


Python内置数据结构有哪些?列表、元组、字典与集合详解
全面解析Python四种核心内置数据结构:列表(list)、元组(tuple)、字典(dict)与集合(set)。从特性对比、底层原理、核心操作到工程选型指南,帮助开发者深入理解并高效使用。
一、四大内置数据结构全景概览
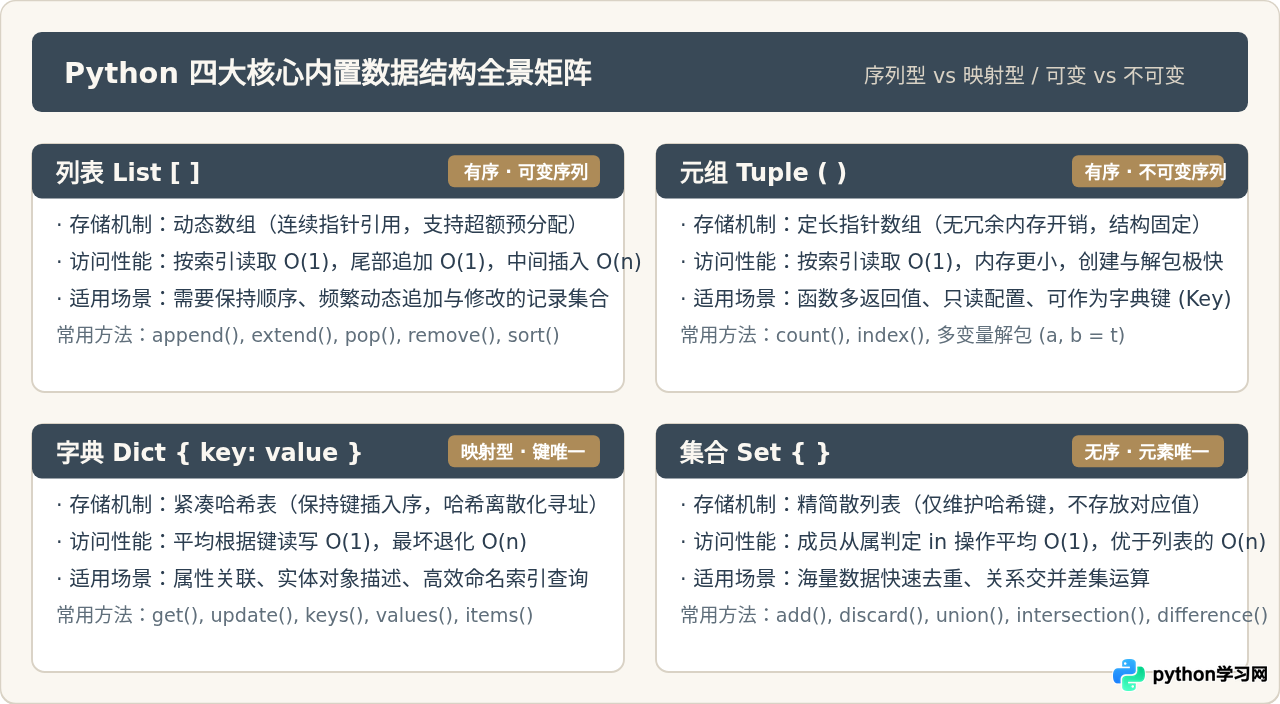
在 Python 中,数据结构是组织与存储数据的基本形式。Python 提供了丰富的基本数据类型(如整数、浮点数、字符串),而复合数据结构则用于容纳多个元素。根据元素是否可被修改、是否有序存放,以及是否按键值对进行组织,四大内置数据结构的属性划分如下表所示:
| 数据结构 | 语法表示 | 有序性 | 可变性 (Mutable) | 元素重复性 | 主要底层实现 |
|---|---|---|---|---|---|
| 列表 (list) | [1, 2, 3] |
有序 | 可变 | 允许重复 | 连续内存指针数组(动态数组) |
| 元组 (tuple) | (1, 2, 3) |
有序 | 不可变 | 允许重复 | 定长内存指针数组 |
| 字典 (dict) | {"key": "val"} |
保持插入顺序 (Python 3.7+) | 可变 | 键唯一,值可重复 | 紧凑哈希表 (Compact Hash Table) |
| 集合 (set) | {1, 2, 3} |
无序 | 可变 | 元素严格唯一 | 哈希散列表(仅存储键) |
二、列表(list)与元组(tuple):序列型数据结构深度解析
列表与元组均属于序列(Sequence)。它们通过从 0 开始的整数索引对元素进行访问,支持正负向切片、遍历迭代以及拼接解包操作。然而,两者的底层分配模型与设计哲学截然不同。
1. 列表(list):高度灵活的动态数组
列表是 Python 中最通用、最常用的有序集合。它使用方括号 [] 定义,也可以通过内置函数 list() 将其他可迭代对象转化为列表。
底层存储与动态扩容机制:
在 CPython 解释器中,列表是由 PyListObject 结构体实现的,其底层实际上是一个存放对象指针的连续数组。由于列表需要随时支持追加操作(append),如果每次追加都向系统申请新的内存空间,性能损耗将无法接受。因此,Python 采用了超额分配(Over-allocation)策略。
当现有预分配空间耗尽时,CPython 会按照特定递增规则(大致为当前容量的 1.125 倍加上固定步长)重新申请一块更大的连续内存区,将原指针拷贝过去,并释放旧空间。这一机制保证了尾部追加操作的均摊时间复杂度为 O(1)。
# 列表常用操作示例
fruits = ["apple", "banana", "cherry"]

# 1. 追加与扩展
fruits.append("orange")         # 尾部单元素追加 O(1)
fruits.extend(["grape", "pear"]) # 批量扩展序列

# 2. 插入与删除
fruits.insert(1, "mango")       # 指定位置插入:后续元素整体后移 O(n)
removed_item = fruits.pop()     # 弹出尾部元素 O(1)
fruits.remove("banana")         # 按值查找并删除首个匹配项 O(n)

# 3. 索引与切片访问
first_fruit = fruits[0]         # 随机索引读取 O(1)
subset = fruits[1:3]            # 切片复制出新列表

# 4. 原地排序与反转
fruits.sort(reverse=False)      # Timsort 原地排序 O(n log n)
2. 元组(tuple):安全轻量的不可变序列
元组使用圆括号 () 定义。与列表最本质的区别在于:元组在创建后其长度与指针引用均不可更改。若尝试对元组的索引位赋值,将抛出 TypeError: 'tuple' object does not support item assignment 异常。
定义细节与不可变性的深度理解:
- 单元素元组的逗号:如果元组内仅有一个元素,必须在末尾加上逗号,例如
t = (42,)。若写作t = (42),Python 会将其视作普通的带括号数学表达式,其类型为整数int。 - 引用的不可变性:元组的不可变性指的是元组内部存储的对象引用(内存地址)不可改变。如果元组内嵌套了一个可变对象(如列表),该列表内部的数据依然可以被修改:
# 元组的不可变性示例
fixed_coords = (120.15, 30.28)  # 经纬度常量表示

# 单元素元组
single_val = (100,)             # 类型为 tuple
not_a_tuple = (100)             # 类型为 int

# 嵌套可变对象的情况
mixed_tuple = ("config_v1", [10, 20, 30])
# mixed_tuple[1] = [40, 50]     # 错误!无法修改元组内槽位的引用
mixed_tuple[1].append(40)       # 合法!列表内部状态改变,但列表本身的内存指针未变
# 此时 mixed_tuple 为 ('config_v1', [10, 20, 30, 40])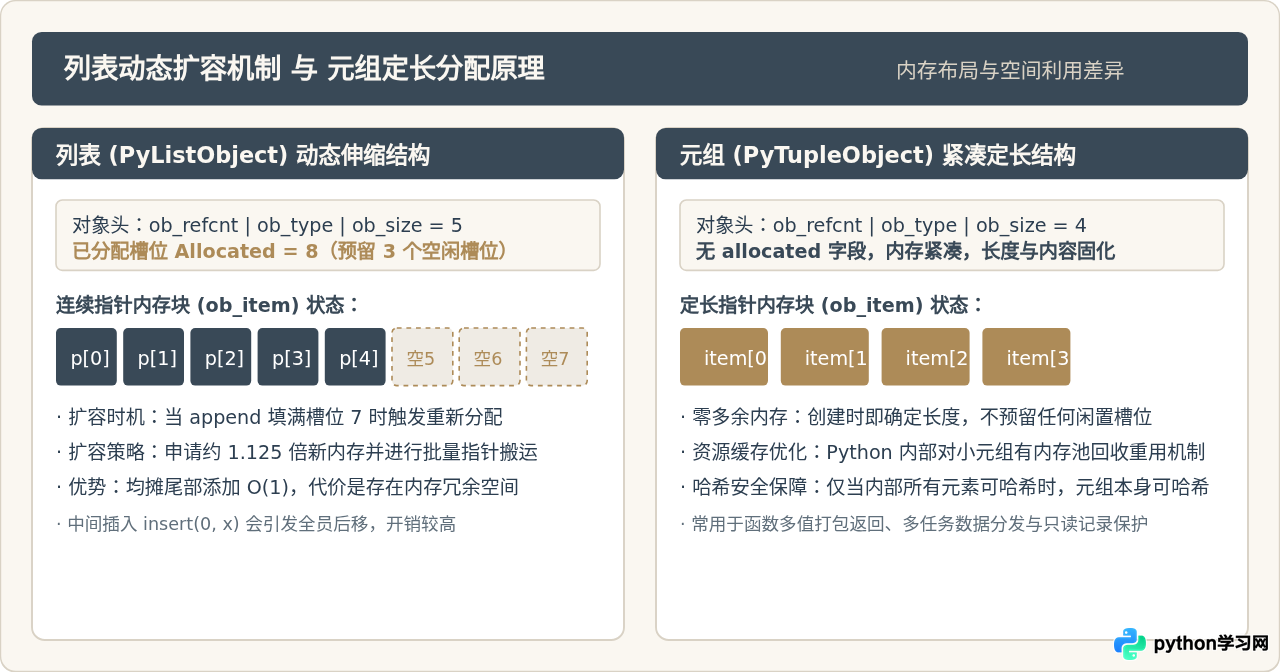
三、字典(dict)与集合(set):哈希型数据结构深度解析
字典与集合是基于哈希表(Hash Table)实现的容器。它们舍弃了传统基于从 0 到 n 连续数字索引的寻址方式,改为根据元素内容计算出的哈希散列码(Hash Value)进行物理存储槽位映射,因此能够在 O(1) 的平均时间复杂度下完成查找、添加和删除。
1. 字典(dict):关联映射的核心中枢
字典是由键值对(Key-Value Pair)构成的映射类型。自 Python 3.6 引入并在 Python 3.7 正式纳入语言规范以来,Python 字典采用了更为紧凑的存储架构(Compact Dict),不仅将内存占用降低了 20%~25%,而且严格保持了键值对的插入顺序。
键(Key)的约束条件:可哈希性(Hashability)
字典中的键必须满足“可哈希”要求:即在生命周期内必须具有唯一的哈希值(通过 __hash__() 返回),且能够与其他对象进行等价性比对(通过 __eq__())。在 Python 中:
- 不可变类型(如
str、int、float、包含可哈希元素的tuple、frozenset)均属于可哈希类型,可作为键。 - 可变类型(如
list、dict、set)不可哈希,若尝试作为字典的键,会引发TypeError: unhashable type: 'list'。
# 字典核心操作示例
user_profile = {
    "uid": 10024,
    "username": "alex_dev",
    "role": "engineer"
}

# 1. 安全访问:使用 get() 避免直接用括号导致的 KeyError
department = user_profile.get("department", "Default-Tech")

# 2. 动态修改与扩展
user_profile["status"] = "active"
user_profile.update({"role": "senior_engineer", "level": 7})

# 3. 视图迭代 (动态反射底层变化)
keys_view = user_profile.keys()
for key, val in user_profile.items():
    pass

# 4. 字典推导式 (用于数据转换与过滤)
score_map = {"math": 92, "english": 85, "history": 78}
passed_subjects = {k: v for k, v in score_map.items() if v >= 80}
2. 集合(set):去重与数学集合代数运算
集合是一个无序且元素严格唯一的容器。集合内部只存储“键”,而不存储对应的“值”。它同样要求元素必须是可哈希的。
在工程实践中,集合主要承担两项关键任务:
- 快速去重与成员判定:列表的
item in my_list是从头到尾遍历的O(n)操作,而集合的item in my_set是哈希计算直接寻址的O(1)操作。在处理数十万条数据时,两者性能差距可达百倍以上。 - 高效的数学运算:集合支持交集(
&)、并集(|)、差集(-)和对称差(^)等内置操作。
# 集合去重与数学运算示例
raw_ids = [101, 102, 103, 101, 104, 102]
unique_ids = set(raw_ids)        # 快速去重,得到 {101, 102, 103, 104}

group_a = {"Python", "Go", "Rust"}
group_b = {"Python", "Java", "C++"}

# 集合代数运算
intersection_res = group_a & group_b      # 交集:{'Python'}
union_res = group_a | group_b             # 并集:涵盖全部不重复技术
diff_res = group_a - group_b              # 差集:A 独有的技术 {'Go', 'Rust'}
sym_diff = group_a ^ group_b              # 对称差:仅在其中一个集合出现的技术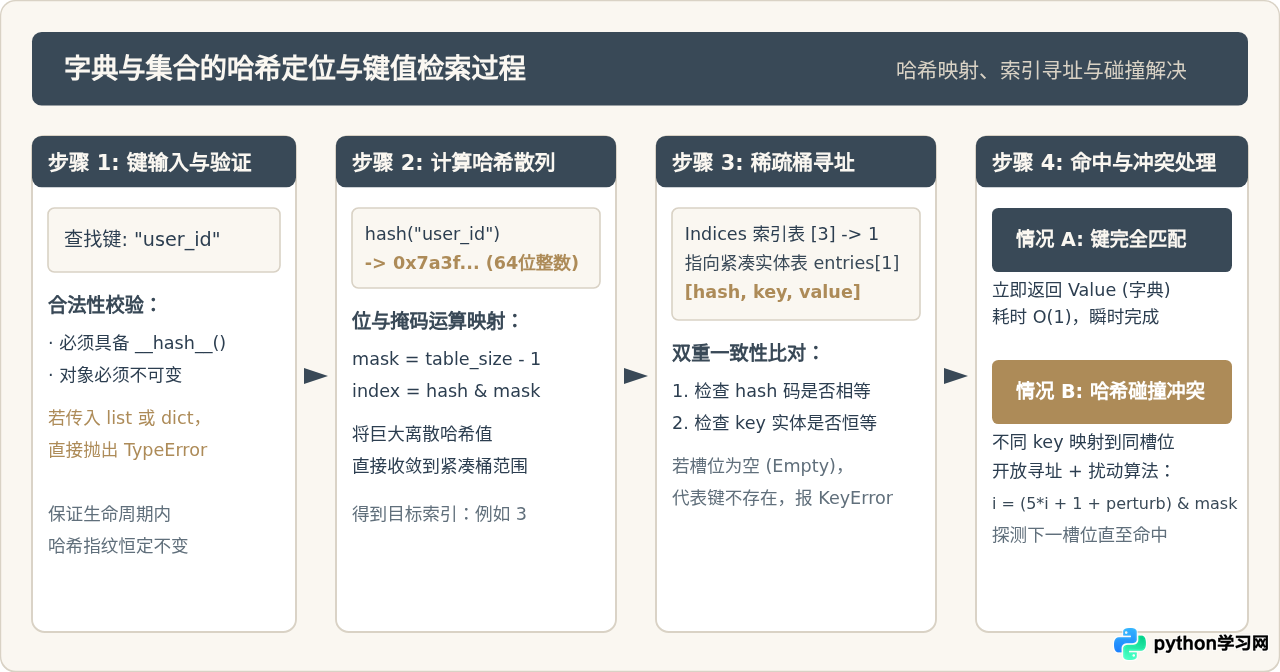
四、四大内置数据结构时间复杂度与核心指标对比
为了在工程开发中做出最优的技术选型,必须清楚各数据结构在典型操作下的算法复杂度(以平均时间复杂度为基准):
| 操作类型 | 列表 (list) | 元组 (tuple) | 字典 (dict) | 集合 (set) |
|---|---|---|---|---|
索引访问 [i] |
O(1) | O(1) | 不适用 (不支持数字索引) | 不适用 (无序不可索引) |
| 键访问 / 查找 | 不适用 | 不适用 | 平均 O(1) | 不适用 |
包含判断 x in s |
O(n) (需全表线性扫描) | O(n) (需全表线性扫描) | 平均 O(1) (对键判定) | 平均 O(1) (哈希命中) |
| 尾部追加 / 插入 | append: 均摊 O(1) | 不支持 (不可变) | 赋值: 平均 O(1) | add: 平均 O(1) |
| 中间插入 / 任意删除 | insert/pop: O(n) | 不支持 | pop(k): 平均 O(1) | remove: 平均 O(1) |
| 内存占用相对水平 | 中等(含预分配空间) | 最紧凑(无多余预分配) | 较高(需维护哈希表) | 较高(需维护哈希表) |
1. 避免使用列表或字典作为函数的默认参数:函数的默认参数在模块加载时仅被评估初始化一次。若使用 def add_item(val, target=[]),所有未传 target 的调用都会共享同一个列表实例,引发隐蔽的状态污染。应使用 target=None 并在函数体内部进行惰性判断 if target is None: target = []。
2. 集合与字典中 NaN 和浮点的特殊性:在 Python 中,float('nan') != float('nan') 永远为 True。若将多个 float('nan') 存入集合,集合无法利用等价性消除它们,会导致同一个集合中存在多个看起来相同的 NaN 元素。
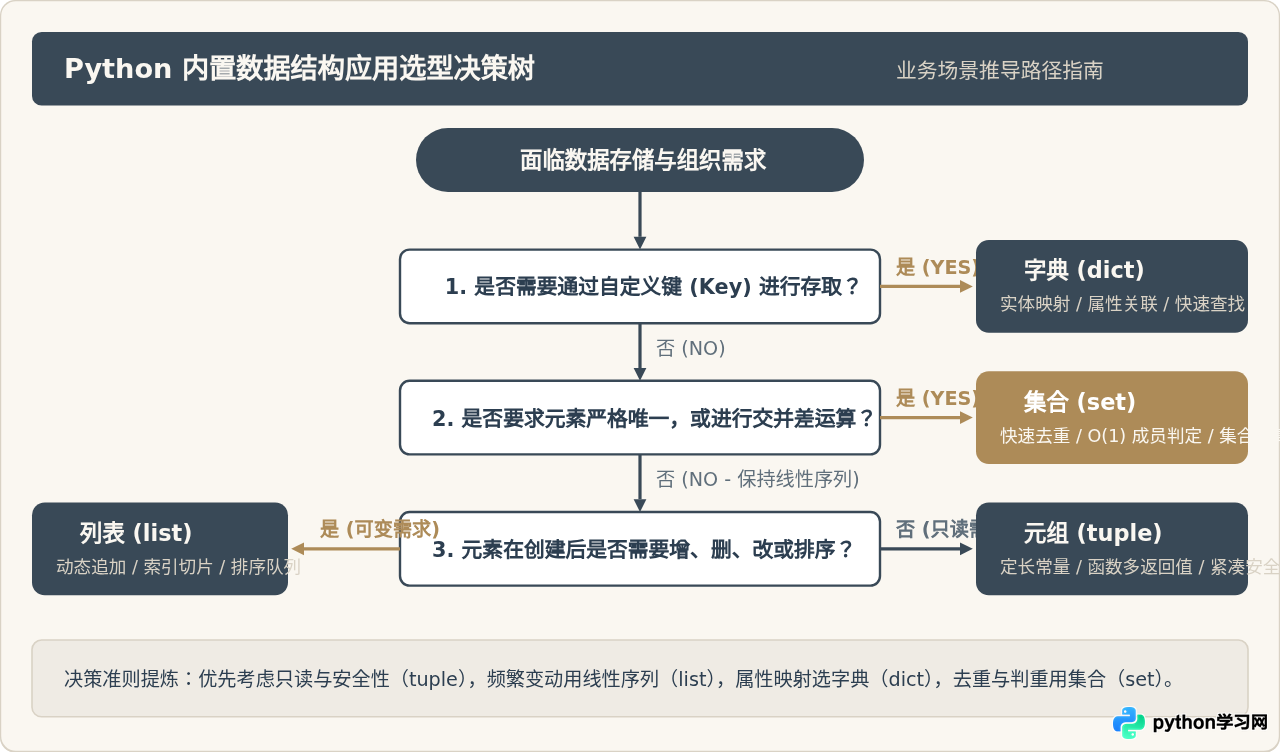
五、工程实践中的选型决策路径
面对业务需求时,应遵循清晰的排他性推导逻辑选择最合适的数据结构:
- 明确是否存在键值关联:如果是结构化数据、带有明确语义字段的对象、或者需要按自定义字符串/ID进行高速查找,果断选择字典(dict)。
- 明确是否需要去重或集合运算:如果目标是排除重复记录、校验黑白名单、或者对两个群体进行求交、求并比对,优先选择集合(set)。
- 明确序列数据的可变性需求:
- 如果数据在业务流转中需要频繁增加、删除、调整次序,或作为任务队列使用,选择列表(list)。
- 如果数据属于定长常量配置、函数多结果返回、坐标记录,或者作为只读参数传递给外部模块防止意外修改,选择元组(tuple)。
六、总结与核心记忆点
掌握 Python 内置数据结构的本质,关键在于理清内存分配机制与检索时间复杂度两根主线:
- 列表(list)是动态可变的指针数组,提供
O(1)的随机索引访问和均摊O(1)的尾部追加能力,是顺序处理任务与动态集合的首选。 - 元组(tuple)是定长只读的不可变序列,内存占用最低,具备天生的防篡改安全特性,常作为固定记录、函数多值返回及字典的合法键。
- 字典(dict)是高度优化的键值对映射表,基于紧凑哈希表实现,在保持插入顺序的同时提供平均
O(1)的超高速键查询。 - 集合(set)是仅维护键的散列表,彻底去除了重复元素,通过常数级的成员判定(
in)和内置集合代数方法,极大简化了多数据集关系运算。
在日常编码中,不滥用单一结构,根据数据的业务语义、读写比率及规模特征选择最契合的数据结构,是写出优雅且高性能 Python 代码的核心功底。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















