


Python正则split怎么保留分隔符内容
详细讲解在Python中使用re.split切分字符串时保留分隔符内容的方法,涵盖捕获括号、先行与后发断言、边缘空串处理及多分组场景。
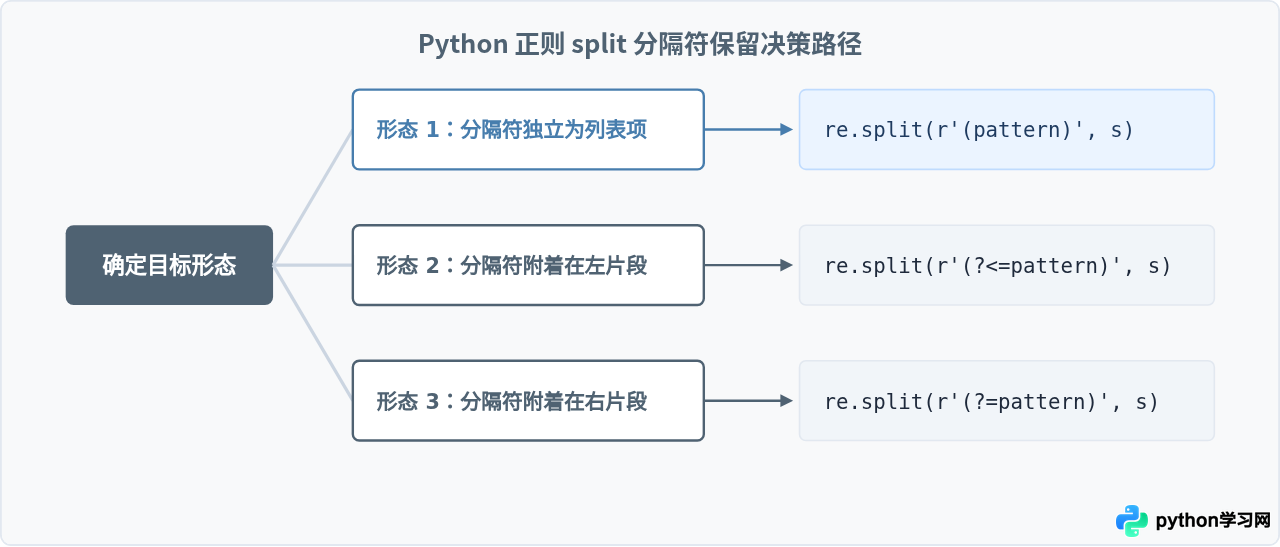
在 Python 中使用 re.split() 切分字符串时,如果直接传入普通匹配表达式,匹配到的分隔符默认会被完全丢弃。要将分隔符作为结果列表的一部分保留下来,最直接的做法是在正则表达式模式中为分隔符加上捕获圆括号 (...)。如果需要分隔符直接吸附在切分出的片段左侧或右侧,则应配合零宽断言进行切分。本文针对这两种核心诉求,详细拆解具体的实现方式与边界细节。
一、使用捕获圆括号保留独立分隔符
Python 标准库 re 模块的文档中明确规定:如果在 re.split(pattern, string) 的模式中使用了捕获组(即外层包裹圆括号),那么模式中每个捕获组匹配到的字符串都会被插入到最终的返回列表中。
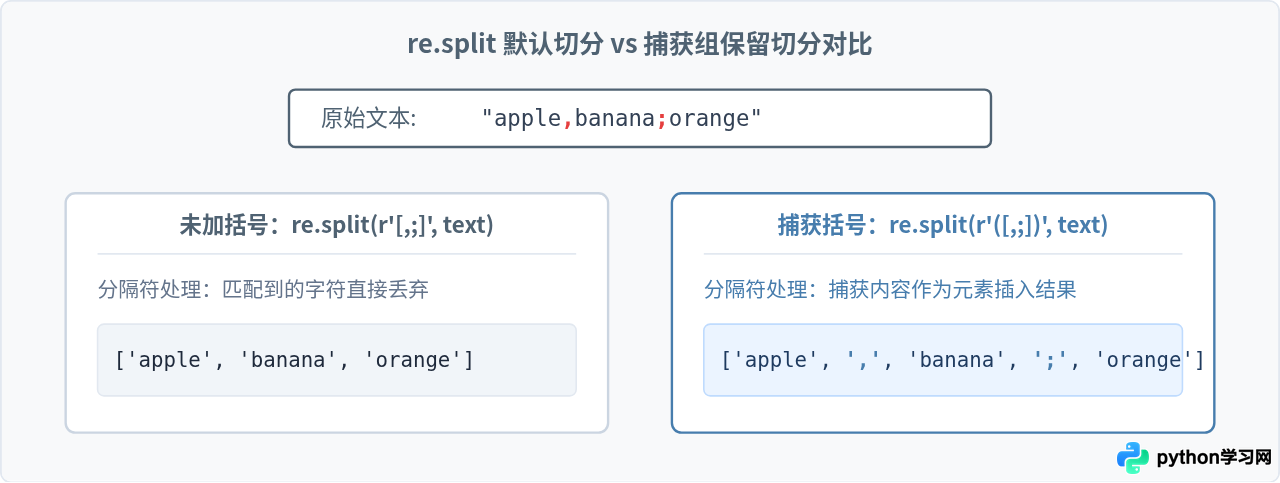
来看一个基础代码示例。假设我们需要切分一个算术表达式,既要获取运算数,也要保留运算符:
import re

text = "10+25*3-8"

# 普通切分:运算符全部丢失
res_normal = re.split(r'[\+\-\*\/]', text)
print("普通切分:", res_normal)
# 示例输出: ['10', '25', '3', '8']

# 捕获组切分:在运算符规则外层包裹小括号
res_keep = re.split(r'([\+\-\*\/])', text)
print("保留分隔符:", res_keep)
# 示例输出: ['10', '+', '25', '*', '3', '-', '8']
可以看到,只要将正则表达式写成 r'([\+\-\*\/])',返回的列表就会严格按照原文本中字符出现的物理顺序,交替排列“普通文本块”与“分隔符块”。
二、捕获组切分的内部处理步骤与推导
理解 re.split() 在遇到捕获圆括号时的具体动作,有助于解决后续可能出现的复杂结构问题。引擎在解析字符串时是逐位推进的。
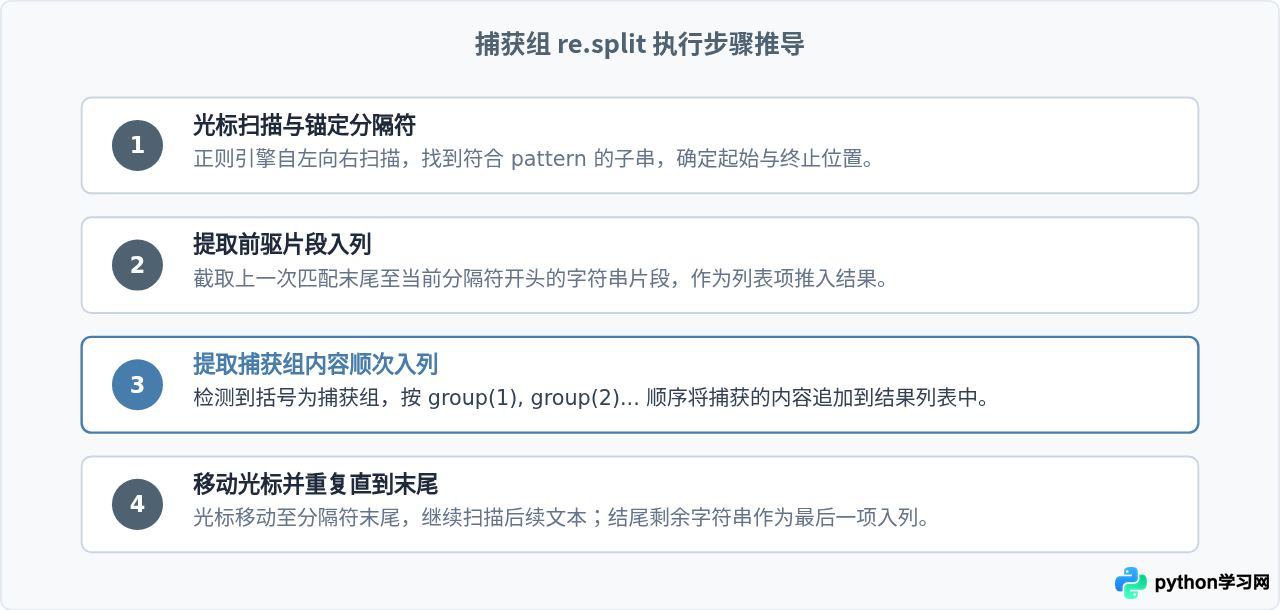
(?:...) 的区别如果你在正则表达式中使用了括号,但仅仅是为了逻辑分组(例如多选分支
r'hello (?:and|or) world'),请务必加上 ?: 声明为非捕获组。否则 re.split() 会把分组内匹配到的 and 或 or 也强行塞进返回列表。
三、利用零宽断言实现“附着保留”
有时业务需求并不是把分隔符切成独立的一项,而是希望分隔符附着在左侧文本的末尾(例如保留句末标点),或者附着在右侧文本的开头(例如按特定前缀切分段落)。此时如果切完后再用循环去拼接,代码会显得冗长繁琐。更优雅的手段是利用正则的零宽断言(Lookaround)。
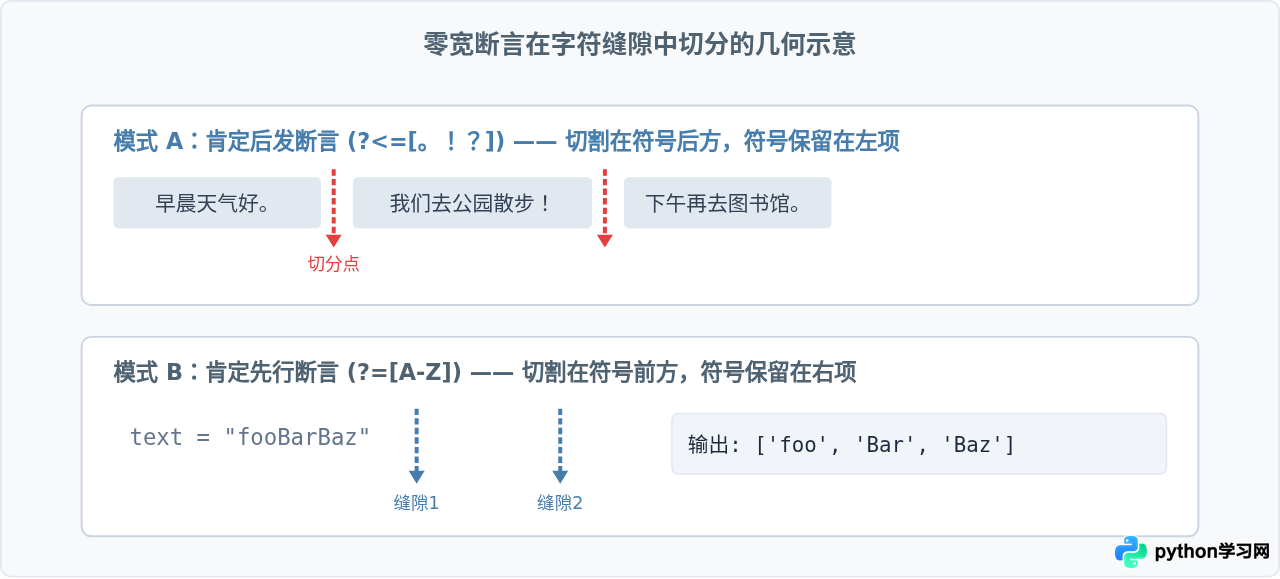
零宽断言本质上并不消耗字符,它匹配的是字符之间的“缝隙”:
- 后发断言
(?<=pattern):要求缝隙左边必须满足模式。因此切分发生在分隔符正后方,分隔符被归并到左边的分块中。 - 先行断言
(?=pattern):要求缝隙右边必须满足模式。因此切分发生在分隔符正前方,分隔符被归并到右边的分块中。
看具体执行代码:
import re

# 场景 1:分句,并保留每句话结尾的标点符号
text1 = "Python很强大。你学了吗?赶快试试!"
sentences = re.split(r'(?<=[。?!])', text1)
# 过滤切分末尾可能产生的空字符串
sentences = [s for s in sentences if s]
print("后发断言保留在句末:", sentences)
# 示例输出: ['Python很强大。', '你学了吗?', '赶快试试!']

# 场景 2:驼峰命名拆分,将大写字母保留在对应单词首位
text2 = "readUserInputData"
words = re.split(r'(?=[A-Z])', text2)
print("先行断言保留在词首:", words)
# 示例输出: ['read', 'User', 'Input', 'Data']
四、关键细节与边界情况排查
在实际编码中,保留分隔符切分容易遇到以下几类边界陷阱,需要针对性地处理:
1. 首尾分隔符导致的空字符串
当待切分的字符串开头或结尾刚好是分隔符时,re.split() 会把分隔符外侧视为空串:
import re

text = ",A,B,"
res = re.split(r'(,)', text)
print(res)
# 示例输出: ['', ',', 'A', ',', 'B', ',', '']如果不需要这些空字符串,可以通过简单的列表推导式进行清洗:[x for x in res if x]。
2. 嵌套括号导致多余的分组输出
如果你的匹配模式较复杂,含有多个分组或嵌套括号,每个括号都会被 re.split 输出:
import re

text = "2026-10-15"
# 错误写法:嵌套了两个捕获组
bad_res = re.split(r'((-))', text)
print("嵌套捕获:", bad_res)
# 示例输出: ['2026', '-', '-', '10', '-', '-', '15']

# 正确写法:只保留一个明确的捕获组,内部分组设为 (?:...)
good_res = re.split(r'(-)', text)
print("规范捕获:", good_res)
# 示例输出: ['2026', '-', '10', '-', '15']
五、保留方案选型与总结
针对不同的文本处理目标,选择合适的分隔符保留策略能够大幅精简代码结构。
| 需求场景 | 正则表达式语法 | 切分示例输入 | 输出形态效果 |
|---|---|---|---|
| 独立保留分隔符 | r'([,;])' |
"a,b;c" |
['a', ',', 'b', ';', 'c'] |
| 分隔符保留在左项末尾 | r'(?<=[,;])' |
"a,b;c" |
['a,', 'b;', 'c'] |
| 分隔符保留在右项开头 | r'(?=[,;])' |
"a,b;c" |
['a', ',b', ';c'] |
| 仅辅助分组但不保留 | r'(?:[,;])' |
"a,b;c" |
['a', 'b', 'c'] |
总结来说,要在 Python 中通过正则 split 保留分隔符,核心就在于括号的用法与断言位置的选择:需要独立项时用普通捕获组 (...);需要原地吸附时用零宽断言 (?<=...) 或 (?=...);纯逻辑组合时加上 ?: 规避多余项。掌握这三种模式,即可覆盖绝大多数复杂的文本切割场景。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















