


ASCII码加5溢出怎么处理?Python实现循环移位加密
针对ASCII码加5直接相加导致的范围溢出问题,本文详解模运算实现循环移位(Wrap-around)的核心数学原理与Python代码实现方案。
一、为什么直接加5会发生“溢出”?
在标准 ASCII 编码表中,各类字符占据着连续但孤立的数字区间。常见的大写字母 'A'~'Z' 对应十进制编码 65~90,小写字母 'a'~'z' 对应 97~122。
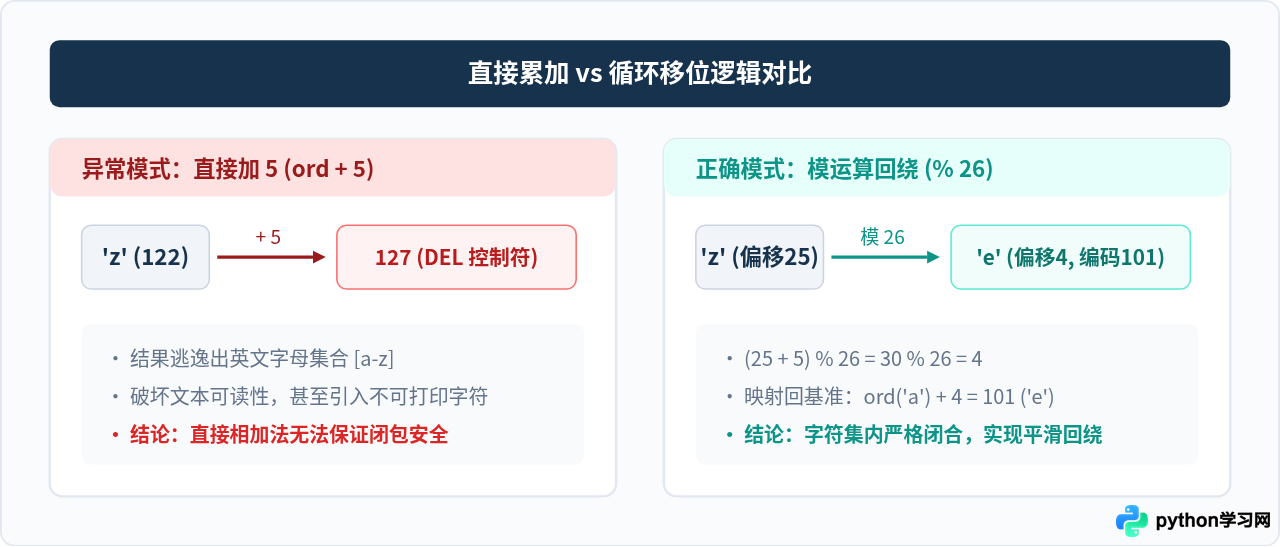
如果编写代码时直接使用 chr(ord(c) + 5) 进行移位加密,位于字母表前端的字符(例如 'a' 变成 'f')能够得到符合预期的结果。但是,只要遇到排在最后的 5 个字母,计算结果就会直接穿透字母边界:
'v'(118) + 5 = 123,对应的字符是左花括号'{'。'w'(119) + 5 = 124,对应的字符是竖线'|'。'x'(120) + 5 = 125,对应的字符是右花括号'}'。'y'(121) + 5 = 126,对应的字符是波浪号'~'。'z'(122) + 5 = 127,对应的字符是不可见的DEL删除控制字符。
这种现象在密码学与文本处理中被称为“区间越界”或“逻辑溢出”。移位加密(如经典的凯撒密码)要求保持字符在同一集合内部轮换,因此必须引入循环机制。
二、循环移位的核心数学推导与执行步骤
要实现安全的移位循环,本质上是将字符映射到一个以 0 为起点的紧凑数字区间,执行取模运算后再还原为目标字符。通用公式如下:
新字符 = chr((ord(原字符) - 基准码 + 位移量) % 集合长度 + 基准码)
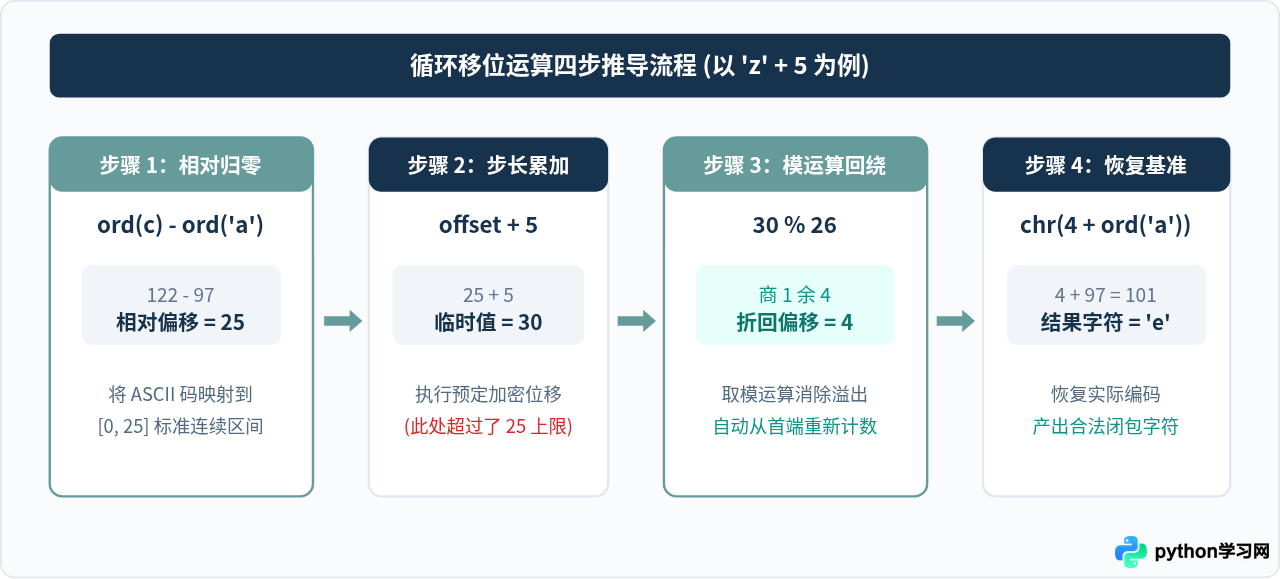
以小写字母 'z' 加 5 为例,具体的推导分为四个严格阶段:
- 归零化(计算相对偏移量):由于
ord('a') == 97,字符'z'的偏移量为ord('z') - ord('a') = 122 - 97 = 25。此时字符处于[0, 25]的标准化区间。 - 位移累加:将相对偏移量与位移量相加,得到
25 + 5 = 30。 - 模运算取余(回绕):英文字母共有 26 个,因此模数为 26。
30 % 26 = 4。超过 25 的数值被平滑折算回区间的起点。 - 恢复基准码:将回绕后的相对数值加回基准字符的 ASCII 码,即
4 + ord('a') = 4 + 97 = 101。再通过chr(101)转回字符,得到目标字符'e'。
三、环形移位的拓扑模型
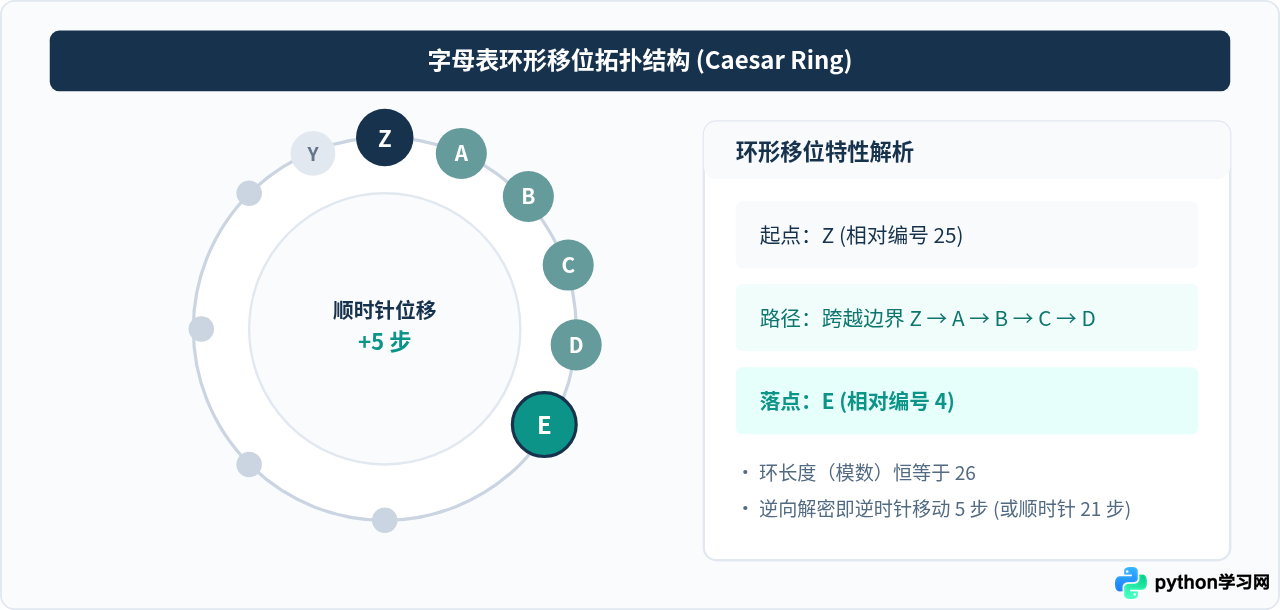
从直观视角来看,取模运算相当于把原本水平排列的 26 个线性字符卡片首尾相连,围成一个类似表盘的“时钟环”。
在表盘上,时针走过 12 点会自然回到 1 点;同理,在 26 个字母的环形表盘上,从 'z' 往前顺时针数 5 格,经过的第一格就是 'a',随后依次是 'b'、'c'、'd',最终停在 'e'。无论位移量增加多少(哪怕是加 31 或加 100),由于环形结构的闭包性,指针永远落在 26 个字母之内。
四、Python 完整代码实现
在实际编程中,我们通常需要处理整段英文文本。一段真实的文本中往往同时包含大写字母、小写字母、标点符号、空格以及数字。因此代码应具备以下处理能力:
- 大写与小写字母分别以
'A'和'a'为基准独立循环,保持原始大小写状态。 - 非字母字符(空格、逗号、句号、数字等)不参与位移,原样输出。
- 支持动态指定移位步长(默认步长为 5)。
def caesar_encrypt(text: str, shift: int = 5) -> str:
    """
    使用循环移位加密文本(保留大小写,非字母字符原样保留)

    参数:
        text: 待加密明文
        shift: 移位步长,默认为 5
    返回:
        加密后的密文
    """
    encrypted_chars = []

    for char in text:
        # 小写英文字母
        if 'a' <= char <= 'z':
            base = ord('a')
            shifted = (ord(char) - base + shift) % 26 + base
            encrypted_chars.append(chr(shifted))
        # 大写英文字母
        elif 'A' <= char <= 'Z':
            base = ord('A')
            shifted = (ord(char) - base + shift) % 26 + base
            encrypted_chars.append(chr(shifted))
        # 其他字符(空格、标点、数字等)保持不变
        else:
            encrypted_chars.append(char)

    return "".join(encrypted_chars)


def caesar_decrypt(ciphertext: str, shift: int = 5) -> str:
    """
    解密密文(向反方向移位)

    参数:
        ciphertext: 待解密密文
        shift: 加密时采用的步长
    返回:
        还原后的明文
    """
    # 在 Python 中,直接传入负数步长即可完美逆向回绕
    return caesar_encrypt(ciphertext, -shift)


# ================= 运行示例 =================
if __name__ == "__main__":
    original_text = "Zoo, zebra and 123 fox!"

    # 执行加密
    cipher = caesar_encrypt(original_text, shift=5)
    print("加密结果:", cipher)

    # 执行解密
    recovered = caesar_decrypt(cipher, shift=5)
    print("解密结果:", recovered)

    # 验证末尾字母移位情况
    print("\n边界字符验证:")
    for ch in ['v', 'w', 'x', 'y', 'z', 'V', 'W', 'X', 'Y', 'Z']:
        print(f"'{ch}' + 5 -> '{caesar_encrypt(ch, 5)}'")
加密结果:
Ett, ejgwf fsi 123 ktc!解密结果:
Zoo, zebra and 123 fox!边界字符验证:
'v' -> 'a', 'w' -> 'b', 'x' -> 'c', 'y' -> 'd', 'z' -> 'e'
五、解密与负数取模的实现细节
在许多编程语言(如 C、C++ 或 Java)中,对负数取模会返回负数余数,例如 -1 % 26 在 Java 中计算结果是 -1,这就要求开发者在代码中手动加上 26:(offset - shift + 26) % 26。
而 Python 的模运算规则严格遵循向下取整(Floor Division)。在 Python 语言规范中:
# Python 内部对负数取模计算
-1 % 26 == 25
-5 % 26 == 21
这意味着在 Python 中编写解密函数时,无需添加繁琐的条件判断或额外补数,直接传入负步长 -shift 即可优雅且准确地实现反向循环。
六、扩展:全可打印 ASCII 区间循环移位
如果应用场景不是英文字母的凯撒加密,而是希望把所有可打印字符(ASCII 32 到 126,涵盖空格、英文字母、数字和各类英文标点符号,共计 95 个字符)全部纳入移位范围,只需调整基准值和模数即可:
| 方案类型 | 适用字符范围 | 基准字符 (Base) | 区间长度 (Modulus) | 典型场景 |
|---|---|---|---|---|
| 字母循环移位 | 'a'-'z' 或 'A'-'Z' | ord('a') 或 ord('A') | 26 | 经典凯撒密码、单词游戏、语义保留混淆 |
| 全打印字符移位 | 32 ~ 126 (空格至波浪号) | 32 (空格) | 95 | 通用 ASCII 简单混淆、避免引入控制字符 |
def printable_ascii_shift(text: str, shift: int = 5) -> str:
    """对所有可打印 ASCII 字符 (32~126) 执行安全循环移位"""
    base = 32
    mod = 95  # 126 - 32 + 1
    result = []
    for char in text:
        code = ord(char)
        if 32 <= code <= 126:
            shifted = (code - base + shift) % mod + base
            result.append(chr(shifted))
        else:
            result.append(char)
    return "".join(result)
七、总结
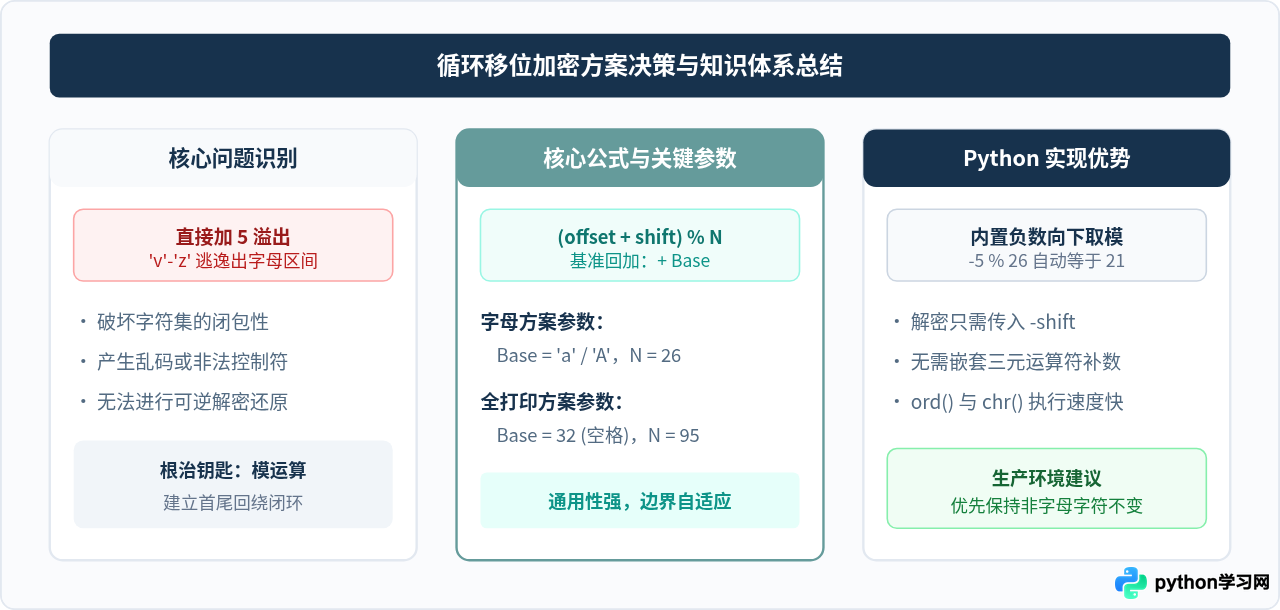
遇到“ASCII 码加 5 溢出”时,不能直接将字符编码加 5 转回字符。正确且健壮的处理方法始终是通过相对偏移与模运算:
- 以起始字符的 ASCII 码为基准,提取相对位置(0 ~ N-1)。
- 在相对位置上叠加步长后,对区间总长度 N 取模。
- 重新加上基准 ASCII 码,并通过
chr()还原。
借助这一机制,不仅解决了字母尾部越界的问题,还能利用 Python 天然的负数取模特性轻松实现对称解密。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















