


python必背源代码tqdm进度条代码
系统梳理Python中tqdm进度条必背核心源代码,包含基础循环包裹、动态参数显示、手动更新模式、多层嵌套循环与Pandas生态集成,助您快速编写健壮高效的进度条代码。
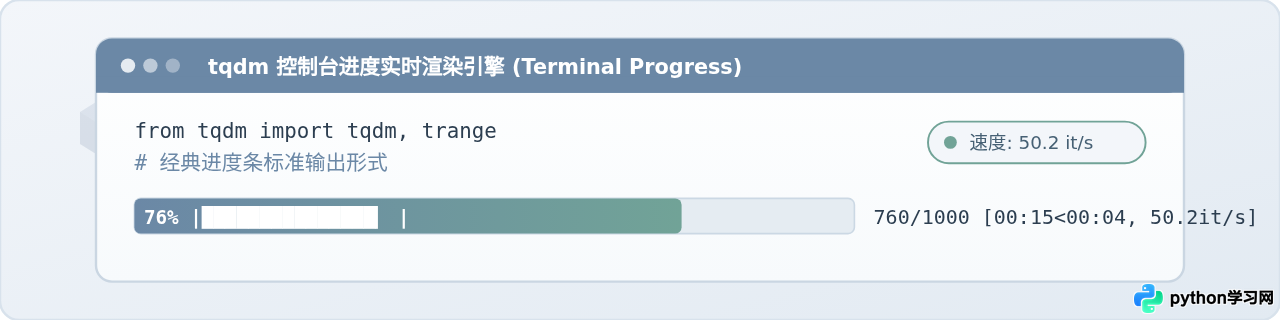
tqdm 是 Python 中应用最广、接入成本最低的进度条工具,只需一行包装代码即可获得包含百分比、迭代速率、已用时间与预估剩余时间(ETA)的终端交互界面。本文梳理并提取开发中必背的五套 tqdm 核心源代码模版,涵盖基本循环、动态指标更新、无规律手动更新、多层嵌套循环与 Pandas 批量计算,助你在实际项目中即调即用。
一、为什么必须掌握 tqdm?
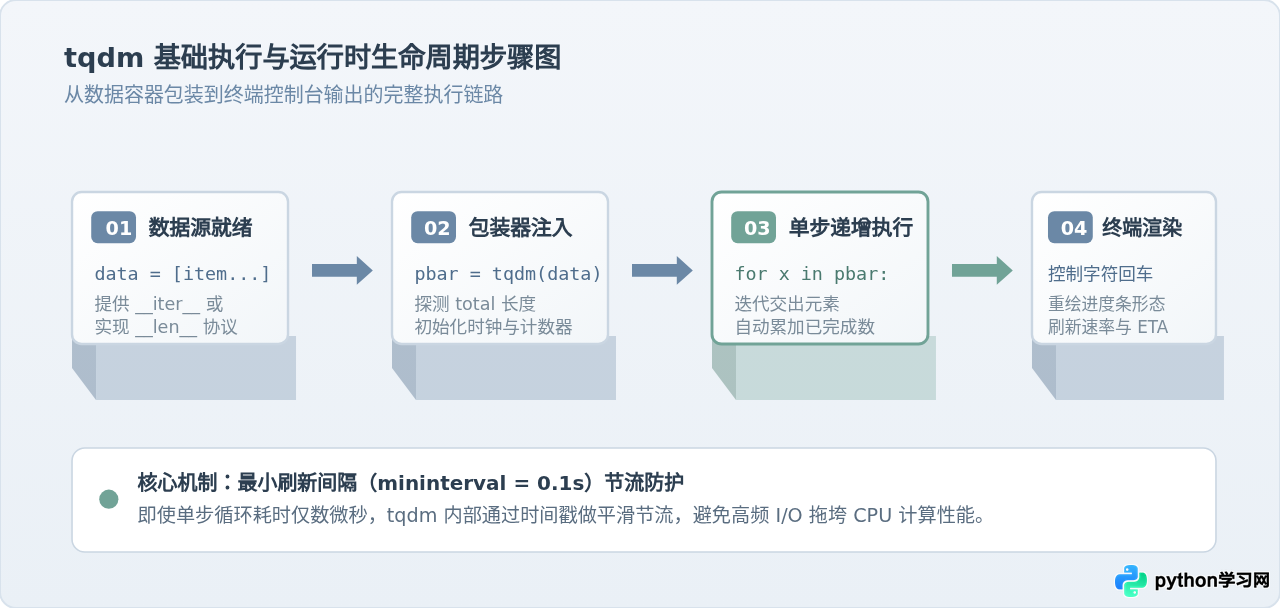
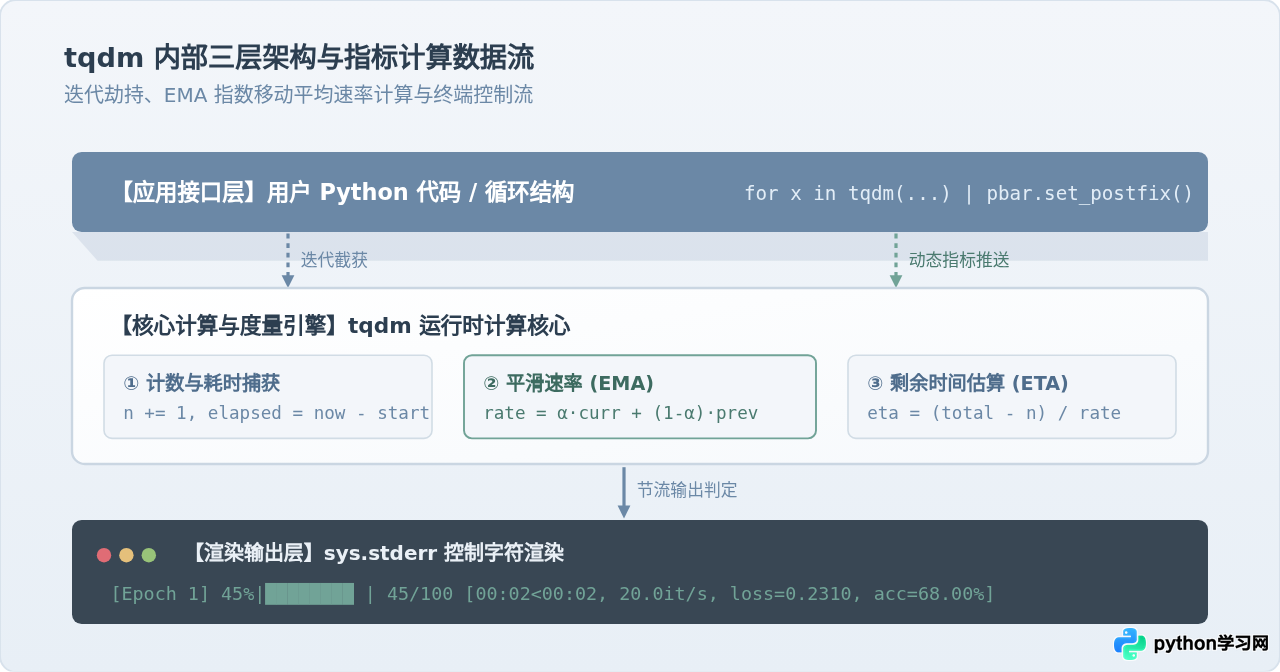
tqdm 得名于阿拉伯语单词“taqaddum”(意为“进步”),也是西班牙语“te quiero demasiado”(我太喜欢你)的缩写。在技术实现上,它的核心优势在于无侵入式包装。它并不改变被包装对象的数据结构与迭代协议,而是通过实现 Python 迭代器上下文与生成器钩子,在每次迭代交出数据的瞬间,自动完成计时与进度计算,并通过 sys.stderr 刷新单行输出。
| 使用方式 | 典型场景 | 核心函数 / 方法 | 核心关注参数 |
|---|---|---|---|
| 基础循环包裹 | 常规列表、文件行、固定次数循环 | tqdm(), trange() |
desc, total, unit |
| 动态信息刷新 | 模型训练、带状态批处理 | set_postfix(), set_description() |
字典键值对、refresh=True |
| 上下文手动更新 | 文件分块传输、流式网络下载 | with tqdm(...) as pbar, update() |
total, unit_scale, update(n) |
| 多层嵌套控制 | 外层 Epoch + 内层 Batch 训练 | tqdm(..., position=x, leave=y) |
position, leave |
| Pandas 链式扩展 | 数据清洗、特征工程批量 Apply | tqdm.pandas(), progress_apply() |
desc |
二、必背模板一:基础循环与 trange 极简代码
在遍历列表、字典或数字序列时,最常用的方式是直接使用 tqdm() 包裹已有容器,或使用等价于 tqdm(range(n)) 的内置简写 trange(n)。
import time
from tqdm import tqdm, trange

# 1. 直接包裹任意可迭代对象(列表、元组等)
file_list = [f"doc_{i}.txt" for i in range(100)]
for file_name in tqdm(file_list, desc="读取文档", unit="篇"):
    time.sleep(0.02)  # 模拟具体读写逻辑

# 2. 替代 range() 的高频必背写法 trange()
for step in trange(50, desc="模型评估", ncols=80):
time.sleep(0.03)desc: 进度条左侧前缀文本,用于区分当前任务类型。unit: 迭代单位名称,默认为"it",可根据实际业务设置为"篇"、"条"或"B"。ncols: 固定整个进度条的字符总宽度,避免终端窗口拉伸时自动折行错乱。
三、必背模板二:动态信息与训练指标实时更新
在进行模型训练、批处理清洗或爬虫采集时,往往需要实时查看当前步骤的指标(如 Loss、准确率、耗时或状态码)。此时必须使用 set_postfix() 或 set_description()。
import time
import random
from tqdm import trange

pbar = trange(100, desc="Epoch 1")
for step in pbar:
    time.sleep(0.05)  # 模拟计算
    loss_val = random.uniform(0.1, 0.9)
    acc_val = 0.5 + step * 0.004

    # 1. 动态更新进度条右侧的字典指标
    pbar.set_postfix(loss=f"{loss_val:.4f}", acc=f"{acc_val:.2%}", refresh=False)

    # 2. 必要时动态修改左侧前缀描述
    if step % 20 == 0:
        pbar.set_description(f"Epoch 1 [阶段 {step//20}]")
注意在调用 set_postfix() 时,通常建议保留默认参数或设置 refresh=False。这样指标会在下一次循环迭代时与进度条一并刷新,避免因额外触发重绘而引起终端闪烁或性能抖动。
四、必背模板三:上下文管理器与手动增量更新
某些操作并没有显式的 for 循环或长度已知的迭代器。最典型的场景包括:读取未知总大小的网络数据流、从 Socket 接收数据块,或者在递归调用中统计文件总数。此时需要使用 with tqdm() as pbar 配合 pbar.update(n)。
import time
from tqdm import tqdm

# 假设需要分块处理 1024KB 的流式文件
total_size = 1024 * 1024  # 1 MB
chunk_size = 64 * 1024    # 每次读取 64 KB

with tqdm(
    total=total_size,
    unit='B',
    unit_scale=True,
    unit_divisor=1024,
    desc="分块传输"
) as pbar:
    transferred = 0
    while transferred < total_size:
        time.sleep(0.04)  # 模拟读取块耗时

        # 手动向后推进指定步长
        pbar.update(chunk_size)
        transferred += chunk_size
pbar.update(n) 中的 n 代表增量(本次推进了多少),而不是当前累计值。许多初学者误将当前的 transferred 传入,导致进度条瞬间溢出(例如超过 1000%)。若确实需要直接设置累计绝对值,应使用 pbar.n = current_val; pbar.refresh()。
五、必背模板四:多层嵌套循环与位置参数
在进行模型训练(外层轮次 Epoch、内层批次 Batch)或多目录递归检索时,往往需要同时展示内外两层进度条。如果不加约束,外层和内层进度条会在终端中相互覆盖、反复换行,造成字符错乱。
解决该问题的标准做法是显式配置 position 和 leave 参数:
import time
from tqdm import trange

num_epochs = 3
num_batches = 20

# 外层进度条:固定在第 0 行,任务结束后保留 (leave=True)
for epoch in trange(num_epochs, desc="Total Epoch", position=0, leave=True):

    # 内层进度条:定位在第 1 行,每轮结束后自动清理 (leave=False)
    for batch in trange(num_batches, desc=f"Epoch {epoch} Batch", position=1, leave=False):
        time.sleep(0.04)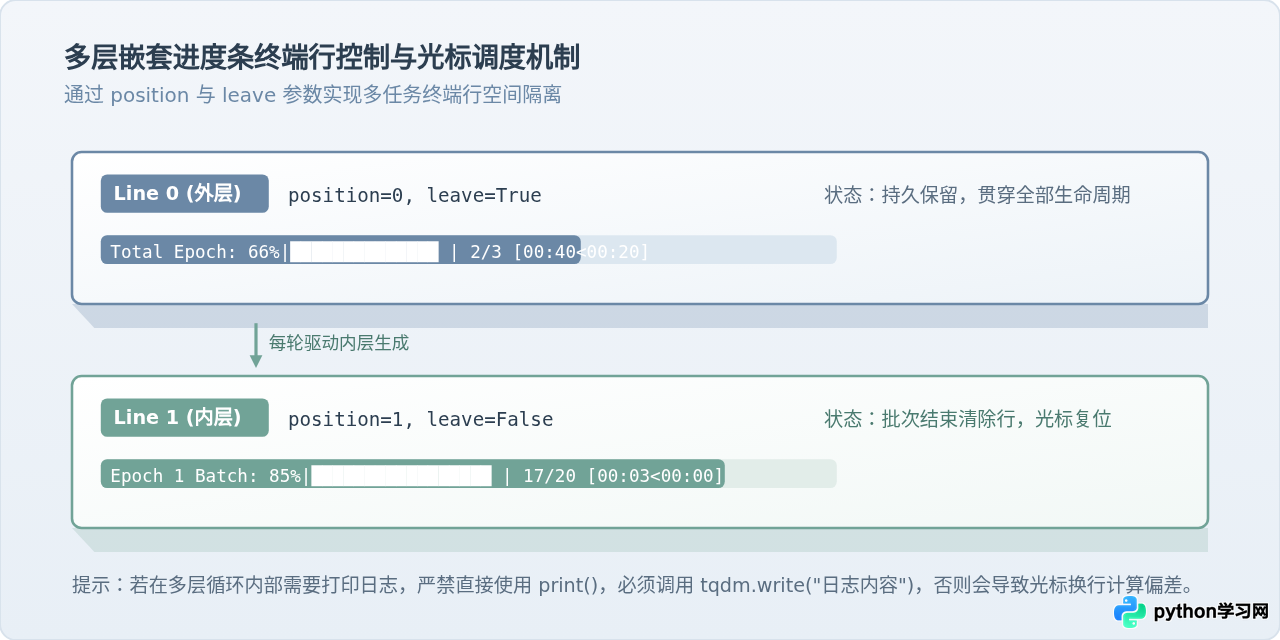
六、必背模板五:Pandas 生态集成 progress_apply
在进行大数据量表格处理时,直接使用 DataFrame.apply() 经常耗费数分钟且没有任何进度反馈。tqdm 对 Pandas 提供了原生集成方案:
import pandas as pd
from tqdm import tqdm

# 1. 注册 tqdm 到 pandas 的全局扩展方法
tqdm.pandas(desc="特征清洗")

# 2. 模拟构建测试数据
df = pd.DataFrame({
    "raw_text": [f" 用户反馈语句数据条目编号_{i} " for i in range(10000)]
})

# 3. 将原有的 .apply() 替换为 .progress_apply()
def clean_text(text):
    return text.strip().lower()

df["cleaned_text"] = df["raw_text"].progress_apply(clean_text)
该写法无需自行拆分 DataFrame 或手写循环,完全保留了 Pandas 的向量化与链式调用习惯。对于按组操作,也同样支持 df.groupby('category').progress_apply(process_func)。
七、常见排查与避坑指南
在实际应用 tqdm 时,开发者常遇到以下三类典型问题,掌握排查方法即可快速恢复正常显示:
-
问题一:控制台出现大量重复刷屏换行
原因:循环内部直接执行了原生print(),破坏了
解法:将print(msg)改为tqdm.write(msg),它会自动协调光标位置,先上移一行输出文本,再恢复进度条渲染。 -
问题二:进度条只显示迭代次数,缺少百分比与 ETA
原因:包装的是一个生成器(Generator)或迭代器(Iterator),对象未实现__len__协议,tqdm无法预知总长度。
解法:在初始化时显式传入total参数,例如tqdm(gen_func(), total=已知总数)。 -
问题三:在 Jupyter Notebook 中进度条变成丑陋的纯文本堆叠
原因:标准tqdm针对标准命令行终端设计,而在 Notebook 环境中应使用基于 HTML/CSS 小部件的富文本版本。
解法:改用from tqdm.notebook import tqdm, trange,即可无缝渲染为带平滑过渡颜色的现代化 HTML 进度条。
八、总结
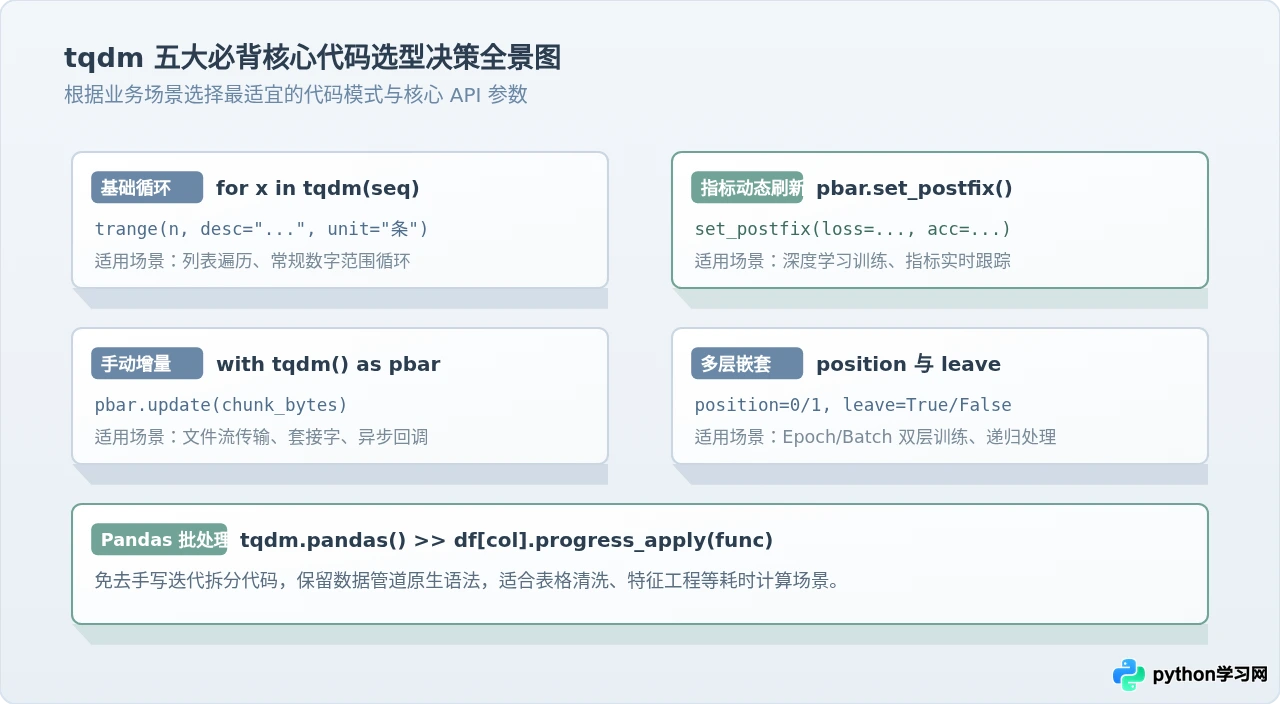
tqdm 是 Python 开发者工具箱中性价比极高的一款库。熟练记忆上述五种核心源代码模式,在日常编写脚本、数据流水线或深度学习模型时,就能根据被迭代对象的特性(容器、生成器、数据流、多层循环或 Pandas 表格)精准选择对应的模板,既能提供直观明确的执行反馈,又能保持代码的整洁与稳健。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















