


Python切片中step为0为什么抛出ValueError?
深入解析Python切片操作中传入step为0时为什么会抛出ValueError异常,从数学步进机制、死循环防范、CPython底层源码实现及防御性编程实践进行全面剖析。
seq[::0] 或 slice(None, None, 0)),解释器会立即抛出 ValueError: slice step cannot be zero。核心原因在于:切片通过步长定义了索引移动的“方向”与“单次位移量”;步长为 0 意味着位移量为零,循环无法向终止边界逼近,必然导致算法陷入无法停机的死循环。为了维护语言层面的语义明确性与执行安全性,Python 在底层 C 语言实现中将其作为非法参数直接拦截并报错。
一、报错复现与最直接的原因
很多开发者在刚接触 Python 切片或者编写动态切片逻辑时,可能会遇到如下报错代码:
# 示例代码:切片中传入 step 为 0
numbers = [10, 20, 30, 40, 50]
result = numbers[1:4:0]
运行上述代码后,终端会立刻输出明确的异常信息:
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
ValueError: slice step cannot be zero
同样的限制也出现在内置函数 range() 中。执行 range(0, 10, 0) 也会抛出 ValueError: range() arg 3 must not be zero。这证明在 Python 的序列生成与索引步进体系中,“步长非零”是一项底层通用的铁律。
二、从切片执行机制理解:为什么步长不能为0
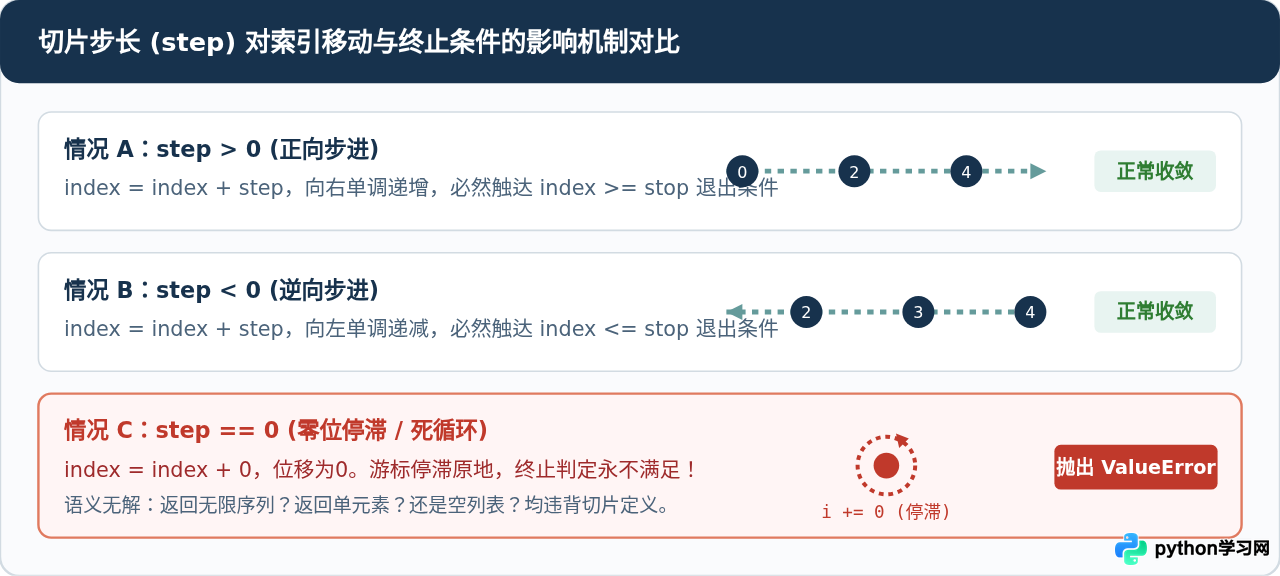
要透彻理解这个设计,我们需要将切片语法 sequence[start:stop:step] 还原为其等价的循环遍历过程。在概念模型中,切片的取值流程可以表述为:
- 将当前游标指针
index初始化为起始位置start。 - 检查当前
index是否已满足或超过终止边界stop。若达到则退出循环。 - 取出当前元素
sequence[index]加入结果集。 - 执行位移更新:
index = index + step,随后返回步骤 2。
当 step > 0 时,索引每次向右单调递增,最终必然会满足 index >= stop 并安全退出;当 step < 0 时,索引每次向左单调递减,最终必然满足 index <= stop 并退出。
然而,如果允许 step = 0,更新公式将退化为 index = index + 0。无论循环迭代多少次,index 的数值都不会发生任何改变。这意味着终止边界检查永远无法被触发,程序直接陷入无法退出的死循环。
三、CPython 源码层面的严格拦截机制
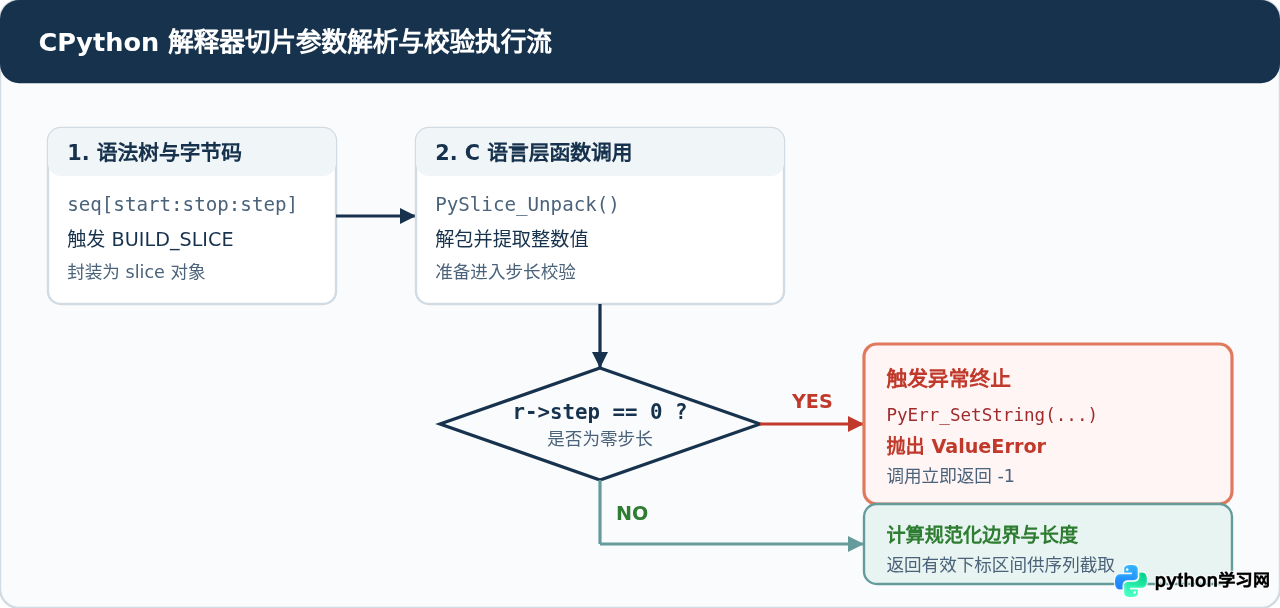
Python 是一门注重“显式优于隐式”且极度重视稳定性的语言。在底层 CPython 实现中,切片操作由 sliceobject.c 负责解析与计算。
当执行切片表达式时,解释器首先构建一个 PySliceObject 对象,随后调用核心函数 PySlice_Unpack() 与 PySlice_GetIndicesEx() 计算最终的切片长度和下标区间。
在 CPython 的核心实现中,存在如下显式的防御性检查代码:
/* 摘自 CPython Objects/sliceobject.c */
if (r->step == 0) {
    PyErr_SetString(PyExc_ValueError, "slice step cannot be zero");
    return -1;
}
从源码逻辑可以看出,步长检查发生在所有边界截断和长度计算的最前端。一旦发现 step == 0,解释器不会做任何尝试或容错修正,而是直接设置 ValueError 异常标志并返回 -1,使得整个切片调用栈立刻中断退出。
四、实际项目中导致 step=0 的高频场景与排查
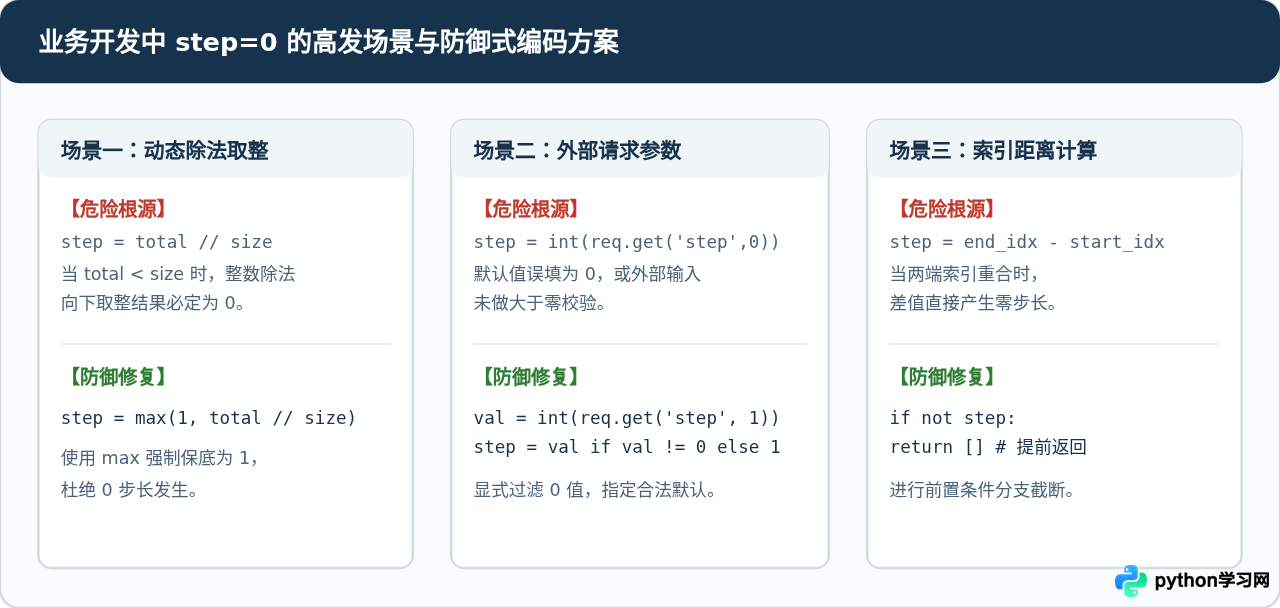
在实际业务开发中,很少有人会显式写出 a[::0]。该错误几乎总是由动态计算步长或未过滤的配置输入引发的。以下是三个最典型的高频场景:
1. 动态步长计算(整除导致为0)
在数据批处理、分页或均匀采样逻辑中,经常会根据数据总量动态计算采样步长:
total_count = len(dataset)
sample_target = 100
# 如果 total_count 小于 sample_target(例如只有 80 条数据),整除结果直接为 0!
step = total_count // sample_target
sampled_data = dataset[::step]  # 触发 ValueError: slice step cannot be zero
2. 未校验的外部参数或默认值陷阱
从 API 请求参数、URL 查询串或配置文件中解析步长时,若默认兜底值或前端传入值未经校验:
# 错误示例:默认值或解析结果取到了 0
user_step = int(request.args.get('step', 0))
items = raw_items[::user_step]  # 当用户未传参时崩溃
3. 步长差值计算产生零
通过两个动态变量计算间隔距离:step = right_bound - left_bound。当两个边界相等时,step 的计算结果就是 0。
五、防御性重构的最佳实践
为了避免代码在生产环境中因意外的零步长而崩溃,建议在封装包含切片或步进逻辑的函数时遵循以下三项防御准则:
- 使用保底函数限制下限: 在进行动态步长计算时,始终套用
max(1, step),确保计算结果至少为 1。 - 在入口处进行类型与数值断言: 对外部传入的参数进行显式校验:
if step == 0: raise ValueError("业务步长不能配置为0"),或直接替换为预设安全值。 - 合理利用切片对象的 indices 方法: 如果编写高通用性的底层类或自定义序列,可以使用
slice.indices(length)方法来规范化切片参数。该方法同样会在step == 0时引发ValueError,便于在上层统一捕获和处理。
六、Python 切片参数规则全景总结
下表矩阵对 Python 切片三元组中 step 的各种取值状态、运行表现与合法性要求进行了汇总,可作为日常编码的速查参考:
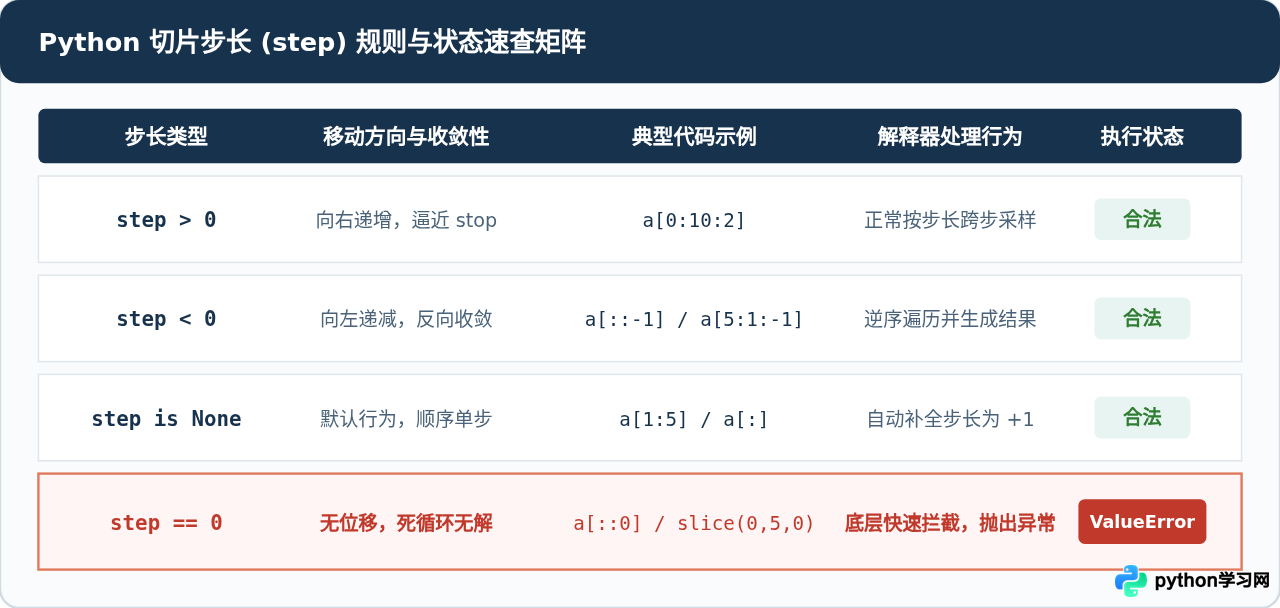
小结: 切片中不允许 step=0 是 Python 语言设计哲学“错误不应被悄悄传递(Errors should never pass silently)”的典型体现。步长等于 0 破坏了索引推进的数学收敛性;通过及早抛出 ValueError,Python 有效阻断了潜在的停机问题与死循环隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















