


Python常用内置函数清单:按功能分类详解与速查
按类型转换、数学运算、序列迭代、自省反射与系统交互五大功能维度,系统梳理Python高频内置函数的核心参数、应用范式与避坑要点。
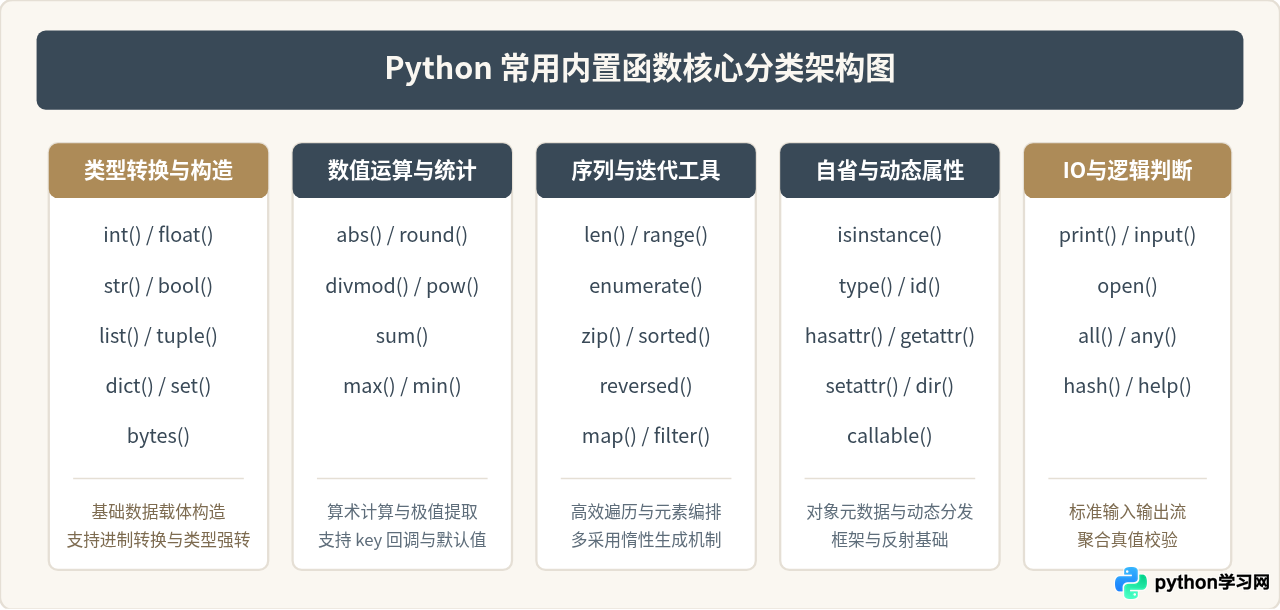
import 即可直接调用的内置函数(Built-in Functions)。本文剔除不常用的边缘接口,提炼出日常开发中使用频率最高的核心函数,按功能划分为“类型构造、数值计算、序列迭代、对象自省与系统交互”五大体系,梳理其关键参数、运行特性与典型避坑场景,提供一份清晰、可落地的速查参考。
一、类型转换与数据构造函数
类型构造函数本质上是内置类的构造器。它们主要用于在不同类型间进行显式转换,或通过已有可迭代对象生成新的集合容器。
1. 标量类型转换:int, float, str, bool
int(x, base=10):将数字或字符串转为整数。当转换字符串时,可通过base指定进制(如 2、8、16 进制)。若浮点数转整数,直接向零截断小数部分。float(x):将字符串或数值转为双精度浮点数。支持科学计数法字符串(如float("1e-4"))。str(object=''):返回对象的面向可读性字符串表示。与repr()的区别在于:str()强调易读性,repr()强调明确性与代码还原度。bool(x):返回对象的真值测试结果。空容器([]、{}、set())、数值零(0、0.0)、空字符串("")以及None均被判定为False。
# 进制转换与科学计数法示例
binary_str = "1011"
dec_val = int(binary_str, 2)  # 结果为 11

rate_str = "2.5e-3"
rate = float(rate_str)        # 结果为 0.0025

# 字符串与真值判断
status = bool([])             # 空列表为 False
has_item = bool([0])          # 非空列表为 True(即使包含元素 0)
2. 容器构造:list, tuple, dict, set
这些函数接收任意可迭代对象(Iterable)作为参数,并在内存中开辟新的容器空间:
list(iterable)与tuple(iterable):将可迭代对象浅拷贝为可变列表或不可变元组。dict(**kwarg)或dict(mapping, **kwarg):通过键值对序列构造字典。例如dict([('a', 1), ('b', 2)])。set(iterable):快速去重并构建无序哈希集合。要求集合元素必须是可哈希(Hashable)类型。
二、数值运算与极值统计函数
Python 在内置作用域中提供了基础数学运算和序列聚合功能,避免了为了简单算术逻辑而引入 math 模块的额外开销。
1. 常用算术运算:abs, round, divmod, pow
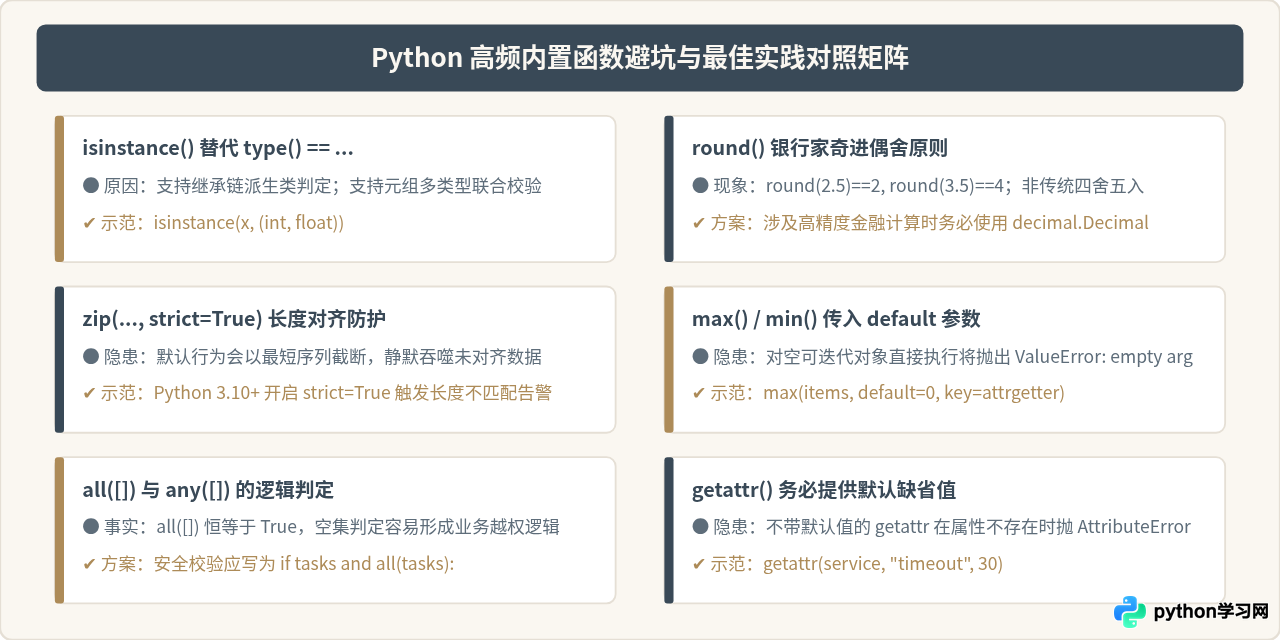
abs(x):返回绝对值。若传入复数(如3 + 4j),则返回该复数的模长。round(number, ndigits=None):对浮点数进行四舍五入。注意:Python 采用“奇进偶舍(Banker's Rounding)”,当尾数恰好为 0.5 时,优先舍入到最接近的偶数(例如round(2.5)得 2,round(3.5)得 4)。divmod(a, b):同时计算商和余数,返回元组(a // b, a % b)。该函数在分页计算场景下尤为高效。pow(base, exp, mod=None):计算base ** exp。若提供第三个参数mod,则高效计算模幂(base ** exp) % mod,常用于加密与数论算法。
# 分页总页数计算范式
total_records = 95
page_size = 10
pages, remainder = divmod(total_records, page_size)
total_pages = pages + (1 if remainder > 0 else 0)  # 总页数为 10
2. 统计与极值提取:sum, max, min
sum(iterable, start=0) 计算累加和。对于字符串拼接,请使用 "".join() 而不是 sum(),后者已被语言层面显式拦截。
max() 与 min() 具有两个极其重要的高级参数:
key:传入单参回调函数,用于自定义比对权值。default:当传入的可迭代对象为空时返回该默认值,避免程序抛出ValueError异常。
# 使用 key 提取属性极值,使用 default 提供防御兜底
records = [{"user": "Alice", "score": 85}, {"user": "Bob", "score": 92}]
top_user = max(records, key=lambda x: x["score"], default=None)
# top_user 结果为: {"user": "Bob", "score": 92}

empty_list = []
safe_max = max(empty_list, default=0)  # 安全返回 0,不报错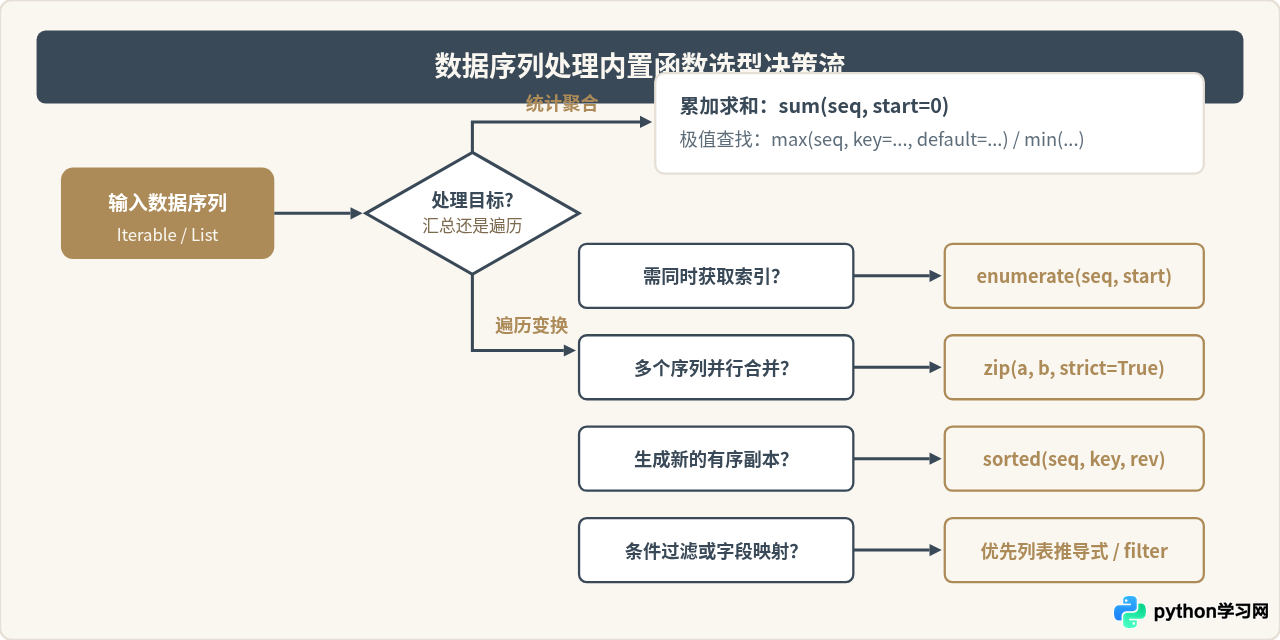
三、序列遍历与迭代器工具
迭代是 Python 编程的核心范式。内置函数提供了诸多高阶迭代器,用于解决循环索引、并行遍历与元素排序等基础需求。
1. 索引遍历与多序列打包:enumerate 与 zip
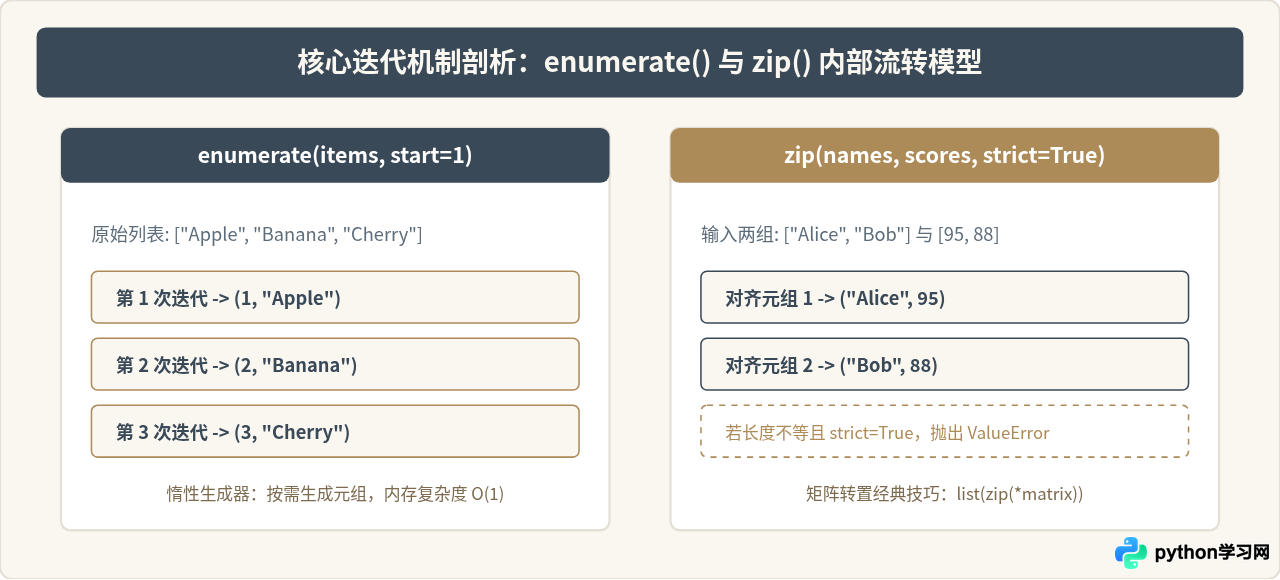
enumerate(iterable, start=0) 生成带有计数索引的元组 (index, item)。避免在循环中手动维护外部计数器 i += 1。
zip(*iterables, strict=False) 像拉链一样并行聚合多个可迭代对象。在 Python 3.10 及以上版本中,强烈建议在期望输入等长时显式开启 strict=True,若序列长度不一致将主动抛出 ValueError,有效规避静默丢失尾部数据的严重隐患。
2. 排序与翻转:sorted 与 reversed
sorted(iterable, key=None, reverse=False):接收任何可迭代对象,在内存中排序并返回全新的列表。原序列保持不变。与列表的原生方法list.sort()相比,sorted()适用于所有序列及生成器,且不会破坏输入数据。reversed(seq):返回反向迭代器。该函数要求目标对象必须实现__reversed__()方法,或支持带__len__()和以零起始整数索引的序列协议。
# 字典按值倒序排序
sales = {"item_A": 340, "item_B": 890, "item_C": 120}
sorted_sales = sorted(sales.items(), key=lambda x: x[1], reverse=True)
# 输出: [('item_B', 890), ('item_A', 340), ('item_C', 120')]
四、对象自省、反射与动态属性
自省(Introspection)是 Python 动态语言特性的基石。它允许程序在运行期探测、判定并操作未知对象的结构。
1. 类型判定:isinstance 与 type
在工程实践中,强烈建议优先使用 isinstance() 而非 type() == ... 进行类型断言。原因如下:
isinstance(obj, class_or_tuple)能够正确处理继承关系。若Dog继承自Animal,isinstance(my_dog, Animal)为True。isinstance()支持传入类元组,例如isinstance(val, (int, float)),能够一行代码判断是否为数值类,可读性与效率更高。- 直接使用
type(obj) is int会破坏面向对象的多态性,导致子类实例无法通过校验。
2. 反射四件套:getattr, hasattr, setattr, delattr
这四个函数构成了 Python 的动态反射操作体系,广泛应用于插件化架构、中间件分发与序列化反序列化库中:
hasattr(object, name):检查对象是否存在指定属性或方法。getattr(object, name, default=None):动态获取属性或方法对象。提供default参数可在属性缺失时静默降级,避免触发AttributeError。setattr(object, name, value):为对象动态赋值新属性或覆盖现有属性。callable(object):检查目标对象是否可调用(如普通函数、类、或者实现了__call__的类实例)。
# 典型的动态路由/命令派发模型
class CommandHandler:
    def handle_login(self, payload):
        return f"处理登录逻辑: {payload.get('user')}"

handler = CommandHandler()
action_name = "login"

# 动态解析方法并执行
method_name = f"handle_{action_name}"
if hasattr(handler, method_name):
    method = getattr(handler, method_name)
    if callable(method):
        result = method({"user": "admin"})
五、系统交互、真值聚合与高级避坑
1. 常用输入输出:print 与 open
print(*objects, sep=' ', end='\n', file=None, flush=False):日常日志与控制台输出的核心。当在长时间运行的脚本中输出阶段状态时,设置 flush=True 可强制刷新内部缓冲区,防止输出由于管道缓冲而延迟显示。
open(file, mode='r', encoding=None):文件系统操作的核心入口。必须使用 with open(...) 上下文管理器以确保文件描述符在异常时依然能够正确释放,且在读取非二进制文件时,务必显式声明 encoding="utf-8",避免跨平台(如 Windows 默认的 gbk 与 Linux 默认的 utf-8)导致乱码。
2. 真值聚合短路:all 与 any 的空集合陷阱
all(iterable) 与 any(iterable) 分别用于判断序列中是否“全部为真”或“存在任一为真”。它们均具备短路特性:any 遇到首个真值即刻返回,all 遇到首个假值即刻返回。
•
all([]) 的返回值是 True。
•
any([]) 的返回值是 False。
若业务逻辑中“空列表代表无权限或未通过校验”,切记不能直接写
if all(checks):,而应显式补充非空校验:if checks and all(checks):。
六、高频内置函数功能速查表
下表汇总了日常编码中最核心的内置函数及其参数速记与最佳应用场景:
| 函数名 | 典型入参签名 | 返回值特性 | 推荐使用场景 |
|---|---|---|---|
enumerate() |
(seq, start=0) |
惰性迭代器,返回 (index, item) |
带行号循环、进度日志打印、数组映射 |
zip() |
(*iterables, strict=False) |
惰性迭代器,打包元组流 | 多表并行合并、字典对齐、矩阵转置 zip(*m) |
sorted() |
(iterable, key=None, reverse=False) |
新 list 实例 |
不可破坏原数据时的排序、对非列表容器排序 |
divmod() |
(a, b) |
(商, 余数) 二元组 |
数据分页计算、时间戳拆分为时分秒 |
isinstance() |
(obj, class_or_tuple) |
bool |
类型前置守卫断言、支持多类型元组判定 |
getattr() |
(obj, name, default=None) |
属性值或方法引用 | 插件钩子派发、配置动态读取、安全解耦 |
all() / any() |
(iterable) |
bool(具备短路机制) |
表单批量有效性检查、条件集合状态聚合 |
max() / min() |
(iterable, key=..., default=...) |
单个极值对象 | 按复杂业务字段查找极值对象 |
熟练运用上述内置函数,不仅能减少重复代码和临时变量的产生,更能依托 CPython 底层的 C 实现获得显著的执行性能提升。在日常编写代码时,建议优先通过内置函数完成基础的数据流操作。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















