


Python新手必装的10个核心第三方库
精选Python新手开发中最为核心的10个第三方库,涵盖网络请求、数据处理、工程规范与自动化工具,提供安装指南、代码示例与进阶选型建议。
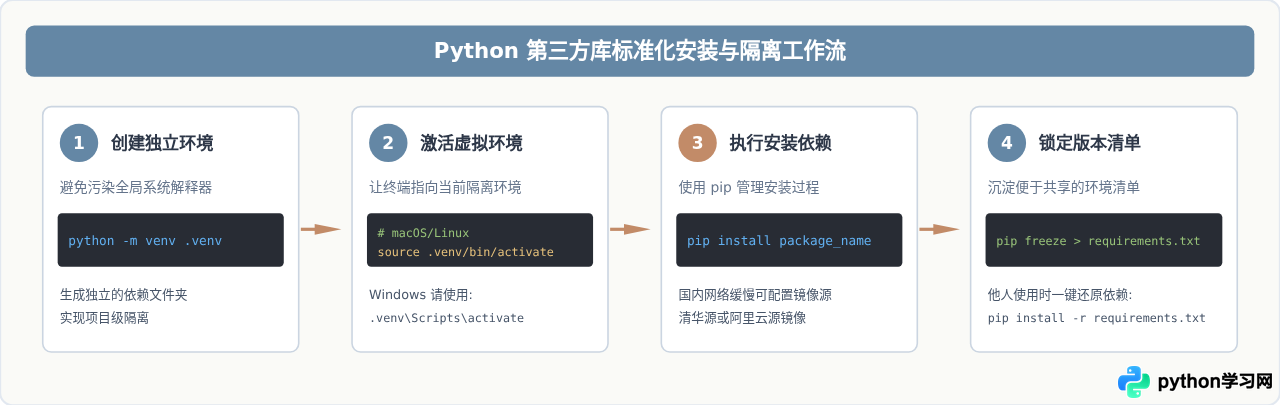
一、标准规范:安装前必备的工作流
在安装任何第三方库之前,新手最容易踩的陷阱是将所有库混杂安装到全局系统 Python 环境中。这不仅容易导致版本依赖冲突,还可能在未来升级系统时破坏现有脚本。标准做法是为每个项目创建独立的虚拟环境,并在该环境中进行包管理。
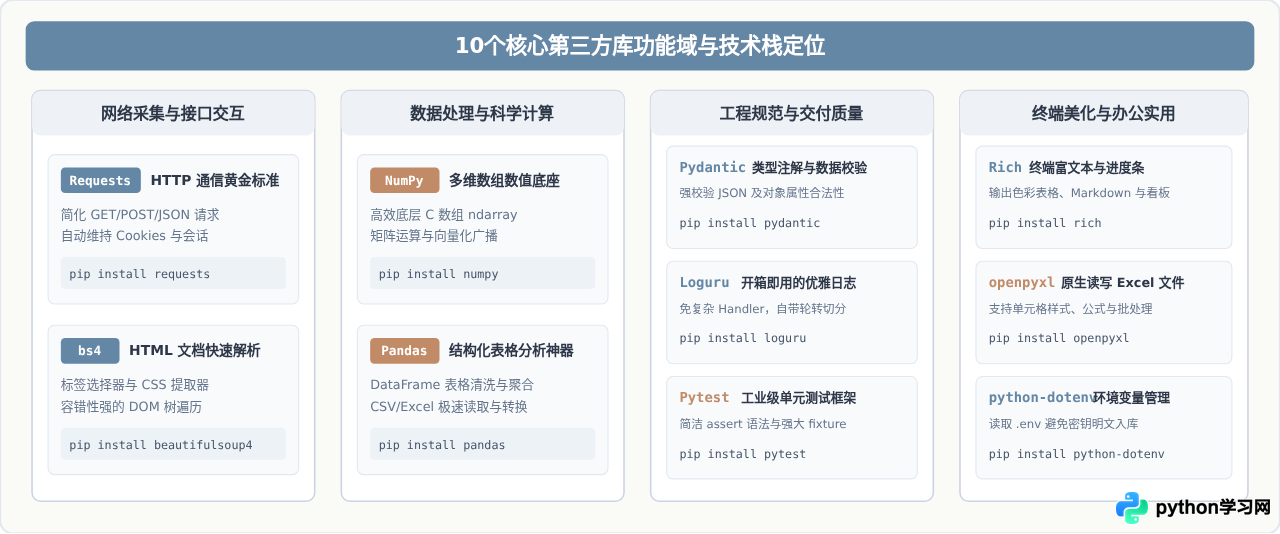
二、10个核心第三方库全景分布
一个初学者的实际编码路径,通常会经历“获取外部数据”、“清洗与分析数据”、“提升工程健壮性”以及“自动化输出成果”四个典型阶段。以下 10 个库分别在这四个阶段承担着基础支柱的角色:
三、核心库深度解析与实操示例
1. Requests:人见人爱的 HTTP 客户端
虽然 Python 内置了 urllib,但其 API 繁冗晦涩,单是处理编码、POST 表单或 Basic 认证就需书写大量样板代码。requests 封装了完整的 HTTP 交互逻辑,几乎成为现代网络调用的事实标准。
import requests

# 抓取在线 JSON 接口
response = requests.get(
    "https://httpbin.org/get",
    params={"tag": "python", "page": 1},
    timeout=5
)

# 校验 HTTP 状态码并转为字典
if response.status_code == 200:
    data = response.json()
    print("返回的主机信息:", data.get("origin"))
else:
    print("请求失败,状态码:", response.status_code)
requests.get() 或 requests.post() 时务必显式传入 timeout 参数(如 5 秒)。默认情况下请求不会超时,若远程服务器无响应,程序将无限期挂起。
2. BeautifulSoup4:容错性极佳的 HTML 解析工具
从网页中抓取数据时,未经规范校验的 HTML 代码常常存在标签漏闭合、排版错乱等问题。beautifulsoup4 配合底层解析器 lxml,能够将杂乱的 HTML 字符串构建为易于检索的树状节点。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
    <h2>文章标题</h2>
    <ul class="item-list">
        <li><a href="/item/1">第一讲:基础环境</a></li>
        <li><a href="/item/2">第二讲:数据提取</a></li>
    </ul>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
# 支持 CSS 选择器语法
links = soup.select(".item-list li a")
for link in links:
    print(f"标题: {link.text.strip()}, 链接: {link.get('href')}")
3. NumPy:科学计算与数值运算基础
Python 原生列表(list)由通用对象指针构成,遍历计算时存在大量类型解包与内存寻址开销。numpy 提供了连续内存存放的同构多维数组 ndarray,在底层由 C 语言实现,支持高效的向量化计算与广播运算。
import numpy as np

# 创建一维数值数组并进行批量乘法
arr = np.array([10, 20, 30, 40, 50])
# 向量化操作:无需写 for 循环
result = arr * 1.5 + 5
print("运算后数组:", result)

# 基础统计分析
print(f"均值: {np.mean(result)}, 标准差: {np.std(result):.2f}")
4. Pandas:结构化数据表格的分析利器
如果说 numpy 是纯粹的数值底座,那么 pandas 则是面向实际业务分析的终极工具。它提供了如同 Excel 般的 DataFrame 二维表格对象,能轻松完成行列过滤、缺失值处理、分组聚合(GroupBy)及透视表统计。
import pandas as pd

# 从字典直接构造数据表
data = {
    "部门": ["技术部", "市场部", "技术部", "运营部", "市场部"],
    "姓名": ["张伟", "李雷", "韩梅梅", "赵云", "孙策"],
    "绩效分": [92, 85, 96, 78, 88]
}
df = pd.DataFrame(data)

# 筛选绩效大于85分且按部门统计平均分
high_performers = df[df["绩效分"] > 85]
dept_avg = df.groupby("部门")["绩效分"].mean().reset_index()

print("部门平均分统计:\n", dept_avg)
5. Pydantic:类型提示与数据解析强约束
动态类型是 Python 的优势,但在处理外部传入的 JSON、表单数据或配置文件时,缺乏类型校验容易引发大量的运行时异常。pydantic 借助原生 Type Hints,能够自动完成数据类型转换、默认值赋予与异常拦截。
from pydantic import BaseModel, Field

class UserProfile(BaseModel):
    id: int
    name: str = Field(min_length=2, max_length=20)
    email: str
    is_active: bool = True

# 外部传入数据(例如数字传入为字符串 "101" 时,会自动强制转换)
raw_input = {"id": "101", "name": "王小明", "email": "xiaoming@example.com"}
user = UserProfile(**raw_input)

print(f"校验成功,用户ID为整型: {user.id} (类型: {type(user.id)})")
6. Rich:让终端输出变得专业与生动
很多初学者编写脚本时,终端仅有单调的 print() 输出,排查错误时费时费力。rich 允许开发者在终端中输出带格式的高亮文字、直观的表格、进度条甚至 Markdown 内容。
from rich.console import Console
from rich.table import Table

console = Console()

table = Table(title="服务器健康状态监控", style="bold #6487A5")
table.add_column("服务节点", style="cyan")
table.add_column("延迟(ms)", justify="right", style="magenta")
table.add_column("状态", justify="center")

table.add_row("Node-A (北京)", "14.2", "[bold green]ONLINE[/bold green]")
table.add_row("Node-B (上海)", "22.8", "[bold green]ONLINE[/bold green]")
table.add_row("Node-C (广州)", "--", "[bold red]TIMEOUT[/bold red]")

console.print(table)
7. Loguru:彻底抛弃繁琐配置的日志框架
标准库的 logging 模块设计严格遵循 Java Log4j 的层级模式,配置 Formatter、Handler 和 Logger 需要十几行样板代码。loguru 引入了单一的 logger 实例,支持开箱即用的着色输出、自动捕获异常堆栈和一键日志文件归档轮转。
from loguru import logger
import sys

# 添加日志文件输出,达到10MB自动轮转,保存7天
logger.add("app_run.log", rotation="10 MB", retention="7 days", level="INFO")

logger.info("任务调度程序启动完成。")

try:
    calc = 100 / 0
except ZeroDivisionError:
    # 自动格式化带有变量上下文的完整 traceback
    logger.exception("数学计算发生除零错误")
8. python-dotenv:保护敏感凭证与环境隔离
在开发过程中,数据库密码、API Key 等机密信息绝不能硬编码在 .py 源码中提交到版本仓库。python-dotenv 能够自动寻找工程根目录下的 .env 文件,并将其声明的键值注入系统的环境变量。
from dotenv import load_dotenv
import os

# 读取根目录下的 .env 文件
load_dotenv()

# 从环境变量中读取配置,第二个参数为未找到时的默认值
api_key = os.getenv("DEEPSEEK_API_KEY", "default_mock_key")
db_port = int(os.getenv("DB_PORT", "5432"))

print(f"当前配置连接端口: {db_port}")
.env 文件的同时,请务必在 .gitignore 中追加一行 .env,防止密钥意外推送到远程代码平台。
9. openpyxl:办公自动化中的 Excel 读写利器
虽然 pandas 能处理数据表格,但若需要对现有的 .xlsx 模板进行单元格着色、批注插入或公式保留,openpyxl 更加精细和可控,是各类自动化办公报表脚本的首选依赖。
import openpyxl

# 创建新工作簿
wb = openpyxl.Workbook()
ws = wb.active
ws.title = "销售月报"

# 写入表头与数据
ws.append(["日期", "商品名称", "销售额(元)"])
ws.append(["2026-03-01", "机械键盘", 299])
ws.append(["2026-03-02", "人体工学椅", 1280])

# 设置简单公式
ws["B4"] = "合计"
ws["C4"] = "=SUM(C2:C3)"

wb.save("销售数据汇总.xlsx")
10. Pytest:简洁可靠的工业级测试框架
标准库 unittest 继承了面向对象的测试类写法,断言需使用 self.assertEqual()。而 pytest 允许直接使用原生 Python 的 assert 关键字,在测试失败时自动展开表达式两端的详细对比,极大降低了写测试的心理门槛。
# test_calculator.py
def add(x, y):
    return x + y

def divide(x, y):
    if y == 0:
        raise ValueError("除数不能为0")
    return x / y

def test_add_success():
    assert add(2, 3) == 5

def test_add_float():
    assert add(0.1, 0.2) != 0.3  # 浮点数精度典型场景
在命令行直接运行 pytest,框架会自动扫描所有以 test_*.py 命名的文件并输出清晰的测试报告。
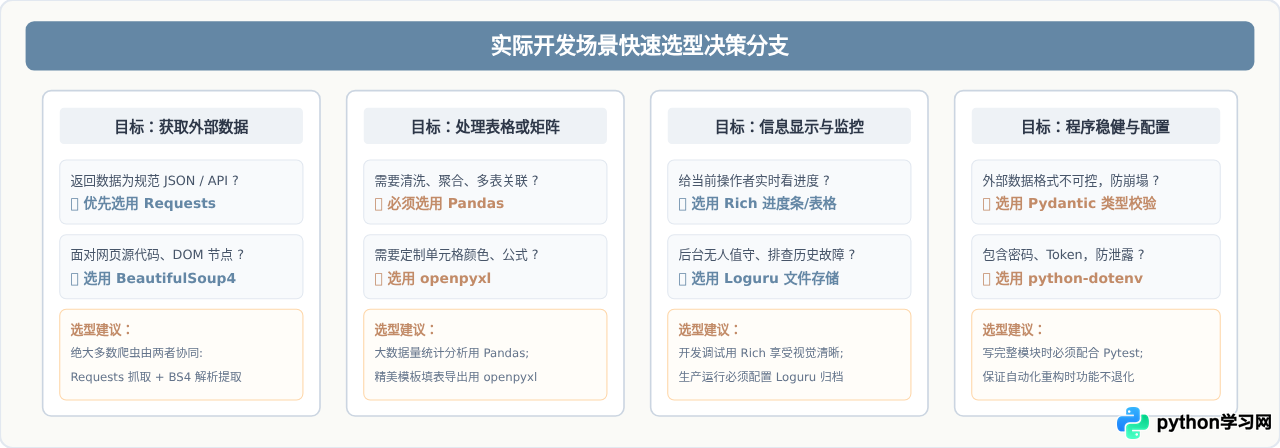
四、场景选型决策:如何选择合适的库?
面对类似的功能需求,初学者常常困惑于该使用哪一个库。以下决策树梳理了针对不同开发目标的优先选用规则:
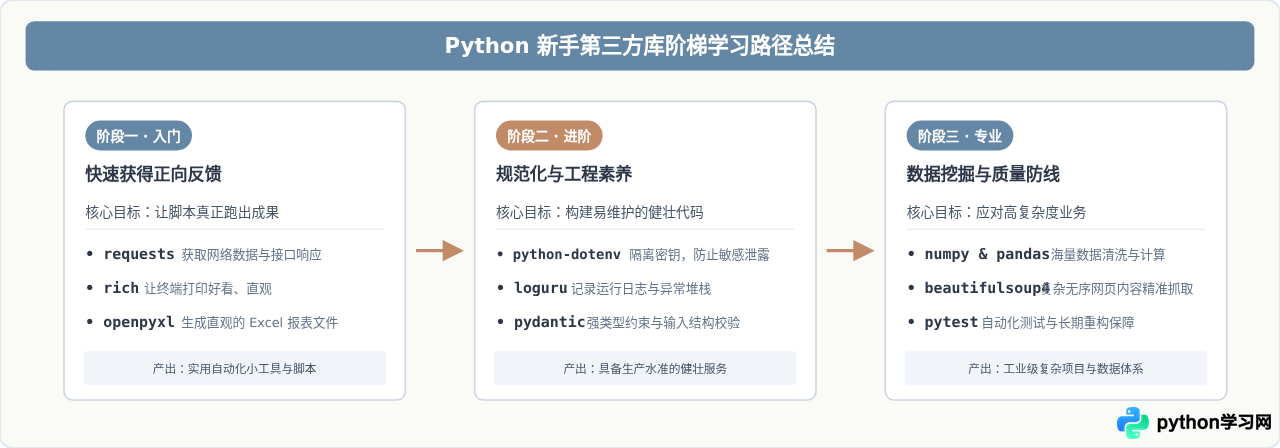
五、总结与学习路径规划
掌握第三方库并不是指要强行死记硬背每个库里成百上千个函数,而是理解它们解决的痛点边界,并掌握“查阅官方文档、运行最小可行示例(MVP)、按需引入”的能力。
速查汇总表格
| 库名称 | 安装命令 | 核心使用场景 | 替代内置库或优势 |
|---|---|---|---|
| Requests | pip install requests |
HTTP GET/POST 接口调用与网络通信 | 相比 urllib 减少 80% 样板代码,自动维持 session |
| BeautifulSoup4 | pip install beautifulsoup4 |
HTML / XML 文档解析与网页数据提取 | 容错率极高,支持 CSS 选择器遍历 DOM |
| NumPy | pip install numpy |
多维数组数值计算与矩阵代数 | 底层 C 数组连续内存,运算性能远超原生 list |
| Pandas | pip install pandas |
二维结构化表格(DataFrame)清洗与统计 | 支持 CSV/Excel/SQL 一键载入与高效 GroupBy 聚合 |
| Pydantic | pip install pydantic |
基于类型注解的数据验证与转换 | 解析复杂嵌套字典,提供清晰字段报错 |
| Rich | pip install rich |
终端彩色文字、表格、进度条与调试看板 | 开箱美化命令行输出,调试体验优异 |
| Loguru | pip install loguru |
现代工程日志记录与异常追踪 | 省去 logging 繁琐配置,自动文件切分与着色 |
| python-dotenv | pip install python-dotenv |
从 .env 文件读取环境变量配置 |
敏感密钥与代码仓库解耦,杜绝泄露隐患 |
| openpyxl | pip install openpyxl |
读写 Excel (.xlsx) 电子表格 |
原生支持样式定制、公式填报与模版修改 |
| Pytest | pip install pytest |
自动化单元测试与测试套件管理 | 直接使用原生 assert,插件生态极其成熟 |
在日常开发中,推荐首先在每个新项目中通过 python -m venv .venv 建立独立环境,结合上述 10 个库的定位按需引入,并使用 pip freeze > requirements.txt 锁定依赖。循序渐进地将这些库融入编码实践中,便能以最优雅、规范的方式解决绝大部分现实工程问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















