


金融与电商场景下常用的Python数据分析模型组合推荐
针对金融风控与电商业务场景,系统解析常用的Python数据分析模型组合方案,涵盖信贷评分、反欺诈检测、用户生命周期分群与营销增量评估,提供端到端技术实现与选型建议。
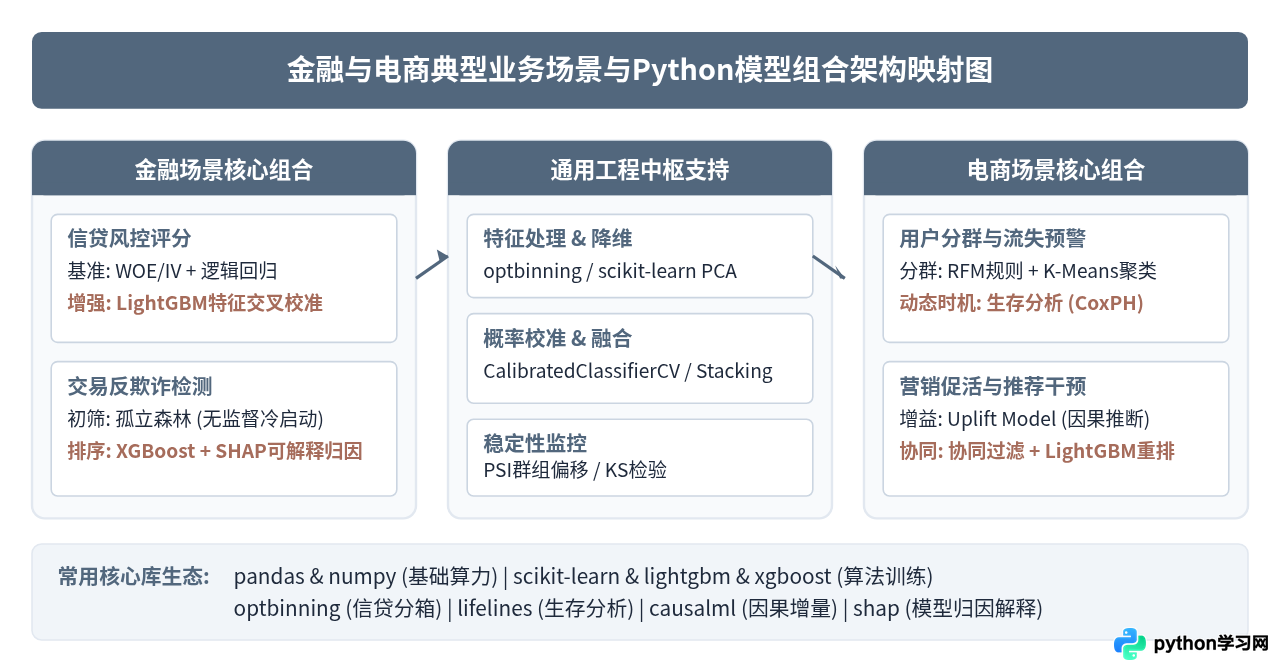
在企业级数据科学实践中,单一算法极少能够完整覆盖业务链条的实际诉求。金融风控既要求严苛的监管可解释性,又要求对违约违规行为具备敏锐的非线性捕获能力;电商分析则需要在数以千万计的异构行为数据中,兼顾客群划分、流失时机预测与营销干预的真实净增收益。本文将核心聚焦点落在“模型组合”这一工程落地策略上,拆解金融信贷风控、交易反欺诈、电商客户分群生命周期分析以及营销增量(Uplift)四大高频业务场景,提供行之有效的Python算法搭档方案与代码实现逻辑。
一、金融场景推荐组合:WOE逻辑回归评分卡 + LightGBM双轨协同
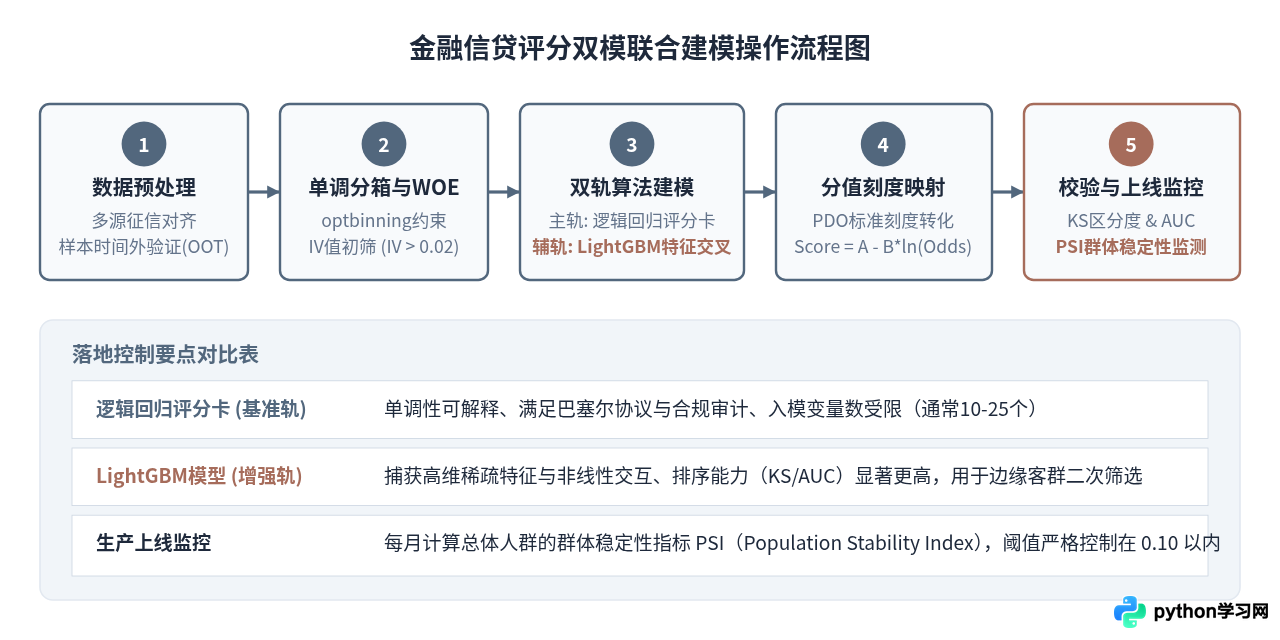
在消费金融与小微企业信贷审批中,监管机构要求授信决策具备清晰的归因链条。如果仅依赖深度学习或复杂树模型给出拒绝结论,往往面临无法向客户与审计机构明确解释拒贷原因的合规风险。然而,纯线性模型在挖掘非线性特征交叉与隐性违约模式时能力受限。因此,业界普遍采用“基线评分卡(主裁判)+ 集成树模型(辅助判别与特征挖掘)”的双轨组合模式。
1. 组合工作逻辑
基线部分使用 optbinning 对连续变量进行单调分箱,计算信息价值(Information Value, IV)并转换证据权重(Weight of Evidence, WOE),再通过带惩罚项的逻辑回归(Logistic Regression)输出基础信用评分。与此同时,并行运行一套以 LightGBM 为核心的高维预测模型,该模型接收原始特征与衍生交叉特征,输出高阶概率预测。双轨协同的方式通常包括两种:
- 特征工程管道协同: 利用 LightGBM 提取每棵树叶子节点的命中索引(Leaf Index),将其作为高阶交叉类别特征送入评分卡,或者利用 SHAP 值筛选非线性交互特征,反哺评分卡分箱设计。
- 拒绝推断与灰度复审: 评分卡作为主裁系统处理低风险通过区与极高风险拒绝区;处于评分模糊边界的灰色客群,由 LightGBM 输出精细概率结合业务策略进行二道复审。
2. 核心实施代码示例
下述代码展示如何在Python环境中运用 optbinning 进行最优分箱,并将分箱转换结果送入逻辑回归作为基线模型:
import pandas as pd
import numpy as np
from optbinning import OptimalBinning, BinningProcess
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

# 示例数据加载(实际业务中包含征信、还款及设备属性)
# X_train: 特征矩阵, y_train: 违约标签 (0: 正常, 1: 逾期)

# 1. 定义需进行最优分箱的特征列表
categorical_features = ["marriage_status", "job_type"]
numerical_features = ["debt_to_income_ratio", "recent_inquiry_count", "credit_limit_used_rate"]

# 2. 批量构建满足单调性或U型约束的分箱处理器
binning_process = BinningProcess(
    variable_names=numerical_features + categorical_features,
    categorical_variables=categorical_features,
    min_n_samples=0.05,       # 每个分箱样本占比不低于5%
    max_pvalue=0.05           # 相邻分箱坏账率差异显著性约束
)

# 拟合分箱并计算 WOE 与 IV 值
binning_process.fit(X_train, y_train)

# 查看各变量的 IV (Information Value) 汇总表
iv_summary = binning_process.summary()
print("变量IV排序与分箱质量:\n", iv_summary[["name", "iv", "quality_score"]])

# 3. 转换训练集与验证集为 WOE 编码值
X_train_woe = binning_process.transform(X_train)
X_test_woe = binning_process.transform(X_test)

# 4. 构建可解释评分卡底层逻辑回归
lr_scorecard = LogisticRegression(C=0.1, penalty='l2', solver='lbfgs', max_iter=500)
lr_scorecard.fit(X_train_woe, y_train)

# 5. 验证基准表现
y_pred_proba = lr_scorecard.predict_proba(X_test_woe)[:, 1]
print(f"基准评分卡 AUC: {roc_auc_score(y_test, y_pred_proba):.4f}")
train 集合上 fit 并仅对 test 和 OOT(跨时间样本) 做 transform,以防止标签信息泄露(Data Leakage)。
二、金融反欺诈场景推荐组合:孤立森林(无监督) + XGBoost/CatBoost(有监督)
交易反欺诈面对的问题与信贷风控有本质区别:欺诈样本在真实业务中极度不平衡(常低于万分之五),且欺诈黑产团伙的手法日新月异,导致模型在冷启动期或者新型攻击爆发时面临“缺乏标注黑样本”的困境。
1. 组合工作逻辑
单一的有监督模型在零黑样或样本严重不平衡时极易产生严重过拟合。实战中推荐采用“孤立森林(Isolation Forest)冷启动初筛 + XGBoost/CatBoost 精准排序”的阶梯式组合架构:
- 阶梯一(无监督离群过滤): 孤立森林基于“异常点更容易在多维特征树中较早被孤立划分”的原理,无需标签即可对高频交易(如IP频繁切换、短时间异地登录、大额突增转账)计算异常度得分,快速将疑似可疑流量圈定在 top 1% 范围。
- 阶梯二(有监督排序与特征回流): 将孤立森林输出的
anomaly_score作为一个高权重数值特征,与关联图谱衍生指标(如一度/二度关联黑名单数量)一同注入 XGBoost 模型中。结合 focal loss 或调整scale_pos_weight处理不平衡问题。 - 阶梯三(SHAP 实时归因): 针对高危拦截交易,利用
shap.TreeExplainer生成单笔交易的贡献力排序,为风控中台运营人员提供可信的拦截原因。
三、电商场景推荐组合:RFM + K-Means 分群与生存分析流失预警
在电商用户运营中,用户行为呈现高频但离散的特点。运营团队经常问两个问题:第一,“这批用户属于什么价值梯队?”;第二,“他们会在什么时候流失?”传统的做法是给出一个固定的阈值(例如30天未下单定义为流失),然后跑一个二分类分类器。然而,这种处理方式忽略了购买周期的自然异质性——购买母婴奶粉的周期与购买耐用品电器的周期完全不同,二分类模型无法给出具体的时效预期。
1. 组合工作逻辑
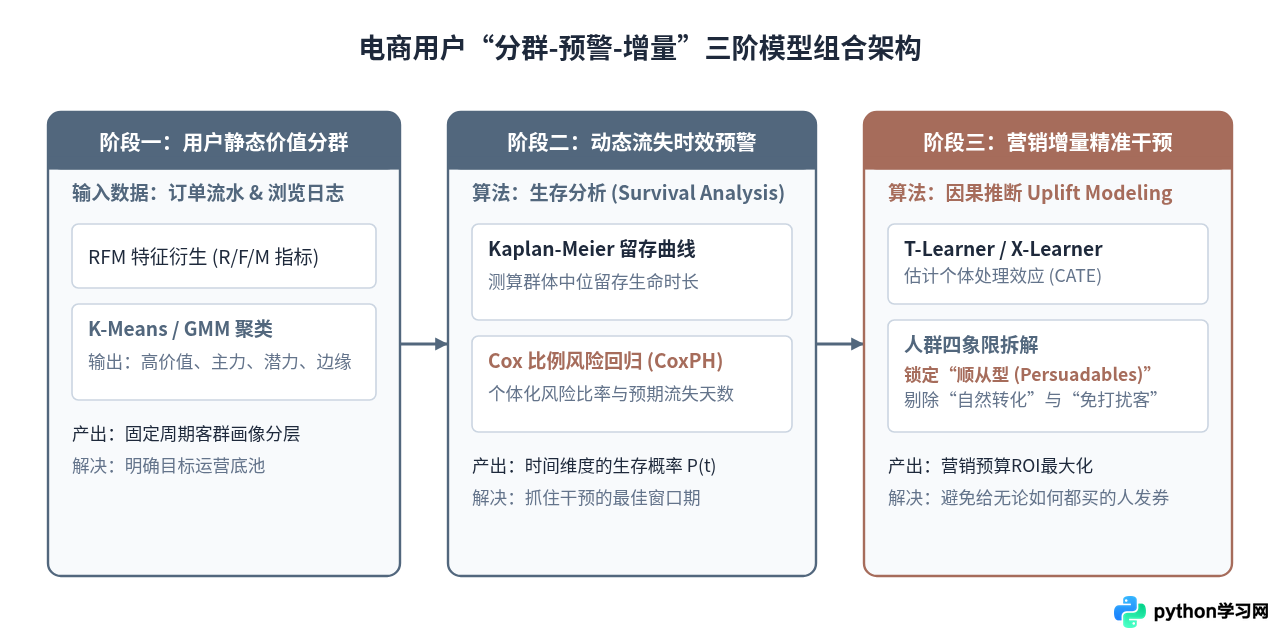
为了精确把握用户活跃流失节律,推荐采用“RFM + K-Means 聚类静态划分”搭档“Cox 比例风险模型(Cox Proportional Hazards)动态生命周期预测”:
- RFM + K-Means: 抽取客户的消费最近时间(Recency)、频次(Frequency)、金额(Monetary),标准化后利用 K-Means 形成业务可解释的 4-8 个客群。这一步解决了宏观分层与业务认知对齐的问题。
- Cox 比例风险模型(基于
lifelines库): 引入右删失数据(Right Censoring)。未流失的用户并不代表永远不流失,其状态仅仅是在当前时间窗口内“尚未观测到流失事件”。CoxPH 模型不仅能输出特定时间 \(t\) 内用户的生存概率曲线,还能解析各项协变量(如最近30天互动频次、领券使用率、客单价变动)对流失风险比率(Hazard Ratio)的边际贡献。
2. 生存分析建模 Python 示例
import pandas as pd
from lifelines import CoxPHFitter
from lifelines.utils import concordance_index

# 构造/读取用户生存数据:
# duration: 观测时长(天)
# churn_event: 观测期末是否发生流失 (1: 已流失, 0: 未流失/删失)
# 协变量: rfm 指标及行为交互特征

cph = CoxPHFitter(penalizer=0.01)
cph.fit(user_survival_df, duration_col='duration', event_col='churn_event')

# 输出变量对流失风险的影响倍数 (exp(coef))
cph.print_summary()

# 预测指定高价值客群在未来 7天、15天、30天的存活概率
target_users = user_survival_df.loc[high_value_cluster_ids].drop(columns=['duration', 'churn_event'])
survival_curves = cph.predict_survival_function(target_users, times=[7, 15, 30])
print("未来时间节点的存活概率矩阵:\n", survival_curves.head())
四、电商营销场景推荐组合:因果推断 Uplift Model + 协同过滤重排
在电商营销与发券运营中,最常见的失误是将资源浪费在“哪怕不发券也会自然下单”的高忠诚用户身上,或者误触“因频繁促销推送而产生厌烦直接退订”的敏感用户。传统的二分类响应模型(Response Model)预测的是 \(P(Y=1|X, T=1)\),即“在给予营销动作下用户购买的概率”,但这完全无法衡量“营销动作本身带来的净增转化”。
1. 增益模型(Uplift Modeling)四象限分解
因果推断增益模型旨在估算个体处理效应(Conditional Average Treatment Effect, CATE):
$$\tau(X) = E[Y | X, T=1] - E[Y | X, T=0]$$
其中 \(T=1\) 为营销干预(如发满减券),\(T=0\) 为自然对照组。增益模型将用户拆分为四个核心群体:
- 顺从型(Persuadables): 发券才会买,不发券不买。这是营销动作的核心目标人群,\(\tau(X) > 0\)。
- 无论如何都会买(Sure Things): 不发券也会自然购买,发券只会造成利润白白损失(Coupon Cannibalization)。
- 无论如何都不买(Lost Causes): 即使发券也不下单,推送券码徒增触达成本。
- 免打扰/反向受损型(Sleeping Dogs): 原本有购买意向或正常留存,发券通知反而打扰其正常节奏导致卸载或退订,\(\tau(X) < 0\)。
2. T-Learner 双模型组合构建
在工程实现中,最稳健高效的做法是采用元学习器中的 T-Learner(Two-Model approach):分别在对照组与实验组上训练两个独立的梯度提升树(如 LightGBM),两者预测差值即为每个个体的增益分数。
import numpy as np
import lightgbm as lgb

# 假定数据集包含特征矩阵 X, 是否干预 treatment (1/0), 以及是否购买 conversion (1/0)
# 1. 拆分实验组与对照组
X_treatment = X[treatment == 1]
y_treatment = conversion[treatment == 1]

X_control = X[treatment == 0]
y_control = conversion[treatment == 0]

# 2. 分别构建两套 LightGBM 分类器
model_treatment = lgb.LGBMClassifier(n_estimators=100, learning_rate=0.05, max_depth=4)
model_treatment.fit(X_treatment, y_treatment)

model_control = lgb.LGBMClassifier(n_estimators=100, learning_rate=0.05, max_depth=4)
model_control.fit(X_control, y_control)

# 3. 对全体候选池用户评估个体增益效应 (CATE)
pred_treatment_prob = model_treatment.predict_proba(X_candidates)[:, 1]
pred_control_prob = model_control.predict_proba(X_candidates)[:, 1]

# 计算每位用户的纯增量 (Uplift Score)
uplift_score = pred_treatment_prob - pred_control_prob

# 4. 根据 Uplift 分数降序排列,仅对 Uplift 显著为正且位于 top 20% 的用户下发优惠券
qualified_mask = uplift_score > 0.05
print(f"推荐发放优惠券的高增量客群规模: {np.sum(qualified_mask)}")
五、实战选型决策指南与落地避坑
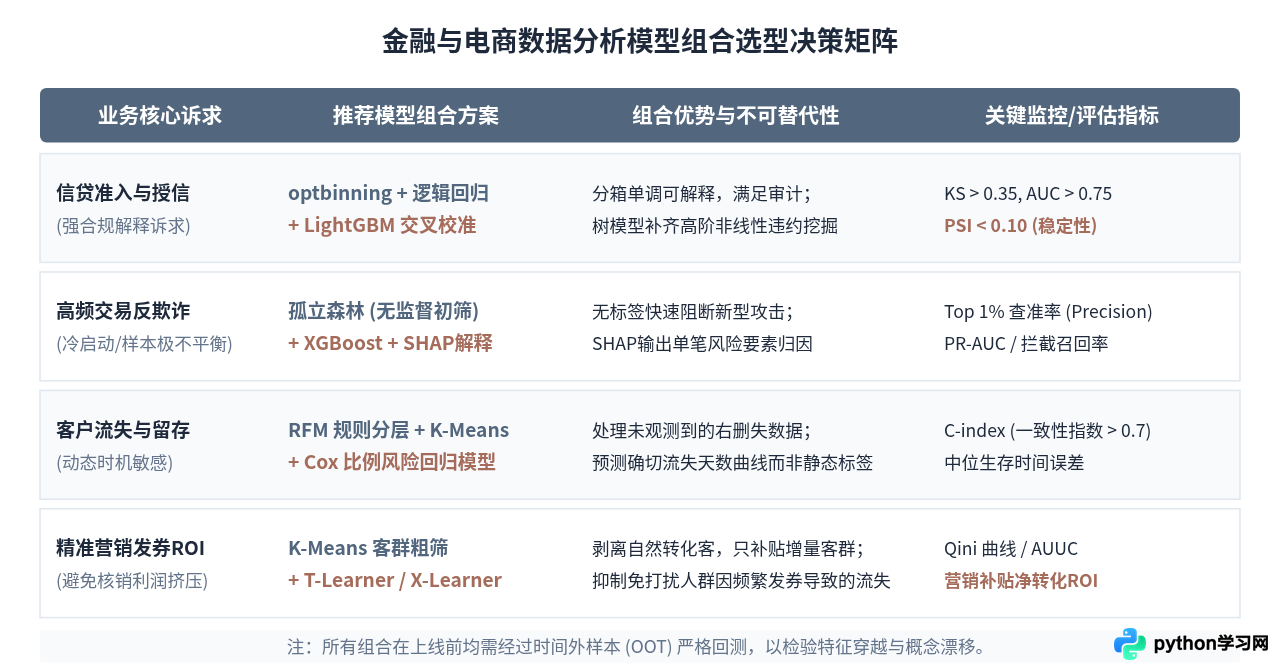
当面临一个具体的业务需求时,如何快速判断应该采用哪种模型组合?我们整理了如下决策矩阵,帮助读者根据“可解释性要求”、“数据时效”和“业务干预成本”进行高效匹配。
实战落地三项核心避坑原则
- 坚决防范数据穿越(Lookahead Bias): 特别是在电商流失预警与金融还款预测中,严禁在特征工程阶段引入未来事件。例如,计算用户“过去30天的平均客单价”时,时间窗口的终点必须严格对齐特征截止日(Cut-off Date),绝不可混入预测期内的任何衍生数据。
- 必须跟踪群体稳定性指标(PSI): 在真实生产环境中,外部环境(如大促活动、突发宏观调控)会导致客户特征分布产生剧烈漂移。每周或每月定期监控所有核心入模特征的 PSI,一旦某特征 PSI > 0.25,必须立即触发降级策略或自动化重训练机制。
- 因果推断必须先做随机化对照试验(A/B Test): 在应用 Uplift 模型之前,历史数据必须包含严格随机的对照组(Holdout Group)。若历史策略存在明显的有偏发券倾向(如只给活跃用户发券),模型学到的将是策略偏差而非真实的干预效应。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















