


Python程序设计基础教程函数定义习题答案与常见报错修正
针对Python程序设计基础教程中的函数定义章节,精选典型课后习题提供标准解答与逻辑拆解,并深度剖析修正SyntaxError、TypeError、UnboundLocalError等高频报错及默认参数陷阱。
一、函数定义核心概念与参数传递机制
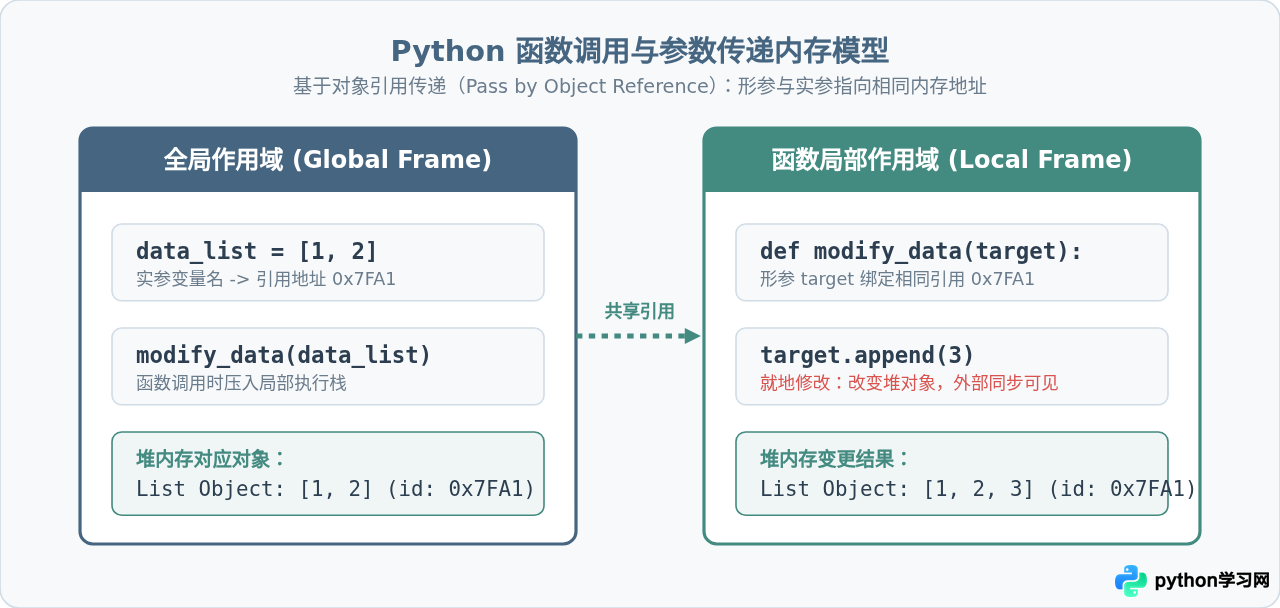
在 Python 中,函数使用 def 关键字定义。函数体内的语句直到该函数被调用时才会执行。很多初学者在编写函数时常把“参数传递”与“全局变量赋值”混淆。理解 Python 的函数执行模型,关键在于掌握对象引用传递(Pass by Object Reference)。
当实参传递给形参时,传递的是该对象在内存中的地址引用,而不是对象本身的深拷贝:
- 不可变类型(int, float, str, tuple):在函数内部尝试重新赋值时,由于对象本身不可变,Python 会在局部作用域创建新对象并改变形参绑定,外部变量的值不受影响。
- 可变类型(list, dict, set):如果通过形参调用其就地修改方法(如
append()、pop()、update()),由于形参和实参指向堆内存中的同一个对象,外部变量所持有的内容会同步改变。
二、典型函数习题解析与标准代码实现
教程中的函数习题通常涵盖数学运算、容器处理、变长参数以及基础递归。以下选取四类最具考核价值的标准习题进行详细解答。
习题 1:素数判定与区间素数统计
题目要求:编写函数 is_prime(n),接收一个正整数 n,若是素数返回 True,否则返回 False。再编写函数 count_primes(start, end),统计区间 [start, end] 内所有素数的个数并返回其列表。
def is_prime(n):
    """判断正整数 n 是否为素数"""
    if n <= 1:
        return False
    if n == 2:
        return True
    if n % 2 == 0:
        return False
    # 只需检查至平方根即可,步长为 2 排除偶数
    limit = int(n ** 0.5) + 1
    for i in range(3, limit, 2):
        if n % i == 0:
            return False
    return True

def count_primes(start, end):
    """统计 [start, end] 区间内的所有素数"""
    if start > end:
        return []
    primes = []
    for num in range(start, end + 1):
        if is_prime(num):
            primes.append(num)
    return primes

# 示例调用与验证
res = count_primes(10, 30)
print(f"10到30之间的素数列表: {res}")
print(f"素数总数: {len(res)}")
# 示例输出:
# 10到30之间的素数列表: [11, 13, 17, 19, 23, 29]
# 素数总数: 6
习题 2:序列数据保序去重与频次统计
题目要求:编写函数 deduplicate_keep_order(items),接收一个包含重复元素的列表,返回一个去重后的新列表,且必须保留元素在原列表中首次出现的相对次序。不得直接使用 list(set(items)),因为集合是无序的。
def deduplicate_keep_order(items):
    """
    对列表进行保序去重
    使用辅助 set 记录已遍历元素,实现 O(1) 的时间查找复杂度
    """
    seen = set()
    result = []
    for item in items:
        if item not in seen:
            seen.add(item)
            result.append(item)
    return result

# 示例调用
raw_list = [3, 1, 2, 3, 4, 1, 5, 2]
clean_list = deduplicate_keep_order(raw_list)
print(f"原始列表: {raw_list}")
print(f"去重列表: {clean_list}")
# 示例输出:
# 原始列表: [3, 1, 2, 3, 4, 1, 5, 2]
# 去重列表: [3, 1, 2, 4, 5]
习题 3:可变参数应用——通用数值统计计算器
题目要求:编写函数 compute_stats(*args, **kwargs)。支持传入任意数量的数值参数 *args;通过关键字参数 round_digits=N 控制保留的小数位数(默认为 2 位),通过 drop_zero=True/False 控制是否过滤掉数值 0。返回包含最大值、最小值、均值和总和的字典。
def compute_stats(*args, **kwargs):
    """
    灵活统计多参数数值特性
    *args: 动态位置参数
    **kwargs: 动态关键字参数
    """
    round_digits = kwargs.get("round_digits", 2)
    drop_zero = kwargs.get("drop_zero", False)

    # 提取所有数值
    numbers = list(args)
    if drop_zero:
        numbers = [x for x in numbers if x != 0]

    if not numbers:
        return {"count": 0, "max": None, "min": None, "sum": 0, "avg": None}

    total_sum = sum(numbers)
    max_val = max(numbers)
    min_val = min(numbers)
    avg_val = round(total_sum / len(numbers), round_digits)

    return {
        "count": len(numbers),
        "max": max_val,
        "min": min_val,
        "sum": round(total_sum, round_digits),
        "avg": avg_val
    }

# 示例调用
stats = compute_stats(12, 0, 45, 78, 0, 99, round_digits=3, drop_zero=True)
print(stats)
# 示例输出:
# {'count': 4, 'max': 99, 'min': 12, 'sum': 234, 'avg': 58.5}
习题 4:递归函数设计——带记忆化防护的斐波那契数列
题目要求:编写递归函数 fibonacci(n) 计算第 n 项斐波那契数(定义:F(1)=1, F(2)=1, F(n)=F(n-1)+F(n-2))。必须包含基础递归边界与边界保护,避免非法输入或性能崩溃。
def fibonacci(n, memo=None):
    """
    带记忆化缓存机制的斐波那契递归实现
    memo: 用于存储中间计算结果,防止 O(2^n) 爆炸
    """
    if not isinstance(n, int) or n < 1:
        raise ValueError("输入必须为大于等于 1 的正整数")

    # 字典惰性初始化,规避可变默认参数缺陷
    if memo is None:
        memo = {1: 1, 2: 1}

    if n in memo:
        return memo[n]

    # 递归拆解并记录结果
    memo[n] = fibonacci(n - 1, memo) + fibonacci(n - 2, memo)
    return memo[n]

# 示例调用
print(f"第 10 项: {fibonacci(10)}")
print(f"第 35 项: {fibonacci(35)}")
# 示例输出:
# 第 10 项: 55
# 第 35 项: 9227465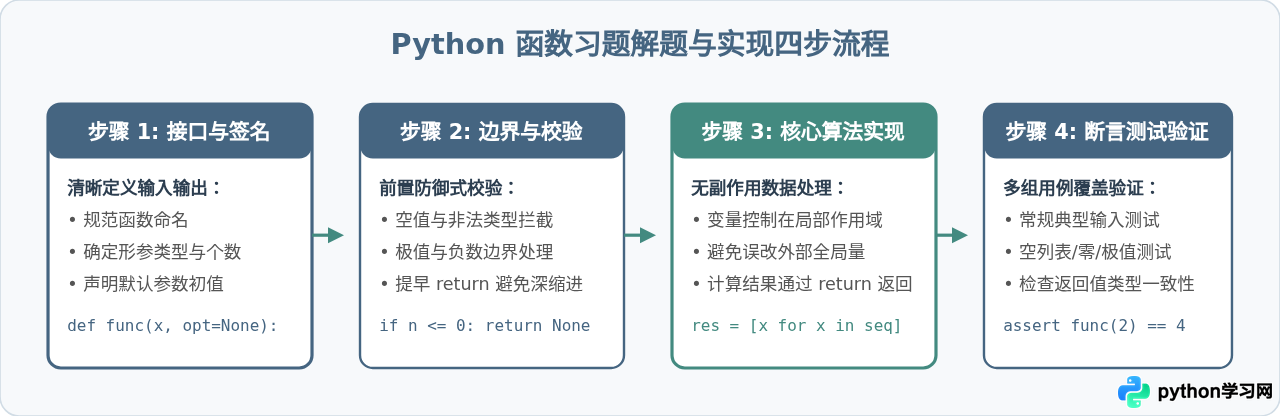
三、函数定义与调用中常见报错及排查修正
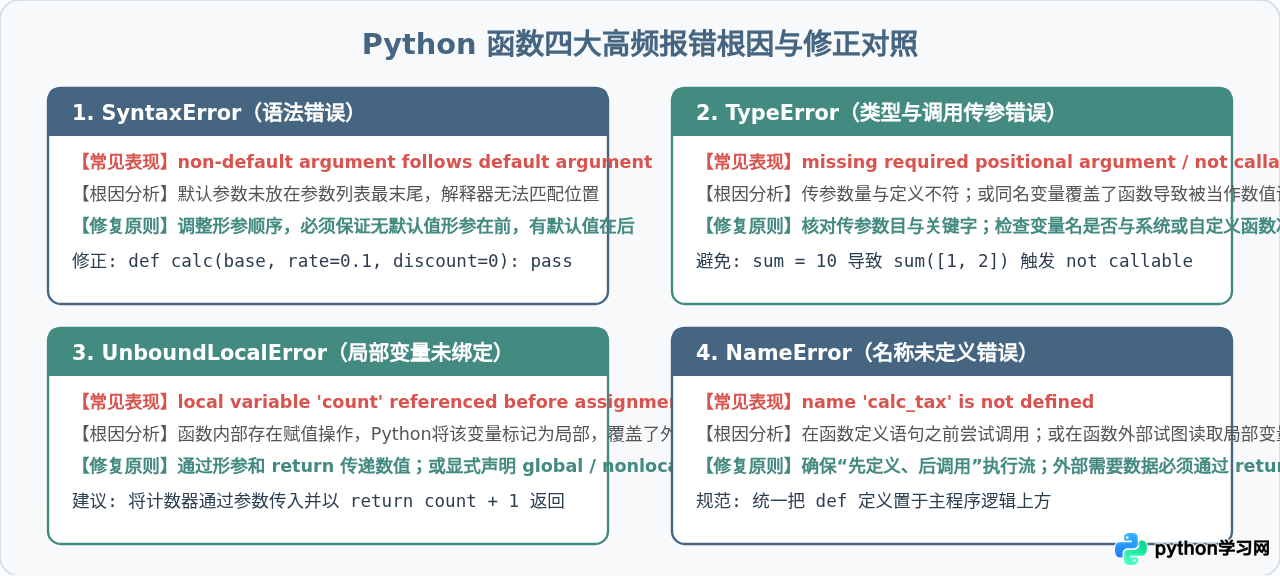
在编写自定义函数时,以下四类报错最为频繁。通过具体的错误样例对比,能够快速定位问题原因并完成修复。
1. SyntaxError: non-default argument follows default argument
错误表现:在定义函数参数列表时,如果把没有默认值的参数写在了带有默认值的参数后面,Python 解析器会在语法分析阶段直接抛出 SyntaxError。
# 错误写法:y 有默认值,但随后的 z 却没有默认值
def calculate_price(x, y=10, z):
    return x + y + z
# SyntaxError: non-default argument follows default argument# 正确写法:所有必填位置参数排在前面
def calculate_price(x, z, y=10):
return x + y + z2. TypeError: missing required positional argument 或 'xxx' object is not callable
错误表现:此类错误常见于调用阶段。第一种是调用时传入的必选参数少于函数定义所要求的数量;第二种是局部或全局变量名与函数名冲突,导致函数对象被其他数据类型(例如 int 或 list)覆盖。
# 错误示例:将变量命名为内置函数名 sum
numbers = [10, 20, 30]
sum = 60  # 这里把内置函数 sum 覆盖成了一个 int 整数

# 稍后尝试调用函数
total = sum(numbers)
# TypeError: 'int' object is not callablesum、max、min、list、dict、str)作为变量名。若发生冲突,使用 del sum 可以恢复内置定义。
3. UnboundLocalError: local variable referenced before assignment
错误表现:函数内部需要读取一个外部全局变量,并在函数内对其进行修改或自增操作时抛出该错误。
counter = 0

def increment():
    # 试图直接自增全局变量
    counter += 1  # 等价于 counter = counter + 1
    return counter

increment()
# UnboundLocalError: local variable 'counter' referenced before assignment深层原因:Python 在编译函数代码块时,只要发现函数体内存在对 counter 的赋值语句(counter = ...),就会在符号表中将 counter 标记为局部变量。执行到右侧 counter + 1 时,局部作用域中的 counter 尚未初始化绑定,因而报错。
def increment(count):
    return count + 1

counter = 0
counter = increment(counter) # counter 结果为 1global 声明。
def increment():
    global counter
    counter += 1
    return counter
4. NameError: name 'xxx' is not defined
错误表现:执行代码时提示函数名未定义。通常有两个诱因:一是函数调用写在函数定义语句之前(Python 逐行解释执行,不存在变量提升);二是由于拼写错误或把函数定义在了一个从不执行的 if 分支内部。
# 错误:在函数定义前就执行调用
result = calculate_tax(5000)

def calculate_tax(income):
    return income * 0.03
# NameError: name 'calculate_tax' is not defineddef 语句在被调用前已由解释器完成读取与加载。推荐将通用函数置于模块上方,或者放置于 if __name__ == '__main__': 结构内部统一调用。
四、隐蔽陷阱:可变对象充当默认参数的连环灾难
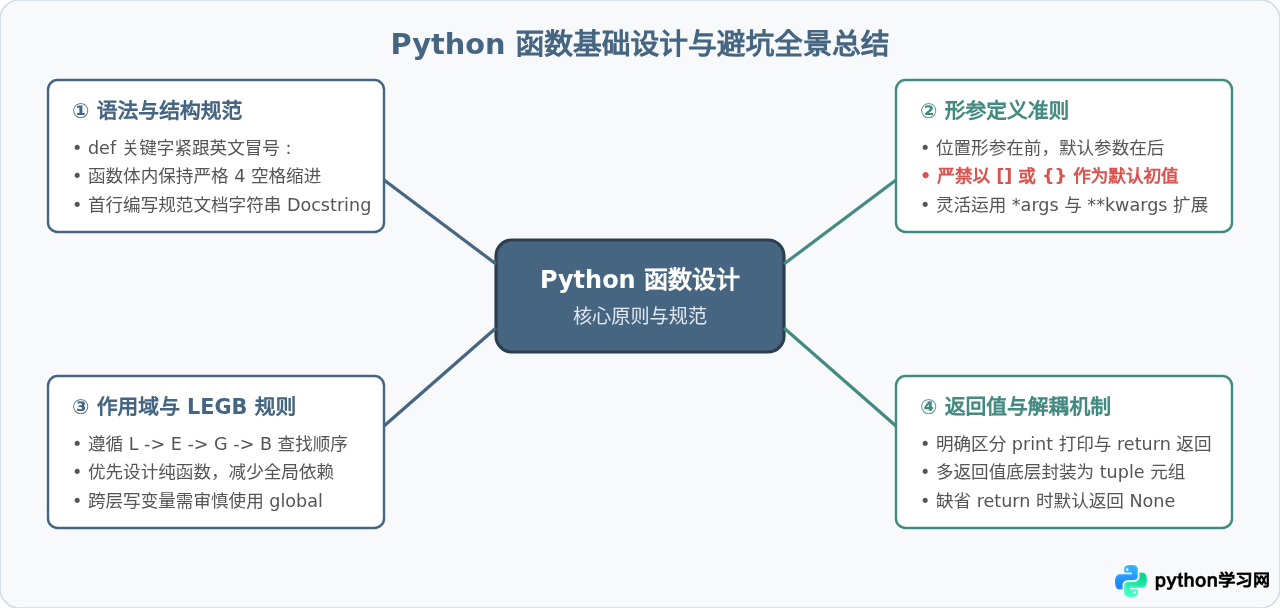
在所有初学者编写的函数 Bug 中,最经典且最隐蔽的莫过于将空列表 [] 或空字典 {} 直接写在默认参数中。
典型陷阱复现:
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item("苹果"))    # 预期: ['苹果'],实际输出: ['苹果']
print(add_item("香蕉"))    # 预期: ['香蕉'],实际输出: ['苹果', '香蕉'] ??
print(add_item("橘子"))    # 预期: ['橘子'],实际输出: ['苹果', '香蕉', '橘子'] !!
成因分析:
在 Python 中,def 语句是一个可执行语句。当模块被加载执行到 def add_item(...) 时,Python 会创建一个函数对象,同时将默认参数表达式求值一次并保存在该函数对象的 __defaults__ 属性中。
当随后的多次调用省略了 target_list 实参时,每次调用绑定的都是同一个堆内存中的列表实例!因此对该列表的任何修改都会被永久积累下来,跨调用持续污染。
标准防御模式(None 占位法):
def add_item(item, target_list=None):
    """
    使用不可变对象 None 作为默认参数占位符
    在函数体内进行惰性实例化
    """
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list

# 再次测试验证
print(add_item("苹果"))    # 输出: ['苹果']
print(add_item("香蕉"))    # 输出: ['香蕉']
print(add_item("橘子"))    # 输出: ['橘子']
五、编写健壮函数的自查清单与最佳实践
在完成基础教程各章节的课后作业时,建议读者在提交代码前依照以下清单逐项自检:
| 检查维度 | 自查规范要点 | 常见反模式与风险 |
|---|---|---|
| 返回值设计 | 明确区分 print() 打印与 return 返回。绝大多数算法函数应通过 return 产出计算结果供外部进一步处理。 |
函数体内只有 print(),外部变量赋值得到 None,导致后续运算崩溃。 |
| 默认参数 | 默认参数只能使用 None、int、float、str、bool 等不可变字面量。 |
直接使用 def f(data=[]),引发跨调用数据串扰。 |
| 作用域规范 | 优先设计纯函数(输入确定则输出确定,不依赖且不改变外部全局状态)。 | 滥用 global 变量,导致函数产生难以复现的副作用。 |
| 防御性校验 | 在函数入口处对入参的边界值、空数据及类型进行快速断言与拦截。 | 直接遍历未判空的序列,当传入空值时抛出 IndexError。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















