


Python双下划线开头的名称修饰机制详解
深入解析Python中双下划线开头的名称修饰(Name Mangling)机制,涵盖语法触发条件、底层重写规则、继承防冲突原理、命名惯例对比及最佳实践。
在Python类定义中,当一个属性或方法名称以至少两个下划线开头且至多以一个下划线结尾时,解释器会在语法解析阶段自动将其名称重写为“单下划线 + 类名 + 原始名称”的形式。这种机制被称为名称修饰(Name Mangling)。名称修饰的核心目标并不是像C++或Java中的private关键字那样提供严格的数据访问封装或安全隔离,而是为了防止在多层继承体系中子类无意中覆盖父类的内部状态或关键方法。
一、名称修饰的语法规则与底层转换
名称修饰只在特定的语法上下文和命名格式下触发。根据Python语言规范,满足以下三个条件的标识符将被自动转换:
- 位于类定义体(class block)之内;
- 以至少两个下划线(
__)开头; - 末尾至多包含一个下划线(即不能以双下划线结尾)。
转换规则十分直接:如果当前类名为Worker,类内声明的变量为__salary,Python在生成字节码时会将其统一改写为_Worker__salary。如果类名本身带有前导下划线,解释器会先剥离类名开头的前导下划线,例如在类_Task中定义的__status会被修饰为_Task__status,而不是__Task__status。
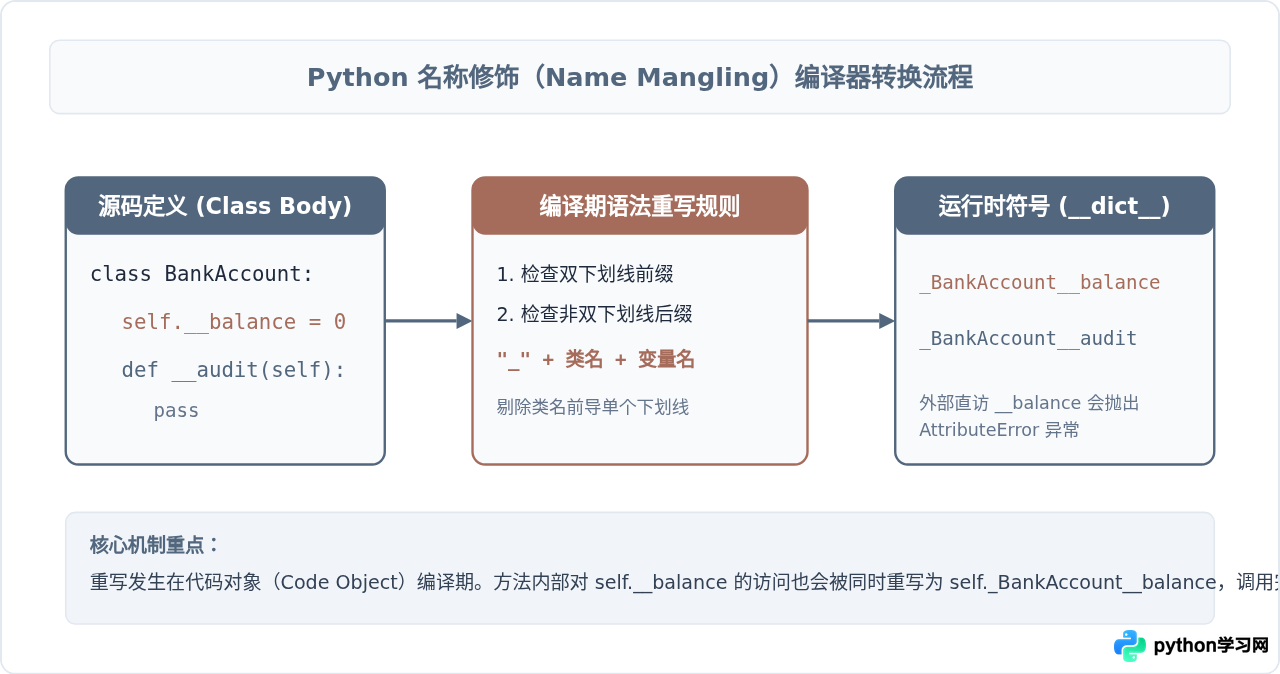
为了直观观察名称修饰发生后的内部状态,可以通过检查实例的属性字典__dict__进行验证:
class Account:
    def __init__(self, owner, balance):
        self.owner = owner
        self.__balance = balance

    def get_balance(self):
        return self.__balance

acc = Account("Alice", 5000)

# 查看实例内部实际存储的属性名
print(acc.__dict__)
# 输出示例: {'owner': 'Alice', '_Account__balance': 5000}

# 直接访问原始名称会报错
try:
    print(acc.__balance)
except AttributeError as err:
    print("捕获错误:", err)
    # 输出示例: 捕获错误: 'Account' object has no attribute '__balance'

# 通过修饰后的名称依然可以正常访问
print(acc._Account__balance)
# 输出: 5000从输出中可以清晰看到,属性并没有真正从内存中被隐藏或加密,它只是以_Account__balance的名字安放在属性字典里。这意味着所谓的“私有”只是语法层面的名字替换,任何了解该机制的代码依然能够直接读写该属性。
二、核心设计初衷:解决继承体系中的名称冲突
既然名称修饰无法真正阻止外部读取,Python为什么还要设计这一机制?其根本原因是保护多层继承与框架扩展中的内部实现细节,防止子类无意中覆盖父类的属性或方法。
在复杂的面向对象继承关系中,基类通常由通用库或框架维护,而派生类由业务开发者编写。假设基类内部依赖一个辅助方法来完成某些基础逻辑,如果使用普通命名或单下划线命名,子类一旦凑巧定义了同名方法,基类的内部流程就会被子类的重写破坏。名称修饰通过引入类名前缀,将父类与子类的同名私有成员在命名空间上彻底隔离开来。
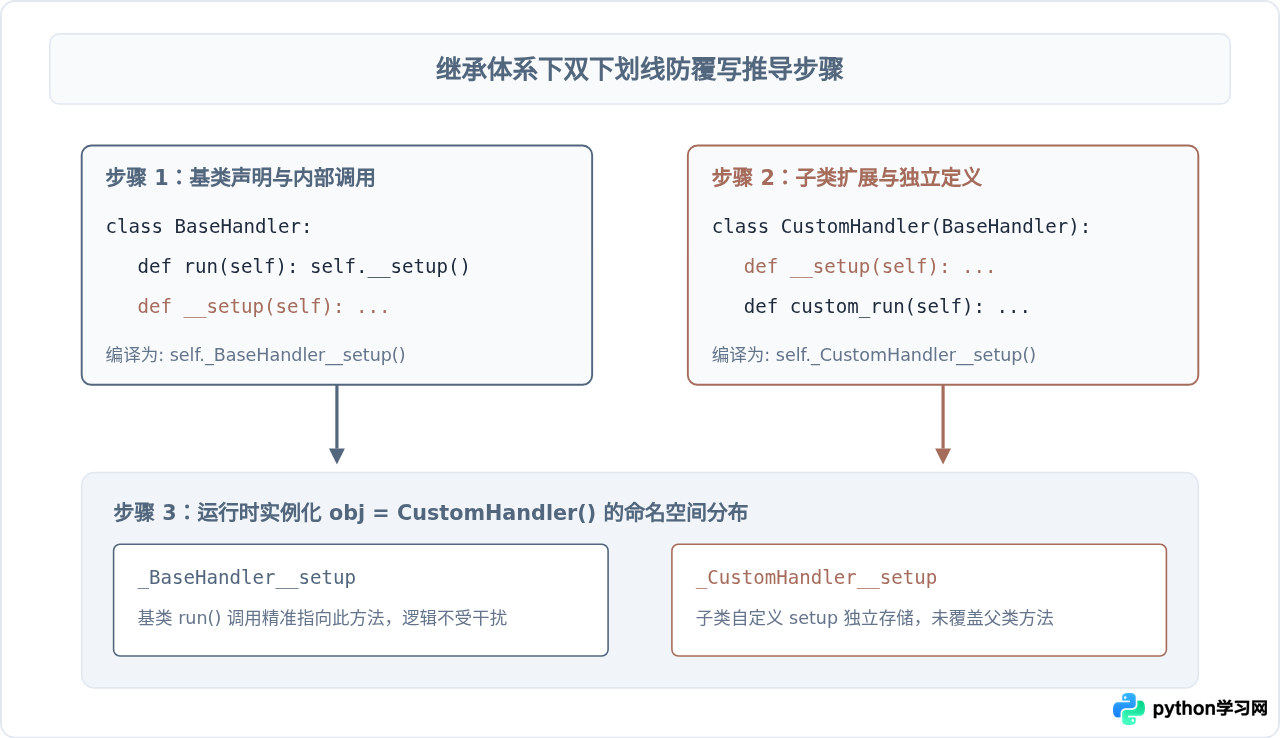
下面通过具体代码演示这种隔离效果:
class Vehicle:
    def __init__(self):
        # 初始化私有状态
        self.__speed = 0
        self.update_log()

    def update_log(self):
        # 调用私有方法记录初始状态
        self.__record()

    def __record(self):
        print(f"[Vehicle] 记录车速: {self.__speed}")

class SportsCar(Vehicle):
    def __init__(self):
        super().__init__()
        # 子类中也定义了名为 __speed 的变量
        self.__speed = 280

    def __record(self):
        print(f"[SportsCar] 极速性能模式: {self.__speed}")

car = SportsCar()
# 输出: [Vehicle] 记录车速: 0在执行super().__init__()时,Vehicle的update_log调用的是self._Vehicle__record(),即使SportsCar中也定义了__record(),由于子类方法被重写成了_SportsCar__record(),因此父类的内部流程不会被子类意外篡改。两者在同一个实例中共存,互不干扰。
三、Python各种下划线命名规范对比
Python开发者在编写面向对象代码时经常会遇到单下划线、双下划线以及前后双下划线等形式。理解它们之间的语义边界对于规范设计至关重要:
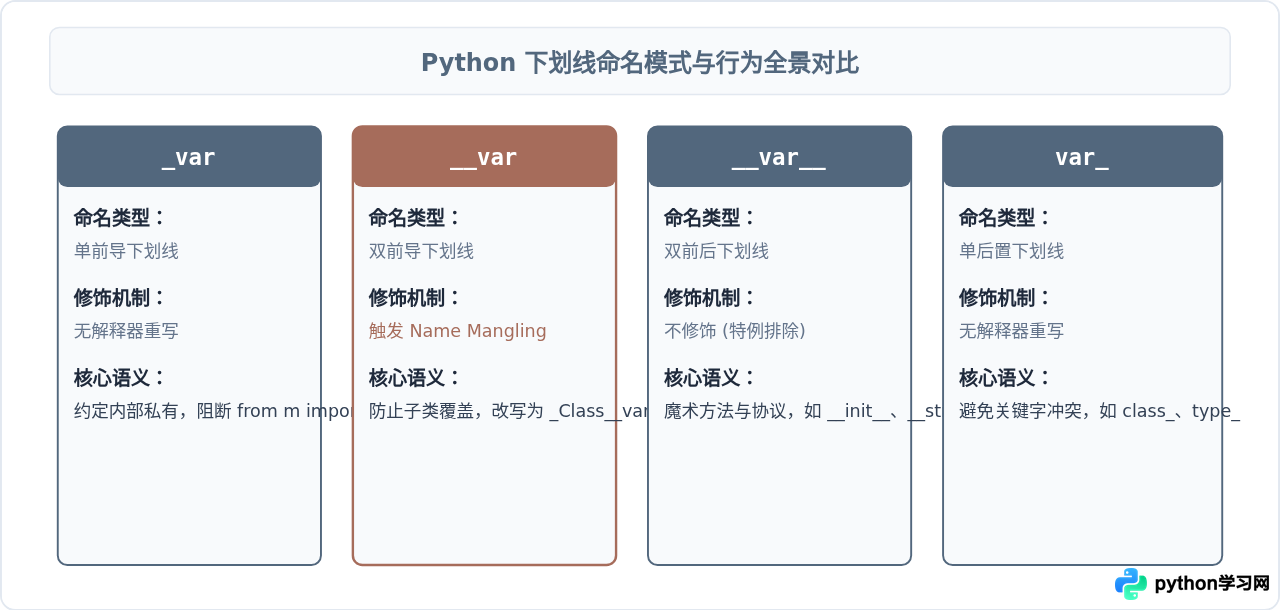
注意:PEP 8 官方编码规范明确指出,单前导下划线(_var)应该作为绝大多数非公开属性和方法的首选命名方式。只有在确实需要防范子类命名冲突的特殊场景下,才考虑使用双前导下划线(__var)。
四、常见误区与使用限制
在实际工程开发中,开发者对名称修饰机制常常产生以下几个认知误区:
1. 误将名称修饰作为真正的安全防护
不少初学者试图使用__password或__token来存储敏感数据,认为这样外部就无法窃取或篡改。然而在Python中,“大家都是成年人”(We are all consenting adults here)。通过getattr(obj, '_ClassName__password')或者直接读取obj.__dict__,任何运行期环境都可以毫无阻碍地访问并修改该值。安全加固应当依赖操作系统隔离、密钥管理系统或内存加密,而非语言层面的命名修饰。
2. 在类作用域之外声明双下划线变量
名称修饰只在类定义的上下文中有效。如果在一个普通函数或全局模块作用域中定义双下划线变量,解释器不会做任何重写:
# 全局模块作用域
__global_config = {"debug": True}

def test_func():
    __local_var = 42
    return __local_var

# 全局变量名称不会发生任何改变
print(__global_config)  # 正常访问,未修饰为任何特殊名称
3. 过度使用带来的维护与测试成本
滥用双下划线会导致类成员在外部难以进行单元测试和Mock替换,也会使序列化工具(例如pickle或自定义JSON编码器)处理属性时变得繁琐。此外,当未来需要通过合理的子类重写来扩展功能时,被双下划线锁死的方法将无法按正常的面向对象多态方式生效。
五、名称修饰的使用决策与工程建议
在日常的业务开发与架构设计中,何时该用单下划线,何时该用双下划线?可以通过如下决策流程清晰判断:
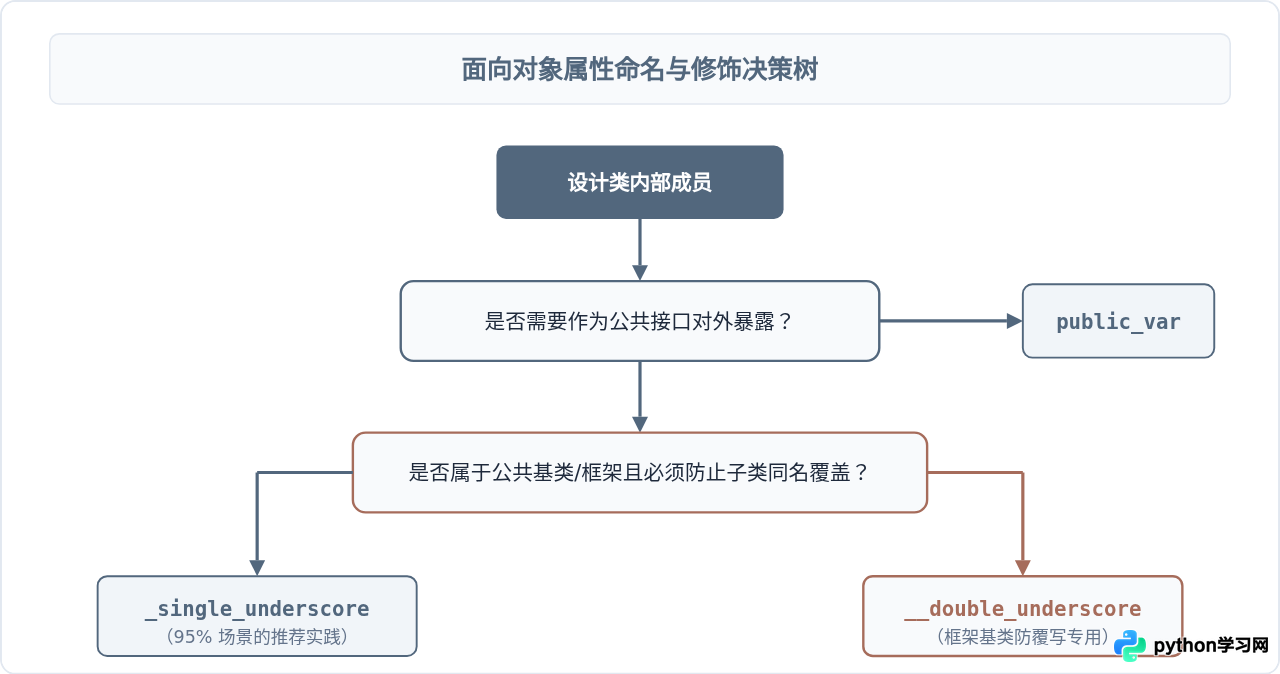
总结而言,Python的双下划线名称修饰是一项由编译器执行的确定性重写策略,专门用于多重继承与开放扩展架构中维护类内部状态的一致性。它明确表达的是“请勿在派生类中覆盖此标识符”,而非“禁止外部读取”。掌握其重写规则与运行机制,有助于在编写库和大型面向对象系统时做出清晰、稳健的架构设计。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















