


Python爬虫基础教程:拆解数据抓取的五个关键阶段
系统拆解Python网络数据抓取的五个核心阶段:目标分析、网络请求、内容解析、数据清洗与持久化存储。提供规范代码示例、排错思路与四幅流程架构SVG图示,帮助初学者建立扎实、清晰的爬虫开发逻辑。
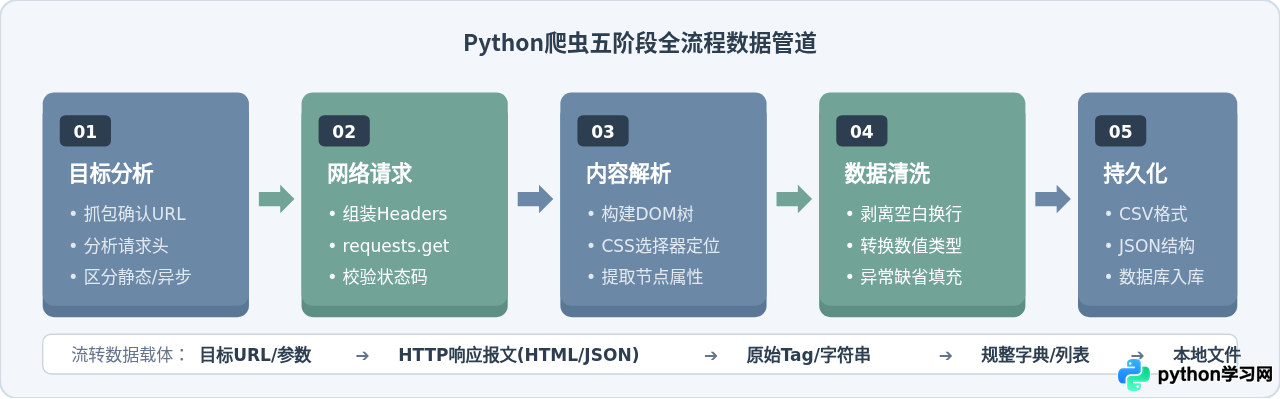
阶段一:目标分析与请求准备(明确入口与通信规则)
很多初学者在编写爬虫时习惯直接拷贝浏览器地址栏的链接,调用代码发起请求,结果往往得到空白页面或403拒绝访问。爬虫的第一步不是写代码,而是通过浏览器开发者工具(F12)进行网络行为分析。
在目标分析阶段,主要完成以下三项任务:
- 识别渲染方式:在浏览器的 Network 面板中刷新页面,查看首个 Doc 请求的响应预览(Response)。如果页面上能看到的文本在响应源码中存在,说明是服务端直接渲染的静态页面;如果源码中只有骨架容器,数据在 Fetch/XHR 请求返回的 JSON 接口中,则说明是前后端分离的异步加载,此时应直接请求该 API 接口,而不是强行解析空 HTML。
- 提取必要请求头(Headers):服务器通常通过
User-Agent识别客户端身份,缺失该头部会被大多数站点直接拦截。对于需要登录或限制来源的接口,还需要提取Cookie与Referer。 - 厘清请求参数(Query String):观察翻页或搜索时 URL 中参数的变动规律。例如
page=1、page=2或时间戳参数,整理出构造批量请求的逻辑模板。
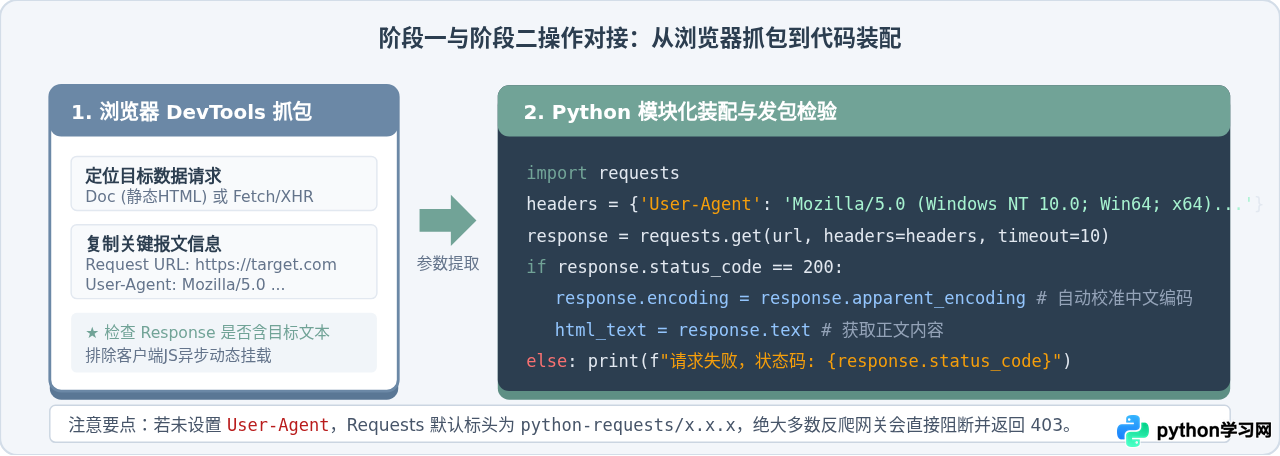
阶段二:建立连接与网络请求(发送HTTP请求与状态判定)
完成参数分析后,程序需要通过 HTTP/HTTPS 协议与远程主机建立连接,获取包含目标内容的原始响应报文。在 Python 中,最推荐且普及度最高的请求库是 requests。
在这个阶段,有三个经常被初学者忽视但影响爬虫稳定性的关键细节:
- 强制设置请求超时(Timeout):如果远程服务器负载过高或出现网络抖动,没有设置超时的
requests.get()会一直挂起阻塞线程。必须显式传入timeout=10(单位秒)。 - 校验响应状态码(Status Code):收到返回对象后,不要直接进行下一步解析,必须首先检查
response.status_code == 200。遇到 404(不存在)、403(反爬拦截)、500(服务器报错)等异常时,应当通过条件分支或异常捕获记录日志,避免抛出解析错误。 - 纠正文本编码:当爬取国内早期网站时,网页常采用
GBK或GB2312编码。requests自动推测的编码有时不准确,容易导致中文乱码。使用response.apparent_encoding重新对response.encoding赋值,可以最大程度避免中文乱码。
import requests

def fetch_page(url):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    try:
        response = requests.get(url, headers=headers, timeout=10)
        # 抛出 HTTP 错误状态码异常(如 403, 404, 500)
        response.raise_for_status()
        # 修正中文页面编码
        response.encoding = response.apparent_encoding
        return response.text
    except requests.exceptions.RequestException as e:
        print(f"请求发生异常: {e}")
        return None
阶段三:解析响应与定位目标数据(DOM树与选择器)
第一、二阶段得到的是长篇的 HTML 文本字符串。第三阶段的任务是将这些文本交给解析器,构建结构化的文档对象模型(DOM 树),并利用 CSS 选择器或 XPath 语法精准定位所需的数据节点。
常用的解析库是 BeautifulSoup4。它不仅容错率高,而且语法简明,支持使用类 CSS 选择器(soup.select())或节点查询方法(find() / find_all())。
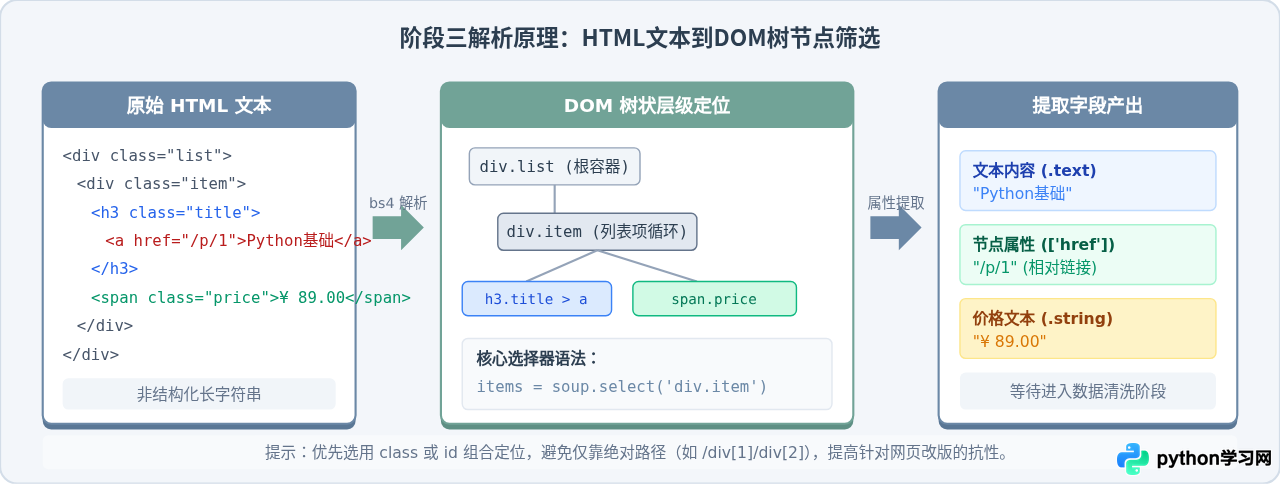
以下是使用 BeautifulSoup 进行节点筛选的核心范式:
from bs4 import BeautifulSoup
from urllib.parse import urljoin

def parse_items(html_content, base_url="https://example.com"):
    # 推荐使用 lxml 解析器,若未安装可回退至 html.parser
    soup = BeautifulSoup(html_content, "lxml")

    # 步骤1:定位列表的每一项容器卡片
    items = soup.select("div.item")
    raw_results = []

    for item in items:
        # 步骤2:在容器内部查找标题元素与链接
        title_tag = item.select_one("h3.title a")
        price_tag = item.select_one("span.price")

        # 必须做好空节点保护,防止页面缺字段导致 AttributeError
        title = title_tag.get_text(strip=True) if title_tag else ""
        raw_link = title_tag.get("href", "") if title_tag else ""
        price = price_tag.get_text(strip=True) if price_tag else ""

        # 补全相对路径为完整可访问 URL
        full_link = urljoin(base_url, raw_link) if raw_link else ""

        raw_results.append({
            "title": title,
            "link": full_link,
            "price": price
        })
    return raw_results
阶段四:数据清洗与格式化校验(规整字段与过滤噪音)
直接从网页提取到的文字通常包含大量格式噪音。例如:标题前后带有制表符与连续换行、价格文本带有货币符号(“¥ 89.00”)、浏览量带有单位缩写(“1.2万”),或者某些字段出现空值缺失。如果直接存储这些原始脏数据,后续进行数据分析或导入数据库时将产生严重的格式错误。
数据清洗阶段的常规处理包括:
- 去除杂乱空白与换行:使用 Python 的
.strip()清理首尾空格,或使用正则re.sub(r'\s+', ' ', text)将多个换行与制表符压缩为单个空格。 - 数据类型转换:将代表数字的字符串转换为整数或浮点数。例如清洗价格字段时,剔除货币符号并转换为浮点数:
float(price_str.replace("¥", "").strip())。 - 默认值填充与缺失校验:对于非必填字段(如副标题、评分人数),当节点不存在时赋予合理的默认值(如空字符串、0 或
None),保证输出的数据结构具备统一的字段 Schema。
import re

def clean_record(raw_dict):
    """
    清洗单个条目,保证字段类型符合规范
    """
    # 1. 标题清洗:去除头尾空格与不可见符号
    title = raw_dict.get("title", "").strip()
    title = re.sub(r'[\r\n\t]+', ' ', title)

    # 2. 价格字段转数值型:剔除 ¥ 与逗号
    raw_price = raw_dict.get("price", "")
    price_val = 0.0
    if raw_price:
        cleaned_price = re.sub(r'[^\d.]', '', raw_price)
        try:
            price_val = float(cleaned_price)
        except ValueError:
            price_val = 0.0

    # 3. 链接有效性校验
    link = raw_dict.get("link", "").strip()
    if not link.startswith("http"):
        link = ""

    return {
        "title": title,
        "price": price_val,
        "link": link
    }
阶段五:数据持久化与持久存储(导出落地)
爬虫流水线的最后一个环节,是将内存中规整好的字典或列表数据持久化保存到磁盘介质上。根据抓取量级与使用场景,存储方式主要分为平面文件与结构化数据库:
- CSV 格式:最适合小型爬虫与表格类数据,可直接用 Excel 或 Pandas 打开。写入中文时需特别指定
encoding='utf-8-sig',否则 Windows 版本的 Excel 打开时会出现乱码。 - JSON / JSON Lines 格式:适合层级嵌套较深或字段不规则的半结构化数据,保持了原生键值对结构。
- 关系型数据库(SQLite/MySQL):适合长周期抓取或数据量超万条的场景,能够利用主键或唯一索引防止数据重复插入。
mode='a')随抓随存。
import csv
import json

def save_to_csv(data_list, filename="result.csv"):
    if not data_list:
        print("无有效数据可保存。")
        return

    fieldnames = list(data_list[0].keys())
    # 采用 utf-8-sig 编码,防止 Excel 查看时中文乱码
    with open(filename, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(data_list)
    print(f"数据成功保存至 {filename},共写入 {len(data_list)} 条记录。")

def save_to_json(data_list, filename="result.json"):
    with open(filename, mode="w", encoding="utf-8") as f:
        # ensure_ascii=False 确保中文字符不被转义为 Unicode 码
        json.dump(data_list, f, ensure_ascii=False, indent=2)
    print(f"数据成功保存至 {filename}。")
完整串联:五阶段协同实战架构
理清五个阶段后,编写爬虫的主体逻辑就演变为清晰的管道流转:在主函数中依次调用这五个模块,每个模块各司其职,互不耦合。当发生网络问题时直接排查第1与第2阶段,当提取字段有误时排查第3与第4阶段,当格式乱码时排查第5阶段。
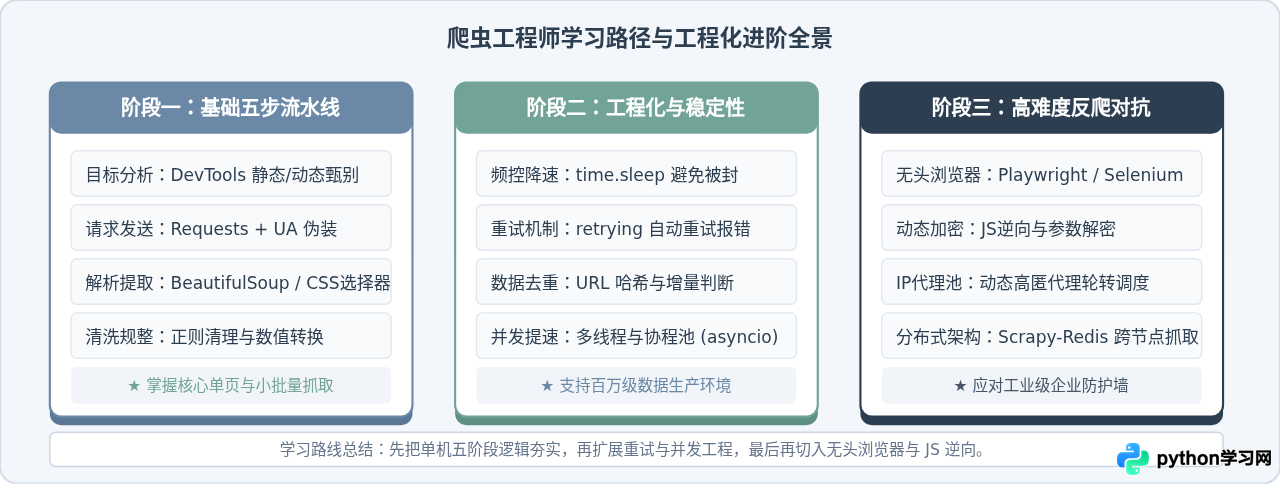
下面是一个将上述五个阶段融合成可直接执行的完整代码范式:
import time
import requests
from bs4 import BeautifulSoup
import re
import csv

class SimpleCrawler:
    def __init__(self, base_url):
        self.base_url = base_url
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
        }

    # 阶段二:网络请求
    def fetch(self, url):
        try:
            resp = requests.get(url, headers=self.headers, timeout=10)
            resp.raise_for_status()
            resp.encoding = resp.apparent_encoding
            return resp.text
        except requests.exceptions.RequestException as err:
            print(f"[错误] 请求 {url} 失败: {err}")
            return None

    # 阶段三:内容解析
    def parse(self, html):
        if not html:
            return []
        soup = BeautifulSoup(html, "lxml")
        raw_list = []
        for card in soup.select("div.item"):
            title_node = card.select_one("h3.title a")
            price_node = card.select_one("span.price")
            raw_list.append({
                "title": title_node.get_text(strip=True) if title_node else "",
                "link": title_node.get("href", "") if title_node else "",
                "price": price_node.get_text(strip=True) if price_node else ""
            })
        return raw_list

    # 阶段四:数据清洗
    def clean(self, raw_list):
        cleaned_list = []
        for item in raw_list:
            title = re.sub(r'[\r\n\t]+', ' ', item["title"].strip())
            price_clean = re.sub(r'[^\d.]', '', item["price"])
            price_val = float(price_clean) if price_clean else 0.0

            cleaned_list.append({
                "title": title,
                "price": price_val,
                "link": requests.compat.urljoin(self.base_url, item["link"])
            })
        return cleaned_list

    # 阶段五:数据存储
    def save(self, data, filename="output.csv"):
        if not data:
            return
        keys = data[0].keys()
        with open(filename, "w", encoding="utf-8-sig", newline="") as f:
            writer = csv.DictWriter(f, fieldnames=keys)
            writer.writeheader()
            writer.writerows(data)
        print(f"[完成] 数据已成功落地到 {filename},共计 {len(data)} 条。")

    # 调度流水线执行
    def run(self, target_path=""):
        full_url = requests.compat.urljoin(self.base_url, target_path)
        print(f"[1. 目标分析完成] 开始抓取: {full_url}")

        html = self.fetch(full_url)
        raw_items = self.parse(html)
        print(f"[3. 解析完成] 提取到 {len(raw_items)} 个原始节点。")

        clean_items = self.clean(raw_items)
        print(f"[4. 清洗完成] 规整完成 {len(clean_items)} 条记录。")

        self.save(clean_items)

if __name__ == "__main__":
    crawler = SimpleCrawler(base_url="https://quotes.toscrape.com")
    crawler.run()
基础爬虫避坑要点
在实际编写与运行爬虫时,遵循以下开发常识能够避免绝大部分常见故障与合规风险:
- 礼貌抓取与频率限制:循环抓取多个分页时,务必在每次循环之间加入随机延时(例如
time.sleep(random.uniform(1.0, 3.0)))。高频无间歇的请求不仅极易触发目标服务器的防火墙封禁,还会对目标网站造成拒绝服务压力。 - 尊重 Robots 协议与服务条款:在编写爬虫前,应当访问
/robots.txt查看网站对自动化爬虫的爬取限制规则。只抓取公开且允许获取的数据,严禁爬取用户隐私敏感信息。 - 善用会话保持对象(requests.Session):当爬虫需要保持登录状态或需要连续访问多个子页面时,使用
session = requests.Session()可以复用底层的 TCP 连接,提升多次请求的网络吞吐效率,并自动在请求间同步 Cookie。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















