


Python多进程调试技巧:怎么定位子进程死锁与异常退出
全面讲解Python多进程开发中子进程死锁与异常退出的排查思路、诊断工具(faulthandler、strace、exitcode解析)以及防范死锁的编程范式。
编写基于 multiprocessing 的 Python 多进程程序时,最棘手的问题往往不是明面上的报错,而是程序在运行中“毫无征兆地卡死”(子进程死锁)或“静默消失且无结果”(子进程异常退出)。解决这类问题不能依赖盲目的 print 调试,而需要掌握一套基于进程生命周期状态、退出码(exitcode)及操作系统系统调用的排查方法。本文将系统拆解子进程死锁与异常退出的根本成因,并提供直观可复现的定位步骤与防御式编码实践。
一、首要诊断:区分“死锁挂起”与“异常退出”
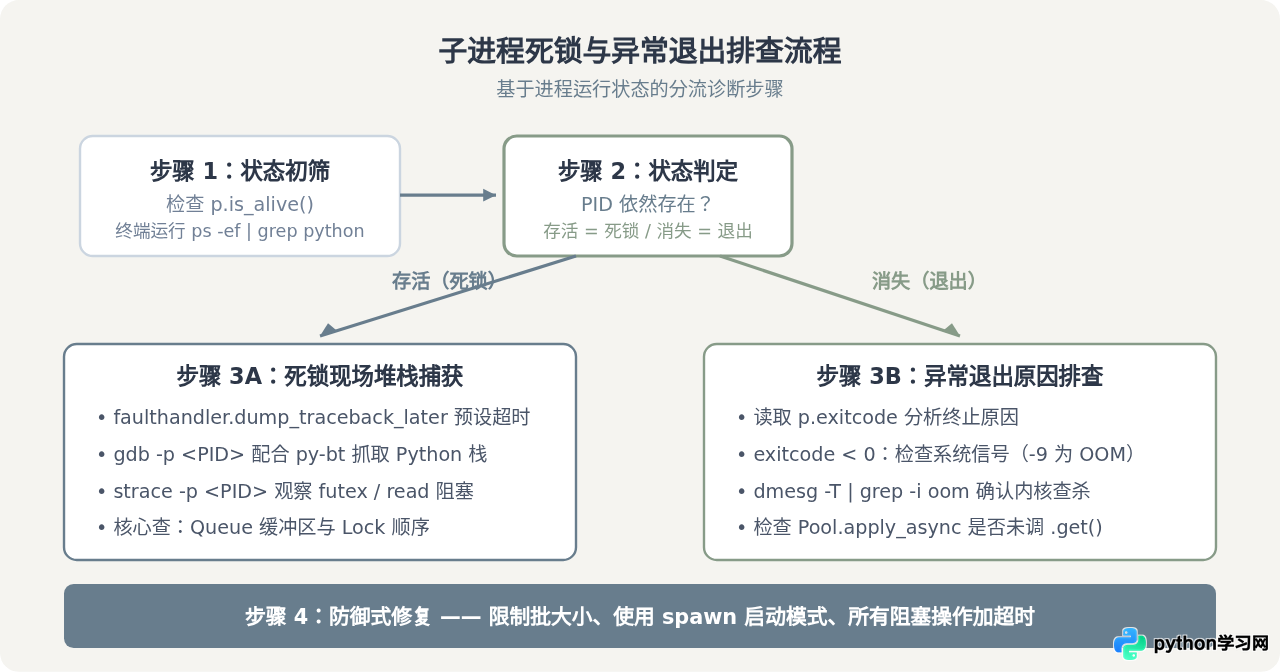
排查的第一步,是确定子进程当前究竟处于什么状态。死锁与异常退出在操作系统层面的特征截然不同,混淆两者的排查方向会导致大量无用功。
- 子进程死锁: 进程依然存活在系统中(
is_alive() == True,且在系统任务管理器中可看到 PID),但 CPU 利用率通常降至接近 0%,程序停滞在同步原语、管道读写或 I/O 等待上,永远无法向后推进。排查核心在于抓取线程当前的调用堆栈。 - 子进程异常退出: 进程已经不存在(
is_alive() == False,PID 已被系统回收),父进程未能拿到预期的计算结果或收到了破损管道(BrokenPipeError)。排查核心在于检索进程销毁瞬间的退出码(exitcode)与系统级内核日志。
二、定位子进程死锁:典型诱因与抓取方法
死锁在 Python 多进程中最常见的两种场景是:Queue 管道缓冲区撑满导致互锁,以及 fork 模式下对多线程锁的不安全复制。
1. 最隐蔽的死锁:Queue 缓冲与 join() 顺序互锁
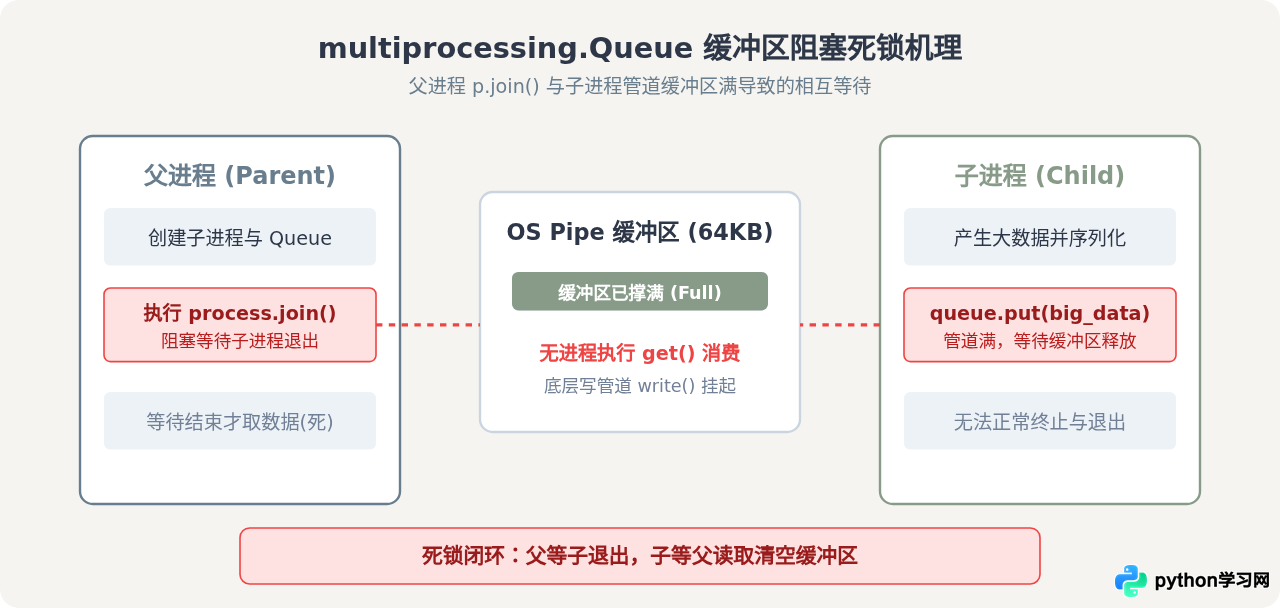
Python 官方文档中明确警示过一个常见陷阱:multiprocessing.Queue 底层依赖一个后台推送线程(feeder thread)将对象序列化并写入 OS Pipe。如果放入的数据量较大(通常超过系统管道默认缓冲区,如 64KB),数据就会驻留在缓冲区中,等待被读取端消费。若主进程在读取队列之前调用了 process.join(),就会发生死锁:
- 子进程执行
queue.put(big_data)后准备退出,但退出前必须等待后台 feeder 线程把缓冲区全部刷入管道; - 管道已满,feeder 线程写入阻塞,等待父进程读取;
- 父进程正在执行
p.join(),等待子进程退出才继续往下读。两者形成死锁。
2. 死锁现场定位实操:dump_traceback_later 与 GDB
当程序已经卡死时,不要直接 Ctrl+C 中断。利用以下两种手段可以直接打印出死锁发生的具体代码行:
方法 A:在子进程中启用 faulthandler 超时转储(推荐)
在子进程入口设置一个兜底计时器,一旦超过预设时限(如 30 秒)子进程仍未完成,便直接在终端打印所有线程的当前 Python 堆栈:
import faulthandler
import time
from multiprocessing import Process

def worker():
    # 若 30 秒内任务未结束,向终端输出所有活动线程的堆栈信息
    faulthandler.dump_traceback_later(timeout=30, exit=False)

    # 模拟耗时或死锁逻辑
    time.sleep(60)

if __name__ == '__main__':
    p = Process(target=worker)
    p.start()
    p.join()
方法 B:在线进程附着(Linux / macOS)
如果卡死已经发生,可以在另一终端窗口找到卡死的子进程 PID,使用 gdb 附着并获取堆栈:
# 1. 查找卡死的子进程 PID
ps -ef | grep python

# 2. 观察当前系统调用(若大量停在 futex() 或 read() 表示正在等待锁或管道)
strace -p <PID>

# 3. 使用 GDB 查看调用栈
gdb -p <PID>
(gdb) py-bt
# 此时将直接打印出卡住的具体 Python 脚本路径及行号
三、定位子进程异常退出:Exit Code 与沉默的崩溃
子进程异常退出通常表现为主进程抛出 BrokenPipeError,或者使用 multiprocessing.Pool 时某些任务永远没有结果返回。排查的关键在于捕获子进程的退出状态码(exitcode)。
1. 理解 exitcode 的系统含义
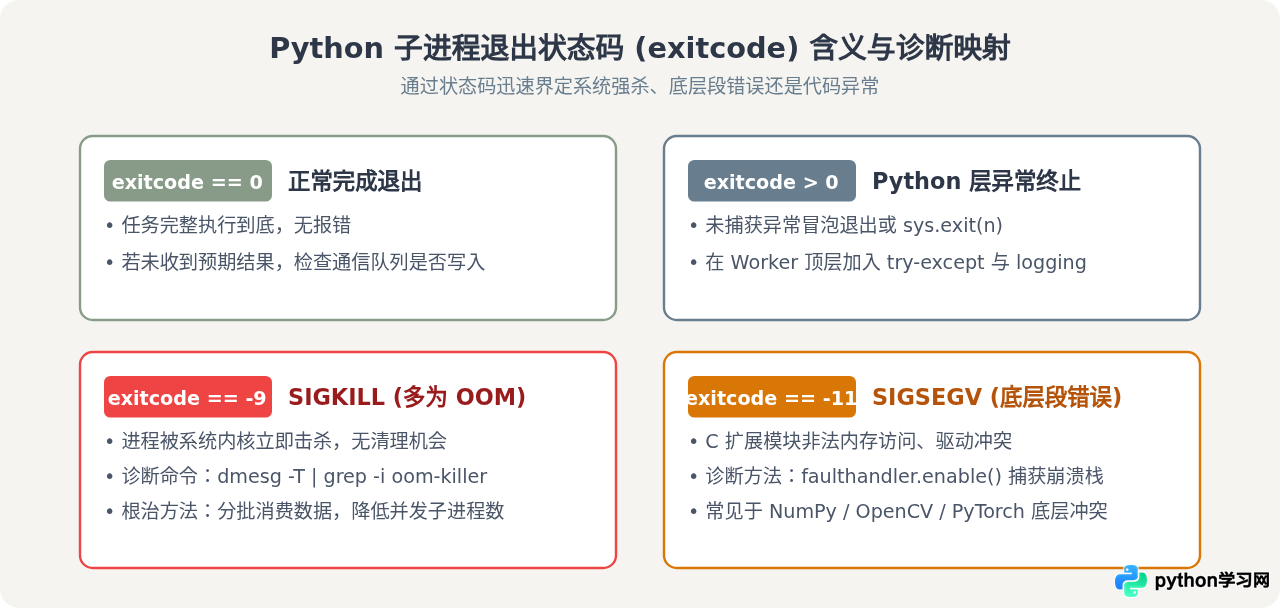
当子进程终止后,Python 的 Process.exitcode 属性会记录具体的退出状态:
None:进程尚未终止;0:进程正常退出,未抛出未捕获异常;> 0:进程通过非零状态码退出,例如显式调用sys.exit(1),或者抛出了顶层未捕获的 Python 异常;< 0:进程被操作系统信号强制杀死。状态码-N代表进程接收到了系统信号N。
2. 最常见的隐式崩溃:OOM Killer (exitcode = -9)
多进程并行处理批处理数据时,每个子进程都拥有独立的内存空间。当子进程申请内存激增,物理内存耗尽时,Linux 内核的 OOM-killer 会直接向该子进程下发 SIGKILL(信号 9)。此时 Python 无法捕获任何异常,没有任何常规 Python 堆栈被输出,子进程直接凭空消失。
验证是否触发 OOM:
# 查看内核环形缓冲区中是否有杀进程记录
dmesg -T | grep -E -i "killed process|oom_killer|out of memory"
若输出包含类似 Out of memory: Killed process 12345 (python) 的字样,即可 100% 确认属于内存超限被强制杀死。解决方法是限制每个进程加载的数据切片大小,或使用进程池的 maxtasksperchild 周期性释放已累积的内存碎片。
3. Pool.apply_async 异常吞噬陷阱
使用 multiprocessing.Pool 时,最容易造成“异常静默”的操作是调用 apply_async 后没有调用返回对象的 .get() 方法:
from multiprocessing import Pool

def faulty_task(x):
    # 此处发生异常
    return 10 / x

if __name__ == '__main__':
    with Pool(processes=2) as pool:
        # 错误做法:未对 AsyncResult 调用 get()
        res = pool.apply_async(faulty_task, args=(0,))

        # 进程池结束,但异常被默默丢弃,不会在终端打印任何 Traceback!
        pool.close()
        pool.join()

        # 正确做法:必须调用 res.get() 才能将子进程内的异常向主进程重新抛出
        # print(res.get(timeout=5))
四、工程防护实践:编写健壮的多进程工作流
定位是事后补救,要在根本上避免死锁与失控退出,应在架构层面遵循以下三项规范:
- 使用 spawn 代替默认的 fork: POSIX 的
fork会将父进程内存原样复制,但只复制调用fork的那条线程。如果父进程中其他线程在 fork 发生时正持有某把锁,该锁在子进程中将处于“永久被持有且无持有者”的损坏状态,子进程一旦尝试 acquire 便直接永久死锁。显式声明multiprocessing.set_start_method('spawn')可保证子进程拥有一个干净初始化的 Python 解释器。 - 所有通信与同步操作必须强制加超时: 绝不写无参数的
queue.get()、lock.acquire()或event.wait()。 - 为子进程任务包装全局异常护盾: 保证子进程在发生任何未知错误时,均能先将异常日志写入标准日志流,再通过有序状态码退出。
以下是具备防死锁与完备异常记录的子进程模版:
import sys
import logging
import traceback
import faulthandler
from multiprocessing import Process, Queue, set_start_method
from queue import Empty

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(processName)s] %(message)s")

def safe_worker(in_q: Queue, out_q: Queue):
    # 开启底层崩溃信号监听(SIGSEGV, SIGFPE等)
    faulthandler.enable()

    while True:
        try:
            # 必须携带 timeout,防止队列上游异常退出后子进程无限挂起
            item = in_q.get(timeout=3.0)
            if item is None:  # 收到退出哨兵信号
                break

            # 执行具体业务运算
            result = item * 2

            # put 同样建议设置超时,防止下游无消费导致管道堵塞
            out_q.put(result, timeout=5.0)

        except Empty:
            # 超时无数据,可继续循环检查或执行心跳检测
            continue
        except Exception as e:
            # 捕获 Python 层全部未预料异常,打印完整调用栈,避免静默消失
            logging.error("子进程内部发生严重未捕获异常:\n%s", traceback.format_exc())
            sys.exit(1)

if __name__ == '__main__':
    # 显式采用 spawn 启动模式
    try:
        set_start_method('spawn')
    except RuntimeError:
        pass

    in_queue = Queue()
    out_queue = Queue()

    p = Process(target=safe_worker, args=(in_queue, out_queue), name="Worker-1")
    p.start()

    # 派发数据与结束哨兵
    in_queue.put(10)
    in_queue.put(None)

    # 必须先取完输出队列里的所有数据,再进行 join()
    try:
        res = out_queue.get(timeout=5.0)
        logging.info("主进程获取到子进程结果: %s", res)
    except Empty:
        logging.warning("子进程在超时时间内未输出数据")

    # 安全收尾
    p.join(timeout=5.0)
    if p.is_alive():
        logging.error("子进程未能在超时时间内正常终止,执行强制终止")
        p.terminate()
        p.join()

    logging.info("子进程最终状态码 exitcode: %s", p.exitcode)
五、核心总结与排查速查
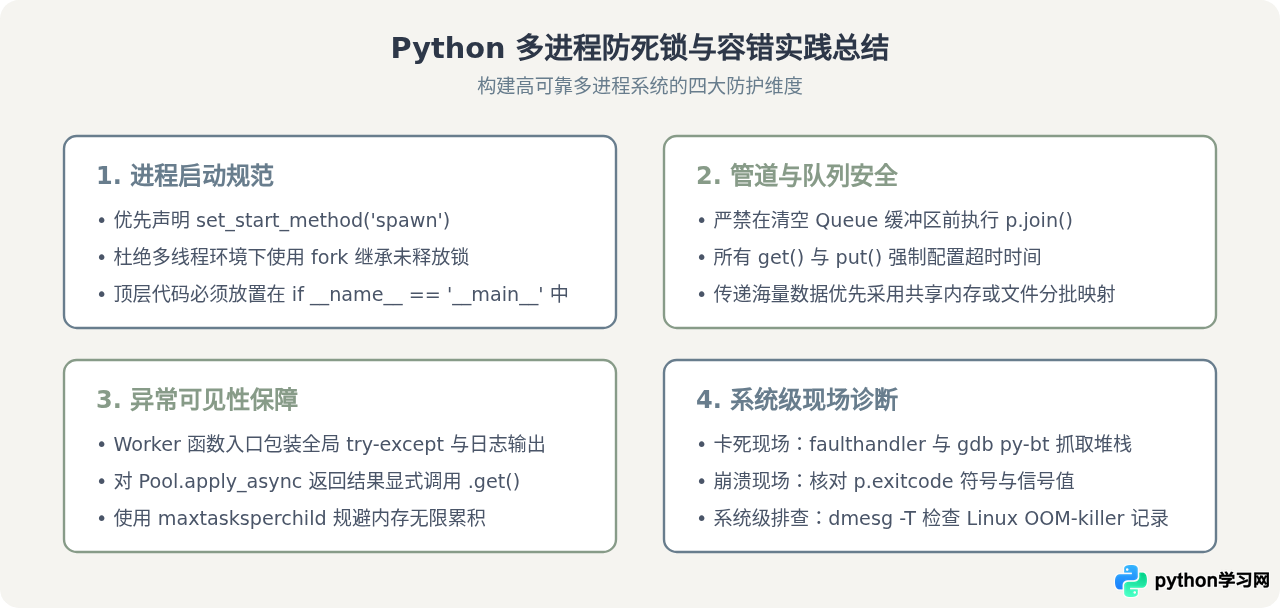
排查 Python 多进程问题切忌盲目猜测。当遇到进程异常停滞或终止时,第一步先核实操作系统中进程的存在性与 exitcode,区分出死锁与崩溃;若是死锁,使用 faulthandler 或 GDB 抓取线程正在等待的系统调用与 Python 栈;若是异常退出,重点关注信号 -9(OOM)或未获处理的异常透传。在工程实践中落实启动模式与超时配置,即可化被动调试为主动防御。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















