


Python元组查询报错处理:解决IndexError和ValueError
针对Python元组查询中常见的IndexError(下标越界)与ValueError(元素不存在)报错,深入剖析其底层触发机制,提供前置判断、切片容错、异常捕获及工程化安全查询方案。
一、IndexError: tuple index out of range 报错剖析与解决
IndexError 通常发生在直接使用方括号索引语法 t[i] 访问元组元素的场景下。元组是有序不可变序列,其合法有效下标由元素个数 строго 限制。如果请求的索引值超出了元组的实际承载区间,Python 就会抛出 IndexError: tuple index out of range。
1. 触发场景与底层机制
假设我们有一个包含 3 个元素的元组 fruits = ("apple", "banana", "cherry")。元组的有效非负索引从 0 递增到 len(fruits) - 1(即 0 到 2);反向负索引则从 -1 递减到 -len(fruits)(即 -1 到 -3)。
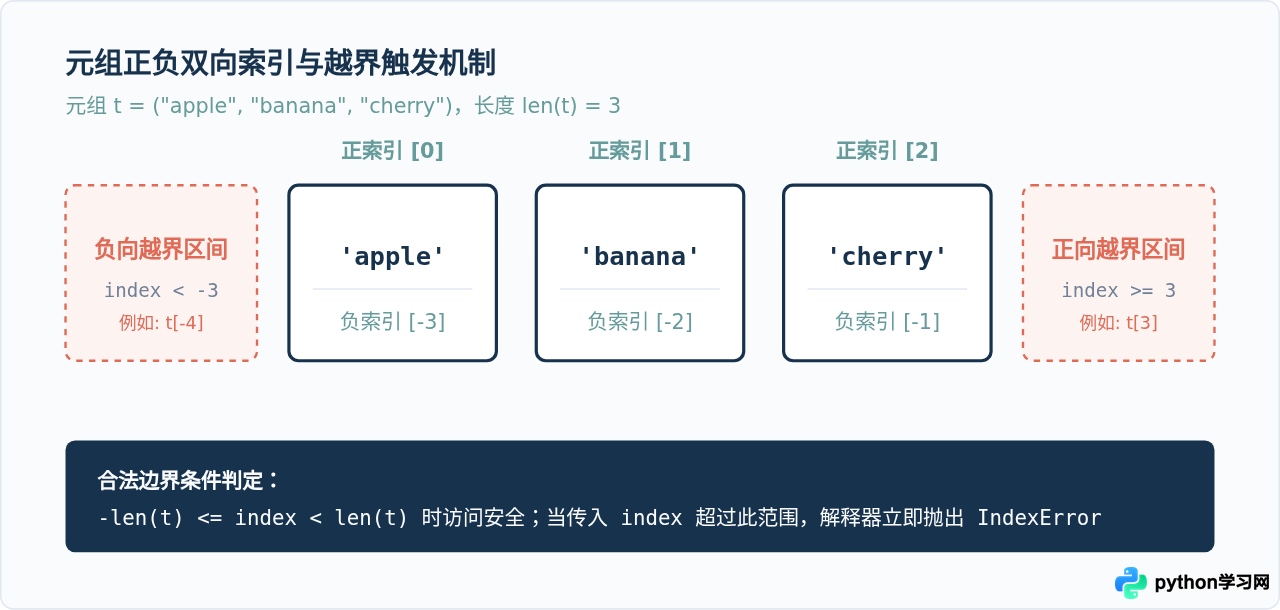
常见的错误触发示例:
fruits = ("apple", "banana", "cherry")

# 尝试访问不存在的第4个元素(合法上限为 2)
print(fruits[3])
# 报错: IndexError: tuple index out of range

# 尝试访问过度负向索引(合法下限为 -3)
print(fruits[-4])
# 报错: IndexError: tuple index out of range

# 访问空元组的任何索引
empty_tuple = ()
print(empty_tuple[0])
# 报错: IndexError: tuple index out of range
2. IndexError 的三种解决与防范策略
针对索引越界,在编码时有三种成熟的解决办法:
方法一:前置长度检查(LBYL 风格)
在取值前明确校验索引变量是否在有效区间内,适合对单次取值有严格控制的逻辑:
def get_item_by_index(data_tuple, target_index):
    # 兼容负索引与正索引的双向校验
    if -len(data_tuple) <= target_index < len(data_tuple):
        return data_tuple[target_index]
    return None  # 或者返回约定默认值
方法二:利用元组切片语法自动容错
Python 序列切片具有宽容性(宽松边界),当下标超出范围时,切片不会抛出 IndexError,而是返回空元组。配合这一特性,可以安全获取元素:
fruits = ("apple", "banana", "cherry")

# 切片不会报错,超出返回 ()
result_slice = fruits[3:4]
item = result_slice[0] if result_slice else "默认水果"
print(item)  # 输出: 默认水果
方法三:使用 try-except 进行异常捕获(EAFP 风格)
对于极少发生越界、更重视正常执行效率的代码路径,推荐使用异常处理:
fruits = ("apple", "banana", "cherry")
target_index = 5

try:
    current_fruit = fruits[target_index]
except IndexError:
    current_fruit = "默认值"
    print(f"索引 {target_index} 不存在,已启用兜底方案。")

print("当前水果:", current_fruit)
二、ValueError: tuple.index(x): x not in tuple 报错剖析与解决
ValueError 通常发生在利用元组内置方法 tuple.index(x) 查询目标值所在的下标位置时。与列表相同,元组的 index() 方法采用线性搜索,当遍历完所有元素仍未找到完全相等的对象时,将直接抛出 ValueError。
1. 触发场景与底层机制
tuple.index(x) 的签名支持 index(value, [start, [stop]]),其工作方式是从左到右逐一比对元素是否满足 element == x。一旦匹配成功,立刻返回首个命中位置;若到达检索区间末尾仍未匹配,则触发异常。
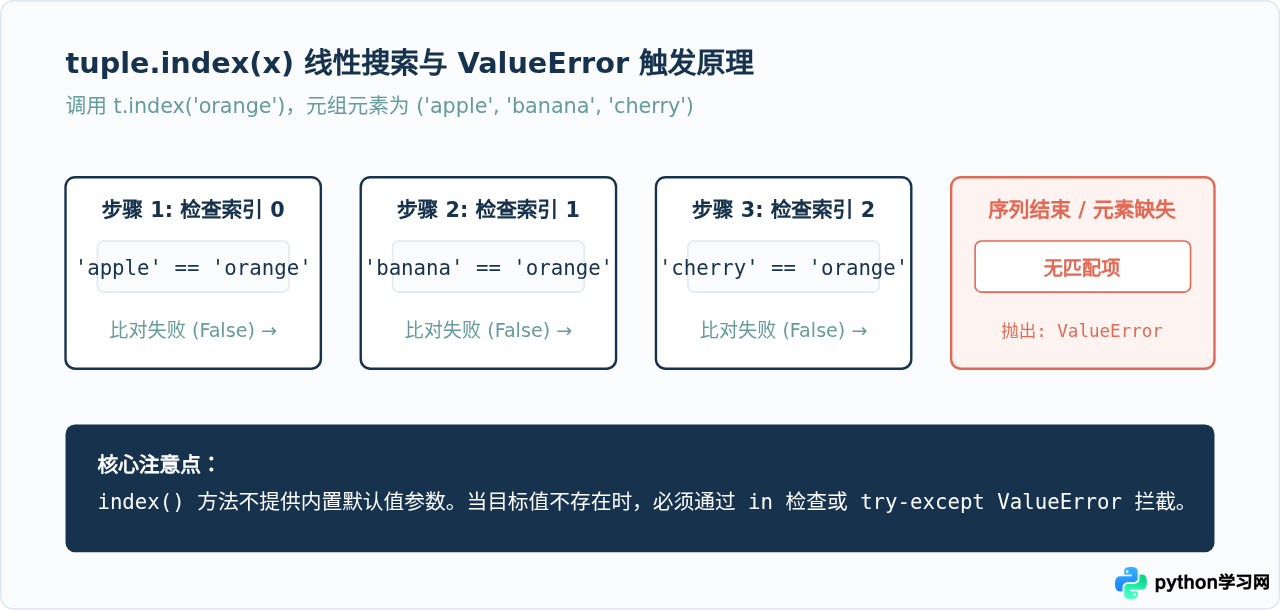
典型报错示例:
fruits = ("apple", "banana", "cherry")

# 查找不在元组中的目标 "orange"
idx = fruits.index("orange")
# 报错: ValueError: tuple.index(x): x not in tuple

# 指定范围查询超出实际存在区间
idx_sub = fruits.index("apple", 1, 3)
# 报错: ValueError: tuple.index(x): x not in tuple ('apple' 位于索引 0,不在 1~2 范围内)
2. ValueError 的解决方案
方法一:使用 in 成员运算符预检(推荐)
对于普通的查找场景,先确认元素存在再调用 index(),逻辑简明直观:
fruits = ("apple", "banana", "cherry")
query_item = "orange"

if query_item in fruits:
    position = fruits.index(query_item)
    print(f"找到元素 {query_item},位置为: {position}")
else:
    position = -1
    print(f"元素 {query_item} 不存在,返回默认标识: {position}")
方法二:try-except 精准捕获 ValueError
如果在大型循环或已有通用数据处理管道中,直接进行异常捕获往往开销更小:
def safe_find_index(data_tuple, target_val, default=-1):
    try:
        return data_tuple.index(target_val)
    except ValueError:
        return default

# 示例调用
idx = safe_find_index(fruits, "grape", default=None)
print("查找结果:", idx)  # 输出: None
三、元组查询排查与安全防护流程
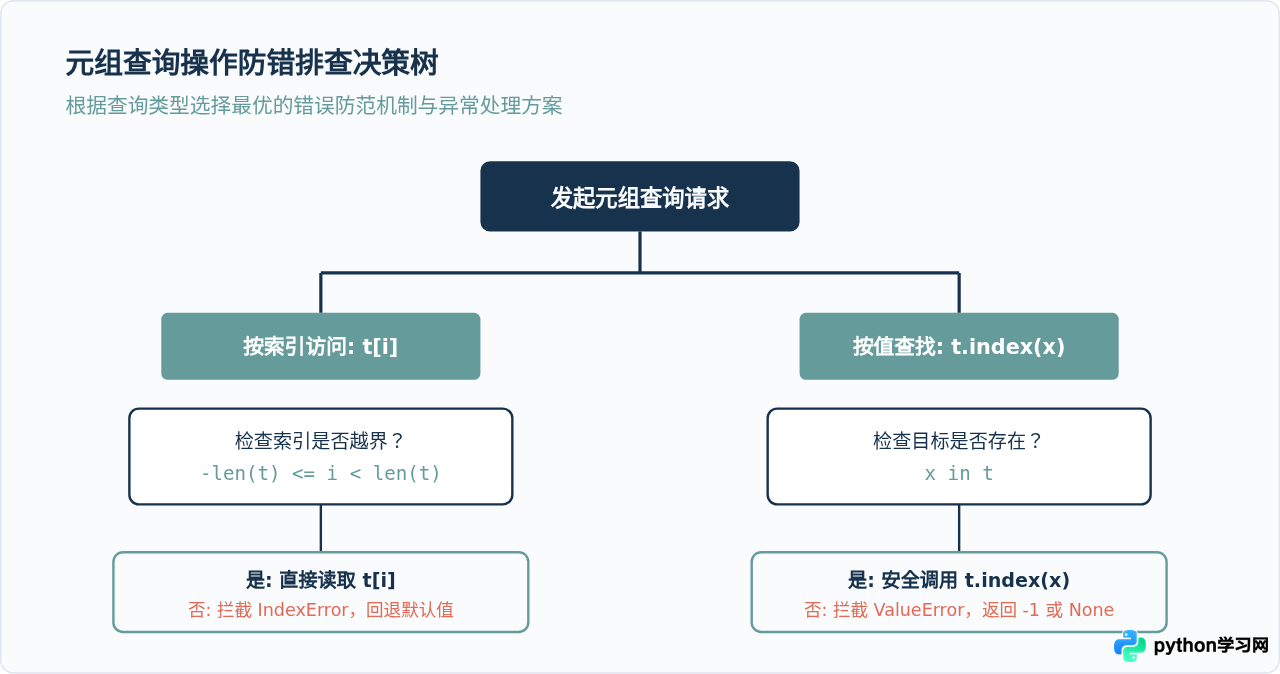
在面对未知外部数据(如从数据库获取的行记录、从网络接收的解析元组)时,应该如何选择最恰当的排查和处理路径?下图总结了面对元组查询时的决策流程:
工程化安全工具函数封装
在实际生产中,我们可以封装一套通用的安全查询函数,既保护代码不因未预料的缺失而崩溃,又能保持调用层语义清晰:
from typing import Any, Tuple, Optional

def safe_tuple_get(tpl: Tuple[Any, ...], index: int, default: Any = None) -> Any:
    """按索引安全读取元组元素,越界返回 default,避免 IndexError"""
    try:
        return tpl[index]
    except IndexError:
        return default

def safe_tuple_index(tpl: Tuple[Any, ...], value: Any, default: Optional[int] = -1) -> Optional[int]:
    """按值安全获取元素首个索引,不存在返回 default,避免 ValueError"""
    try:
        return tpl.index(value)
    except ValueError:
        return default

# 测试样例
data = ("server_ip", 8080, "active")

print(safe_tuple_get(data, 1))      # 正常访问 -> 8080
print(safe_tuple_get(data, 5, "N/A"))# 越界防范 -> "N/A"

print(safe_tuple_index(data, 8080))    # 正常查找 -> 1
print(safe_tuple_index(data, "closed"))# 未匹配防范 -> -1
四、方案对比与防御总结
针对元组查询中涉及的 IndexError 与 ValueError,不同场景下选型依据各有侧重:
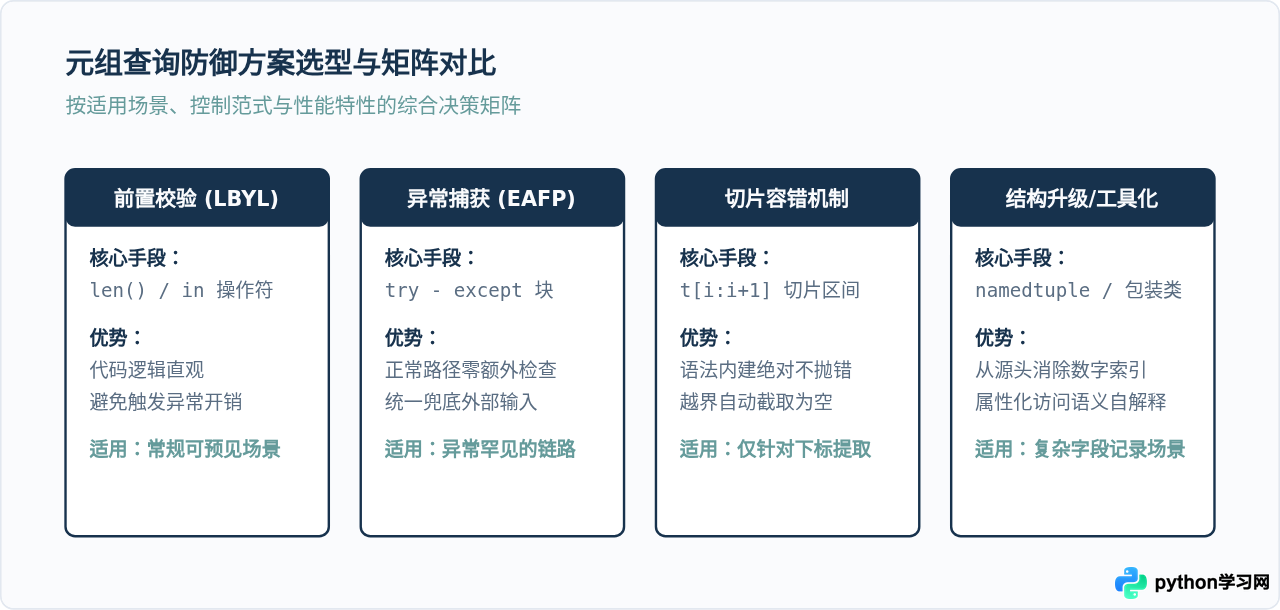
- 对于下标查询,优先考虑数据是否有固定字段含义;如果有,使用
collections.namedtuple代替原生纯元组,使用item.field避免下标越界。如果是动态索引,采用-len(t) <= i < len(t)校验或封装好的safe_tuple_get()。 - 对于值索引查询,牢记
tuple.index()不接受 default 参数。在不确定元素必然存在时,务必使用if x in t:进行前置断言,或包裹在try...except ValueError:中妥善处理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















