


Python pathlib读取文件教程:Path.read_text()与传统open对比
全面讲解Python标准库pathlib的Path.read_text()方法,对比传统open()在语法结构、资源管理、异常处理及大文件读取场景下的差异与选型建议。
在日常 Python 脚本和项目开发中,读取配置文件、提示词模板或小型文本文件是极为高频的操作。长期以来,开发者习惯使用 with open(...) as f: f.read() 这一标准范式;而自 Python 3.4 引入并在此后版本成为事实标准的 pathlib 模块,为我们提供了面向对象且更为简洁的 Path.read_text() 方法。本文将全面介绍 Path.read_text() 的核心用法,并与传统 open() 展开深层机制对比,帮助你在合适的场景写出更加优雅健壮的代码。
一、Path.read_text() 核心概念与生命周期机制
pathlib.Path.read_text() 是 Path 类的一个实例方法,其职责非常专一:以文本模式打开当前路径指向的文件,读取其全部内容作为字符串返回,并在操作完成后立刻自动关闭底层文件描述符。
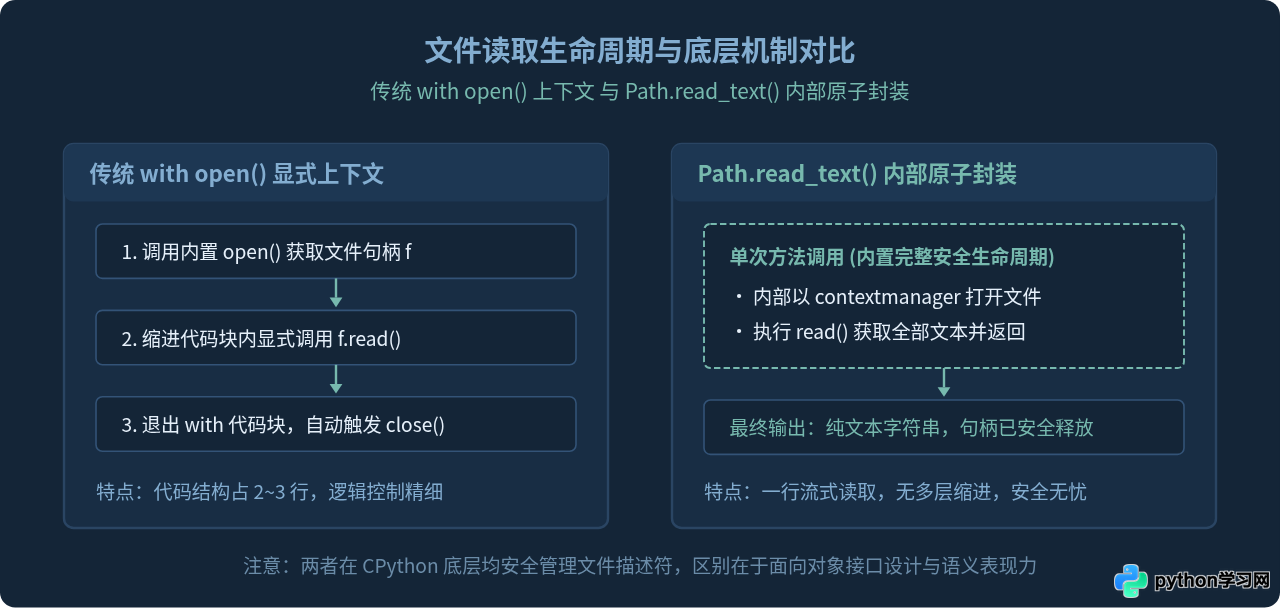
很多开发者初次看到 content = Path("config.json").read_text() 仅需一行代码时,常会担心:它没有写在 with 语句块中,底层的句柄是否会泄漏?事实上,Path.read_text() 内部实现正是严格包装了 with open(...) 这一上下文管理器。它并不是绕过了安全回收,而是将“打开、完整读取、退出并关闭”的标准生命周期封装成了一个单次原子级调用。
二、Path.read_text() 实用操作步骤与规范示例
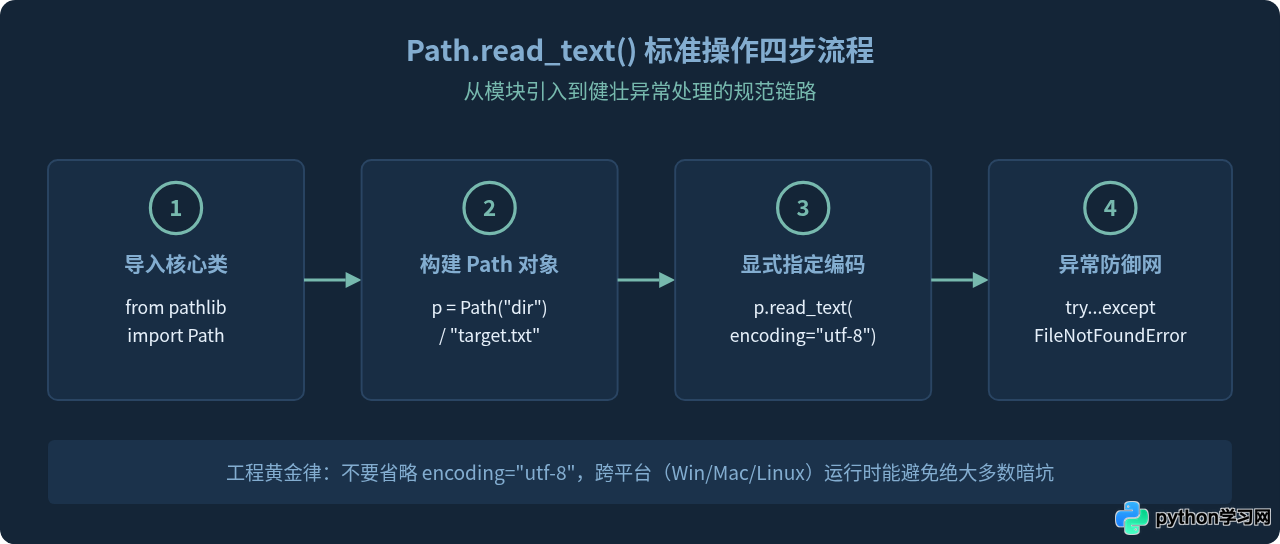
要规范且安全地使用 Path.read_text(),建议遵循标准四步法:模块导入、路径锚定、显式编码设置以及异常拦截。
1. 关键参数解析
查看 Path.read_text 的签名:
Path.read_text(encoding=None, errors=None)- encoding:指定解码文本字符集。强烈建议始终显式传入
encoding="utf-8"。若缺省,Python 会采用平台相关的默认编码(在 Windows 下常为 gbk 或 cp936),极易跨平台出现乱码。 - errors:指定解码异常时的处理策略,常见有
strict(默认报错)、ignore(忽略非法字节)或replace(非法字节替换为占位字符)。
2. 标准使用四步法
以下是经过工程检验的完整范例:
from pathlib import Path

# 步骤 1 & 2:构建路径对象
config_path = Path("configs") / "settings.json"

# 步骤 3 & 4:显式指定编码并添加防御性异常处理
try:
    content = config_path.read_text(encoding="utf-8")
    print(f"成功读取配置,字符数:{len(content)}")
except FileNotFoundError:
    print(f"错误:指定文件不存在 - {config_path.resolve()}")
except UnicodeDecodeError as err:
    print(f"编码解码错误:请确认文件是否为 UTF-8 编码 - {err}")
三、Path.read_text() 与传统 open() 的维度对比
为了更清晰地评估两者的差异,我们从代码表现、内存占用、路径操作兼容性等关键维度进行剖析:
| 对比维度 | Path.read_text() | 传统 open() / with open() |
|---|---|---|
| 代码行数与缩进 | 1 行表达式,无须引入额外的代码块缩进 | 至少 2~3 行,强制增加一级 with 缩进 |
| 资源管理 | 内置上下文机制,调用结束立即自动释放句柄 | 依赖 with 语句显式保障或手动 f.close() |
| 内存占用特征 | 一次性将全文读入内存字符串(RAM = 文件体积) | 支持一次性读取,更支持逐行流式(迭代器)低内存读取 |
| 与路径体系的契合度 | 原生面向对象,可与 Path.glob()、/ 运算符自然链式衔接 |
入参需要字符串或 os.PathLike,链式表达不自然 |
| 超大文件读取 | 不适用(易造成大内存消耗甚至 MemoryError) | 极其适合(使用 for line in f: 达到近乎常数级的内存占用) |
| 二进制处理 | 文本专属,二进制需对应切换为 Path.read_bytes() |
通过变更模式参数 mode='rb' 统一处理 |
代码表达对比
当我们需要遍历一个目录并提取所有 Markdown 文件的标题首行时,二者的代码形态差异尤为明显:
传统 open() 实现:
import os

doc_dir = "docs"
titles = []
for filename in os.listdir(doc_dir):
    if filename.endswith(".md"):
        full_path = os.path.join(doc_dir, filename)
        with open(full_path, "r", encoding="utf-8") as f:
            first_line = f.readline().strip()
            titles.append(first_line)
pathlib.Path.read_text() 结合列表推导式:
from pathlib import Path

# 现代 Pythonic 风格:路径检索与文件读取浑然一体
titles = [
    p.read_text(encoding="utf-8").splitlines()[0]
    for p in Path("docs").glob("*.md")
    if p.stat().st_size > 0
]
从代码可读性看,pathlib 消除了一层又一层的临时变量与缩进括号,让业务逻辑的核心流向变得一目了然。
四、场景选型与决策树
虽然 Path.read_text() 极为便捷,但绝不是在任何场景下都应该替代 open()。选用哪一种方案,主要取决于文件体积与数据处理方式。
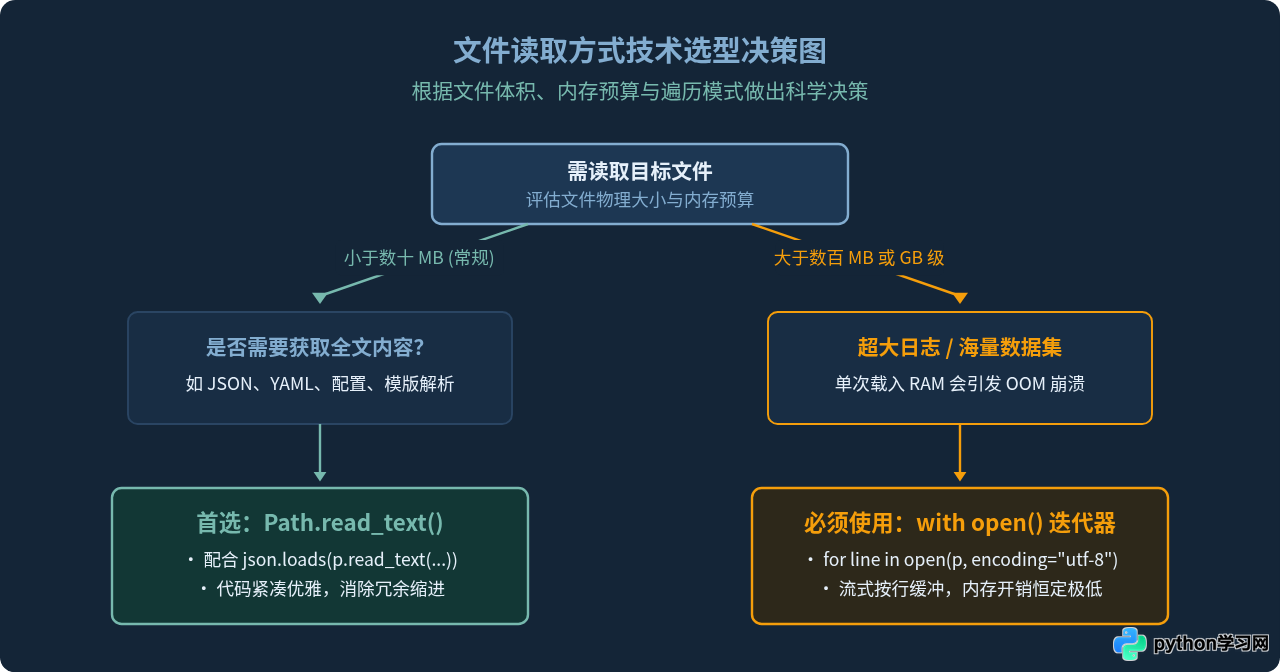
如果一个日志文件达到 4GB,调用 p.read_text() 会迫使 Python 尝试申请分配 4GB 的连续字符串内存。对于 32 位环境或内存受限的容器服务,这将立即触发 MemoryError 甚至引发系统 OOM Killer 杀掉进程。处理大文件必须使用 with open(...) 借助底层缓冲区进行分块或流式迭代。
五、总结与工程最佳实践
在现代 Python 代码规范中,pathlib 已经全面取代旧时代的 os.path。理解 Path.read_text() 与 open() 的区别,是衡量一个 Python 开发者代码现代化程度的典型标志。
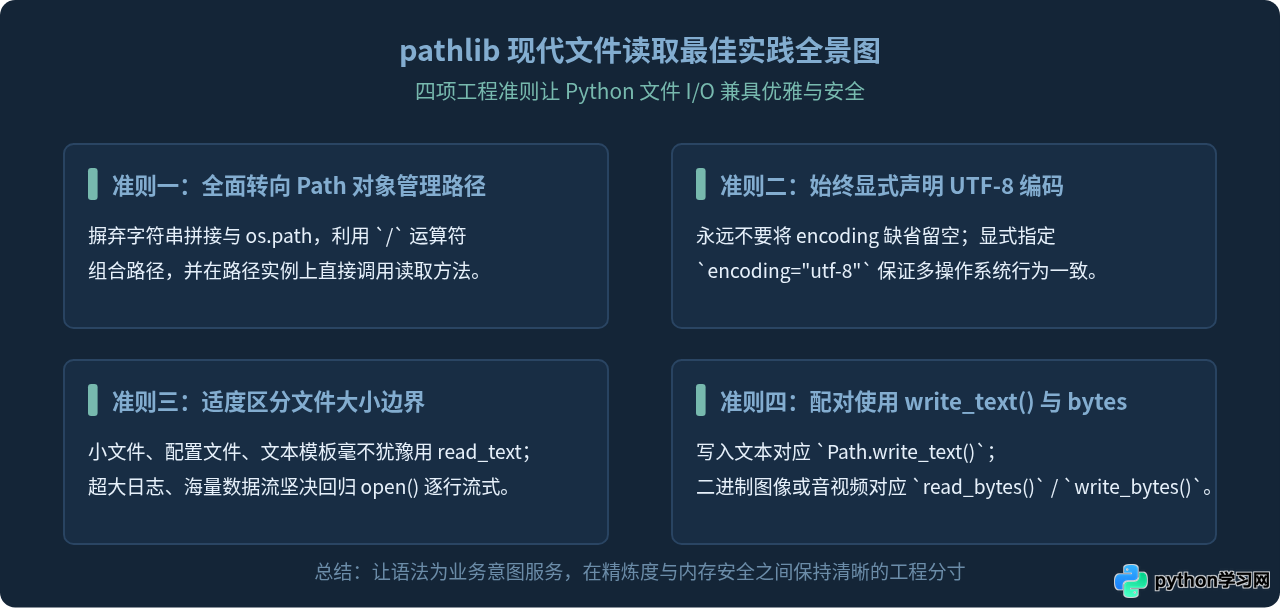
综上所述,对于中小体积的配置文件、数据字典或纯文本内容,果断采用 Path.read_text(encoding="utf-8") 能够让你的脚本清爽精悍、摆脱多余的嵌套层级;而在处理超大体积日志和流式分析时,坚守 with open(...) 借助按行迭代器控制内存消耗,两者结合才是成熟工程师的严谨之选。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















