


pandas读取CSV报错ParserError或UnicodeDecodeError修复指南
针对pandas使用read_csv读取CSV时常见的ParserError与UnicodeDecodeError两大报错,深入剖析报错机理、排查流程与安全修复方案,提供完整的代码示例与参数决策。
pandas.read_csv() 加载数据时,最常遇到的两类中断性异常是 UnicodeDecodeError(编码解码异常)与 ParserError(解析语法异常)。前者发生在字节流转为字符的阶段,属于字符集编码冲突;后者发生在字符拆分为行列矩阵的阶段,属于分隔符、引号或行列结构不齐整。本文提供清晰的定位逻辑、修复策略与防御性代码,帮助读者在保留数据完整性的前提下彻底解决这两类报错。
一、快速诊断:区分报错阶段与排查分流
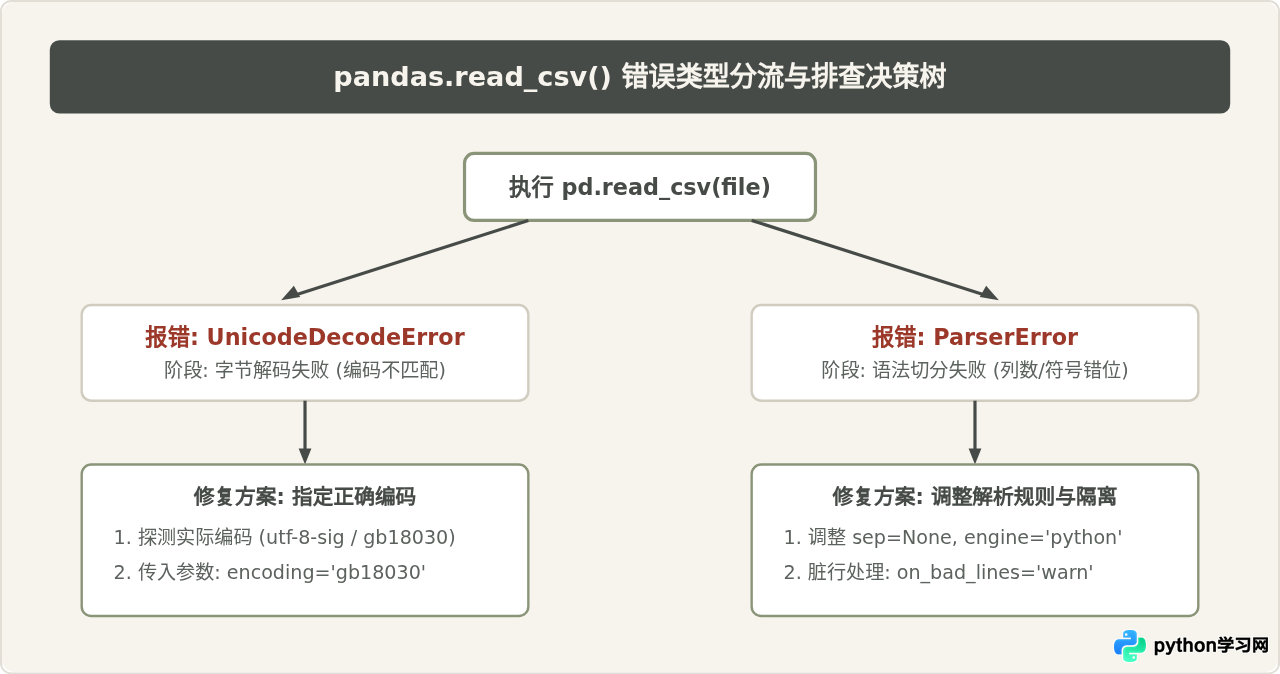
排查 CSV 读取故障的第一步,是准确识别异常抛出的生命周期阶段。read_csv() 在处理文件时分为两个核心步骤:第一步将物理文件存储的二进制字节(Bytes)按照指定编码转换为字符串(Unicode String);第二步依托 C 引擎或 Python 引擎对字符流按照分隔符、引用符号进行语法切分并构建二维数据表。
- UnicodeDecodeError:通常提示
'utf-8' codec can't decode byte 0xba in position ...: invalid start byte。这表明在第一阶段甚至还没开始解析逗号或列名,底层解码器就已经无法将字节还原为文本。 - ParserError:通常提示
Error tokenizing data. C error: Expected 4 fields in line 15, saw 5。这表明编码解码已经通过,但在第二阶段切分字段时,某一行解析出的字段数与表头不一致。
二、攻克 UnicodeDecodeError:编码冲突与精准匹配
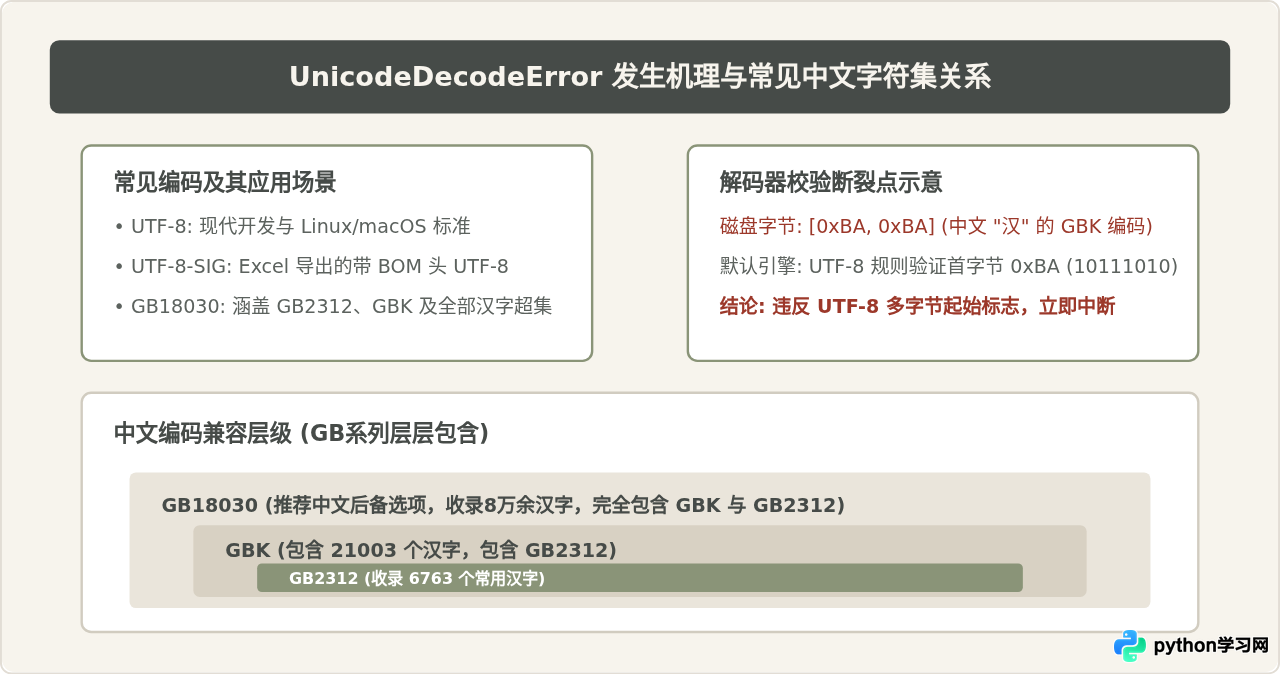
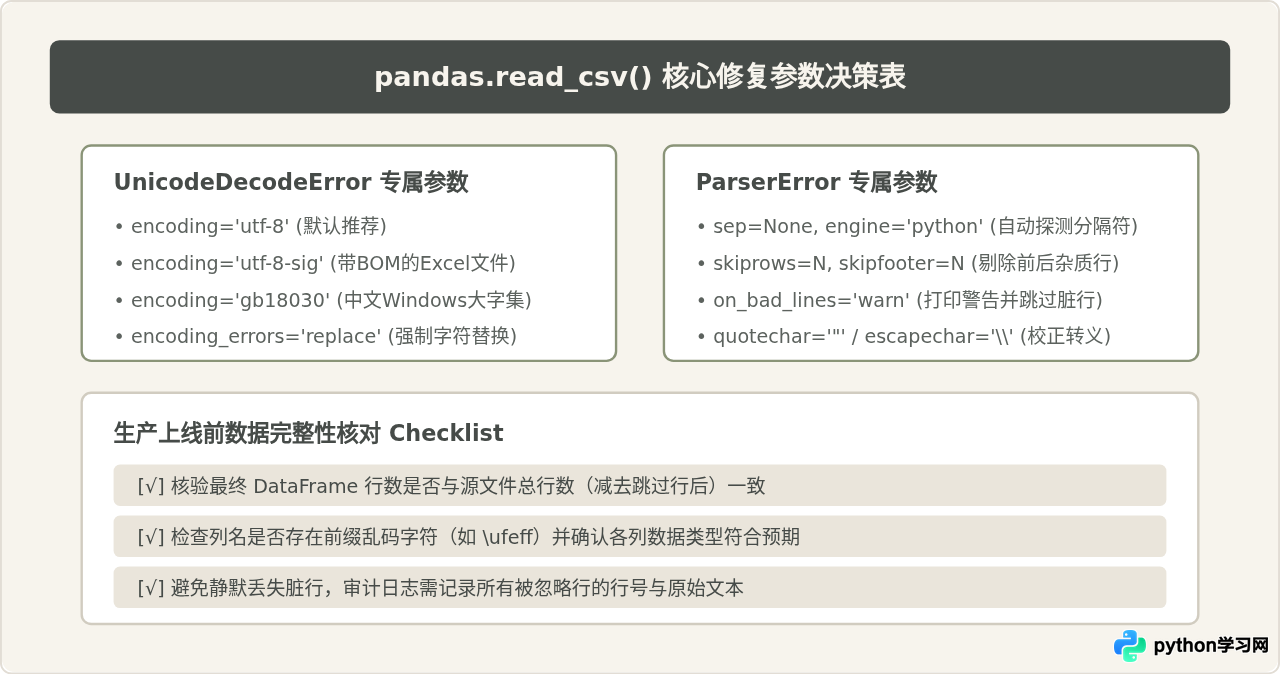
UnicodeDecodeError 的本质在于:读取函数假定的字符集与文件实际保存时采用的二进制编码规则产生了冲突。pandas 在默认情况下使用 encoding='utf-8',当 CSV 来自 Windows 办公软件导出、旧版数据库备份或特定地区软件时,往往以 GBK、GB2312、GB18030 或带 BOM 的 UTF-8 保存,此时就会直接触发解码崩溃。
有人常说:“读取 CSV 报编码错误时,直接加上
encoding='gbk' 就能搞定。”辨析:该说法在文件确实产生自简体中文 Windows 简体默认环境(CP936)时往往有效。但如果 CSV 包含生僻字、特定标点符号或少数民族文字,GBK 的字库范围就会溢出并再次报错;此时更宽泛的国家标准
gb18030 才是更稳妥的超集。此外,如果 CSV 是由 Excel 保存的“UTF-8 CSV”,其文件头部带有 3 字节的 BOM(\xEF\xBB\xBF),强制用 GBK 会出现乱码,用标准 UTF-8 则会导致首列列名携带 \ufeff,正确的解法是使用 encoding='utf-8-sig'。
1. 针对性修复方法与代码
在已知数据来源的前提下,直接在 pd.read_csv() 中指定 encoding 参数是最简洁的操作:
import pandas as pd

# 场景 1:普通 UTF-8 无法读取,且来源为国内 Windows 系统或旧系统导出
# 优先推荐使用 gb18030 代替 gbk,获得更全的字符集覆盖
df = pd.read_csv("data_chinese.csv", encoding="gb18030")

# 场景 2:由 Windows Excel 保存的 CSV,表头前带乱码或无法正常索引
df = pd.read_csv("data_excel.csv", encoding="utf-8-sig")

# 场景 3:包含不可逆损坏字符,且只要求提取可用数据时(谨慎使用)
# 依赖 python 引擎的 encoding_errors 参数(pandas 1.3.0+)
df = pd.read_csv("data_corrupted.csv", encoding="utf-8", encoding_errors="replace")
2. 自动探测编码的最佳实践
当处理批量的未知外部数据时,人工反复试探编码并不实际。可以读取文件前几个 KB 的二进制切片,借助标准库或轻量工具进行编码置信度探测:
import pandas as pd

def detect_and_read_csv(file_path):
    """通过读取文件头部二进制特征检测编码并安全加载"""
    try:
        import charset_normalizer as chardet
    except ImportError:
        import chardet

    # 仅读取前 20KB 即可高准确率推断编码,避免读取几个GB大文件导致内存暴涨
    with open(file_path, "rb") as f:
        raw_bytes = f.read(20480)
        result = chardet.detect(raw_bytes)
        encoding = result["encoding"]

    if not encoding:
        encoding = "gb18030"

    print(f"[提示] 检测到文件编码为: {encoding} (置信度: {result.get('confidence', 0):.2f})")
    return pd.read_csv(file_path, encoding=encoding)

# 示例调用
# df = detect_and_read_csv("unknown_file.csv")
三、破解 ParserError:解析与结构异常机理与修复方案
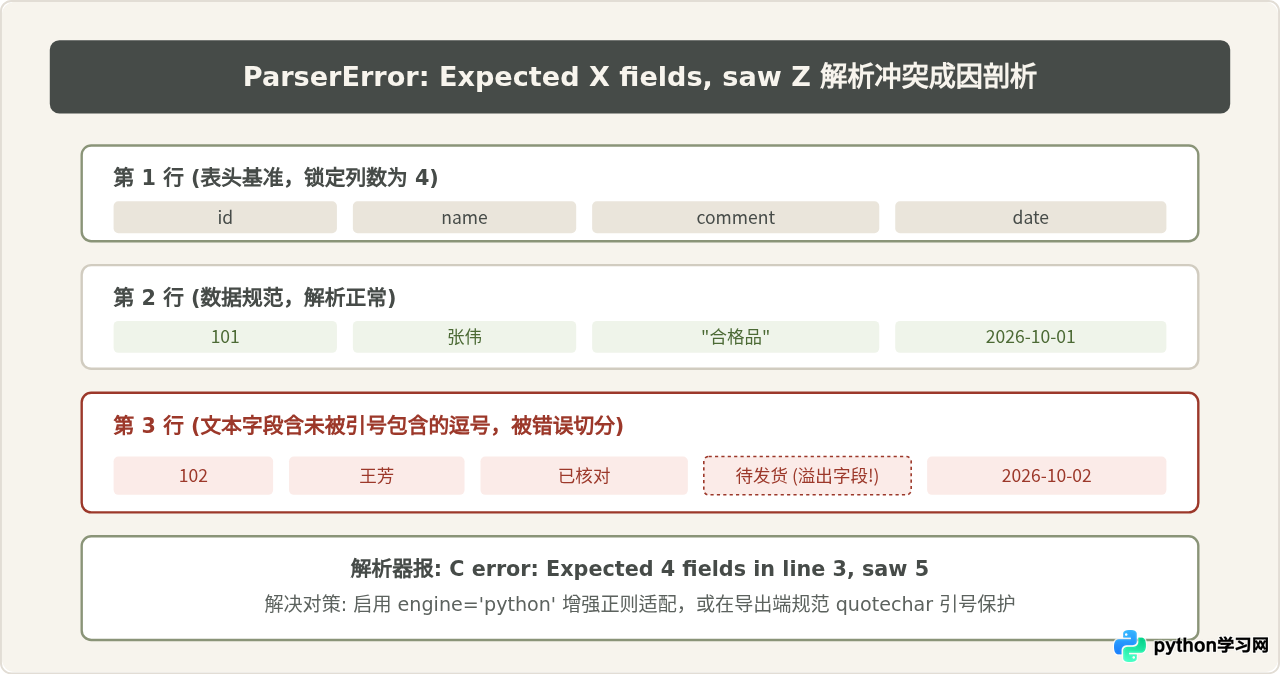
当数据能够顺利转换为字符后,pandas 的底层解析引擎(默认是高性能的 C 引擎)开始逐行解析。C 引擎会根据第一行(或指定的表头行)推断出整张表的字段数量(例如 5 列)。如果在后续行中读取到了 6 个字段或无法闭合的引号,就会引发 ParserError。
有人认为:“遇到
ParserError,直接加上 on_bad_lines='skip'(旧版为 error_bad_lines=False)跳过报错行是最好用的万能技巧。”辨析:这种做法虽然能让脚本不报错并顺利输出 DataFrame,但存在巨大的数据安全隐患。跳过错误行意味着在用户不知情的情况下丢弃了数据,可能导致行数缺失、指标统计偏移、关键业务记录遗漏。只有在确认异常行纯属日志杂质、注释行或无价值脏数据时,跳过才合理;在多数情况下,应当先定位为何会多出字段,修正分隔符或引用解析规则才是根本解法。
1. 常见诱因与对应参数调节
| 诱发场景 | 典型错误提示 | 核心排查思路与修复参数 |
|---|---|---|
| 实际分隔符并非逗号 | Expected 1 fields, saw 4 |
使用 sep=None, engine='python' 开启自动分隔符嗅探,或明确声明 sep='\t'、sep=';'。 |
| 字段内包含逗号且未被正确引号包裹 | Expected 4 fields, saw 5 |
检查 quotechar='"' 配置;若包含特殊转义符,配置 escapechar='\\'。 |
| 文件头部或尾部附带说明文本 | Expected 1 fields, saw 8 |
指定 skiprows=N 跳过顶部说明文字,或指定 skipfooter=N, engine='python' 剔除尾部统计行。 |
| 零星无法自动修复的脏数据行 | Error tokenizing data |
指定 on_bad_lines='warn'(打印警告并跳过)或自定义回调函数记录脏行。 |
2. 修复代码示例与引擎切换
import pandas as pd

# 方案 A:应对非标分隔符(如制表符、分号、甚至不规则空格)
# 切换为 python 引擎可获得更宽容的正则表达式支持
df = pd.read_csv("mixed_sep.csv", sep=r"\s+", engine="python")

# 方案 B:跳过文件前 3 行元数据描述,并忽略尾部 2 行汇总
df = pd.read_csv("report_with_notes.csv", skiprows=3, skipfooter=2, engine="python")

# 方案 C:安全隔离少量脏行并打印告警(pandas 1.3.0+ 推荐语法)
# 注意:在 pandas 1.3.0 之前,参数名为 error_bad_lines=False, warn_bad_lines=True
df = pd.read_csv("data_with_bad_rows.csv", on_bad_lines="warn")

# 方案 D:通过自定义函数捕获并持久化记录异常行,实现不漏查
bad_lines = []
def record_bad_line(bad_line):
    bad_lines.append(bad_line)
    return None  # 返回 None 表示跳过该行

df = pd.read_csv("data_audit.csv", on_bad_lines=record_bad_line, engine="python")
if bad_lines:
    print(f"[警告] 共隔离 {len(bad_lines)} 行结构异常数据,已存入待审计列表。")
四、综合实战:构建健壮的 CSV 防御性读取管道
为了在生产系统或批量数据管道中实现稳健加载,我们可以将编码嗅探、语法隔离与降级重试逻辑整合为一个高度健壮的通用函数。
import os
import pandas as pd

def robust_read_csv(file_path, **kwargs):
    """
    具备编码自适应与解析降级能力的健壮 CSV 读取函数
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"未找到目标文件: {file_path}")

    # 1. 尝试常规 UTF-8 快速加载 (绝大多数情况走高性能 C 引擎)
    encodings_to_try = ["utf-8", "utf-8-sig", "gb18030"]
    last_exception = None

    for enc in encodings_to_try:
        try:
            return pd.read_csv(file_path, encoding=enc, **kwargs)
        except UnicodeDecodeError as e:
            last_exception = e
            continue  # 编码不匹配,换下一个编码尝试
        except pd.errors.ParserError as e:
            # 编码已通过,但发生解析格式错误,进入解析降级
            print(f"[提示] 文件 {file_path} 在编码 {enc} 下发生解析异常,尝试切换 python 引擎容错模式...")
            try:
                return pd.read_csv(
                    file_path,
                    encoding=enc,
                    engine="python",
                    on_bad_lines="warn",
                    **kwargs
                )
            except Exception as inner_e:
                raise inner_e

    # 若预设编码皆失败,抛出最后的异常
    raise last_exception

# 示例调用
if __name__ == "__main__":
    # 模拟读取测试
    # df = robust_read_csv("example_dataset.csv")
    print("防御性读取模块加载就绪。")
五、排查清单与参数决策全景总结
遇到读取错误时,无需盲目尝试参数,按以下两分钟排查清单执行即可高效率定位:
- 先看原生文本:在终端执行
head -n 10 data.csv或使用记事本打开,肉眼观察第一行与第二行:是否有非逗号的分隔符?表头前是否有空行或说明文字? - 定点排查编码:若终端提示
UnicodeDecodeError,优先测试encoding='gb18030'或encoding='utf-8-sig'。 - 定点排查解析:若报错提示
ParserError且指出具体行号(如 line 24),直接打开该行对比字段数,确认是否因文本包含未闭合引号或逗号导致溢出。 - 严守数据质量:切忌无脑加入
on_bad_lines='skip',必须清楚被丢弃的数据行所占比例及丢弃内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















