


解决Python爬虫中文乱码与元素定位失败的常见错误
深入解析Python网络爬虫开发中中文乱码与元素定位失败两大高频问题的底层成因,提供标准化排查流程、修复方案与防护实践。
在编写Python爬虫抓取目标网页时,开发者最常遭遇的两类阻碍就是“抓到的内容是乱码”以及“解析器找不到对应节点”。中文乱码的本质是程序解码所使用的字符集与服务器发送的原始字节编码不匹配;元素定位失败则通常由动态渲染、选择器书写不严谨或文档树作用域隔离所引起。本文将分别拆解这两类问题的底层机制,提供确切可行的排查步骤与修复方案。
一、中文乱码的根源剖析与标准排查路径
很多开发者在调用 requests.get(url).text 获取页面字符串时,会发现终端或文件中出现类似 éà 、锟斤拷 或 \xe4\xbd\xa0 的乱码内容。要解决乱码,首先需要了解数据从服务器到字符串对象的转化过程:HTTP传输的永远是二进制字节流(Bytes),客户端必须依据正确的字符集映射规则才能将其转换为人眼可见的字符。
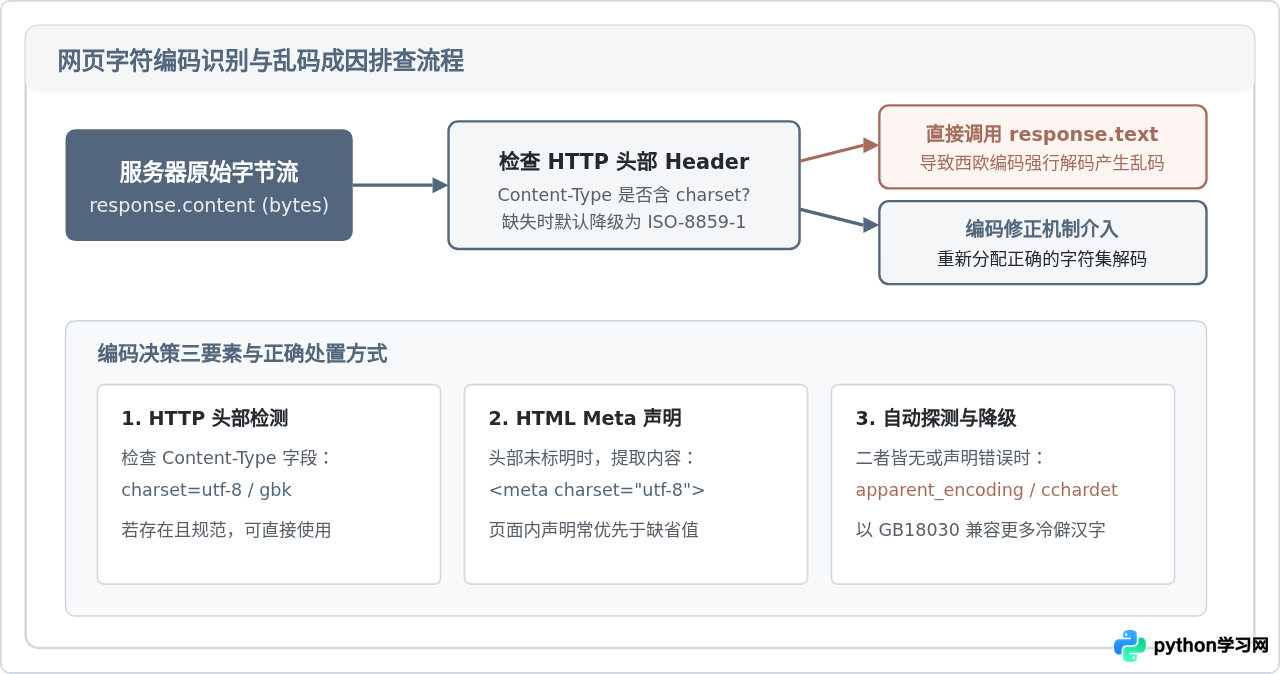
1. requests 默认编码回退机制的问题
在 Python 的 requests 库中,当响应头 Content-Type 中没有显式指明 charset 参数时,按照早期的 HTTP 1.1 标准规范,库内部会自动将 response.encoding 赋值为 ISO-8859-1(一种西欧单字节字符集)。现代中文网页绝大多数使用 UTF-8 或 GBK,如果直接调用 response.text,就会用 ISO-8859-1 去解析多字节的中文数据,从而生成形如 å
³é®è¯ 的乱码。
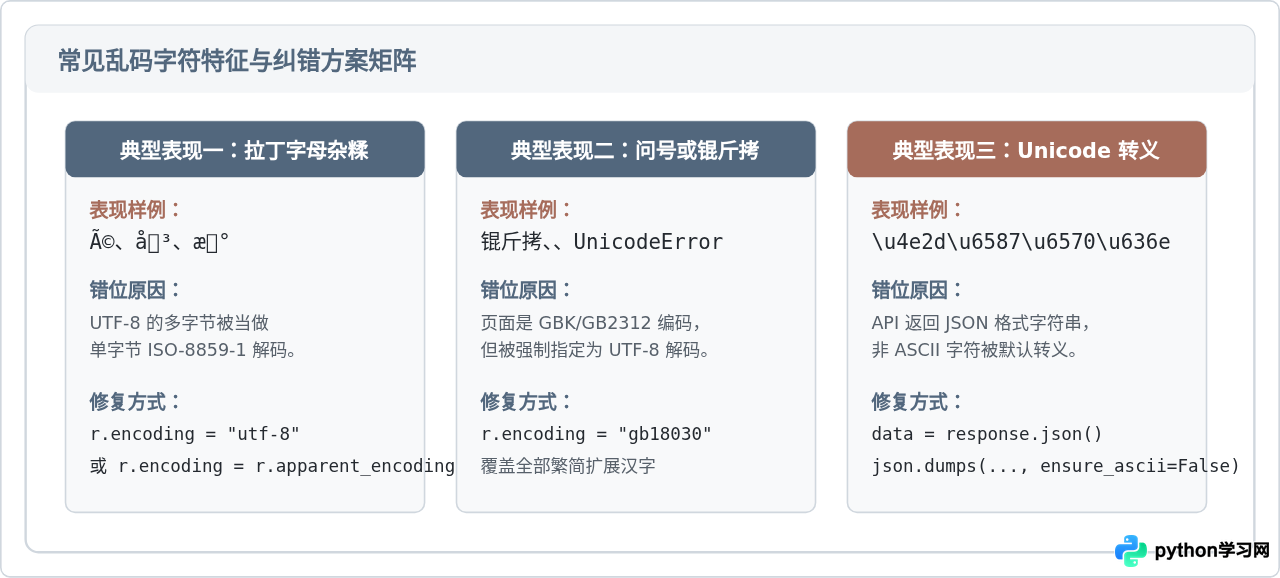
2. 常见乱码特征与对应成因
观察乱码的具体字符特征,往往可以直接定位出错的编码对应关系:
3. 正确且健壮的解码修复代码
解决乱码的原则是:优先保留原始字节 response.content,按优先级确定字符集后再解码。以下代码展示了能够适应不同网页编码的稳健实现:
import re
import requests

def fetch_html(url: str, timeout: int = 10) -> str:
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    response = requests.get(url, headers=headers, timeout=timeout)
    raw_bytes = response.content

    # 1. 优先提取 HTTP Response Header 中的 charset
    content_type = response.headers.get("content-type", "").lower()
    charset_match = re.search(r"charset=([\w\-]+)", content_type)
    if charset_match:
        declared_encoding = charset_match.group(1)
        try:
            return raw_bytes.decode(declared_encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 2. 其次在 HTML 前 2048 字节中正则寻找 meta 标签 charset
    meta_match = re.search(rb'<meta[^>]+charset=["\']?([\w\-]+)', raw_bytes[:2048], re.IGNORECASE)
    if meta_match:
        try:
            encoding = meta_match.group(1).decode("ascii")
            return raw_bytes.decode(encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 3. 兜底方案:使用 apparent_encoding 检测,或降级为兼容性更强的 gb18030
    apparent = response.apparent_encoding
    if apparent:
        try:
            return raw_bytes.decode(apparent)
        except UnicodeDecodeError:
            pass

    # 4. 最终容错解码
    return raw_bytes.decode("gb18030", errors="replace")
二、元素定位失败的排查步骤与修复方案
解决了字符编码后,第二类最容易让人陷入困惑的问题是元素定位失败。例如在浏览器开发者工具中能清晰看到 <div class="price">¥99</div>,但在 Python 代码中通过 soup.find('div', class_='price') 或 XPath 提取时,返回的却是 None 或空列表 []。
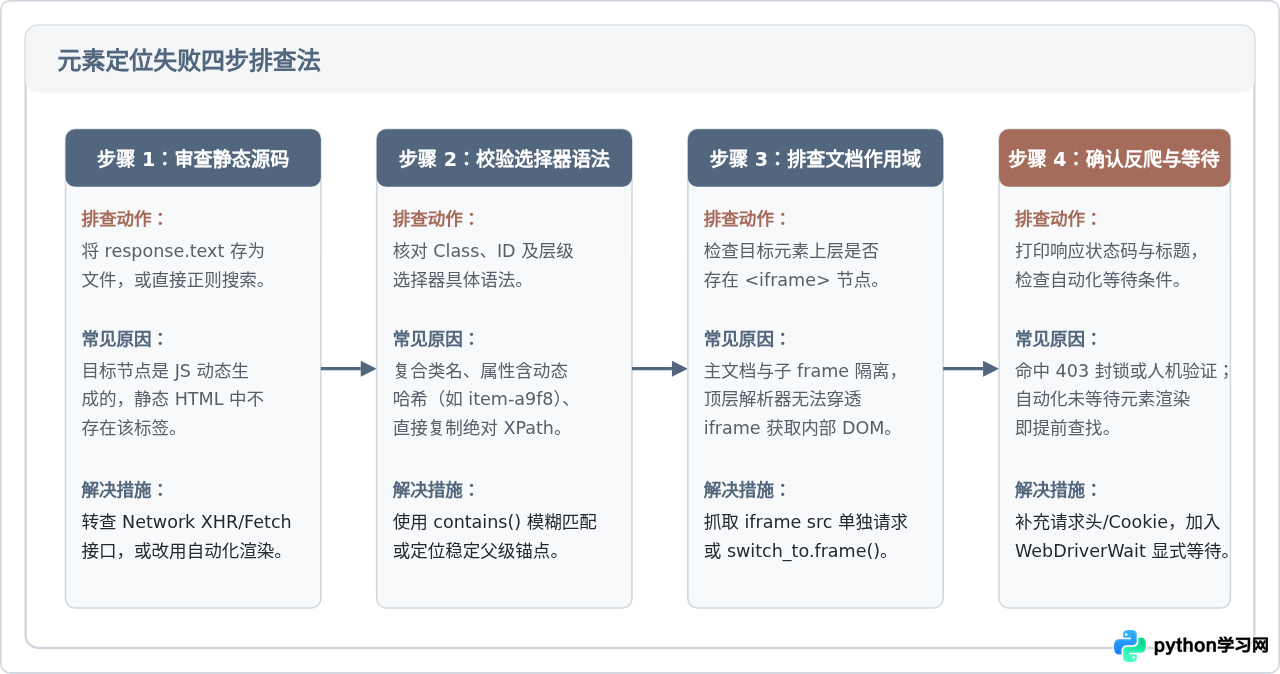
1. 静态 HTML 与浏览器渲染 DOM 的差异
很多初学者在浏览器中通过 F12 检查(Inspect)看到目标标签,直接右键复制 XPath 或 CSS 选择器放入 Python 代码中运行,结果却返回空。这是因为浏览器 F12 的 Elements 面板展示的是 JavaScript 执行完毕后生成的最终 DOM 树,而 requests.get() 拿到的仅仅是服务器返回的初始静态 HTML。
如果目标数据是通过 Ajax、Fetch 请求异步载入,或者由 Vue/React/Angular 前端组件动态渲染,那么在原始静态 HTML 中该节点完全不存在。验证方法很简单:在代码中执行 print(keyword in response.text)。若返回 False,说明该内容根本不在静态页面内,盲目调整选择器语法毫无意义,应当转向浏览器的 Network 标签页排查数据 API,或使用 Playwright / Selenium 进行渲染抓取。
2. 选择器语法编写的常见错误
当确认静态 HTML 中存在该节点后,定位失败通常由以下几类语法失误导致:
- 多 Class 类名匹配陷阱: HTML 标签为
<div class="content article-body clear">时,若使用 BeautifulSoup 的soup.find('div', class_='content article-body clear'),只要空格数量或顺序稍有变动就会匹配失败。正确的做法是仅匹配核心类名soup.find('div', class_='article-body'),或使用 CSS 选择器soup.select_one('div.article-body')。 - XPath 复制绝对路径: 浏览器右键复制的 Full XPath 形如
/html/body/div[2]/div[1]/section/div[3]/p,只要页面微调新增了一个横幅广告,层级序号就会全部移位导致断裂。应改用基于语义属性的相对路径,如//div[contains(@class, "article-body")]//p。 - XPath text() 节点被子标签截断: 例如
<a href="#">点击<span>详情</span></a>,表达式//a[text()='点击详情']将匹配失败。因为text()仅获取直接子文本节点,此时应使用string()函数或直接匹配属性。
from bs4 import BeautifulSoup
from lxml import etree

html_content = """
<div id="main-content">
    <div class="card item-box active" data-id="1001">
        <h3 class="title">Python数据分析</h3>
        <p class="price-tag">价格:<span class="num">99.00</span>元</p>
    </div>
</div>
"""

# BeautifulSoup 正确写法:避免全量多类名匹配,使用单一关键类或 CSS 组合选择器
soup = BeautifulSoup(html_content, "html.parser")
item = soup.select_one("div.card.item-box")
title = item.find("h3", class_="title").get_text(strip=True) if item else None

# lxml XPath 正确写法:使用 contains 进行模糊类名匹配,避免绝对层级依赖
tree = etree.HTML(html_content)
prices = tree.xpath('//div[contains(@class, "card")]//span[@class="num"]/text()')
print(f"提取结果: 标题={title}, 价格={prices[0] if prices else '未找到'}")
3. iframe 与多窗口隔离
如果目标元素包裹在 <iframe> 或 <frame> 标签内,它在结构上属于另一个独立的 HTML 文档。对于普通静态爬虫,解析器在当前文档内无法直接向下穿透,需要先提取该 iframe 的 src 属性 URL,并发起二次 HTTP 请求解析;对于使用 Selenium 或 Playwright 的自动化爬虫,必须显式调用切换上下文指令:
# 自动化浏览器(Selenium)中的 iframe 切换示例
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

driver = webdriver.Chrome()
driver.get("https://example.com/page-with-iframe")

# 1. 等待 iframe 加载完成并切换进入
iframe_element = WebDriverWait(driver, 10).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "iframe#sub-frame"))
)
driver.switch_to.frame(iframe_element)

# 2. 在 iframe 内部正常定位目标元素
target_text = WebDriverWait(driver, 10).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, ".inner-content"))
).text

# 3. 操作完成后切回主文档
driver.switch_to.default_content()
三、爬虫健壮性防护体系全景总结
网络爬虫是面向外部不确定环境的数据采集工程。避免乱码与定位失败的核心不在于事后临时调试,而在于建立分层严谨的健壮性采集流程。从网络请求、字符解码到 DOM 提取,每一层都应具备降级策略与异常兜底能力。
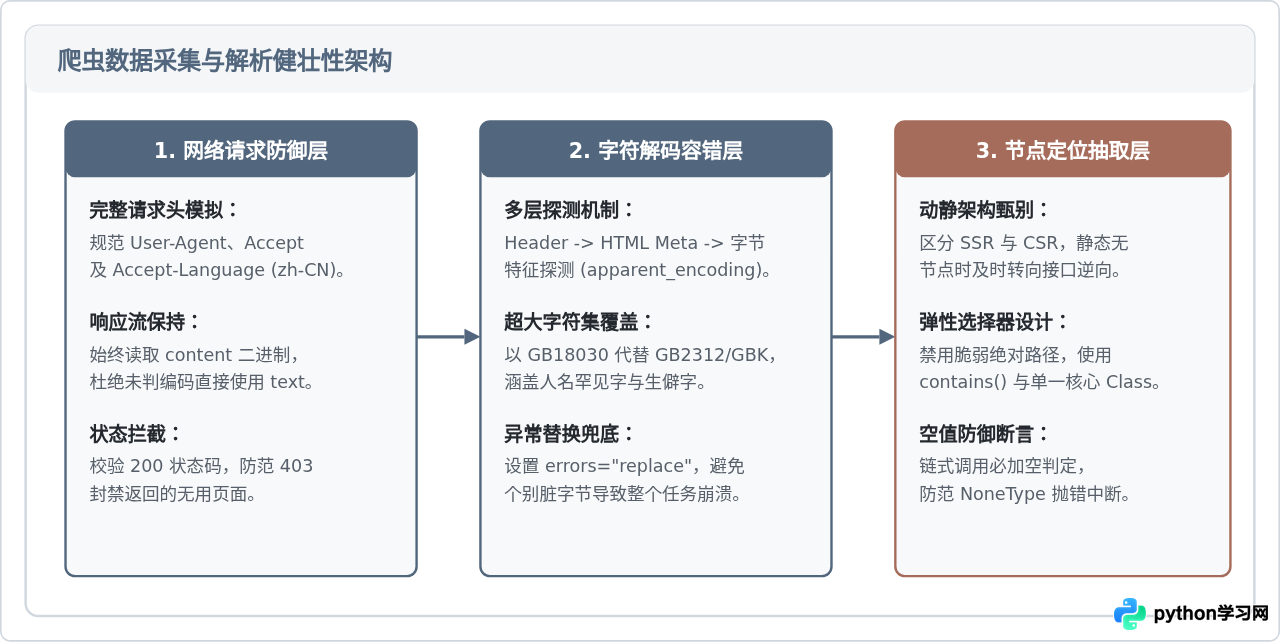
处理乱码时,记住永远以原始 bytes(即 response.content)为基准,不要在已经被错误解码的字符串上反复 encode/decode;处理元素定位失败时,记住先确认静态文本中是否存在该内容,再检查语法与作用域,避免在无效方向上耗费调试精力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















