


复现菜鸟教程Python爬虫代码报错?常见编码问题与选择器错误解决

在学习 Python 爬虫时,菜鸟教程等入门平台提供的示例通常结构清晰、精简直观。但不少初学者将示例代码复制到本地运行时,经常会遇到两类典型报错:一类是获取页面后文本出现生僻乱码或直接抛出 UnicodeDecodeError;另一类是使用 BeautifulSoup 或 XPath 解析数据时,抛出 AttributeError: 'NoneType' object has no attribute 'find_all' 或 IndexError: list index out of range。这两类问题并非 Python 基础语法有误,而是真实目标网页的字符集编码声明与实际返回不一致,以及真实 DOM 结构受浏览器规范化与动态渲染影响所致。本文将按问题发生根源、排查路径及防御式修复方法展开详细解答。
一、编码报错与网页乱码:成因排查与正确定位
入门教程中通常使用如下经典代码抓取页面内容:
import requests

url = "https://example.com"
response = requests.get(url)
print(response.text)
这段代码在请求部分国内网站或老旧站点时,最容易出现两类问题:输出控制台显示类似 é、彩页 的乱码;或者在尝试用 response.content.decode('utf-8') 时直接抛出 UnicodeDecodeError: 'utf-8' codec can't decode byte ... in position ...: invalid start byte。
1. 为什么 response.text 会导致中文乱码?
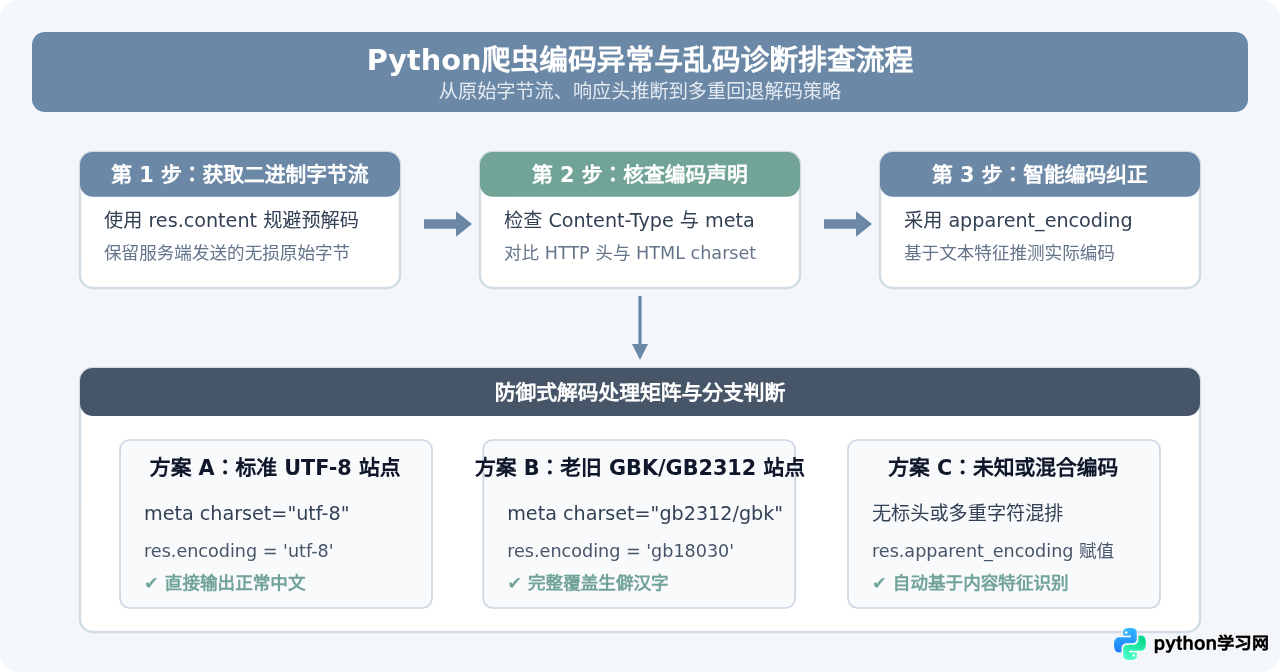
requests 库在访问 response.text 属性时,会自动根据 HTTP 响应头的 Content-Type 字段推测网页编码。如果目标服务器的响应头未明确携带 charset 参数(例如只返回 Content-Type: text/html),按照 HTTP/1.1 标准(RFC 2616),requests 会默认将其视为 ISO-8859-1(西欧字符集)。然而国内中文网站通常采用 UTF-8 或 GBK/GB2312 编写,使用西欧编码强行解码中文字节序列,必然产生乱码。
2. 为什么 decode('utf-8') 会抛出 UnicodeDecodeError?
许多初学者发现乱码后,便尝试改用 response.content.decode('utf-8')。但当目标网站实际采用的是 GBK 或 GB18030 字符集时,其汉字字节编码规则与 UTF-8 的可变长字节规范不兼容。Python 的 UTF-8 解码器在遇到不合规的起始字节时,就会抛出致命的 UnicodeDecodeError。
3. 编码问题的通用解决代码
最健壮的通用处理方式是在解析内容前,将 response.apparent_encoding 赋给 response.encoding,或者使用 GB18030 字符集进行容错解码(GB18030 向下兼容 GBK 与 GB2312):
import requests

url = "https://example.com"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}
response = requests.get(url, headers=headers)

# 方案1:自动修正 requests 的编码识别(推荐)
response.encoding = response.apparent_encoding
html_text = response.text

# 方案2:手动使用更宽泛的字符集对二进制流解码,并忽略无法识别的非法字节
# html_text = response.content.decode('gb18030', errors='replace')
二、选择器报错:NoneType 与 IndexError 根源深度剖析
解决完编码问题后,第二大绊脚石出现在数据解析阶段。许多初学者在 Chrome 浏览器中打开开发者工具(DevTools),右键某个元素选择“Copy selector”或“Copy XPath”,直接粘贴进代码:
from bs4 import BeautifulSoup

soup = BeautifulSoup(response.text, 'html.parser')
# 常见报错写法 1:直接链式调用导致 AttributeError
title = soup.find('div', class_='content-box').find('h1').text

# 常见报错写法 2:XPath 索引超限导致 IndexError
# item = tree.xpath('//*[@id="main"]/table/tbody/tr[1]/td[2]/text()')[0]
运行后经常产生两种报错信息:
AttributeError: 'NoneType' object has no attribute 'find'(或has no attribute 'text'):说明前一步的find()没有匹配到任何节点,返回了None,在None上继续调用属性或方法必然崩溃。IndexError: list index out of range:说明xpath()或select()返回了一个空列表[],通过[0]取值直接触发列表越界。
1. 陷阱一:浏览器自动补充的 <tbody> 标签
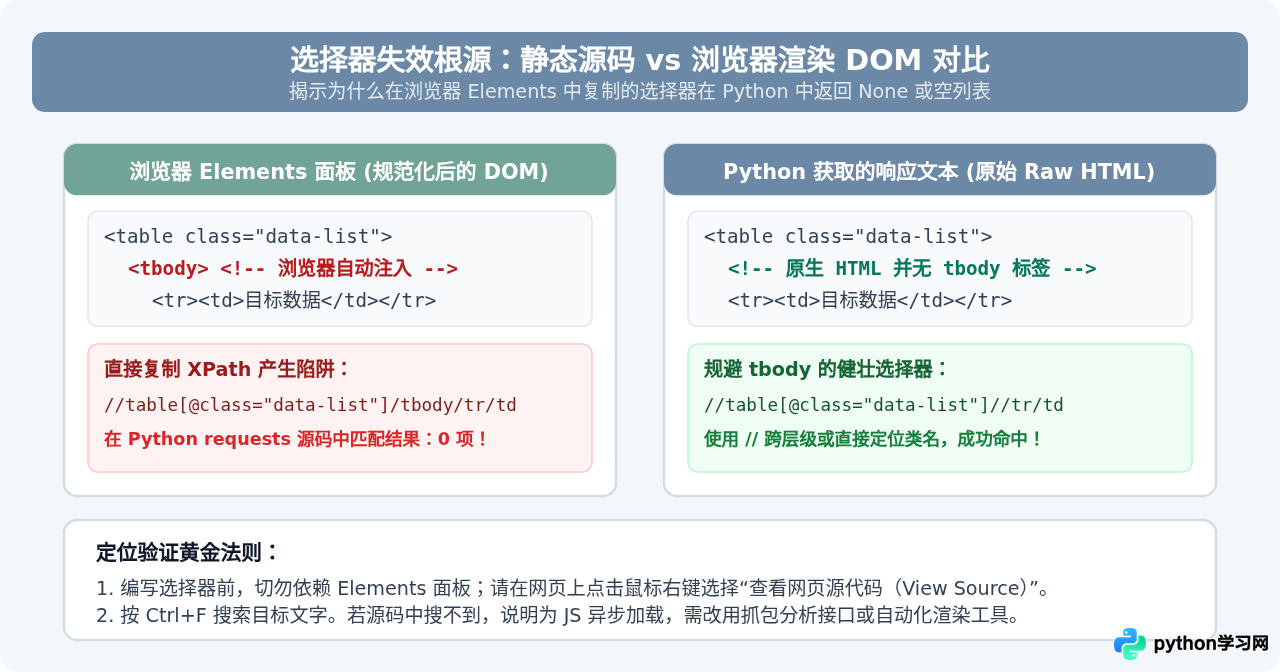
这是最隐蔽的错误来源。现代浏览器在解析 HTML 源码遇到 <table> 时,即使原始源码中并没有 <tbody>,浏览器渲染引擎(如 Blink、WebKit)也会在内存中的 DOM 树上自动补全 <tbody> 标签。当开发者从 DevTools 的 Elements 面板中复制 XPath 时,路径中常常带有 /tbody/。然而爬虫获取的是服务器返回的原始静态文本,其中根本没有 <tbody>,导致 XPath 检索路径断裂,返回空列表。
2. 陷阱二:JavaScript 异步动态渲染(Ajax / SPA)
在菜鸟教程中,绝大多数演示案例使用的是传统的服务端渲染(SSR)页面,静态 HTML 源码中直接包含文字数据。但现代很多网页采用前端框架(Vue、React 等)异步请求 API 接口后再通过 JS 渲染到 DOM 中。在浏览器中能够肉眼看到文字,但通过 requests.get() 下载的静态 HTML 中只包含一个空的 <div id="app"></div>,选择器自然无法定位到内容。
三、构建健壮防御式提取流水线
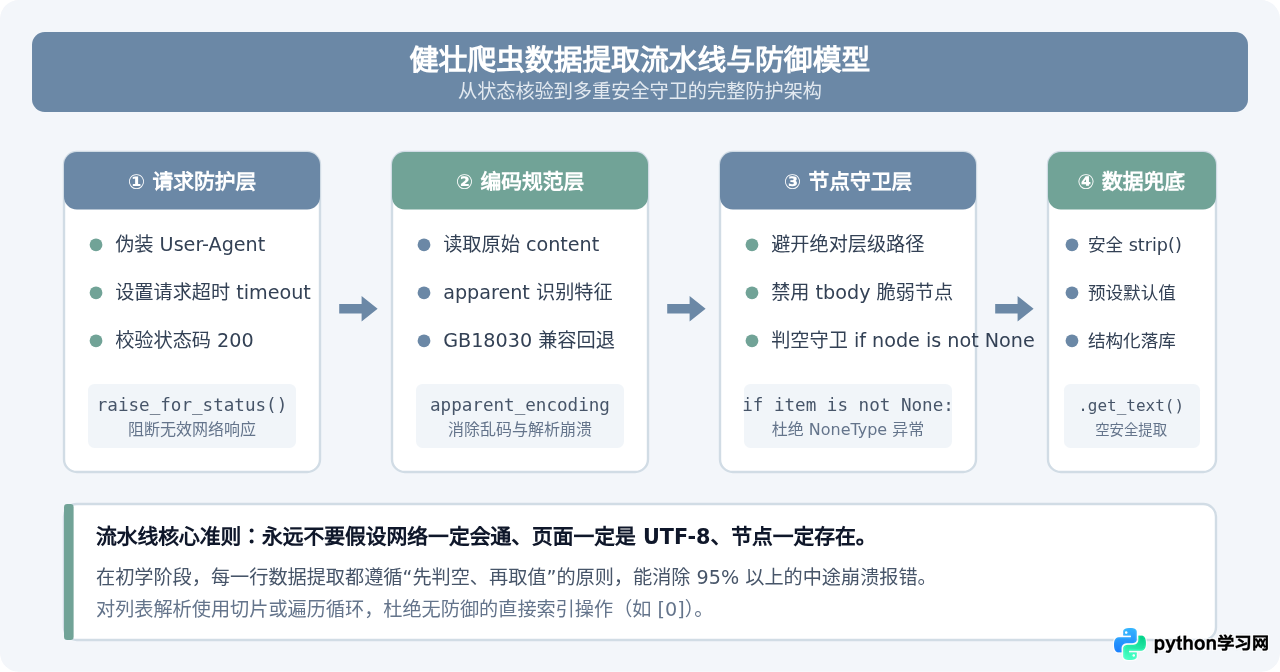
在菜鸟教程的基础示例上进行实战应用时,必须引入“防御式编程”思维。一个合格的数据提取流程应当由“网络请求防御”、“编码规整”、“节点安全检索”以及“数据清洗兜底”四部分组成。
4. 实战对比:改造菜鸟教程经典代码
下面给出一段经过健壮化改造的完整实战代码,对比展示初学脆弱写法与标准工程写法的差异:
import requests
from bs4 import BeautifulSoup

def safe_crawl_article(url):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9"
    }

    try:
        response = requests.get(url, headers=headers, timeout=10)
        # 1. 检查 HTTP 状态码
        if response.status_code != 200:
            print(f"[错误] 请求失败,状态码: {response.status_code}")
            return None

        # 2. 自动修正编码,解决 UnicodeDecodeError 与中文乱码
        response.encoding = response.apparent_encoding
        html_content = response.text

    except requests.exceptions.RequestException as e:
        print(f"[网络异常] 请求发生错误: {e}")
        return None

    # 3. 解析 DOM 树
    soup = BeautifulSoup(html_content, 'html.parser')

    # 4. 防御式提取:避免直接链式调用导致 AttributeError
    article_container = soup.find('div', class_='article-body')
    if not article_container:
        print("[警告] 未匹配到正文容器,可能原因:选择器已变更或页面由 JS 异步渲染")
        return None

    # 5. 安全提取子节点与属性
    title_node = article_container.find('h1')
    title = title_node.get_text(strip=True) if title_node else "无标题"

    # 6. 安全提取列表:避免直接索引 [0] 引发 IndexError
    paragraphs = []
    p_nodes = article_container.find_all('p')
    for p in p_nodes:
        text = p.get_text(strip=True)
        if text:  # 过滤空段落
            paragraphs.append(text)

    return {
        "title": title,
        "paragraphs": paragraphs
    }

if __name__ == "__main__":
    test_url = "https://www.runoob.com/python3/python3-tutorial.html"
    result = safe_crawl_article(test_url)
    if result:
        print(f"成功抓取标题: {result['title']}")
        print(f"提取段落数: {len(result['paragraphs'])}")
四、常见避坑清单与排错自检总结
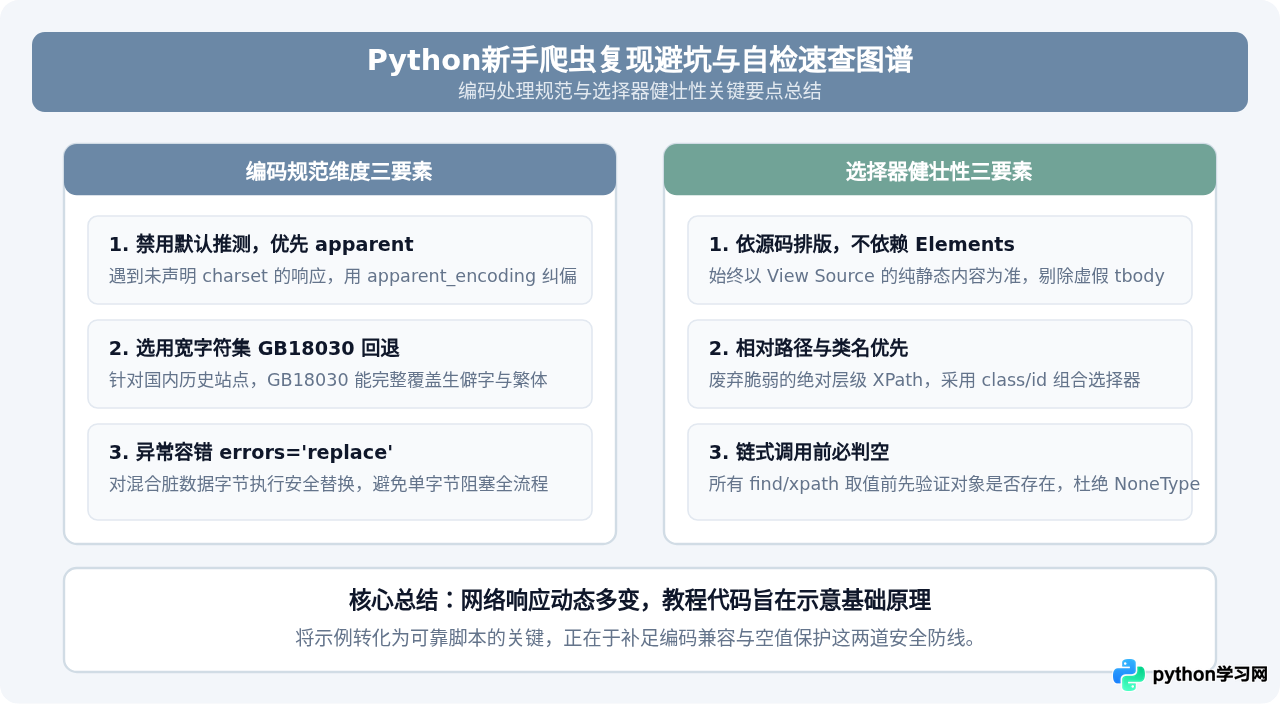
为了让读者在遇到同类问题时能够快速自查,下表整理了复现教程爬虫时最典型的报错现象、排查工具与修复手段:
| 报错现象 / 异常类型 | 产生根本原因 | 推荐排查方式 | 标准修复手段 |
|---|---|---|---|
UnicodeDecodeError |
网页实际编码为 GBK/GB2312,代码强行使用 utf-8 解码 | 查看网页 meta 声明或打印 apparent_encoding |
res.encoding = res.apparent_encoding 或使用 gb18030 解码 |
中文字符显示为 ã© 等乱码 |
HTTP 头未声明编码,requests 默认回退到 ISO-8859-1 | 打印 response.encoding 查看当前识别值 |
手动设置 response.encoding = 'utf-8' 或 apparent_encoding |
AttributeError: 'NoneType'... |
find() 未找到节点返回 None,随后强行 .text |
打印父级节点,检查网页是否改版或类名是否正确 | 增加 if node: 守卫语句,改用 node.get_text() |
IndexError: list index out of range |
复制了带 tbody 的 XPath,或目标内容由 JS 动态生成 |
右键查看网页源代码,Ctrl+F 检索目标文字 | 移除 /tbody/ 改用相对路径 //;JS 渲染改用接口请求 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















