


不训练模型也能用AI?Python调用大模型API开发应用教程
本教程详细讲解如何无需训练或微调大模型,使用Python直接调用主流大模型API构建AI应用。涵盖开发架构、环境与安全配置、基础与流式调用代码以及生产环境异常处理。
一、为什么开发AI应用不需要自己训练模型
在深度学习早期,落地一个自然语言处理任务通常需要经历语料收集、数据标注、模型架构设计、反向传播训练以及部署维护等完整环节。不仅硬件门槛高昂,整个交付周期也往往以月为单位计算。
大语言模型(LLM)的成熟彻底改变了这一分工。基础模型的预训练工作已由专业平台在数万张加速卡上完成,并对外开放了标准化的推理接口(Inference API)。对于绝大多数应用开发者而言,核心任务变成了“面向提示词与上下文设计应用逻辑”,即通过向API传递结构化的提示词(Prompt),获取模型返回的推断结果。
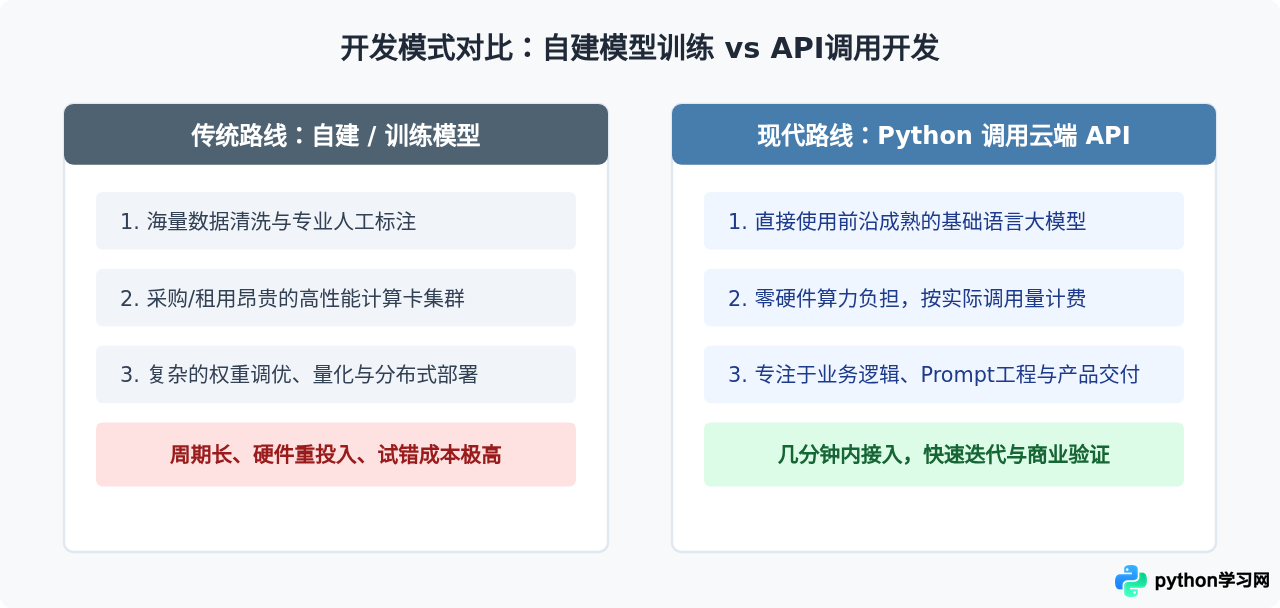
通过对比可以看出,除非企业拥有非常特殊且不能离开内网的专有结构化数据,或者是为了研究模型底层架构,普通软件开发完全应当选用API模式。你只需把精力放在核心业务流程的设计上。
二、开发准备与安全凭据配置
要通过代码调用大模型,首要任务是在模型平台获取身份认证凭据(API Key)。目前业界普遍采用 OpenAI 规范的 RESTful 接口体系,国内主流模型(如通义千问、智谱清言、Moonshot 等)也大多原生提供了兼容 OpenAI SDK 的调用协议。
1. 依赖安装
我们推荐在独立的 Python 虚拟环境中安装官方客户端工具库以及环境变量管理包:
# 创建虚拟环境(可选但推荐)
python3 -m venv venv
source venv/bin/activate  # Windows 环境使用: venv\Scripts\activate

# 安装官方客户端库与环境变量解析库
pip install openai python-dotenv
2. 环境变量隔离(严禁代码硬编码)
API Key 等同于你的账号密码和计费凭据。一旦不小心将带有 Key 的代码提交到公共仓库,可能会在数小时内造成大额账单损失。因此,必须将凭据与业务代码解耦。
在项目根目录创建一个名为 .env 的配置文件(并在 .gitignore 中加入该文件名):
# .env 文件内容
OPENAI_API_KEY="sk-your-actual-api-key-here"
OPENAI_BASE_URL="https://api.openai.com/v1"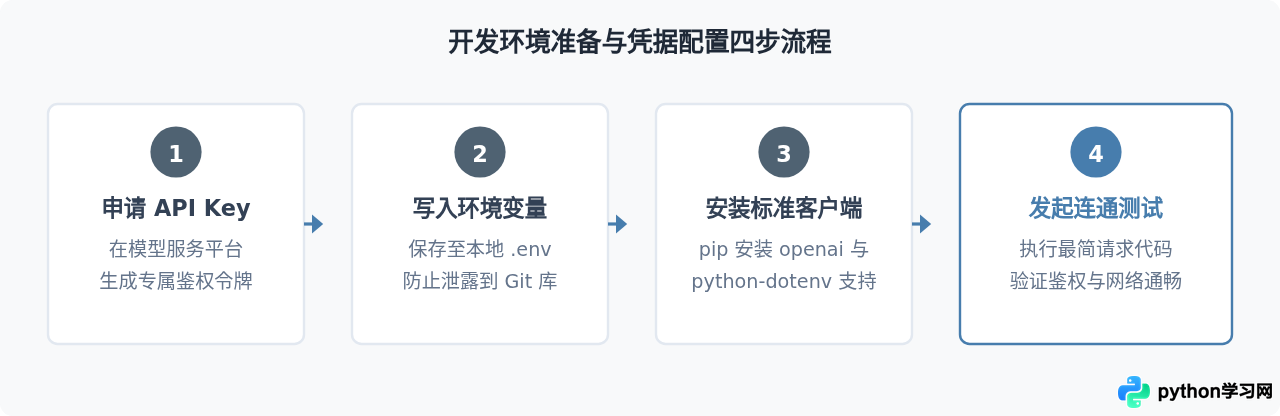
三、编写第一个基础调用程序
完成准备工作后,即可编写一段精简的 Python 脚本,向云端模型发送一条消息并打印其回复。
import os
from dotenv import load_dotenv
from openai import OpenAI

# 1. 加载本地 .env 文件中的环境变量
load_dotenv()

# 2. 初始化客户端对象
# 客户端会自动读取 OPENAI_API_KEY 与 OPENAI_BASE_URL 环境变量
client = OpenAI(
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url=os.getenv("OPENAI_BASE_URL", "https://api.openai.com/v1")
)

def ask_ai(question: str) -> str:
    response = client.chat.completions.create(
        model="gpt-4o-mini",  # 或所选服务商支持的具体模型型号
        messages=[
            {"role": "system", "content": "你是一位耐心、精确的 Python 编程助手。"},
            {"role": "user", "content": question}
        ],
        temperature=0.7,
        max_tokens=500
    )
    return response.choices[0].message.content

if __name__ == "__main__":
    prompt = "请用三句话向初学者解释什么是 Python 的列表推导式。"
    print("提问:", prompt)
    answer = ask_ai(prompt)
    print("AI回复:\n", answer)
关键参数解析
| 参数名 | 数据类型 | 核心作用与调优建议 |
|---|---|---|
model |
字符串 | 指定调用的模型标识符。开发测试阶段建议选用轻量模型(响应快、资费低),复杂推理任务选用大规格模型。 |
messages |
列表 (List[Dict]) | 对话上下文数组。通过 system(系统设定指令)、user(用户输入)和 assistant(AI历史回复)构成完整的对话链条。 |
temperature |
浮点数 (0.0 ~ 2.0) | 采样温度。值越低(如 0.2),输出结果越严谨、确定;值越高(如 0.8),输出更富有多样性和创造力。代码与分类任务建议设在 0.1~0.3 之间。 |
max_tokens |
整数 | 单次输出的最大 Token 数量,用于限制返回长度以防止极端情况下的计费失控。 |
四、核心进阶:流式响应(Streaming)实现
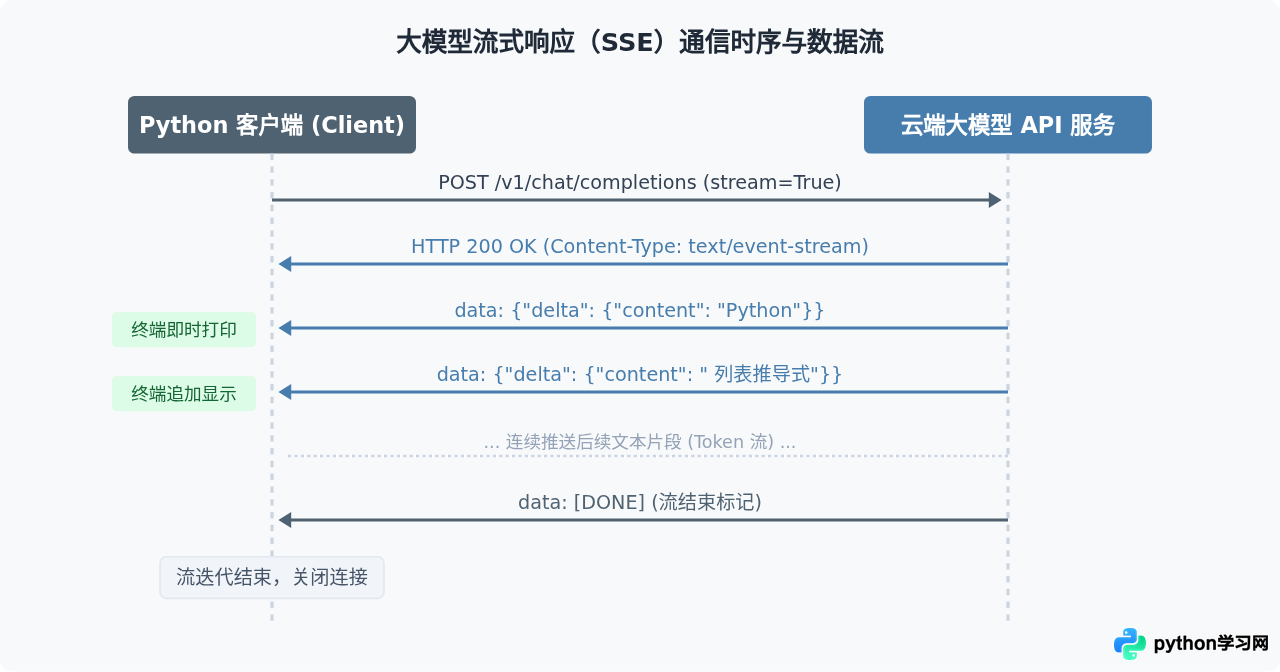
在常规调用模式下,客户端必须等待模型把整个完整段落推理完毕后,才能一次性接收到响应。当模型需要生成数百甚至上千字时,用户可能会在界面前面对长达数秒的空白等待,极大影响使用体验。
主流大模型服务都支持基于 Server-Sent Events (SSE) 的流式输出。通过在请求中配置 stream=True,模型推理出一个字或词块(Chunk),就会通过 HTTP 长连接即时推送到客户端,从而实现类似打字机的实时打字效果。
流式处理完整代码
利用 Python 的生成器特性,只需几行代码即可完成流式响应的解析:
import sys
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI()

def stream_chat(prompt: str):
    response_stream = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "你是一位资深技术博主。"},
            {"role": "user", "content": prompt}
        ],
        stream=True  # 开启流式推送模式
    )

    print("实时输出: ", end="", flush=True)
    full_content = []

    for chunk in response_stream:
        # 获取当前分块的内容片段
        delta = chunk.choices[0].delta
        if delta.content is not None:
            # 立即输出到控制台,不自动换行,并强制刷新缓冲区
            sys.stdout.write(delta.content)
            sys.stdout.flush()
            full_content.append(delta.content)

    print("\n\n[回答接收完毕,共", len("".join(full_content)), "字]")

if __name__ == "__main__":
    stream_chat("请简述 Python 装饰器在性能监控场景中的具体用法。")
五、生产环境必知:异常处理与防御机制
实际开发中,网络请求不可避免会遇到波动。在生产环境中直接裸跑 API 调用是非常脆弱的,容易因为临时性网络超时或频次限制导致整个应用崩溃。一个健壮的调用模块必须包含对常见异常的捕获与重试机制。
- 网络连通性异常 (APIConnectionError):DNS解析失败、代理中断或远端服务器丢包。
- 频次限制异常 (RateLimitError - HTTP 429):单位时间内请求并发数(RPM)或消耗Token数(TPM)超过服务商账户配额。此时切忌暴力重试,而应采用指数退避(Exponential Backoff)策略。
- 服务端内部错误 (InternalServerError - HTTP 500/503):云端平台负载过高或临时故障,通常重试1~2次即可恢复。
import time
from openai import OpenAI, APIConnectionError, RateLimitError, APIStatusError

client = OpenAI()

def robust_call(prompt: str, max_retries: int = 3) -> str:
    """具备自动重试与异常保护的 API 调用包装函数"""
    delay = 2  # 初始退避秒数
    for attempt in range(1, max_retries + 1):
        try:
            response = client.chat.completions.create(
                model="gpt-4o-mini",
                messages=[{"role": "user", "content": prompt}],
                timeout=15.0  # 显式设定请求超时,避免线程死锁
            )
            return response.choices[0].message.content

        except RateLimitError as e:
            print(f"[警告] 触发限流 (尝试 {attempt}/{max_retries}): {e},等待 {delay}s 后重试...")
            if attempt == max_retries:
                raise
            time.sleep(delay)
            delay *= 2  # 指数退避:2s, 4s, 8s

        except APIConnectionError as e:
            print(f"[网络错误] 连接中断 (尝试 {attempt}/{max_retries}): {e}")
            if attempt == max_retries:
                raise
            time.sleep(delay)

        except APIStatusError as e:
            print(f"[HTTP错误] 状态码 {e.status_code}: {e.message}")
            raise  # 业务参数错误(如 400 或 401 密钥失效)直接抛出,重试无意义
六、总结:大模型应用系统架构全景
综上所述,利用 Python 开发大模型应用的核心精髓在于架构解耦与工程化约束:前端负责收集用户交互,中台负责上下文装配、敏感词过滤与调用容灾,而重型推理运算则全权托付给云端大模型 API。
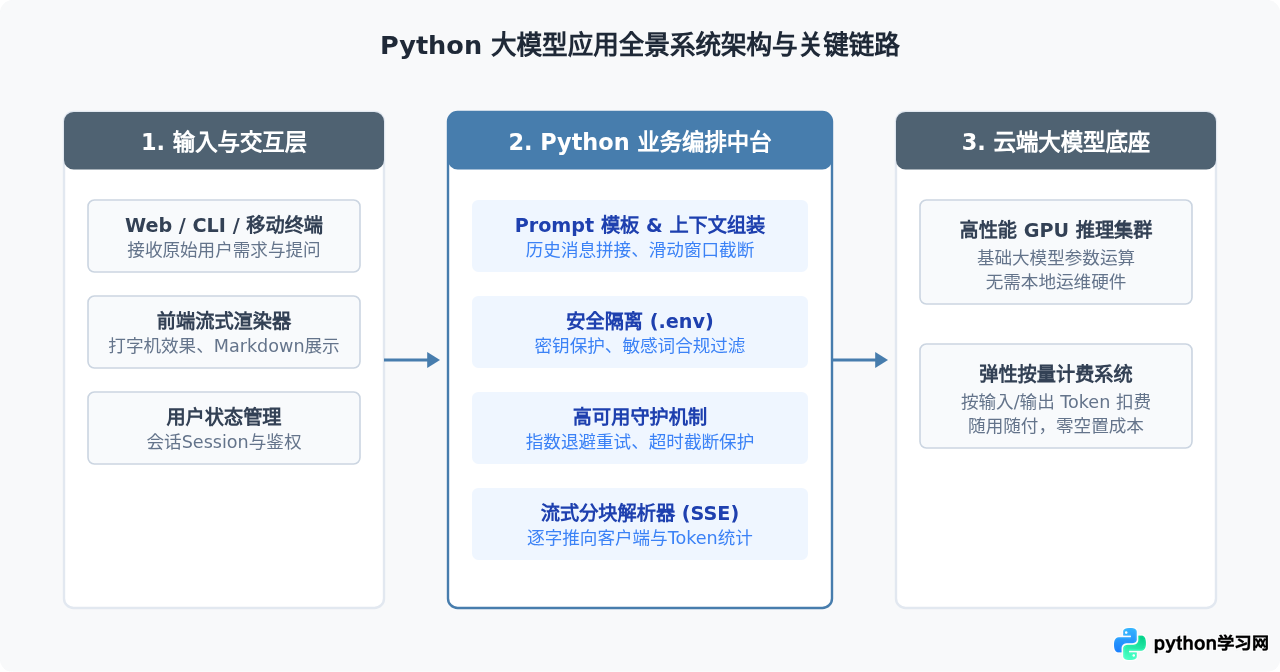
通过本文介绍的方法,你已经掌握了如何使用 Python 安全、可靠地连接大模型服务。以此为基石,你可以继续扩展实现长文本总结工具、智能客服机器人、代码辅助补全插件以及基于 RAG(检索增强生成)的企业知识库应用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















