


Python字典(dict)有哪些内置方法:完整清单与功能说明

全面梳理Python 3中字典(dict)的11个标准内置方法,详细解析其语法格式、返回值、原地修改特性、应用场景及避坑指南,并配以直观图解。
在 Python 3 中,字典(dict)是基于哈希表实现的键值对映射类型。除去双下划线的特殊方法(如 __getitem__、__iter__)外,Python 字典原生提供了 11 个标准内置方法。这些方法涵盖了字典在日常开发中的五大核心诉求:安全查询与取值、动态视图与遍历、新增与批量合并、键值删除与容器清理、以及内存复制。掌握这 11 个方法的具体行为、返回值及是否原地修改,是编写健壮、高效 Python 代码的基础。
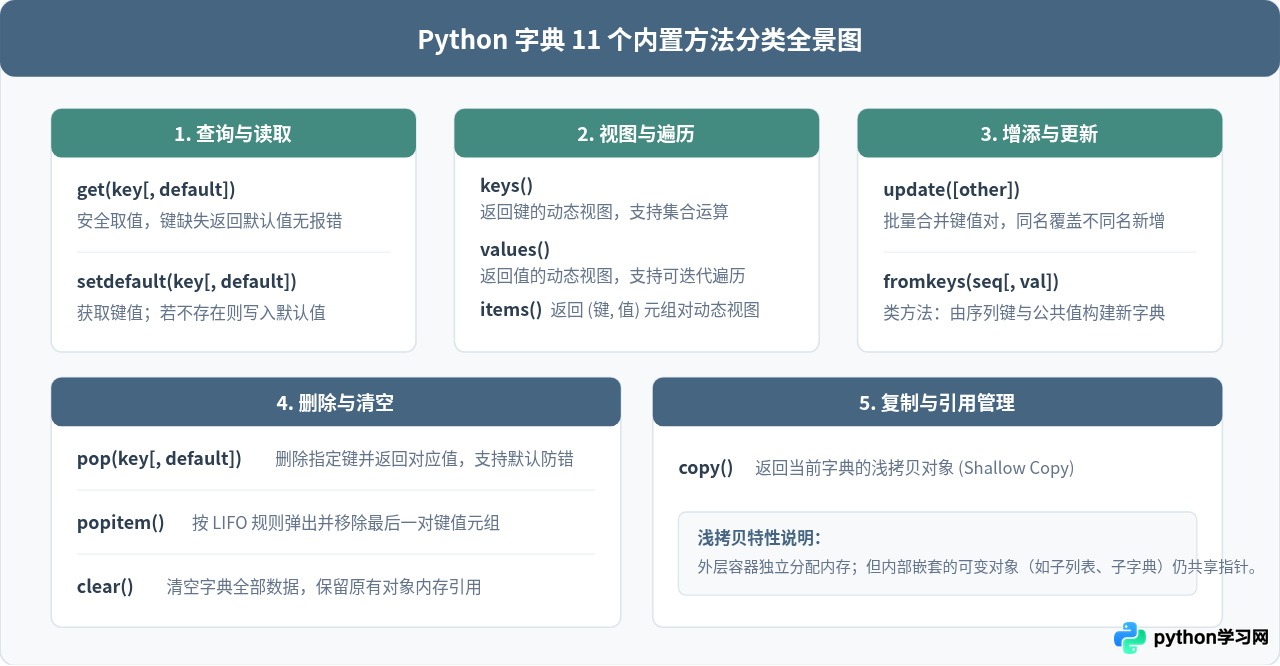
一、字典内置方法全览速查表
在深入每个方法的具体机制前,下表对这 11 个方法的原型、返回值类型以及是否会直接修改原字典(原地操作 In-place)进行了集中汇总:
| 方法名称与调用格式 | 作用说明 | 返回值 | 修改原字典 |
|---|---|---|---|
d.get(key, default=None) |
获取指定键的值,不存在时返回默认值 | 键对应的值或 default | 否 |
d.setdefault(key, default=None) |
键存在则返回其值;不存在则将键与默认值存入并返回 | 键对应的值或 default | 是(键不存在时) |
d.keys() |
获取包含字典所有键的动态视图 | dict_keys 对象 |
否 |
d.values() |
获取包含字典所有值的动态视图 | dict_values 对象 |
否 |
d.items() |
获取包含所有 (键, 值) 元组的动态视图 | dict_items 对象 |
否 |
d.update([other], **kwargs) |
用另一个映射或可迭代对象批量更新当前字典 | None |
是 |
dict.fromkeys(iterable, value=None) |
以序列元素作为键、统一默认值创建并返回新字典 | 新字典对象 | 否(类方法) |
d.pop(key[, default]) |
删除指定键并返回其对应的值 | 键对应的值或 default | 是 |
d.popitem() |
删除并返回最后插入的一对键值元组(LIFO) | (key, value) 元组 |
是 |
d.clear() |
清空字典内的全部元素 | None |
是 |
d.copy() |
返回当前字典的浅拷贝副本 | 新字典对象 | 否 |
二、查询与安全读取:get 与 setdefault
直接通过下标操作符 d[key] 取值虽然直观,但在键不存在时会直接抛出 KeyError,往往需要搭配 try...except 或 if key in d 检查。字典内置的 get() 与 setdefault() 提供了更为优雅安全的取值途径。
1. dict.get(key, default=None)
get() 方法用于检索键对应的值。若键存在,返回实际值;若键不存在,则返回指定的 default 参数(默认是 None),不会引发任何异常。需要特别注意的是:它绝不会向原字典中写入任何新键值对。
user_profile = {"name": "Alice", "role": "admin"}

# 键存在时
print(user_profile.get("name"))          # 输出示例: Alice

# 键不存在时,不设 default 默认返回 None
print(user_profile.get("department"))    # 输出示例: None

# 键不存在时,指定默认值
print(user_profile.get("status", "off")) # 输出示例: off

# 原字典完全不受影响
print(user_profile)                      # 输出示例: {'name': 'Alice', 'role': 'admin'}
2. dict.setdefault(key, default=None)
setdefault() 在查询的同时具备“惰性初始化”的副作用。它的执行逻辑如下:如果 key 已经存在于字典中,直接返回其现有值;如果 key 不在字典中,则将 key: default 插入到字典中,并返回该 default。
# 场景:为分类列表初始化默认空列表
inventory = {"fruits": ["apple"]}

# 键存在:直接返回现有列表,不修改
res1 = inventory.setdefault("fruits", [])
print(res1)        # 输出示例: ['apple']

# 键不存在:插入 "drinks": [] 并返回该空列表
res2 = inventory.setdefault("drinks", [])
res2.append("tea") # 直接对返回的引用追加数据

print(inventory)   # 输出示例: {'fruits': ['apple'], 'drinks': ['tea']}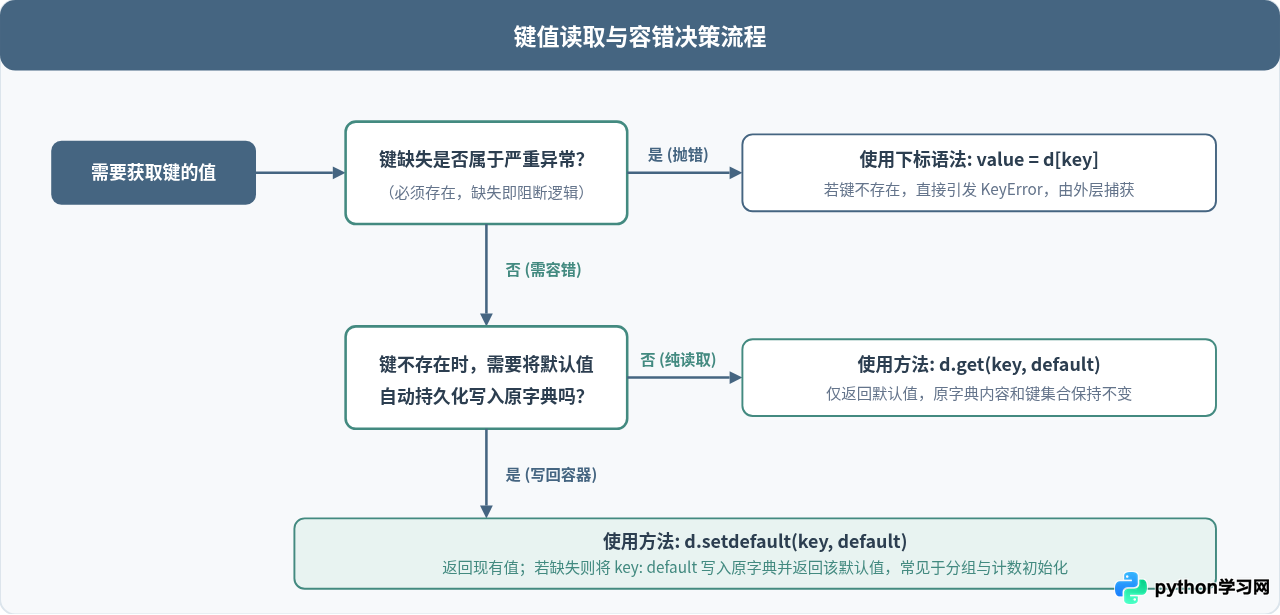
三、动态视图与遍历:keys、values 与 items
在 Python 2 中,keys()、values() 和 items() 会直接生成独立的列表。而在 Python 3 中,这三个方法返回的是动态视图对象(dict_keys、dict_values、dict_items)。视图对象不会复制字典的数据,而是像镜子一样直接映射底层数据结构。
1. dict.keys()
返回包含字典中所有键的视图。由于字典中的键具有互异性,dict_keys 支持类似数学集合(Set)的交集(&)、并集(|)和差集(-)等高级运算:
server_a = {"port": 80, "host": "127.0.0.1", "protocol": "http"}
server_b = {"port": 443, "ssl": True, "protocol": "https"}

# 获取所有共同的配置项键
common_keys = server_a.keys() & server_b.keys()
print(common_keys)  # 输出示例: {'port', 'protocol'}
2. dict.values()
返回包含字典中所有值的视图。值允许重复且可能包含不可哈希对象,因此 dict_values 不支持集合运算,但完全支持 for 循环遍历、len() 统计以及 in 成员测试。
scores = {"math": 95, "physics": 95, "chemistry": 88}
print(list(scores.values()))  # 输出示例: [95, 95, 88]
print(95 in scores.values())  # 输出示例: True
3. dict.items()
返回包含 (key, value) 元组对的视图。这是遍历字典最常用的方式,支持同时解包键与值:
user = {"id": 1001, "name": "Bob"}
for k, v in user.items():
    print(f"{k} -> {v}")
# 输出示例:
# id -> 1001
# name -> Bob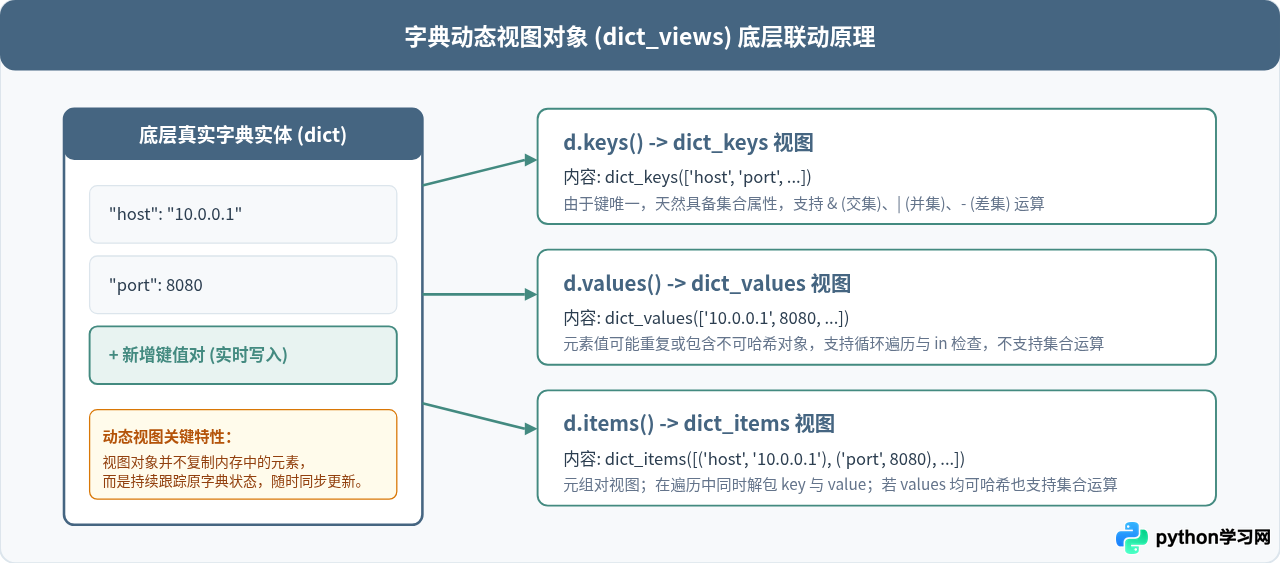
四、批量更新与快捷构建:update 与 fromkeys
1. dict.update([other], **kwargs)
update() 用于批量将键值对合入现有字典中。它是一种原地修改操作,执行完毕后返回 None。合并规则是:若目标字典中已有相同的键,则新值覆盖旧值;若不存在,则作为新键直接插入。
config = {"timeout": 30, "debug": False}

# 方式一:传入字典
config.update({"debug": True, "retries": 3})

# 方式二:使用关键字参数
config.update(max_connections=100)

# 方式三:传入包含二元元组的序列
config.update([("env", "prod"), ("log_level", "INFO")])

print(config)
# 输出示例: {'timeout': 30, 'debug': True, 'retries': 3, 'max_connections': 100, 'env': 'prod', 'log_level': 'INFO'}
2. dict.fromkeys(iterable, value=None)
fromkeys() 是一个类方法,通常通过类名 dict.fromkeys(...) 调用。它接收一个序列作为键的来源,并将每个键的值统一定义为 value(默认是 None),以此构建并返回一个全新的字典。
keys = ["status", "code", "message"]
default_dict = dict.fromkeys(keys, 0)
print(default_dict) # 输出示例: {'status': 0, 'code': 0, 'message': 0}fromkeys() 的 value 是一个可变对象(例如空列表 [] 或嵌套字典),所有的键都会指向同一个可变对象的内存地址!修改其中一个键的列表内容,其他所有键的值都会同步变化:
# 错误范例:所有键共享同一个列表对象
bad_dict = dict.fromkeys(["group_a", "group_b"], [])
bad_dict["group_a"].append("user1")
print(bad_dict)
# 意外结果: {'group_a': ['user1'], 'group_b': ['user1']}

# 正确做法:使用字典推导式为每个键独立创建列表
safe_dict = {k: [] for k in ["group_a", "group_b"]}
safe_dict["group_a"].append("user1")
print(safe_dict)
# 预期结果: {'group_a': ['user1'], 'group_b': []}
五、删除与容器清理:pop、popitem 与 clear
删除字典中的数据不仅是为了释放内存,更是为了在数据消费流程中准确控制状态。Python 提供了三种粒度截然不同的删除内置方法。
1. dict.pop(key[, default])
弹出并删除指定的键,同时返回该键对应的值。如果不提供 default 且键不存在,会抛出 KeyError;若提供了 default,键不存在时会平稳返回默认值。
task = {"task_id": "T101", "status": "running", "temp_token": "xyz789"}

# 提取并删除临时标记
token = task.pop("temp_token")
print(token)         # 输出示例: xyz789

# 安全弹出不存在的键
mode = task.pop("priority", "normal")
print(mode)          # 输出示例: normal
print(task)          # 输出示例: {'task_id': 'T101', 'status': 'running'}
2. dict.popitem()
移除并返回字典中最后插入的一对键值元组 (key, value)。自 Python 3.7 起,标准字典严格保证插入保序性,因此 popitem() 具备了严格的后进先出(LIFO)栈行为。若字典为空,调用该方法会报 KeyError: 'popitem(): dictionary is empty'。
stack_data = {"a": 1, "b": 2, "c": 3}
item = stack_data.popitem()
print(item)        # 输出示例: ('c', 3)
print(stack_data)  # 输出示例: {'a': 1, 'b': 2}
3. dict.clear() 与 d = {} 的本质区别
clear() 会移除原字典中的所有键值对,使字典变为空字典 {}。它是原地操作,不会改变字典在内存中的物理地址。如果多个变量名同时引用了该字典,调用 clear() 会让所有引用方看到空字典;而 d = {} 仅仅是让变量 d 重新指向了一个新建的空字典对象,原字典如果被其他变量引用,数据仍然留存。
shared_cache = {"data": [1, 2, 3]}
alias = shared_cache

# 使用 clear():影响所有引用方
shared_cache.clear()
print(alias)       # 输出示例: {} (数据被彻底清空)

# 对比重新赋值:
shared_cache = {"data": [1, 2, 3]}
alias = shared_cache
shared_cache = {}  # 仅改变 shared_cache 绑定目标
print(alias)       # 输出示例: {'data': [1, 2, 3]} (原数据依然存在)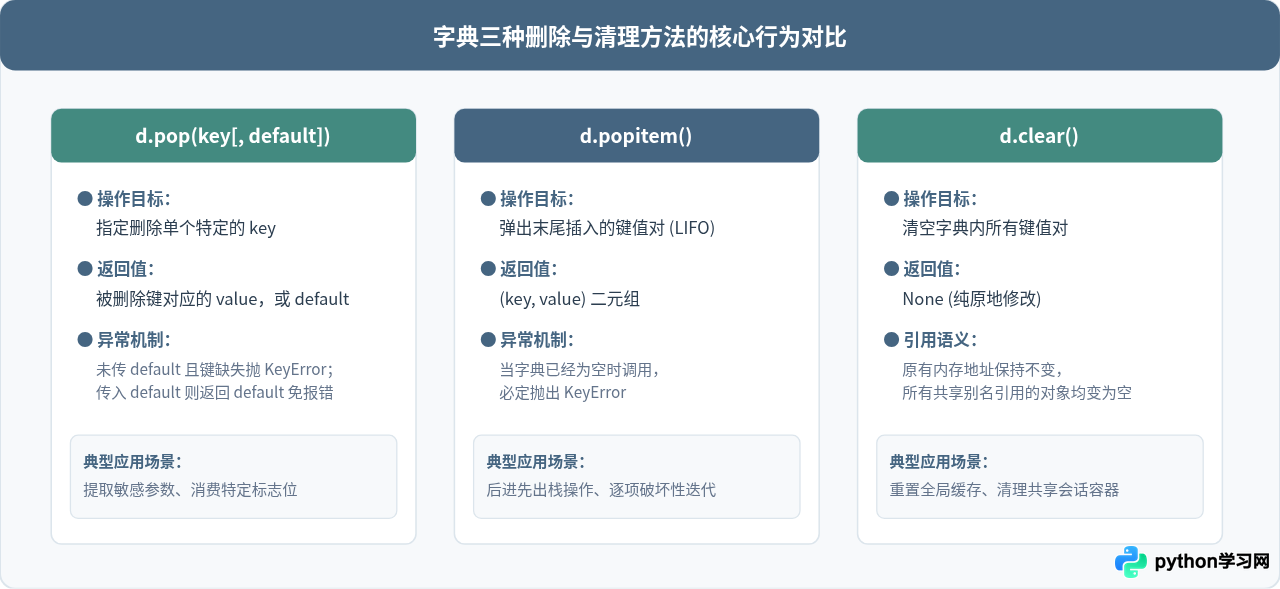
六、副本管理:copy 与深浅拷贝区别
1. dict.copy()
copy() 返回当前字典的一个浅拷贝(Shallow Copy)副本。它会为新字典分配一块独立的内存空间,并复制所有的顶层键值引用。在新字典中新增、修改或删除顶层键,完全不会影响原字典:
origin = {"a": 1, "b": 2}
cloned = origin.copy()

cloned["a"] = 999
cloned["c"] = 3

print(origin)  # 输出示例: {'a': 1, 'b': 2} (原字典不受影响)
print(cloned)  # 输出示例: {'a': 999, 'b': 2, 'c': 3}
2. 嵌套可变对象时的浅拷贝边界
如果字典的“值”包含列表、字典或集合等可变对象,copy() 仅仅复制了这些子对象的指针。修改子对象内部的数据,仍然会导致原字典与拷贝字典相互串扰:
import copy

data = {"user": "Tom", "tags": ["python", "dev"]}
shallow = data.copy()

# 修改子列表
shallow["tags"].append("backend")
print(data["tags"])     # 输出示例: ['python', 'dev', 'backend'] (原字典被连带修改)

# 若需彻底阻断关联,必须使用 copy 模块的 deepcopy
deep = copy.deepcopy(data)
deep["tags"].append("cloud")
print(data["tags"])     # 输出示例: ['python', 'dev', 'backend'] (完全独立)
七、总结与最佳实践选择
掌握 Python 字典的 11 个内置方法,能让开发者在处理键值映射时选择最恰当的工具:
- 单值读取:优先考虑
get()规避KeyError;若需要“不存在则初始化并填入”,使用setdefault()。 - 结构遍历:只要遍历键使用
for k in d或d.keys();同时操作键值对时使用for k, v in d.items()。 - 批量赋值:合并配置或字典片段时使用
update();从一组字段名生成初始模板时使用dict.fromkeys(),但切记不要向其传递可变默认对象。 - 删除元素:明确键名取用并移除使用
pop();栈式消耗使用popitem();彻底清空共享缓存容器使用clear()。 - 复制隔离:平铺字典直接使用
copy();若结构中含有多层嵌套,则应引入copy.deepcopy()保障数据安全性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















