


Python numpy.random批量生成随机数的高效实现
深入解析在Python中利用NumPy批量生成随机数的高效方法,涵盖现代default_rng生成器架构、多维向量化构造、原地内存写入及多线程派生技巧。
在数值计算、统计模拟、数据增强以及机器学习参数初始化等任务中,批量生成随机数是极为基础且执行频率极高的环节。当数据量上升至数千万甚至上亿规模时,低效的生成策略会瞬间拖慢整条计算流水线。实现批量随机数高速生成的核心路径非常清晰:彻底摒弃 Python 原生标量循环与 NumPy 早期基于全局状态的旧接口,全面迁移至现代解耦架构的 Generator(即 default_rng);同时合理设定连续内存维度、选用贴合精度的数值类型,并在大吞吐场景下配合原地写入(out 参数)机制,将随机数填充过程完全下沉至底层的 C 代码与 SIMD 向量化指令执行。
一、架构演进:为什么现代 NumPy 随机数更快更可靠
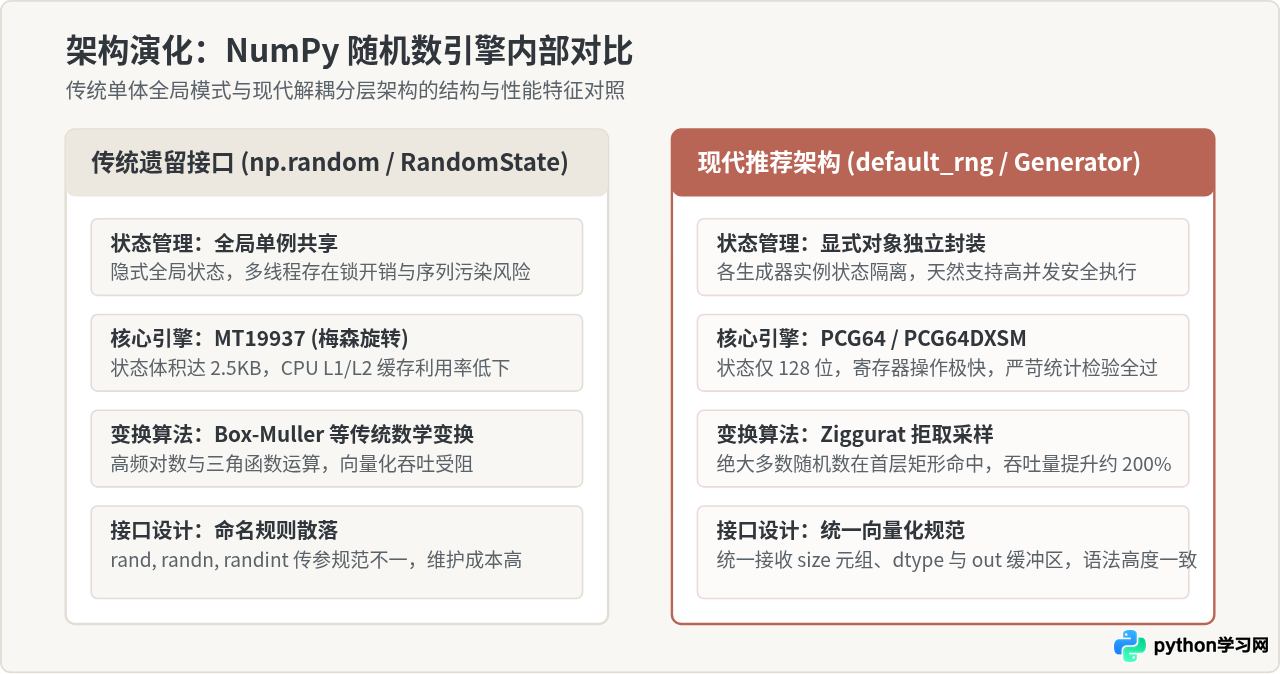
很多开发者在编写代码时,仍习惯性调用 np.random.rand()、np.random.randn() 或 np.random.randint()。这些函数属于 NumPy 1.17 之前的遗留接口(Legacy Random API)。遗留接口在底层绑定了单一全局的 RandomState 实例,不仅存在全局锁竞争,更限制了现代硬件算力的发挥。
自 NumPy 1.17 起,官方重构了随机数子系统,将整体架构清晰地拆分为两层:底层的位生成器(BitGenerator)与上层的分布生成器(Generator)。理解这一转变,是编写高性能随机数生成代码的前提:
- 底层算法升级:旧版接口绑定梅森旋转算法(MT19937),其内部状态体积高达 2.5KB,频繁调用容易造成 CPU 缓存颠簸,且无法通过严格的 TestU01 统计检验;现代
default_rng默认采用 PCG64(Permuted Congruential Generator),内部状态仅需 128 位,计算密度极高,缓存亲和性优秀,且通过了全套统计测试。 - 分布采样效率跃升:以正态分布生成为例,旧接口采用 Box-Muller 变换,涉及耗时的对数与三角函数运算;而现代 Generator 统一采用 Ziggurat(金字塔拒取采样)算法,98% 以上的采样点可在简单矩形判断内直接产生,批量生成速度相比旧接口提升近两倍。
- 实例隔离与并发安全:新接口强制使用独立实例,摆脱了全局隐式状态,使得在多线程与并发场景下生成独立伪随机数流变得非常直接。
二、标准实施:批量随机数高效生产的四个步骤
要规范且高效地完成大规模随机数生成,需遵循明确的工程流线。通过对种子规划、对象构建、内存布局与数据写出的分步管控,避免无谓的性能损耗。
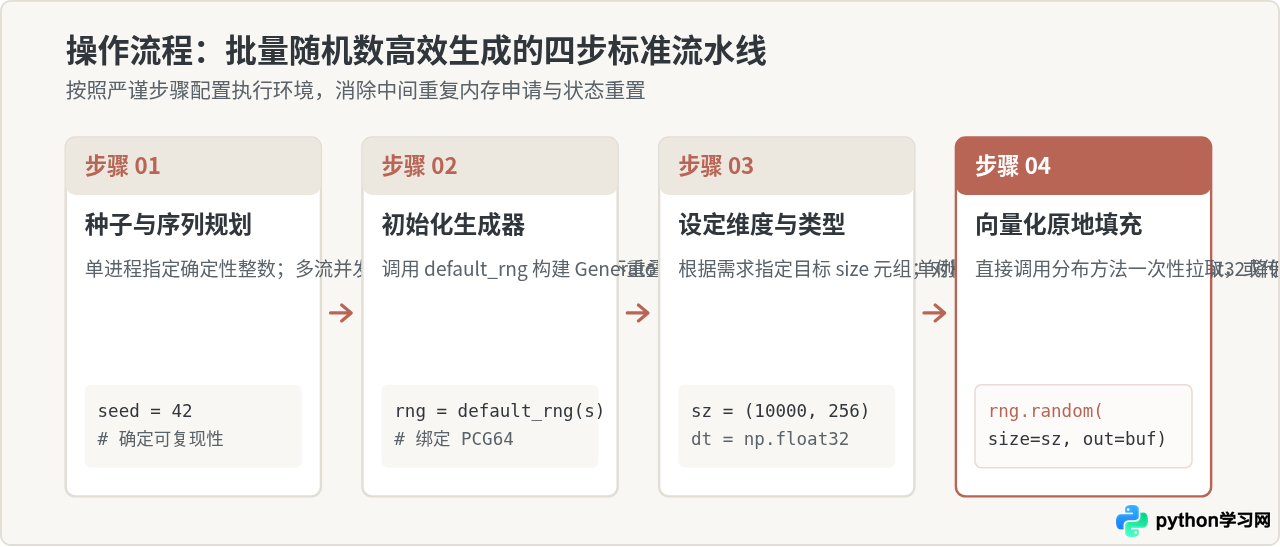
下面是完成上述四个步骤的完整执行代码:
import numpy as np

# 1. 种子配置:指定整数标量确保结果可重复
seed = 20261020

# 2. 初始化生成器:创建独立的 Generator 对象(底层绑定 PCG64)
rng = np.random.default_rng(seed)

# 3. 维度与精度规划:批量构造 1000 万个单精度浮点数
total_elements = 10_000_000
target_shape = (total_elements,)
target_dtype = np.float32

# 4. 一次性向量化生成:在 C 语言层完成连续内存写入
random_array = rng.random(size=target_shape, dtype=target_dtype)

print("生成形状:", random_array.shape)
print("数据类型:", random_array.dtype)
print("前五个样本示例:", random_array[:5])
三、核心分布的批量生成实践与接口选型
不同数值分布在数学转化上的开销差异很大。现代 Generator 将方法名进行了语义归一化,以下是常见场景下的标准写法:
1. 均匀分布浮点数:rng.random()
生成区间在 [0.0, 1.0) 内的浮点数。该方法直接调用底层位生成器并除以最大模数,是所有生成中开销最小的路径:
# 批量生成 (5000, 1000) 的二维均匀分布矩阵
uniform_matrix = rng.random(size=(5000, 1000), dtype=np.float32)
若需要任意闭开区间 [low, high),应使用 rng.uniform(low, high, size=...),它在 C 源码中直接进行线性缩放,效率优于手动在 Python 级别执行 low + (high - low) * arr。
2. 离散均匀整数:rng.integers()
取代旧版的 np.random.randint()。在批量生成类别标签、随机索引或打乱映射时使用:
# 生成范围在 [0, 100) 之间的 100 万个整数(32位整型)
int_samples = rng.integers(low=0, high=100, size=1_000_000, dtype=np.int32)

# 若需包含上限,指定 endpoint=True 即可生成 [1, 6] 的骰子点数
dice_rolls = rng.integers(low=1, high=6, endpoint=True, size=500_000)
3. 标准正态分布与高斯分布:rng.standard_normal()
生成均值为 0、方差为 1 的正态分布数据。得益于 Ziggurat 算法的高效实现,它是目前 NumPy 中最快的正态发生器:
# 批量生成标准正态分布数组
norm_samples = rng.standard_normal(size=2_000_000, dtype=np.float32)

# 若需指定特定均值 (loc) 与标准差 (scale),使用 rng.normal
custom_norm = rng.normal(loc=10.0, scale=2.5, size=2_000_000)
4. 离散抽样与置换:rng.choice() 与 rng.permutation()
在批量负采样、Bootstrap 抽样中,rng.choice 支持有放回(replace=True)与无放回(replace=False)采样,并支持概率加权 p 数组:
categories = np.array(["A", "B", "C", "D"])
probabilities = [0.1, 0.4, 0.3, 0.2]

# 批量抽取 500,000 个类别样本
sampled_labels = rng.choice(categories, size=500_000, replace=True, p=probabilities)
四、深层性能优化:内存复用与高并发技巧
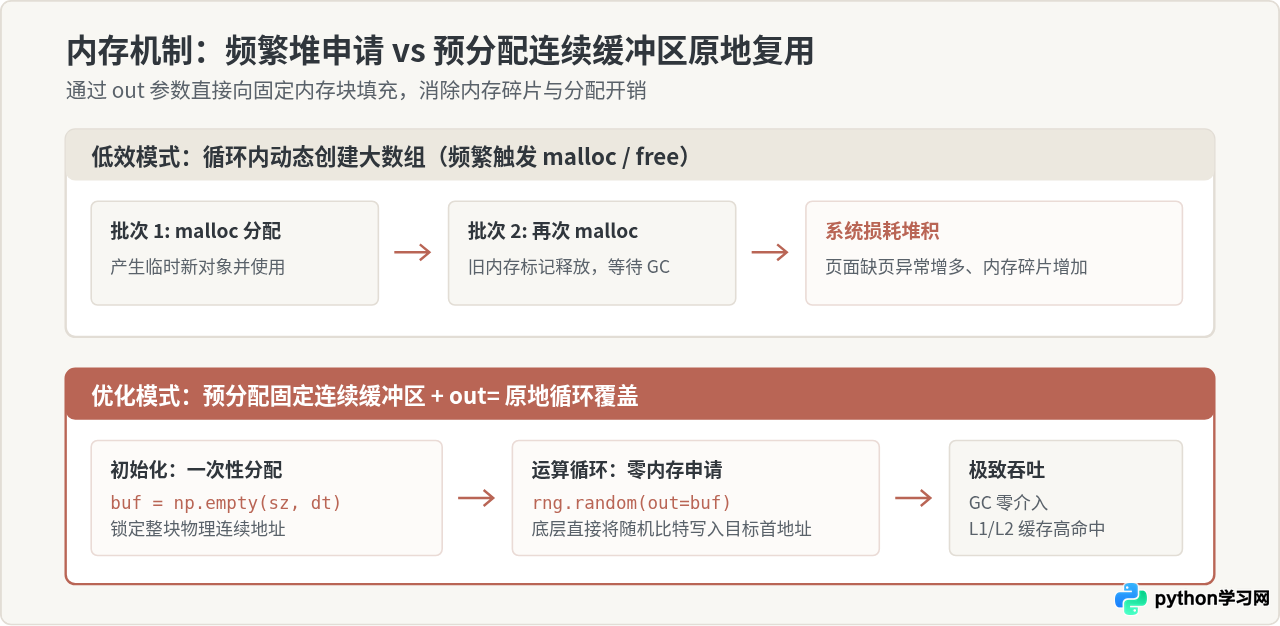
在追求极限吞吐时,单纯调用向量化 API 依然可能遇到瓶颈。这通常并非算力不足,而是由于频繁向操作系统申请堆内存导致的页表映射延迟与垃圾回收阻滞。
1. 善用 out 参数实现零冗余内存复用
在 Monte Carlo 迭代或批次训练中,经常需要在每一步迭代中生成一批全新随机数。常规写法每轮都会生成新对象,迫使 Python 频繁进行垃圾回收:
# 预分配固定形状的内存缓冲区
batch_size = (100_000, 64)
buffer = np.empty(batch_size, dtype=np.float32)

# 在批次迭代中反复原地填充,避免重复 malloc 与 GC
for epoch in range(10):
    rng.random(out=buffer)
    # 直接基于 buffer 执行后续向量化业务计算,无需释放对象
    process_data = buffer * 2.0
2. 数据类型(dtype)与内存带宽压制
NumPy 默认的浮点类型为双精度 float64(占 8 字节)。但在深度学习与许多工程仿真中,单精度 float32(占 4 字节)已完全具备足够的数值精度:
- 生成 1000 万个
float64随机数需要 80 MB 内存带宽; - 切换为
float32后仅需 40 MB 内存,耗时与内存开销直接减半,同时在现代支持 AVX2 / AVX-512 的 CPU 上能获得两倍的向量化并行吞吐。
3. 并行多进程/多线程:使用 SeedSequence.spawn
单独的 Generator 实例是非线程安全的。若在多线程中直接共享同一 rng 会引起状态竞争;若为每个工作进程简单传入 seed + i,又可能因伪随机数序列产生周期重叠而破坏统计独立性。
NumPy 官方提供了 SeedSequence,通过黄金分割比例(Golden Ratio)与散列变换,为多进程派生出数学上被严格证明不重叠的独立子序列:
from numpy.random import SeedSequence, default_rng
from concurrent.futures import ProcessPoolExecutor

def worker_task(child_seed):
    # 为每个工作进程独立构建 Generator
    local_rng = default_rng(child_seed)
    return local_rng.standard_normal(size=1_000_000, dtype=np.float32).mean()

# 规划根种子并派生出 4 个严格独立的子种子
root_ss = SeedSequence(123456789)
child_seeds = root_ss.spawn(4)

with ProcessPoolExecutor(max_workers=4) as executor:
    results = list(executor.map(worker_task, child_seeds))

print("并行独立子流计算均值:", results)
五、常见错误与反模式排查
即使使用了 numpy.random,如果不注意调用方式,仍可能意外退化为低效执行。以下是实际项目中最易出现的几个反模式:
| 反模式写法 | 产生原因与性能代价 | 推荐的高效实现方案 |
|---|---|---|
在 Python for 循环中单步调用 rng.random() |
每一次循环都产生函数调用上下文开销,完全无法发挥 C 级向量化与 SIMD 寄存器优势。 | 直接将循环次数传入 size 参数,一次性生成完整数组后再行切片或处理。 |
在循环体或高频函数内反复调用 default_rng() |
每次初始化都会执行底层状态装填与位生成器握手,不仅极慢,还会造成伪随机性被不断重置。 | 在模块启动或类初始化中创建单个全局/实例级 rng,并在生命周期内反复复用。 |
混用 np.random.seed() 与新生成器实例 |
np.random.seed() 仅对旧版全局 RandomState 生效,对 default_rng() 无任何控制作用。 |
统一在 default_rng(seed) 中传参,从工程中彻底移除旧版 np.random.seed。 |
六、全景选型与优化准则总结
为了在实际工程中快速制定合理的批量生成策略,可通过下方的全景决策图进行比对与选型:
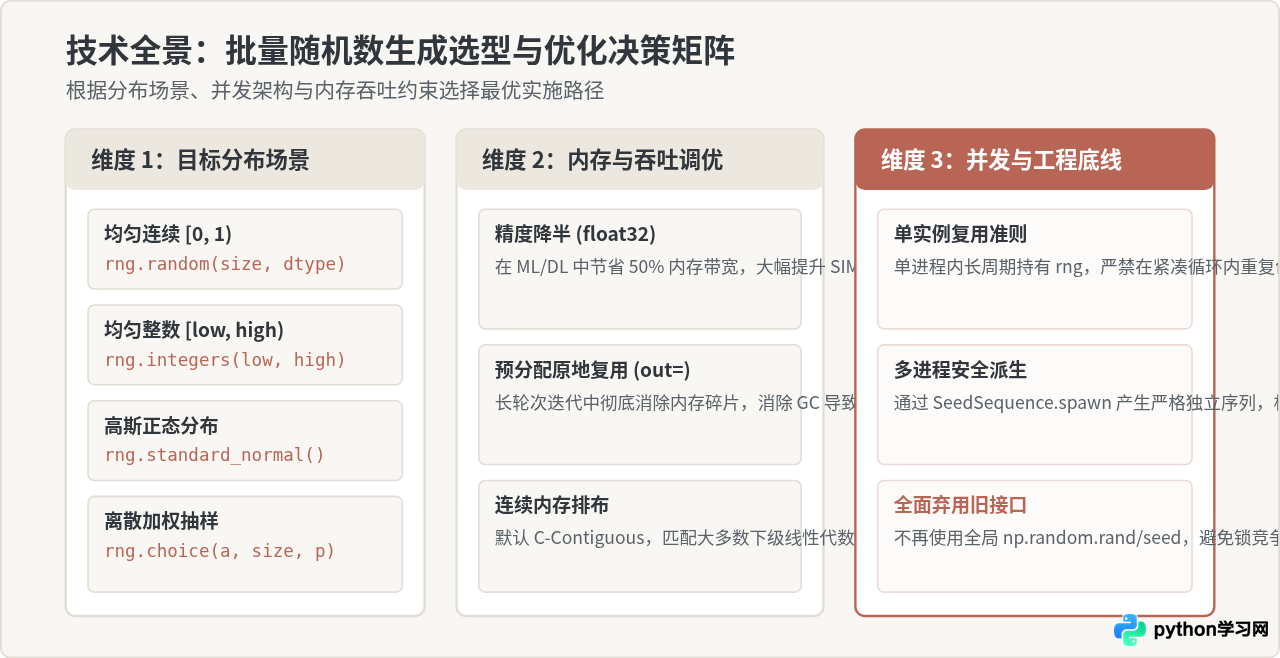
核心检查清单:实现高效随机数生成时,优先确认三点:① 是否已使用 np.random.default_rng();② 生成时是否直接向 size 传入了完整元组而非逐项循环;③ 超大批次场景下是否指定了贴合需求的 dtype=np.float32 并尽可能通过 out= 传入预分配内存。遵循这三条准则,即可确保随机数生成环节处于近乎硬件极限的吞吐状态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















