


Python爬虫常用库详解:从Requests到Scrapy的应用场景
深入详解Python爬虫核心库,涵盖Requests、httpx、BeautifulSoup、lxml、Playwright及Scrapy的特性、适用边界与架构差异,帮助开发者根据抓取规模与目标特征精准选型。
构建Python网络爬虫的核心在于根据目标站点的响应机制、数据传输协议以及采集规模,匹配最合适的工具链。很多初学者容易陷入两个极端:要么用Requests硬解高度依赖前端渲染的复杂网页,要么随手新建一个重型Scrapy工程抓取单页静态文本。本文将系统拆解Requests、httpx、BeautifulSoup、lxml、Playwright以及Scrapy的核心技术定位与运行机制,并给出清晰的选型决策依据。
一、Python爬虫工具栈体系全景
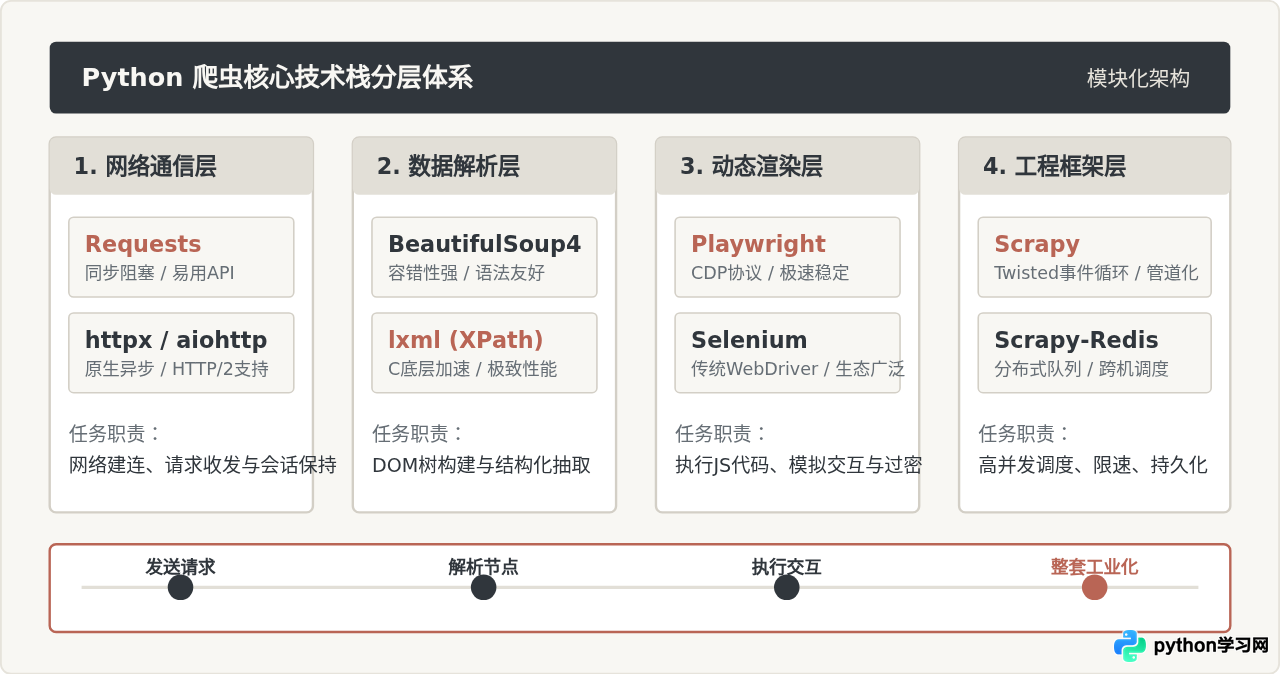
Python爬虫生态经过多年迭代,已经形成了职责分明的模块化分工。完整的采集工作流通常包含四个关键环节:HTTP通信层、内容解析层、动态仿真渲染层以及集成化工程调度框架。理解各个库所属的层级,是合理组合工具的前提。
二、轻量级同步抓取:Requests 与解析库组合
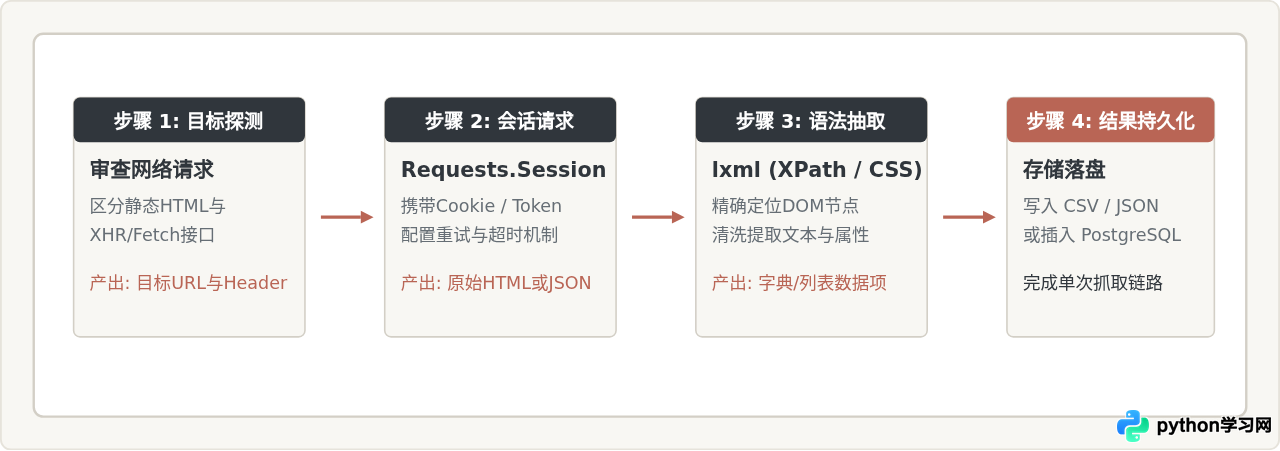
对于大部分服务端渲染(SSR)或提供公开 RESTful API 的网站,简单的 HTTP 请求搭配高效的 HTML 提取器是最直接有效的方案。Requests 库凭借高度人性化的 API 设计,成为这一场景下的事实标准。
1. Requests 的适用边界与性能特征
Requests 建立在 urllib3 之上,默认采用阻塞式 I/O。在发送请求时,主线程会一直挂起等待远端服务器响应。因此,当面对几百到上千个页面的小规模抓取时,编写单线程脚本配合简单的 concurrent.futures.ThreadPoolExecutor 即可高效完成任务。
需要注意:Requests 无法执行任何 JavaScript 代码。如果目标页面是通过前端 Vue/React 异步渲染,或者核心数据通过 WebSocket 推送,直接获取到的 HTML 往往只是一个空白的挂载节点(如 <div id="app"></div>)。此时应优先通过浏览器开发者工具检查网络面板中的 XHR/Fetch 接口;直接用 Requests 请求后端 JSON 接口,通常比解析整个 HTML 更快更稳定。
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 保持会话,自动管理Cookies与TCP连接复用
session = requests.Session()
session.headers.update(headers)

response = session.get("https://example.com/api/data", timeout=10)
if response.status_code == 200:
    data = response.json()
    print("获取数据条数:", len(data))
2. 解析器选型:BeautifulSoup vs lxml
获取到原始 HTML 字符串后,需要将其解析为结构化数据。初学者常用的 BeautifulSoup4 (BS4) 本质上是一个封装器,它可以底层绑定不同的解析引擎(如 Python 内置的 html.parser 或 lxml)。
- BeautifulSoup4: 优势在于 API 设计直观,对残缺或标签闭合错误的“脏 HTML”具有极强的容错修复能力。缺点是内存占用较高,纯 Python 包装层在大数据量解析时耗时明显。
- lxml: 基于 C 语言的
libxml2与libxslt库封装,原生支持 XPath 1.0 和 CSS 选择器。其节点遍历与查找速度通常是纯 Python 解析器的 5 到 10 倍,适合追求处理吞吐量的生产环境。
三、动态页面与反爬交互:Playwright 与自动化方案
当目标页面使用了大量单页应用技术、字体加密、滑动验证码,或者前端参数经过复杂的混淆签名(如动态 Token、Canvas 指纹)时,直接逆向 HTTP 接口的成本急剧攀升。此时,驱动真实的无头浏览器(Headless Browser)是性价比最高的突破途径。
1. Playwright 与 Selenium 的技术迭代
早期开发者主要依赖 Selenium,但 Selenium 基于 WebDriver 协议与浏览器通信,每次交互都需要经过中间代理进程进行 HTTP 转发,延迟高且容易在运行时出现失步现象。此外,Selenium 的 navigator.webdriver 属性极易被主流 WAF 识别拦截。
微软推出的 Playwright 则直接通过 Chrome DevTools Protocol (CDP) 以及对应内核的原生调试协议与浏览器底层长连接交互。其核心优势包括:
- 自动等待(Auto-waiting): 在执行点击、输入或获取属性前,Playwright 会自动检查元素是否已挂载、可见且可交互,彻底告别随处可见的
time.sleep()。 - 网络拦截与伪装: 原生支持在请求层过滤不需要加载的图片、媒体流或字体文件,显著降低带宽与内存消耗;同时支持修改请求头和响应体。
- 轻量级上下文隔离: 单个浏览器进程内可并行创建数百个彼此隔离的
BrowserContext,无需为每个会话重复启动完整的浏览器进程。
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    context = browser.new_context(viewport={"width": 1920, "height": 1080})
    page = context.new_page()

    # 访问目标页面并等待网络空闲
    page.goto("https://spa-example.com/products", wait_until="networkidle")

    # 自动等待元素渲染后提取
    titles = page.locator(".product-title").all_text_contents()
    for title in titles[:5]:
        print("商品标题:", title)

browser.close()四、框架工程化:Scrapy 的核心架构与高并发能力
当抓取目标从“单个页面的几十条记录”扩大为“全站数万个详情页”,并且需要处理深度爬取、URL去重、失败重试、自动限速和分布式存储时,脚本式的 Requests 或 Playwright 代码会迅速膨胀且极难维护。这是 Scrapy 不可替代的核心领域。
1. Scrapy 的内部运作引擎
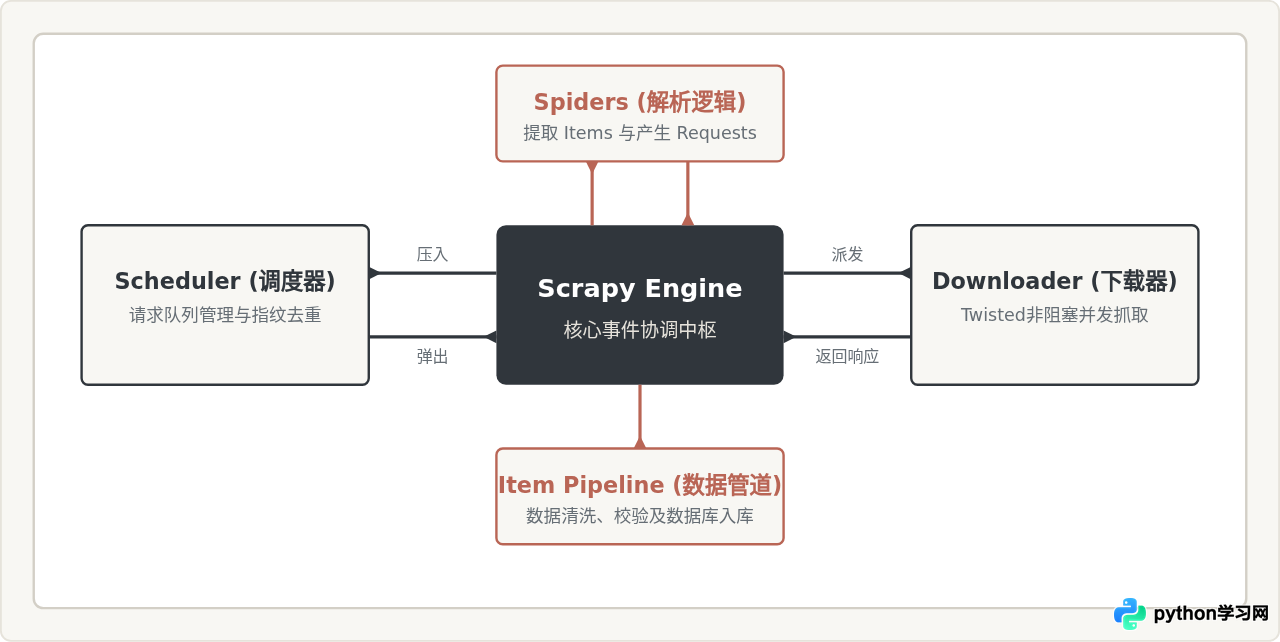
Scrapy 基于 Python 的异步网络库 Twisted 构建,采用事件驱动的非阻塞架构。整个框架由引擎(Scrapy Engine)统一协调调度,其各组件高度解耦:
- Engine(引擎): 控制整个系统的数据流,并在各个组件发生特定动作时触发事件。
- Scheduler(调度器): 接收引擎发来的请求并压入优先级队列,负责内置的指纹去重(RFPDupeFilter)。
- Downloader(下载器): 高效执行非阻塞 HTTP 请求并将 Response 交付引擎。
- Spiders(爬虫逻辑): 开发者编写的解析代码,负责提取结构化数据(Item)或产出新的下级待抓取链接(Request)。
- Item Pipeline(管道): 对 Spider 抽取的 Item 进行清洗、验证及数据库持久化。
五、实战选型决策指南
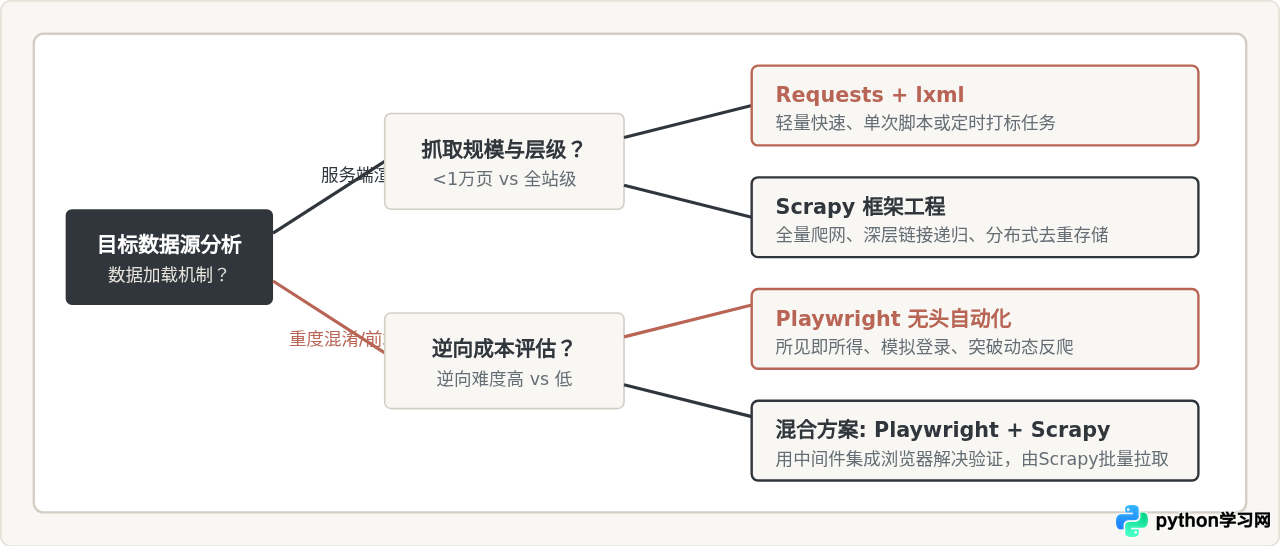
在面对具体的业务需求时,应综合衡量开发时间、运行效率、目标反爬强度以及并发规模,选择最匹配的技术路径,而不是盲目选用复杂框架。
2. 核心特性横向对比表
| 库 / 工具 | I/O 模式 | JavaScript执行 | 学习与开发成本 | 最佳适用场景 |
|---|---|---|---|---|
| Requests | 同步阻塞 | 不支持 | 极低,几行代码立即可用 | 单次脚本、静态页面抓取、公开 API 数据拉取 |
| lxml | -(DOM解析) | 不支持 | 中等(需熟悉 XPath/CSS) | 高性能 HTML/XML 抽取,高并发流水线内部处理 |
| Playwright | 异步 / 同步可选 | 完整支持(真实引擎) | 中等 | 单页应用(SPA)、复杂交互、验证码绕过、截图归档 |
| Scrapy | 异步非阻塞 (Twisted) | 默认不支持(可扩展) | 较高(规范的项目工程) | 整站深层采集、百万级高并发、企业级持久化流水线 |
六、总结与落地建议
在实际工程中,优秀的爬虫开发者绝不会“一把梭”只用某一个库。推荐的开发路径是:
- 先抓包后写代码: 面对任何目标,先用浏览器审查网络流量。如果有直接的 JSON API,即便前端页面再花哨,也只需要用
Requests带着对应 Header 直接请求接口,这是最高效稳妥的方式。 - 小脚本选 Requests + lxml: 在任务规模不大或数据只需一次性导出的情况下,直接组合 Requests 与 lxml 能在半小时内交付产物,无需为小型任务引入 Scrapy 的模板工程。
- 规模化首选 Scrapy: 一旦采集逻辑需要长期跑在服务器上,涉及故障自愈、失败重试、中间件监控及数据库批量写入,立即切换到 Scrapy。
- 反爬严苛时考虑自动化: 遇到高频变动的加密签名时,利用 Playwright 充当桥梁,既可以做全量渲染,也可以只作为凭据分发中心配合主爬虫运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















