


为什么Python矩阵运算推荐用NumPy而非原生列表循环
深入解析在Python中进行矩阵与数值计算时,为什么强烈推荐使用NumPy而非原生嵌套列表循环,从底层内存连续性、解释器开销、SIMD指令集优化及工程可维护性等维度全面对比。
在 Python 中处理矩阵乘法、线性方程组或批量数据变换时,直接编写多层 for 循环操作嵌套列表(list)不仅代码冗长,而且在大规模计算时运行速度往往比 NumPy 慢数十倍甚至数千倍。推荐使用 NumPy 的核心原因在于:NumPy 提供了连续整块的紧凑内存布局、彻底规避了 CPython 解释器的逐元素拆箱与动态查表开销、深度利用了现代 CPU 的 SIMD 矢量指令与高性能底层数学库(BLAS/LAPACK),并通过向量化语法提供了高表达力且不易出错的数学心智模型。
一、内存组织:连续数据缓冲区与离散指针引用的本质差异
Python 原生列表是一个动态通用容器。当我们构建一个二维矩阵 matrix = [[1.0, 2.0], [3.0, 4.0]] 时,外层列表存储的并非实际数值,而是指向各个子列表对象的指针;子列表内部存储的依然不是纯粹的数字,而是指向堆内存中独立 PyFloatObject 对象的指针。每个浮点数在 CPython 中都是一个包含引用计数、类型对象指针及双精度浮点值的完整结构体,通常需要占用 24 字节内存,而且分散分配在虚拟地址空间的不同区域。
NumPy 的核心数据结构 ndarray 采取了完全不同的策略。一个多维数组由两部分组成:一个存储步长(strides)、形状(shape)、数据类型(dtype)等元数据的精简头部结构体,以及一块在内存中连续排列的原始字节缓冲区。对于 float64 类型的数组,每个元素仅占用标准的 8 字节 IEEE 754 内存空间,数据紧凑且毫无冗余。
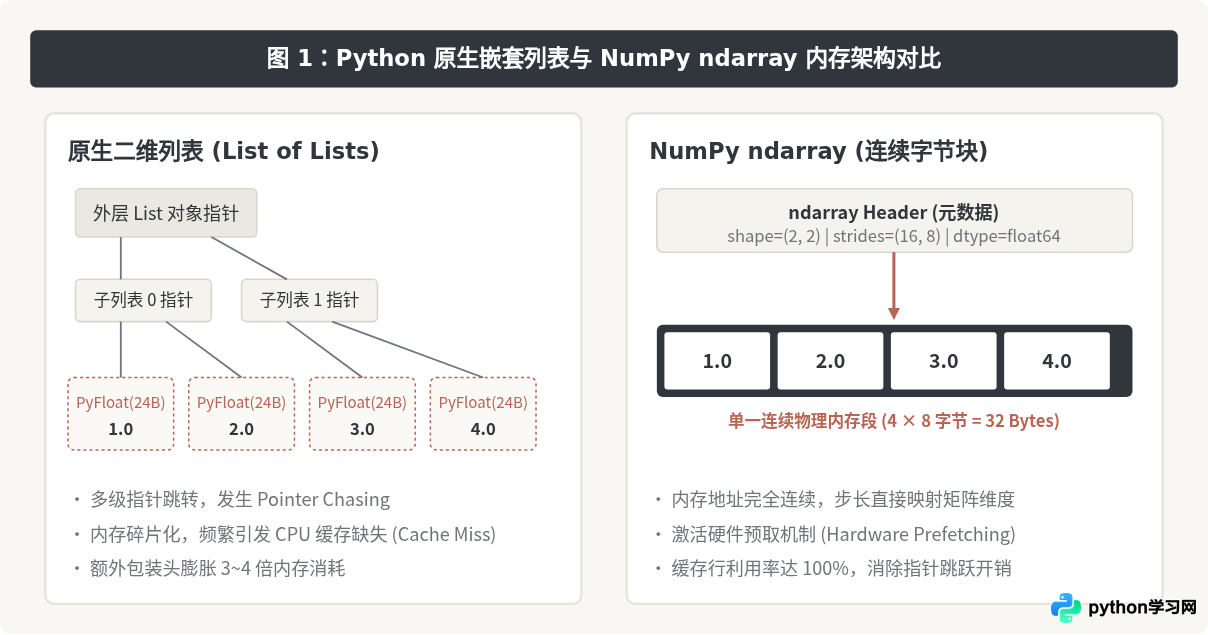
连续内存对于矩阵计算具有决定性优势。现代 CPU 访问内存的速度远落后于核心计算速度,因此高度依赖 L1、L2、L3 高速缓存。当 CPU 读取一个 NumPy 数组元素时,硬件预取器会一次性将连续的 64 字节缓存行装入缓存,接下来的运算命中率极高;而遍历 Python 原生列表时,每次通过指针访问下一个浮点数,都可能落在不同的内存页上,导致严重的缓存颠簸(Cache Miss)。
二、执行机制:解释器动态装箱 vs 编译级向量化与 SIMD
在 Python 原生列表中执行矩阵加法或乘法时,外层的每一个 for 循环都要经过 CPython 解释器的字节码求值循环(evaluation loop)。以一个简单的 c = a + b 为例,解释器必须执行以下完整流程:
- 执行字节码
FOR_ITER,检查循环边界; - 在堆栈上压入变量,进行动态类型检查(确认操作数是否支持加法操作);
- 调用 CPython 内部的拆箱函数(如
PyFloat_AsDouble),从对象头中取出真实的 C 语言double标量; - 执行 CPU 浮点加法指令;
- 调用内存分配器创建全新的
PyFloatObject,将结果数值包装进去,并更新引用计数以供垃圾回收追踪。
这意味着对于一个包含 100 万个元素的矩阵,上述类型检查、指针解引用、装箱拆箱操作需要重复整整 100 万次。计算耗时中只有不到 5% 用于实际数学运算,其余 95% 以上全部消耗在解释器运行时代价上。
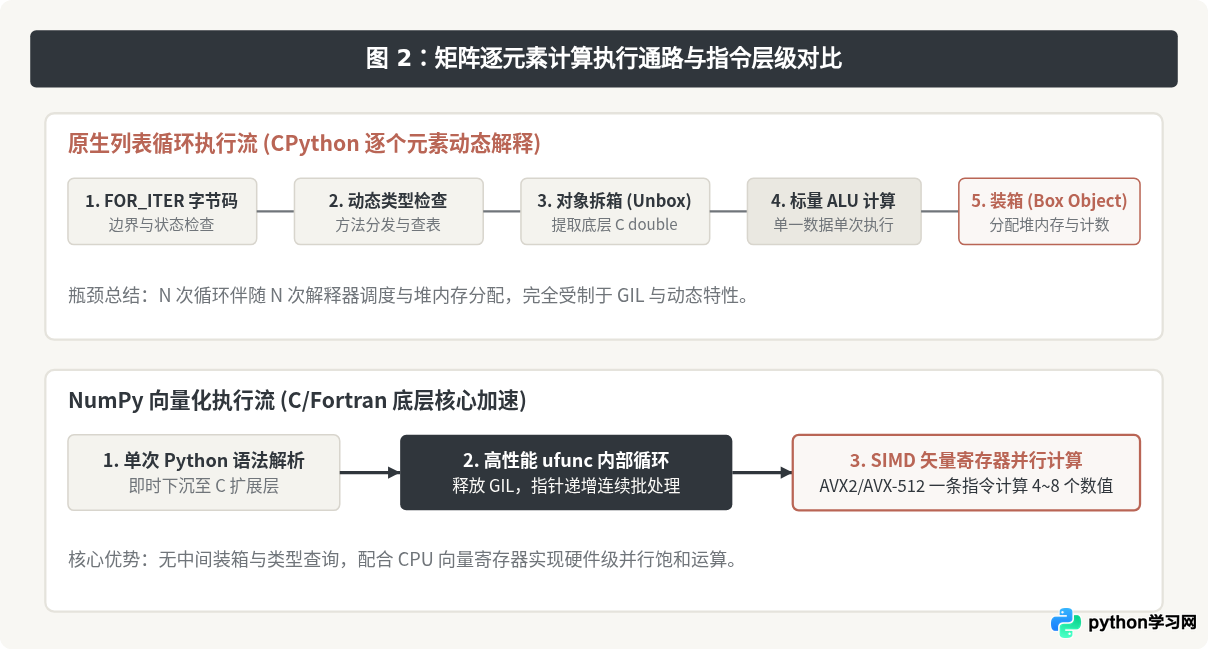
相比之下,NumPy 的算术运算通过通函数(ufunc)直接用预编译的 C 代码完成。在执行 C = A + B 时,Python 解释器仅在启动时介入一次,随后立即将两个数组的首地址与维度信息交给底层 C 循环。该循环释放了全局解释器锁(GIL),利用现代处理器的 SIMD(单指令多数据流,如 AVX2 或 AVX-512)指令集,一条指令即可同时完成 4 个或 8 个双精度浮点数的加法运算,性能直接逼近硬件理论极限。
三、心智模型与代码维护性:三重循环与代数抽象的演进
在算法实现层面,原生列表与 NumPy 体现了完全不同的抽象层级。以基础的矩阵乘法 $C = A \times B$ 为例,其中 $A$ 为 $M \times K$ 矩阵,$B$ 为 $K \times N$ 矩阵。使用原生列表时,程序员必须手动维护三重嵌套循环,关注每一个下标索引的递增与越界边界:
# 矩阵乘法原生列表实现 (需要初始化结果矩阵并维护三重循环)
def matrix_multiply_pure_python(A, B):
    rows_A = len(A)
    cols_A = len(A[0])
    rows_B = len(B)
    cols_B = len(B[0])

    # 维度一致性校验
    if cols_A != rows_B:
        raise ValueError("矩阵维度不匹配:A 的列数必须等于 B 的行数")

    # 初始化全零输出矩阵
    result = [[0.0 for _ in range(cols_B)] for _ in range(rows_A)]

    # 三重嵌套循环计算点积
    for i in range(rows_A):
        for j in range(cols_B):
            total = 0.0
            for k in range(cols_A):
                total += A[i][k] * B[k][j]
            result[i][j] = total

    return result
使用 NumPy 实现同样的逻辑,只需一行清晰的矩阵运算符:
import numpy as np

# 使用 @ 矩阵乘法运算符,或使用 np.matmul / np.dot
C = A @ B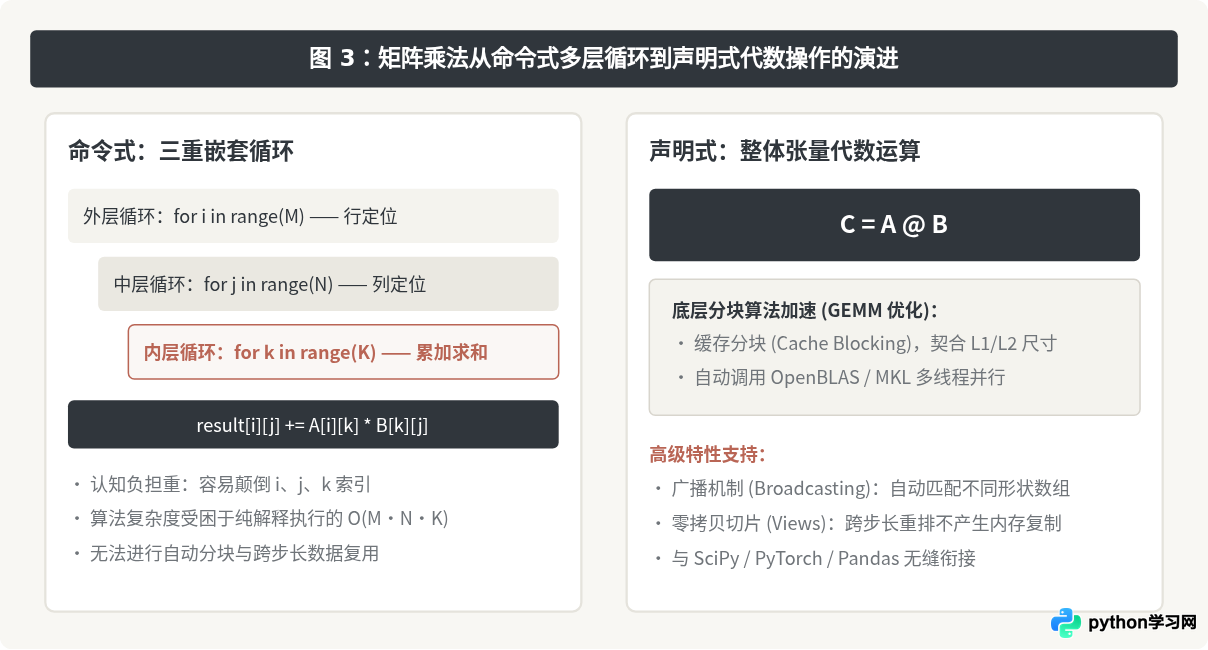
在底层,NumPy 的 @ 运算符并非简单将三层循环写进 C 语言,而是直接调用通用矩阵乘法核心子程序 GEMM(General Matrix Multiply)。现代 GEMM 库(如 Intel MKL、OpenBLAS、Apple Accelerate)针对不同架构的 CPU 做了细致到时钟周期的调优:通过矩阵分块(Tiling/Blocking)技术使计算块能够完全驻留于 L1/L2 缓存中;通过多线程让多核心同时参与运算;并且根据具体的向量寄存器位宽动态进行循环展开。这些优化在手写原生 Python 循环中几乎是不可能实现的。
四、计算性能与内存开销对照
为了直观展现两者在工程场景中的实际差距,下表列出了在常见规模的矩阵运算中,原生列表循环与 NumPy 的典型表现对比:
| 评估维度 | 原生 Python 嵌套列表 | NumPy (ndarray) | 差异根源 |
|---|---|---|---|
| 内存占用 | 大(每个浮点数 24B + 指针 8B) | 极小(纯浮点数值仅 8B) | 连续物理缓冲 vs 独立 PyObject 分配 |
| 缓存命中率 | 极低,指针寻址跳跃频繁 | 极高,内存地址连续可预取 | 局部性原理(Locality of Reference) |
| 解释器消耗 | 每一次迭代均需执行字节码 | 单次调用解析后下沉到 C 层 | CPython 求值循环瓶颈 |
| 硬件级并行 | 仅支持单线程标量执行 | 支持 SIMD 矢量化与多核多线程 | AVX2/AVX-512 与 BLAS 线程池 |
| 1000×1000 乘法耗时 | 数分钟至十几分钟(极慢) | 通常在数十毫秒以内 | 300~1000 倍以上的计算吞吐量差异 |
五、反例与适用边界:何时可以不使用 NumPy?
尽管在科学计算与数据工程中 NumPy 拥有压倒性优势,但并不意味着所有涉及数字的场景都必须引入 NumPy。了解以下边界条件有助于做出合理的工程决策:
- 极小规模且调用频繁的标量运算: 如果矩阵维度极小(例如三维图形学中的 $3 \times 3$ 变换矩阵),且计算分布在大量独立的短生命周期函数中,NumPy 将数组对象打包下沉至 C 层的函数调用开销可能反而超过原生轻量数据。对于单个三维向量的点积,使用原生
tuple或标准库math配合内联计算有时响应更快。 - 严苛的零外部依赖环境: 在某些需要保证单文件运行、不能使用任何第三方依赖包的自动化脚本、受限内嵌设备或微型运维工具中,引入 NumPy 会增加环境部署负担。此时若计算量在可承受范围内,使用原生列表是合理的妥协。
- 频繁发生动态长度变更的容器: 原生列表非常擅长动态追加(
append)与插入(insert),其底层通过倍增分配机制保证了均摊 $O(1)$ 的追加复杂度。而 NumPy 的数组尺寸是固定的,对数组执行拼接(如np.append)每次都会重新分配整块新内存并完整复制旧数据,代价极为昂贵。
六、选型决策与实践建议
在面对矩阵及数值计算任务时,可以通过以下逻辑快速完成方案选型:
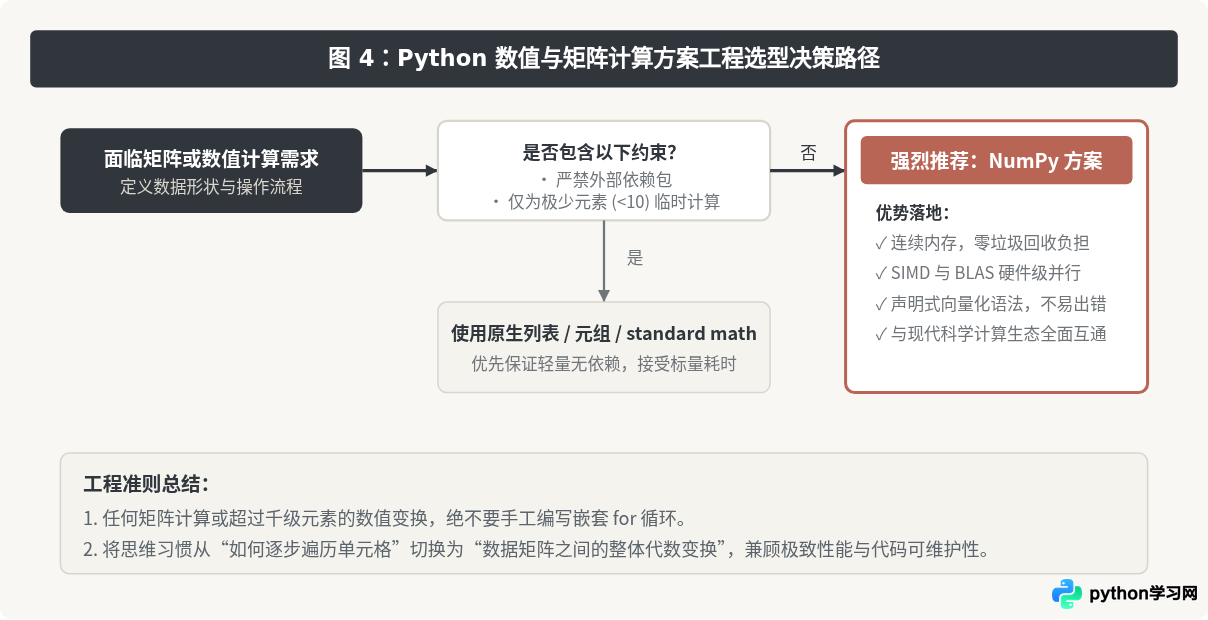
总结而言,Python 矩阵运算推荐使用 NumPy 而非原生列表循环,并非单纯的语法风格偏好,而是计算机底层物理架构决定的客观结果。NumPy 将紧凑连续的内存表示、预编译的高效向量化核心与简洁直观的代数语法结合在一起,使开发者既能享受 Python 脚本的高生产力,又能获取原生 C/Fortran 级别的硬件计算极限。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















