


Python正则匹配中文标点与全角字符的范围设定
全面解析在Python中使用正则表达式匹配中文标点符号与全角字符的Unicode码位区间设定规则,包含CJK标点、通用标点、全角ASCII变体详细对照、实战代码与避坑指南。
\w 正则均无法正确捕获。本文直接给出中文标点与全角字符的核心 Unicode 码位范围,解析各区块分布逻辑,并通过 Python 标准库 re 展示具体的匹配、清洗与全角转半角代码实现。
一、中文标点与全角字符的 Unicode 编码分布
在 Python 3 中,所有字符串(str)均为 Unicode 文本。Python 内置的 re 模块默认不支持类似 \p{Punctuation} 这种 POSIX/Unicode 属性字符类(需第三方 regex 库支持)。因此在标准库下,匹配中文标点与全角字符必须显式指定其十六进制码位范围,即通过 [\uXXXX-\uYYYY] 的形式进行定义。
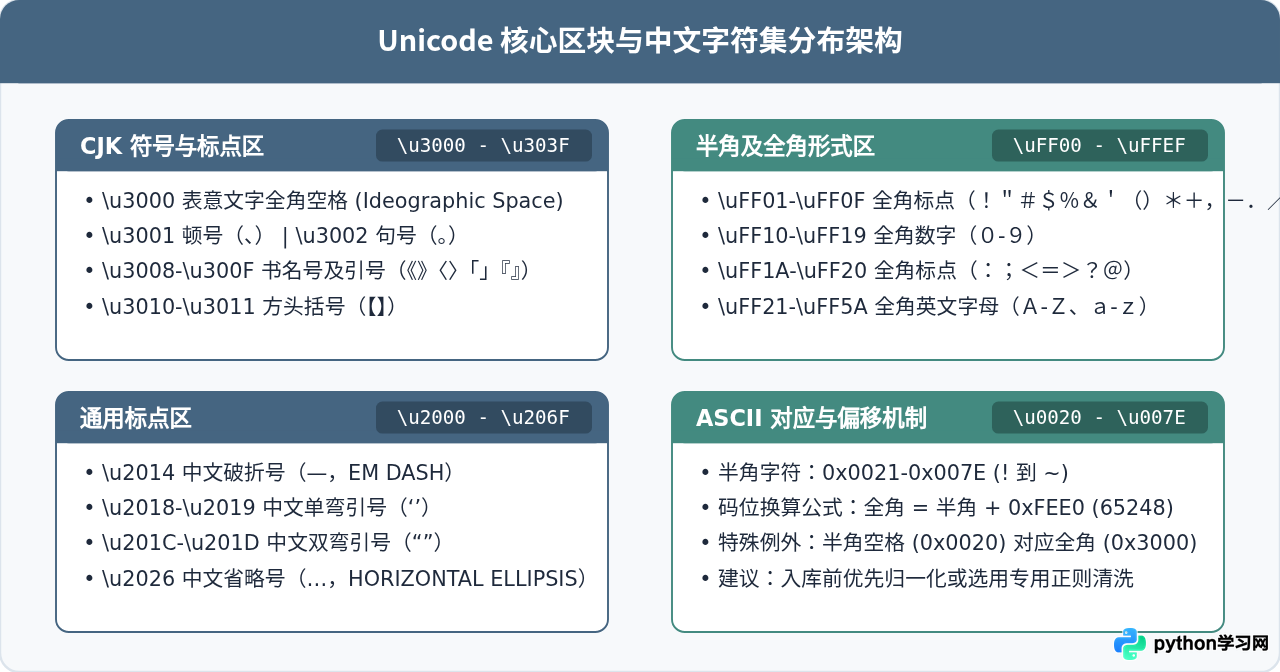
中文标点与全角字符主要跨越三个核心 Unicode 区块:
- CJK 符号和标点(CJK Symbols and Punctuation,
\u3000-\u303F):收录了中日韩共用的典型标点,如句号(。)、顿号(、)、书名号(《》〈〉)、方头括号(【】)、引号(「」『』)以及不可忽视的全角空格(\u3000)。 - 通用标点区(General Punctuation,
\u2000-\u206F):收录了中文排版中频繁使用的双引号(“”)、单引号(‘’)、中文破折号(—,EM DASH,\u2014)和中文省略号(…,HORIZONTAL ELLIPSIS,\u2026)。 - 半角及全角形式(Halfwidth and Fullwidth Forms,
\uFF00-\uFFEF):收录了 ASCII 字符的全角映射版本。常见全角逗号(,)、全角感叹号(!)、全角问号(?)、全角冒号(:)均位于\uFF01-\uFF5E之间。
二、常用字符集的 Unicode 范围设定详解
在编写正则表达式时,明确目标是“仅匹配标点”还是“匹配所有全角字符(含英数)”至关重要。两者的范围设定存在明确区别。
1. 常用中文标点符号的集合设定
中文书籍、新闻和网页中最常出现的标点符号(句号、逗号、顿号、分号、冒号、问号、感叹号、双引号、单引号、书名号、括号、省略号、破折号)分散在上述三个区域。组合后的标准匹配模式如下:
# 常用中文标点正则字符集
pattern_cn_punct = r'[\u3002\uFF0C\u3001\uFF1F\uFF01\uFF1A\uFF1B\u201C\u201D\u2018\u2019\u300A\u300B\uFF08\uFF09\u3010\u3011\u2014\u2026]'
如果希望尽可能覆盖所有可能出现的冷门中文符号(如间隔号 · \u00B7、竖排括号等),可使用连续区间简写形式:
# 宽泛中文标点字符集(包含通用标点、CJK标点及全角标点)
pattern_broad_punct = r'[\u2000-\u206F\u3000-\u303F\uFF01-\uFF0F\uFF1A-\uFF20\uFF3B-\uFF40\uFF5B-\uFF65]'
2. 全角字符(包含全角字母、数字及空格)的集合设定
全角字符是早期东亚排版系统中为使拉丁字符与汉字等宽对齐而引入的编码形式。在现代文本处理中,全角英数字往往被视为脏数据(如 2024年 或 Python)。
全角字符的标准区间定义为:
\u3000:全角空格。\uFF01-\uFF5E:全角 ASCII 变体字符集(包含全角标点、全角数字0-9、全角大写英文字母A-Z和全角小写英文字母a-z)。
组合后匹配所有全角字符的正则为:
pattern_fullwidth = r'[\u3000\uFF01-\uFF5E]'三、Python 正则操作步骤与代码实现
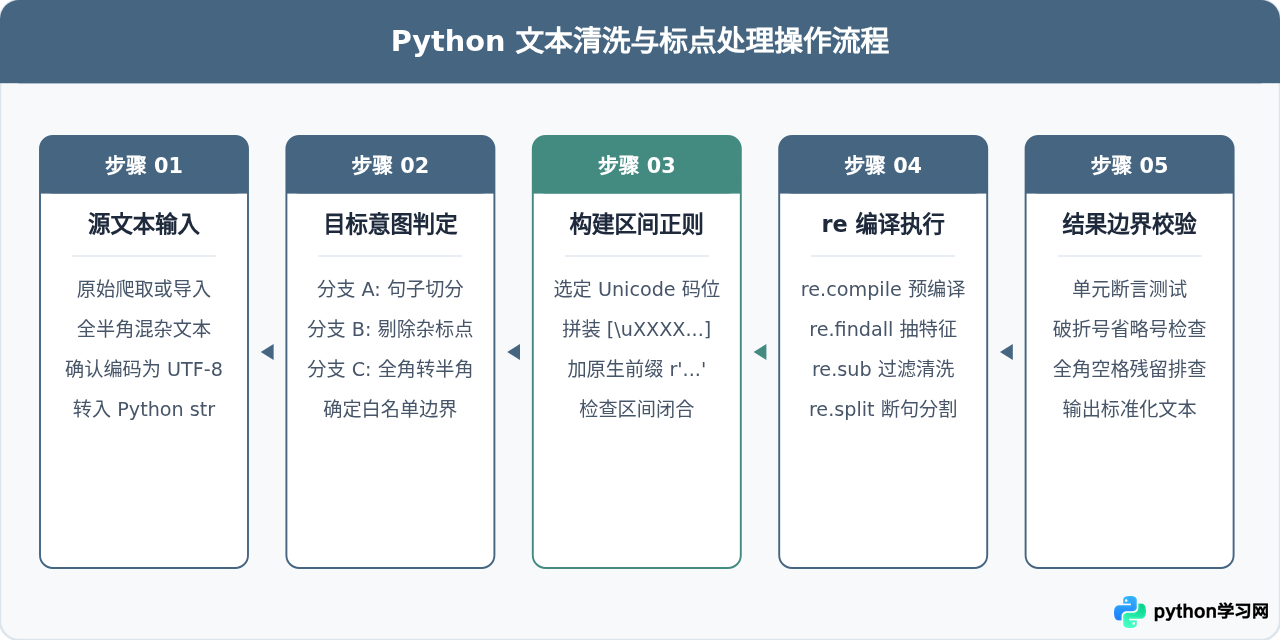
在实际业务中处理中文标点与全角字符,通常遵循“源文本输入 → 目标判定 → 范围拼装 → re 编译执行 → 结果校验”五个步骤。
1. 示例:匹配并提取文本中的所有中文标点
以下代码展示如何使用 re.findall 抽取出中文文本中包含的所有中文专有标点与全角标点:
import re

# 测试文本(包含汉字、英文字母、中文标点及全角字符)
raw_text = "Python数据清洗:注意《正则表达式》的应用!包括“引号”、破折号——以及省略号……"

# 定义包含核心中文标点的正则范围
# \u3001-\u3002: 、。
# \u3008-\u300F: 《》〈〉「」『』
# \u2014: 破折号 —
# \u2018-\u201F: 中文弯单双引号 ‘ ’ “ ”
# \u2026: 省略号 …
# \uFF01-\uFF0F, \uFF1A-\uFF20: 全角标点如 ! : 等
cn_punct_pattern = re.compile(r'[\u3001\u3002\u3008-\u300F\u2014\u2018-\u201F\u2026\uFF01\uFF0C\uFF1A\uFF1B\uFF1F]')

# 执行匹配提取
matched_puncts = cn_punct_pattern.findall(raw_text)

print("提取到的标点列表:", matched_puncts)提取到的标点列表: [':', '《', '》', '!', '“', '”', '、', '——', '……']2. 示例:过滤清洗中文标点
若目标是剔除中文文本中的所有标点符号,仅保留中英文字符与数字,可使用 re.sub:
import re

def clean_chinese_punctuation(text: str) -> str:
    # 汇总覆盖常用通用标点区、CJK标点区及全角标点区
    pattern = re.compile(r'[\u2000-\u206F\u3000-\u303F\uFF01-\uFF0F\uFF1A-\uFF20\uFF3B-\uFF40\uFF5B-\uFF65]')
    # 替换为空字符串
    return pattern.sub('', text)

sample = "【声明】欢迎加入2026团队!请阅读《使用手册》,如有疑问,请咨询:support@example.com。"
cleaned = clean_chinese_punctuation(sample)
print("清洗后结果:", cleaned)清洗后结果: 声明欢迎加入2026团队请阅读使用手册如有疑问请咨询support@example.com3. 示例:基于全角码位偏移的全角转半角函数
除了直接删除全角字符,更常见的业务需求是将全角数字、英文字母及常见标点转换为标准的 ASCII 半角字符。根据前文所述的编码偏移规律,除全角空格(0x3000 → 0x0020)外,全角字符与半角字符的码位差值恒定为 65248(即十六进制 0xFEE0)。
import re

def fullwidth_to_halfwidth(text: str) -> str:
    """
    将文本中的全角字符转换为对应的半角字符
    """
    def replace_char(match):
        code = ord(match.group(0))
        if code == 0x3000:
            return chr(0x0020)  # 全角空格转换为半角空格
        return chr(code - 0xFEE0)

    # 匹配全角空格及所有全角 ASCII 变体(!到~)
    pattern = re.compile(r'[\u3000\uFF01-\uFF5E]')
    return pattern.sub(replace_char, text)

dirty_input = "Python3.10 版本更新:支持新语法,售价¥100。"
normalized = fullwidth_to_halfwidth(dirty_input)
print("转换后结果:", normalized)转换后结果: Python3.10 版本更新:支持新语法,售价¥100.四、不同业务场景下的正则范围定制
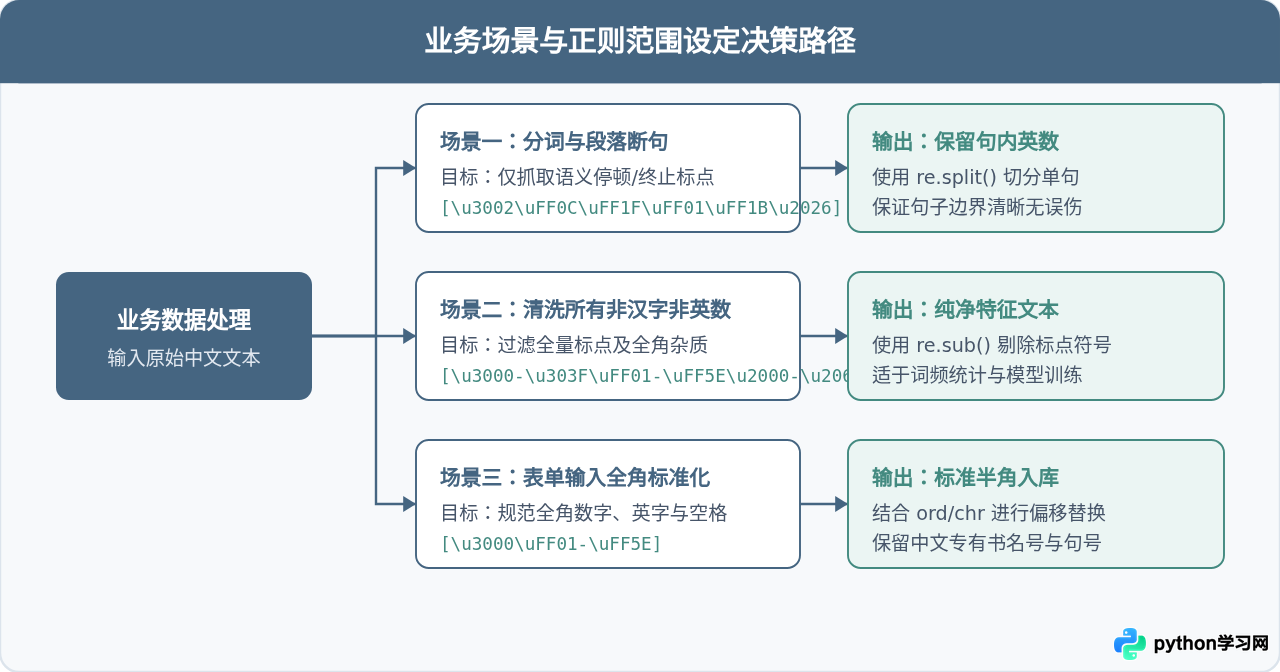
由于中文文本应用场景不同,如果盲目采用过宽或过窄的正则区间,容易产生误伤或遗漏。应当根据业务场景进行精确选型。
五、常见陷阱与注意事项
1. 全角空格(\u3000)与 \s 的重叠性
在 Python 3 中,默认的 re.ASCII 标志并未开启,因此 \s 是基于 Unicode 标准的空白字符匹配,它已经包含了 \u3000(表意文字空格)。但如果通过 re.compile(..., re.ASCII) 或类似 [^\w\s] 的逻辑剔除标点时,全角空格可能会被误当做标点清除或误保留。若要明确清洗全角空格,建议直接在正则字符集开头显式写入 \u3000。
2. 中文破折号与省略号的连续字符形态
中文标准破折号通常是两个连续的“—”,其码位为两次 \u2014(EM DASH);有时抓取的数据中会出现 \u2015(HORIZONTAL BAR)或两个西文连字符 --。同样,中文省略号标准为两次 \u2026(……),但民间排版经常使用连续六个句点 ......。如果仅匹配单个 \u2026,只能匹配规范字符;做文本清洗时若需要规范化省略号,需注意量词 [\u2026]{1,2} 或 \.{3,6} 的联合处理。
3. unicodedata.normalize 的副作用
Python 标准库提供了 unicodedata.normalize('NFKC', text),它能自动将全角字符(如 A、1、,)转换为半角(A、1、,)。但这会带来不可逆的副作用:它会将中文的方头括号 【】 转换成西文半角方括号 [],将中文顿号 、 转换成西文逗号 ,,甚至改变某些特殊符号的形态。因此,如果需要完整保留正文的中文排版风格,仅将全角数字和英文字母转为半角,严禁直接无脑套用 NFKC 归一化,应采用针对 [\uFF10-\uFF19\uFF21-\uFF3A\uFF41-\uFF5A] 的精准正则替换。
六、核心范围速查与总结
下表整理了 Python 正则匹配中文标点与全角字符最常用的范围设定速查信息:
| 分类名称 | Unicode 十六进制区间 | 代表性字符示例 | 推荐 Python 正则表达式 |
|---|---|---|---|
| CJK 专有标点 | \u3001-\u303F |
、 。 《》 「」 【】 |
r'[\u3001-\u303F]' |
| 常用通用标点 | \u2010-\u2027 |
“ ” ‘ ’ — … |
r'[\u2018-\u201F\u2014\u2026]' |
| 全角 ASCII 标点 | \uFF01-\uFF0F 等 |
, ! ? : ; () |
r'[\uFF01-\uFF0F\uFF1A-\uFF20\uFF3B-\uFF40\uFF5B-\uFF65]' |
| 全角全集(含英数空) | \u3000\uFF01-\uFF5E |
0-9 A-Z a-z 及标点 |
r'[\u3000\uFF01-\uFF5E]' |
| 全量中文标点与全角 | 组合区间 | 上述所有中文标点与全角字符 | r'[\u3000-\u303F\uFF01-\uFF5E\u2000-\u206F]' |
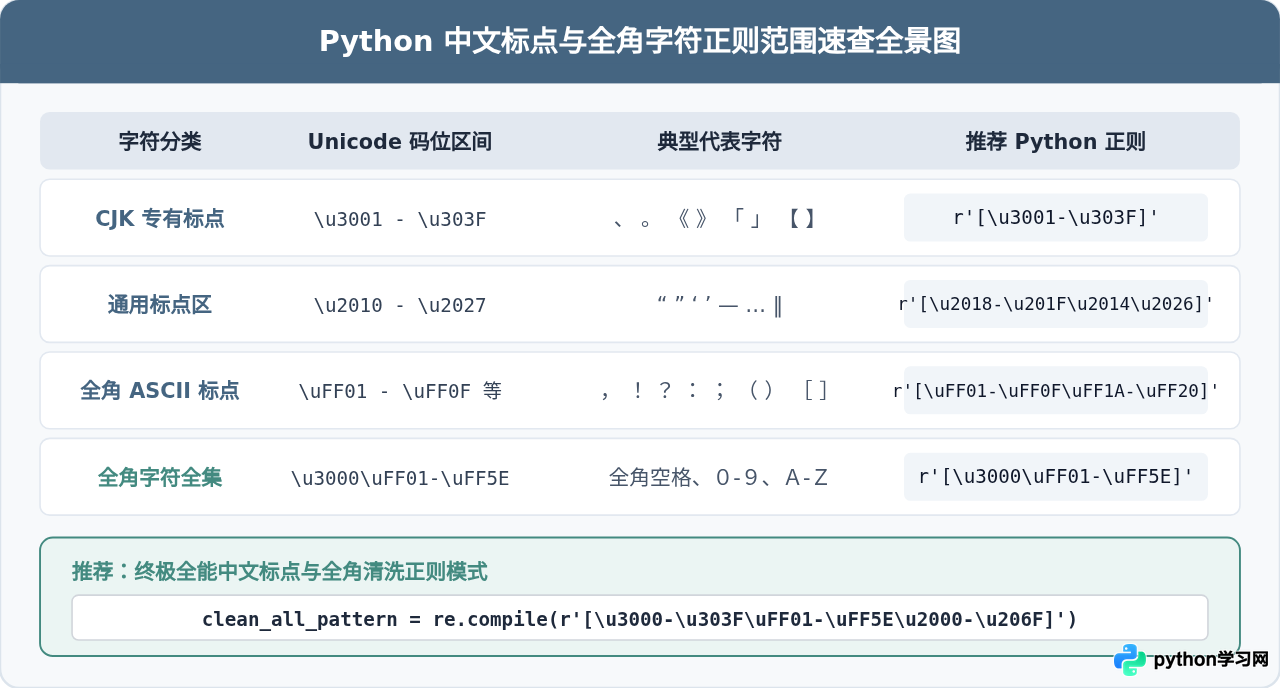
理解了 Unicode 区块的分布与编码规则后,在 Python 中设定中文标点与全角字符的范围就不再需要机械地硬编码个别字符。对于常规的分词断句,精准圈定停顿终止符能够避免破坏长句逻辑;对于抓取数据的清洗入库,结合码位偏移的全角转半角能够保证数据格式的规整统一;而对于彻底过滤非文本特征的任务,组合 [\u3000-\u303F\uFF01-\uFF5E\u2000-\u206F] 则能实现全面覆盖。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















