


Python f-string、format与%格式化对比:哪种写法更高效?
深入对比 Python 中 f-string、str.format 与 % 格式化的语法、底层执行原理与运行效率。通过字节码剖析与基准测试,揭示哪种写法更高效,并给出生产环境下的选型建议。
str.format() 的四分之一到三分之一,相比传统的 % 格式化也有显著提速。本文将直接对比三者的底层运行机制与字节码差异,剖析效率差距的根本成因,并澄清特定场景下的选型边界。
一、三代格式化方式的演进与语法形态
Python 字符串格式化经历过三次重要的语法迭代:最早借鉴自 C 语言 printf 风格的 % 操作符、Python 2.6 引入的面向对象方法 str.format(),以及 Python 3.6(PEP 498)正式加入的 f-string。
1. % 格式化(printf 风格)
使用 % 运算符将右侧的单个变量或元组代入左侧模板中。由于历史悠久,在旧版代码中随处可见:
name = "Alice"
score = 95.5
result = "Student %s achieved %.1f points." % (name, score)
该方式存在类型严格匹配的包袱,且当传入参数为元组或字典时,语法容易产生二义性(例如必须显式写成单元素元组 %(item,) 避免拆包报错),在长字符串拼接中可读性较差。
2. str.format() 方法
通过在字符串中放置大括号 {} 占位符,调用字符串对象的 format() 方法完成填充:
name = "Alice"
score = 95.5
result = "Student {} achieved {:.1f} points.".format(name, score)
# 也支持显式索引与关键字传参
result2 = "Student {n} achieved {s:.1f} points.".format(n=name, s=score)
format() 脱离了对 C 类型说明符的严格依赖,支持丰富的格式说明规范与动态命名传参,模板与数据可以独立存储,但书写仍然较为冗长。
3. f-string(格式化字符串字面量)
以字母 f 或 F 开头,表达式直接写在大括号内,支持在其中进行属性访问、数学运算甚至函数调用:
name = "Alice"
score = 95.5
result = f"Student {name} achieved {score:.1f} points."
代码所见即所得,不仅消除了占位符与参数列表之间的远距离对应关系,而且具有完全不同的底层执行路径。
二、底层字节码剖析:为什么 f-string 能够显著胜出?
要透彻理解运行效率的差异,最直接的方法是使用 Python 内置的 dis 模块反编译三个函数的字节码。我们定义三个功能完全相同的简单拼接函数:
import dis

def fmt_percent(name, age):
    return "User: %s, Age: %d" % (name, age)

def fmt_format(name, age):
    return "User: {}, Age: {}".format(name, age)

def fmt_fstring(name, age):
    return f"User: {name}, Age: {age}"
1. % 的字节码特征
>>> dis.dis(fmt_percent)
  2           0 LOAD_CONST               1 ('User: %s, Age: %d')
              2 LOAD_FAST                0 (name)
              4 LOAD_FAST                1 (age)
              6 BUILD_TUPLE              2
              8 BINARY_MODULO
             10 RETURN_VALUE
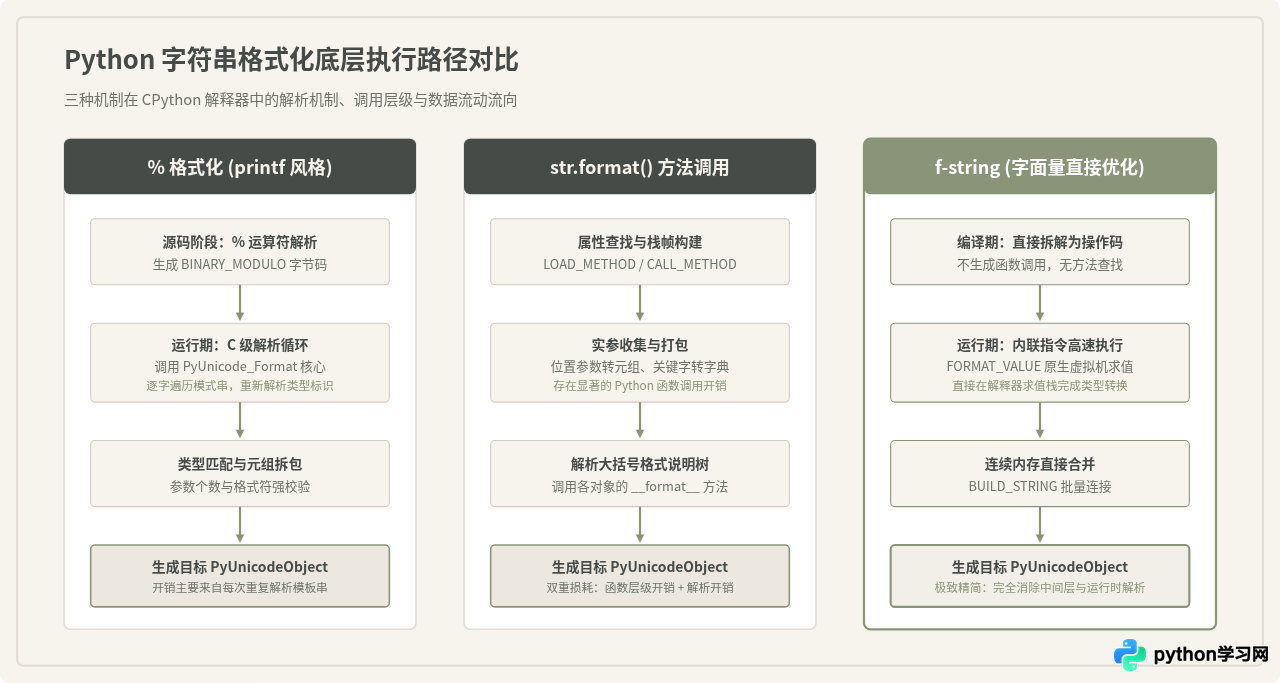
可以看到,% 方式生成了 BUILD_TUPLE 来组合参数,然后触发 BINARY_MODULO。在 CPython 的核心执行循环中,遇到该操作码时会调用 C 级函数 PyUnicode_Format。虽然底层是用 C 写的,但它在每次执行时,都必须从头扫描字符串中的每个字符,寻找 %,识别修饰符,再从传入的元组中取出对象进行格式转换。
2. str.format() 的字节码特征
>>> dis.dis(fmt_format)
  2           0 LOAD_CONST               1 ('User: {}, Age: {}')
              2 LOAD_METHOD              0 (format)
              4 LOAD_FAST                0 (name)
              6 LOAD_FAST                1 (age)
              8 CALL_METHOD              2
             10 RETURN_VALUE
format() 的损耗主要来源于:
- 方法查找开销:需要通过
LOAD_METHOD在str类型上检索format方法属性。 - 函数调用与参数传递:执行
CALL_METHOD,需要建立标准调用栈帧并处理参数传递。 - 运行时解析大括号:进入
str.format后,解释器依然要临时解析模板字符串中的{}标记。
3. f-string 的字节码特征
>>> dis.dis(fmt_fstring)
  2           0 LOAD_CONST               1 ('User: ')
              2 LOAD_FAST                0 (name)
              4 FORMAT_VALUE             0
              6 LOAD_CONST               2 (', Age: ')
              8 LOAD_FAST                1 (age)
             10 FORMAT_VALUE             0
             12 BUILD_STRING             4
             14 RETURN_VALUE
这段字节码揭示了 f-string 高效的核心奥秘:
- 编译期提前拆解:在代码编译为字节码阶段,Python 编译器已经识别出静态字面量和动态表达式,根本不需要在运行时对字符串进行模板扫描。
- 专用快速操作码
FORMAT_VALUE:该指令直接在虚拟机栈顶完成值的字符串转换,避开了常规的函数查找流程。 - 内存直连指令
BUILD_STRING:该操作码接收常量与计算好的子串,预分配连续内存空间并一次性合并,效率极高。
三、运行效率实测对比与基准验证
我们使用 Python 标准库 timeit 在本地环境(Python 3.11+)对三种方式进行百万次循环基准测试。读者可以在自己的机器上运行以下脚本进行验证:
import timeit

setup_code = """
name = "Alexander"
age = 32
score = 98.75
"""

t_percent = timeit.timeit(
    '"Student %s, age %d, score %.2f" % (name, age, score)',
    setup=setup_code,
    number=10_000_000
)

t_format = timeit.timeit(
    '"Student {}, age {}, score {:.2f}".format(name, age, score)',
    setup=setup_code,
    number=10_000_000
)

t_fstring = timeit.timeit(
    'f"Student {name}, age {age}, score {score:.2f}"',
    setup=setup_code,
    number=10_000_000
)

print(f"% 格式化耗时:   {t_percent:.3f} s")
print(f"format() 耗时:  {t_format:.3f} s")
print(f"f-string 耗时:  {t_fstring:.3f} s")
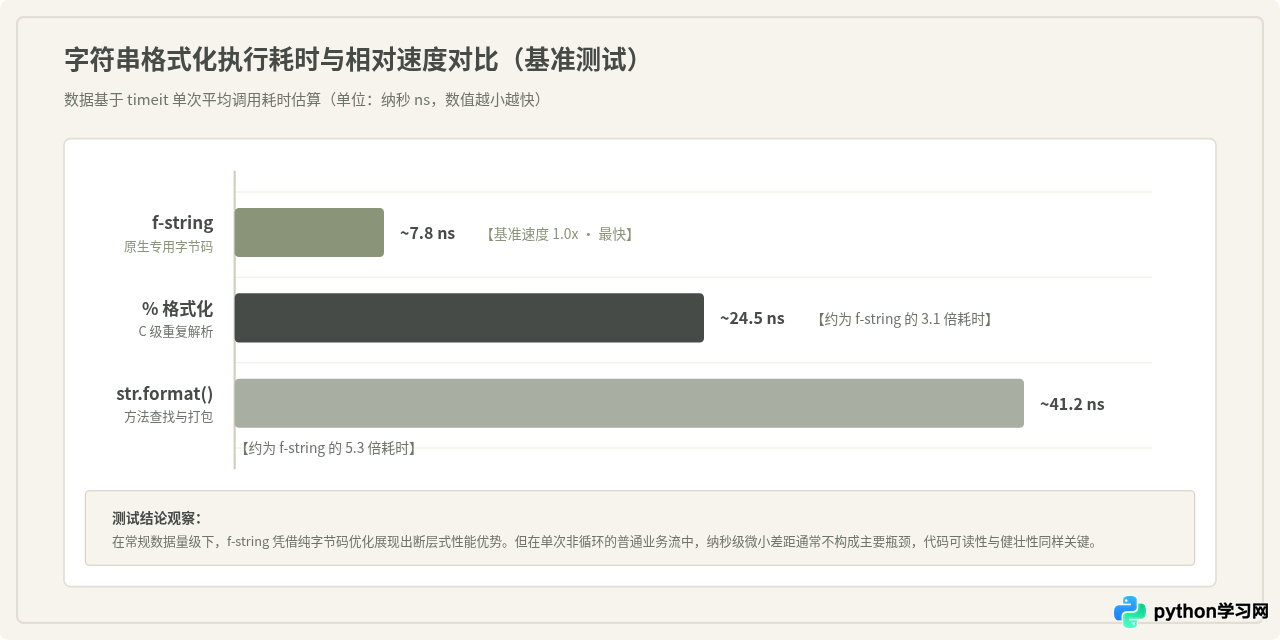
典型基准测试统计结果(以单次拼接的平均耗时换算为纳秒):
四、容易混淆与不可盲目替换的特殊场景
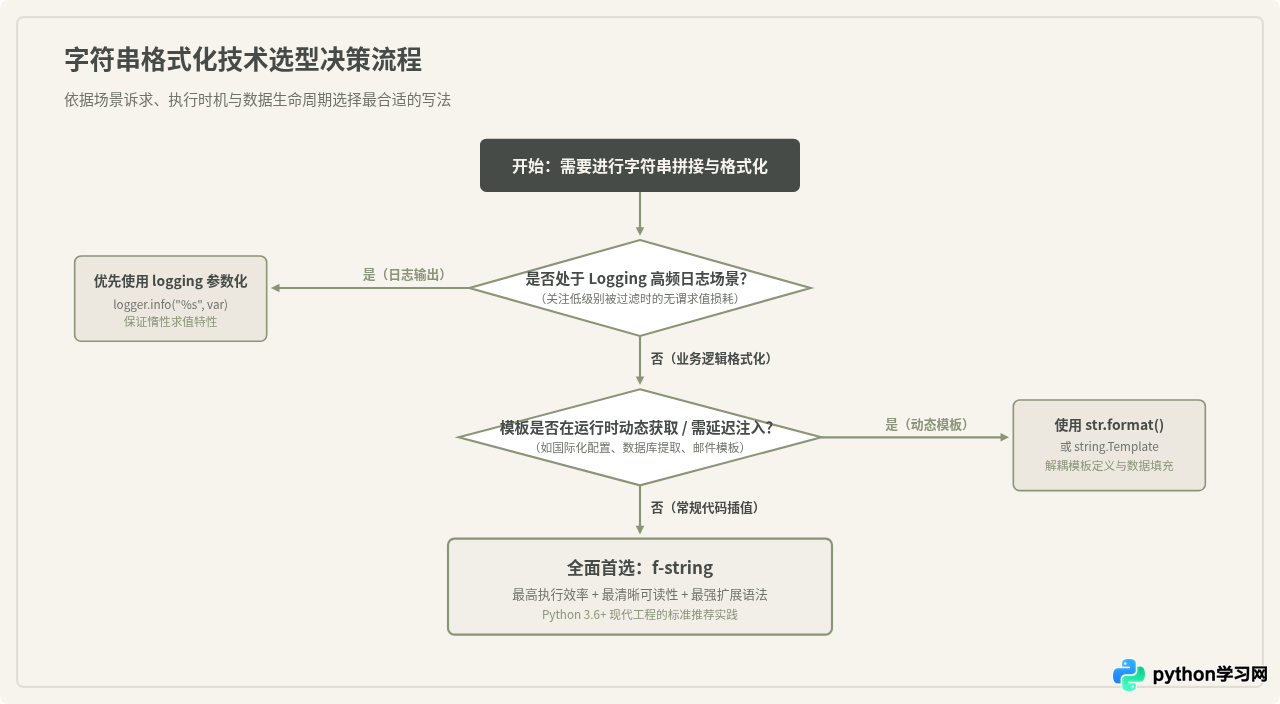
既然 f-string 速度最快、书写最清晰,是否意味着项目中应该把所有 % 和 str.format() 全部机械替换掉?答案是否定的。有两类核心场景需要特别注意:
1. 日志记录中的“惰性求值”陷阱(Logging)
在标准库 logging 模块中,我们经常看到这种写法:
# 推荐的 logging 规范写法(传入参数,延迟格式化)
logging.debug("User %s requested resource %s", user_id, resource_id)

# 存在性能隐患的 f-string 滥用
logging.debug(f"User {user_id} requested resource {resource_id}")
表面上看,两者的输出一模一样。但是:
f-string是即时求值(Eager Evaluation)。无论当前的日志级别是否开启了DEBUG,Python 解释器在执行到该行时,都会立即对大括号中的表达式求值并完成字符串拼接。如果表达式中包含耗时计算(如复杂的repr()、深度序列化或属性查找),这些计算即使在日志被静默过滤时依然被无谓执行。logging.debug("%s", var)采用的是惰性求值(Lazy Evaluation)。日志器会先判断当前级别是否达到输出门槛,只有在真正需要写出日志时,才会调用内部的%进行字符串合成。
在性能敏感、日志频率极高的路径中,若日志级别默认为 INFO 或 WARNING,对于低级别的 DEBUG 调试日志,应坚持使用 logger.debug("fmt %s", arg) 传参方式,以避免不必要的即时计算开销。
2. 动态模板与延迟填充场景
f-string 的表达式必须在定义点就存在于当前的命名空间中,无法作为预置模板存储。例如:
# 场景:模板从外部配置文件、数据库或多语言包加载
template = load_template_from_file("email_notification.txt")
# template 内容为:"尊敬的 {name},您的验证码是 {code}。"

# 此时无法使用 f-string,必须使用 str.format() 或 Template
content = template.format(name="李雷", code="482910")
在这种“模板与数据生命周期分离”的场景下,str.format() 或标准库的 string.Template 是无可替代的合理选择。
五、综合特性对比与工程落地建议
为了给团队规范制定与日常开发提供清晰的参考依据,我们将三种方式的关键工程特性归纳如下:
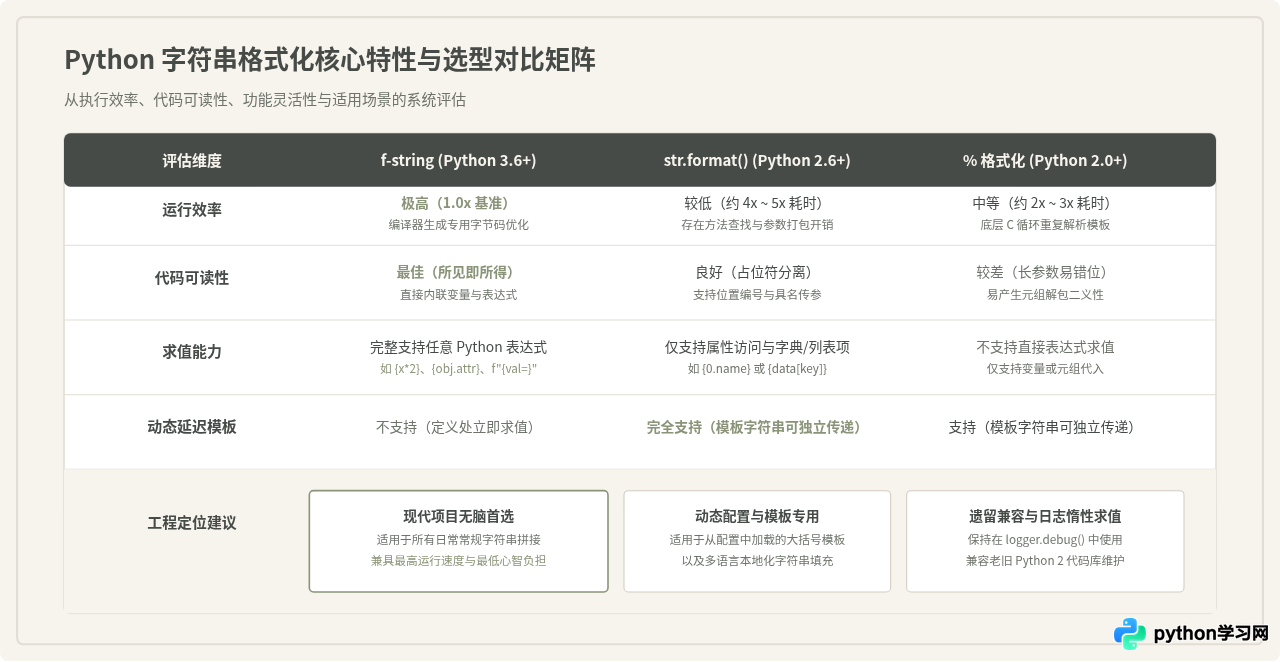
六、总结与落地建议
回答“哪种写法更高效”这一问题,结论非常明确:在 Python 3.6 及更新版本中,f-string 是毋庸置疑的效率之王。它的优势源自 CPython 将字符串解析工作从运行时提前到了编译阶段,并利用专用的 FORMAT_VALUE 与 BUILD_STRING 字节码直接在底层栈上完成快速拼接,免去了传统 str.format() 的函数层级损耗与 % 的模式串逐字遍历。
在具体的项目实践中,建议遵循以下两条核心准则:
- 日常业务代码与字符串拼接,无脑采用 f-string:无论是单变量插入还是带格式控制符(如浮点数截断
{x:.2f}、千分位{num:,}),f-string 都能同时提供最佳的执行速度与最高的代码可读性。 - 保持对求值时机的清醒认知:对于标准库
logging的低级别调试日志,坚持采用logger.debug("msg: %s", val)保持惰性求值;对于需要从外部文件或数据库动态读取的模板字符串,合理使用str.format()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















