


Python列表推导式与for循环遍历的对比及适用场景
深入对比Python列表推导式与标准for循环在执行原理、底层字节码、运行性能及编码风格上的差异,提供清晰的技术选型指南与避坑建议。
在 Python 中生成或处理列表数据时,最常见的两种语法方式是标准 for 循环遍历与列表推导式(List Comprehension)。简而言之,列表推导式是专注于“从已有可迭代对象映射、过滤出新列表”的声明式语法糖,执行速度更快且代码紧凑;而标准 for 循环则是通用且功能完整的命令式控制流结构,具备完整的流程控制、异常处理和调试灵活性。理解两者的底层执行原理与设计定位,能够帮助我们在编写代码时既保持可读性,又获得出色的执行效率。
一、底层原理与执行机制差异
很多开发者会直观地认为列表推导式只是 for 循环加上 list.append() 的语法缩写。然而在 Python 底层(以 CPython 为例),两者的字节码生成机制和运行时开销存在本质区别。
在标准 for 循环中,每次往列表中追加元素都需要执行 append() 方法。这涉及两个额外开销:第一,每次循环迭代都必须在全局或局部命名空间查找 append 属性;第二,调用 append() 会产生 Python 函数调用的压栈与出栈开销。而在列表推导式中,解释器在编译期就会识别出构建列表的意图,并在虚拟机内部直接使用专用的字节码指令 LIST_APPEND。该指令直接在 C 语言层面对内存中的列表对象进行操作,完全跳过了 Python 解释层面的方法查找与函数调用开销。
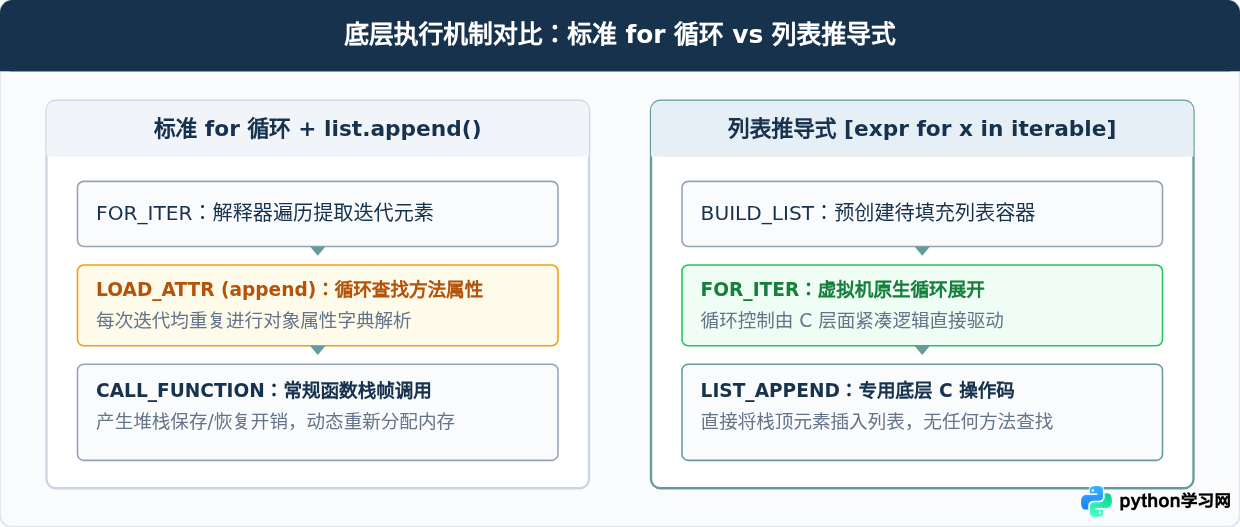
通过 Python 内置的 dis 模块可以清晰验证两者的字节码差异。以下是两者的反编译代码片段:
import dis

def loop_append(data):
    res = []
    for x in data:
        res.append(x * 2)
    return res

def list_comp(data):
    return [x * 2 for x in data]

print("=== for 循环字节码 ===")
dis.dis(loop_append)
print("\n=== 列表推导式字节码 ===")
dis.dis(list_comp)
在 loop_append 的反编译指令中,可以看到每一轮迭代都会出现 LOAD_METHOD (append) 与 CALL_METHOD;而在 list_comp 中,核心操作直接变成了单一的 LIST_APPEND 指令。这种执行机制的精简正是列表推导式速度更快的关键原因。
二、语法映射与推导演进
对于刚从其他命令式语言转入 Python 的开发者,往往更习惯于编写 for 循环。实际上,列表推导式的语法结构是标准 for 循环逻辑的高密度重组。
一个包含过滤条件的常规构建逻辑由四部分组成:定义结果列表容器、迭代循环头部、if 条件分支以及最终的计算赋值。列表推导式将这四个要素压缩进一对中括号 [...] 中,将关注点从“如何一步步追加”转移到了“生成什么样的结果”。
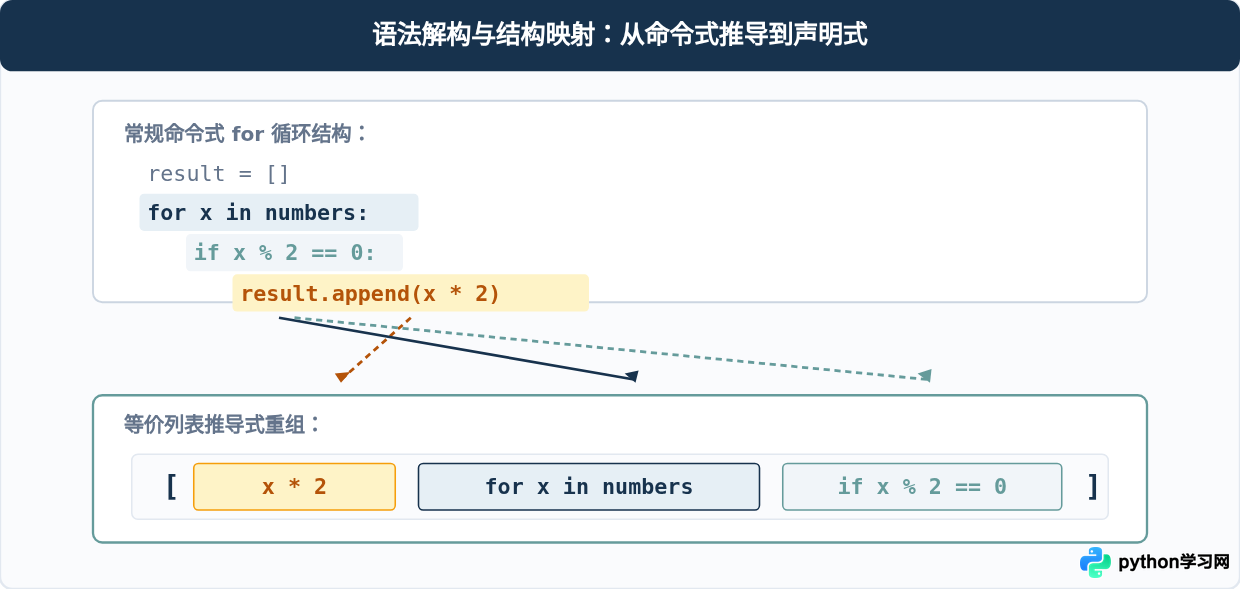
可以看到,推导式的排列次序体现了明确的数据流向:先声明期望输出的计算表达式,再指定数据来源与遍历变量,最后附带可选的过滤判定。这种语法不仅省去了多行缩进和空列表的初始化,更使代码读者能第一眼看到计算目标。
三、技术选型决策与适用场景分析
虽然列表推导式性能出色且语法优雅,但绝不意味着它应当无条件取代 for 循环。Python 强调代码的“可读性优先(Readability Counts)”。盲目使用推导式不仅会导致代码晦涩,还会带来难以排查的维护隐患。
1. 列表推导式的黄金适用场景
- 一对一元素转换(Mapping):例如将字符串数组统一转为小写、将对象属性提取为纯数值列表等。
- 基于条件的简单过滤(Filtering):去除列表中不合规的
None值、过滤奇数或保留满足特定业务前缀的项。 - 轻量级嵌套解平(Flattening):单层嵌套展开二维矩阵(如将两层数组铺平成一维)。
# 场景示例 1:纯数据映射清洗
raw_users = [" Alice ", "Bob", "  CHARLIE\n", "david"]
cleaned_users = [user.strip().lower() for user in raw_users]
# 输出: ['alice', 'bob', 'charlie', 'david']

# 场景示例 2:数据提取与过滤组合
products = [
    {"name": "笔记本", "price": 5999, "active": True},
    {"name": "鼠标", "price": 99, "active": False},
    {"name": "机械键盘", "price": 499, "active": True}
]
active_names = [p["name"] for p in products if p["active"]]
# 输出: ['笔记本', '机械键盘']
2. 必须坚守标准 for 循环的场景
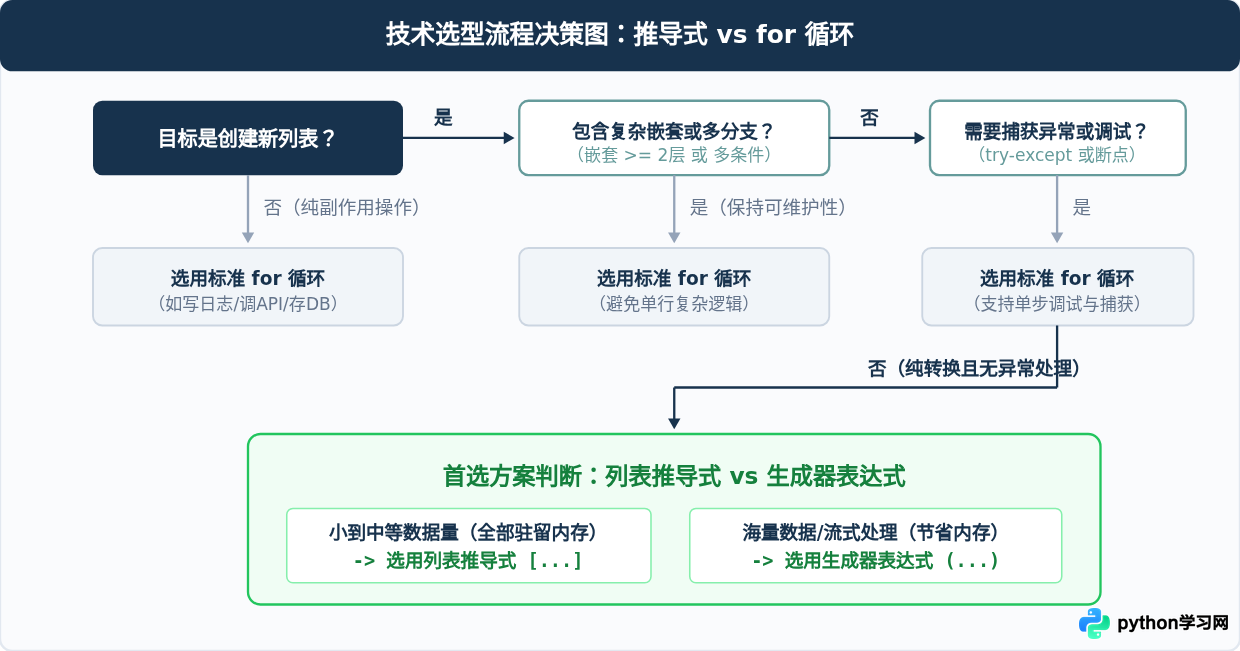
- 具有明显副作用(Side Effects)的操作:例如向数据库写入记录、发送网络请求、写入本地文件或调用控制台打印。推导式设计初衷是“构建容器”,利用推导式遍历并产生副作用是典型的反模式。
- 需要进行复杂的异常处理(try-except):推导式内部无法直接编写
try...except语句块。如果迭代过程中可能抛出异常且必须局部捕获容错,必须采用for循环。 - 单步断点调试(Debugging)与复杂日志记录:推导式在调试器中通常被视作单行原子语句,无法逐个变量观察中间状态,也不方便在每步插入追踪日志。
- 超过两层的深层嵌套循环或包含多重分支:三层以上的推导式会形成难以理解的“单行怪兽”,极大增加后续维护人员的心智负担。
四、性能实测与基准对比
为了直观评估两者的实际速度差异,我们可以通过 Python 内置的 timeit 模块在相同的运行环境下进行基准测试。以下测试分别对比了三种常见场景:纯数字倍增、条件过滤以及带属性查找的复杂操作。
import timeit

setup_code = "data = list(range(100_000))"

# 1. 常规 for 循环 + append
for_loop_code = """
result = []
for x in data:
    result.append(x * 2)
"""

# 2. 列表推导式
list_comp_code = """
result = [x * 2 for x in data]
"""

# 3. 针对 for 循环的局部方法绑定微优化
optimized_for_code = """
result = []
append_fn = result.append
for x in data:
    append_fn(x * 2)
"""

t_loop = timeit.timeit(for_loop_code, setup=setup_code, number=100)
t_comp = timeit.timeit(list_comp_code, setup=setup_code, number=100)
t_opt = timeit.timeit(optimized_for_code, setup=setup_code, number=100)

print(f"标准 for 循环耗时:   {t_loop:.4f} 秒")
print(f"局部优化 for 耗时:   {t_opt:.4f} 秒")
print(f"列表推导式耗时:       {t_comp:.4f} 秒")
在典型的 Python 3.10+ 运行环境下,100 次十万级数据运算的典型基准表现如下:
| 实现方式 | 测试耗时(秒) | 相对耗时比率 | 核心影响机制 |
|---|---|---|---|
标准 for 循环 + append |
约 0.62s | 1.0x(基准) | 每轮迭代进行属性查找和函数栈调用 |
局部变量优化 append_fn |
约 0.48s | 约 0.77x(提升 23%) | 消除了 LOAD_ATTR,但保留了函数调用 |
| 列表推导式 | 约 0.38s | 约 0.61x(提升 39%) | 底层 C 原生 LIST_APPEND 指令执行 |
测试结果印证了前述的机制分析:即便利弊权衡下对 for 循环进行了局部属性绑定的微优化,列表推导式依然凭借 C 语言层的紧凑指令保持着 30% 到 40% 的速度优势。
五、常见陷阱与避坑指南
在实际项目开发中,开发者容易走向两个极端:要么对推导式产生排斥,处处手写繁琐的 for 循环;要么过度崇拜单行表达,写出难以理解和维护的缺陷代码。
1. 误区一:把推导式当成无返回值的遍历语句
以下代码虽然能够正常运行,但严重违反了 Python 社区的设计哲学:
# 错误示例:仅为了副作用而使用推导式
[print(user.name) for user in user_list]
[db_session.save(record) for record in records]
上述写法会在内存中临时构建一个全部由 None 组成的冗余列表,消耗额外内存并在垃圾回收时带来无谓负担。对于此类仅需产生副作用的操作,应坚决使用标准 for 循环:
# 正确示例:清晰表明副作用意图
for user in user_list:
    print(user.name)

for record in records:
    db_session.save(record)
2. 误区二:无节制的多层嵌套推导
推导式允许书写多重 for 和复杂的条件分支,但这往往是代码可读性的灾难:
# 晦涩示例:多层嵌套与条件夹杂
result = [x * y for x in matrix if len(x) > 2 for y in x if y % 2 == 0 and y > 10]

# 推荐写法:退回标准嵌套 for 循环,逻辑层次清晰
result = []
for row in matrix:
    if len(row) > 2:
        for y in row:
            if y % 2 == 0 and y > 10:
                result.append(y * row[0])
3. 作用域泄露的历史演进说明
在老旧的 Python 2 时代,列表推导式中的循环变量(如 [x for x in data] 中的 x)会泄露到外部作用域,甚至意外覆盖同名的外部变量。自 Python 3 起,列表推导式拥有了独立的局部作用域(类似隐式函数闭包),推导式内部的迭代变量不会再对外部同名变量造成污染,这一历史隐患已在现代 Python 中被彻底修复。
六、全维度对比总结
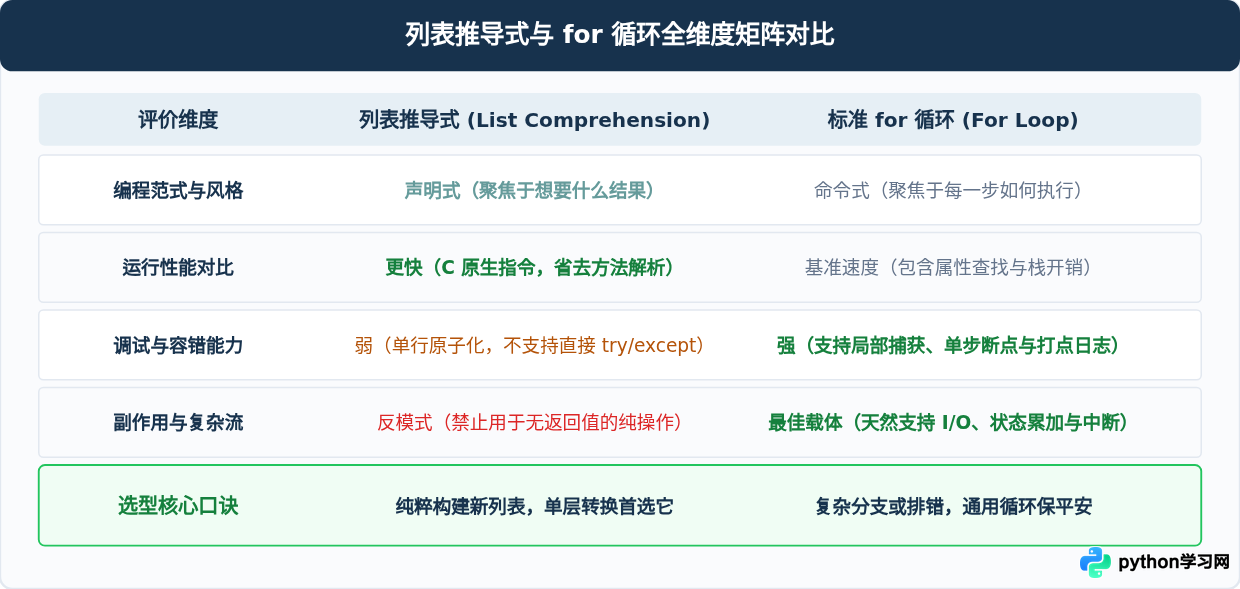
为了帮助大家在日常代码审查与技术选型中快速决断,下表从语法、性能、内存、调试等多维度整理了两者的核心区别:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















