


Python翻译库推荐:googletrans与deep-translator等主流方案对比
全面对比Python主流文本翻译方案,深入分析googletrans、deep-translator、translate以及本地离线Argos Translate的实现机制、使用步骤、接口稳定性与选型策略。
在开发多语言数据清洗、国际化文本自动化以及爬虫内容解析等任务时,Python开发者常常需要集成文本翻译能力。实现翻译的路径主要分为两类:一类是通过免密爬虫或Web接口逆向封装的免费库,另一类是聚合主流翻译API并提供规范调用的中间层SDK。本文针对目前主流的Python翻译方案——googletrans、deep-translator、translate以及本地离线引擎Argos Translate进行全面对比,拆解它们的底层机制、调用方法、稳定性表现与典型场景选型。
一、核心选型快速结论
为了让不同诉求的项目能够快速锁定合适组件,可以根据以下几条明确的场景标准进行判断:
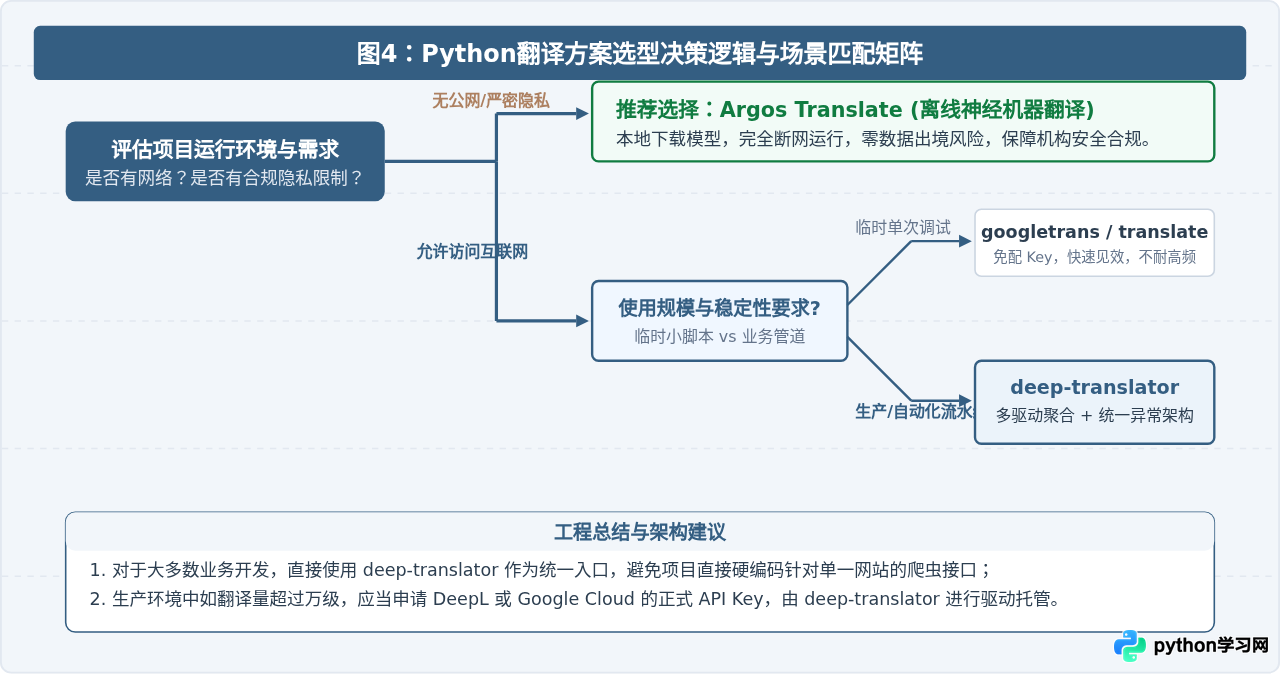
- 首选综合方案(deep-translator):如果需要高扩展性、支持多个商业引擎(Google、DeepL、MyMemory、Linguee等)统一调用,且需要灵活应对某单一服务断联,首选 deep-translator。它代码健壮且处于活跃维护状态。
- 简易轻量脚本(googletrans):如果是个人本地单次快速翻译短文本,不要求长期自动化稳定性,googletrans 使用门槛最低。但因其依赖 Google 网页端非公开接口,遇到高频调用时极易被限流封禁(403 或 429 报错)。
- 传统简单任务(translate):适合简单单词或简短语句转换,支持配置 Provider,但功能扩展度不如 deep-translator 丰富。
- 内网隔离与隐私合规(Argos Translate):如果运行环境完全处于内网无外网访问权限,或者文本涉及企业数据隐私禁止上传云端,基于 OpenNMT 的开源离线翻译库 Argos Translate 是目前最佳选择。
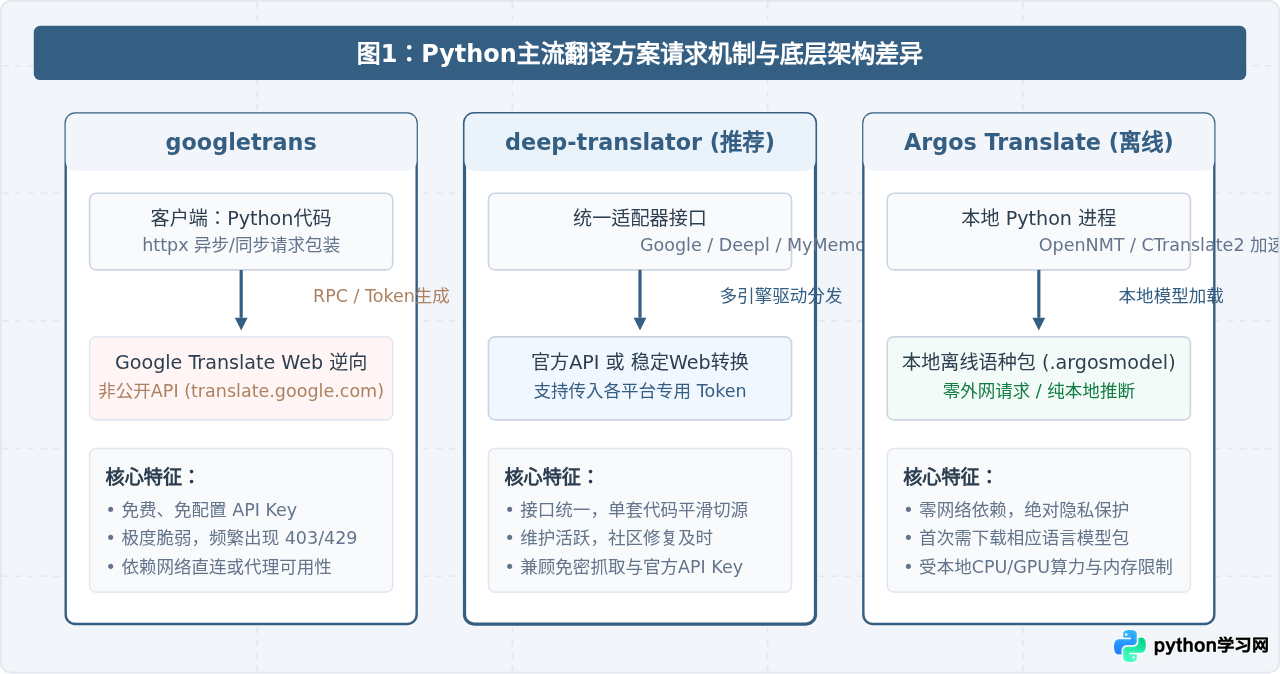
二、主流方案深入解析与实战代码
1. googletrans:简单上手与现实瓶颈
googletrans 是早期流传最广的非官方 Google 翻译库。它通过模拟浏览器向 Google 翻译网页端发送请求,解析回传数据。这种机制的最大好处在于无需注册任何 Google Cloud 账号,也不用支付 API 费用。
安装注意:目前 PyPI 上的正式版本 googletrans 3.0.0 已经无法正常工作,必须安装 4.0.0-rc1 或更新版本:
# 必须指定安装预发布版本
pip install googletrans==4.0.0rc1
基础调用示例:
from googletrans import Translator

# 实例化翻译对象
translator = Translator()

# 同步调用翻译:将中文翻译为英文
result = translator.translate('自动化测试流程已启动', src='zh-cn', dest='en')

print(f"原文本: {result.origin}")
print(f"翻译结果: {result.text}")
print(f"识别语言: {result.src}")1. 网络可达性:国内环境在没有正确配置代理的情况下,默认无法连接 translate.google.com,会直接引发连接超时报错。
2. 服务封锁(429 Too Many Requests):Google 针对未授权的 Web 端高频访问部署了严格的速率限制与反机器人机制。只要循环请求超过数十次,就极易被封锁 IP,因此绝对不能直接用于线上批量业务。
2. deep-translator:模块化与多引擎聚合框架
deep-translator 是目前 Python 生态中最具工程价值的翻译库。它的设计理念不是绑定某一个翻译提供商,而是抽象出一套标准化的 Translator 接口,内部实现了对 Google Translate、DeepL、MyMemory、Pons、Linguee、LibreTranslate、Baidu、Qcri 等数十种底层翻译服务的桥接。
# 安装 deep-translator
pip install deep-translator
其最大亮点在于:不仅支持免密模式,还同时支持各大平台的正式商业 API(只要填入 API Key 即可)。当其中一个服务出现故障时,业务层只需改动极小配置就能切换到备选通道。
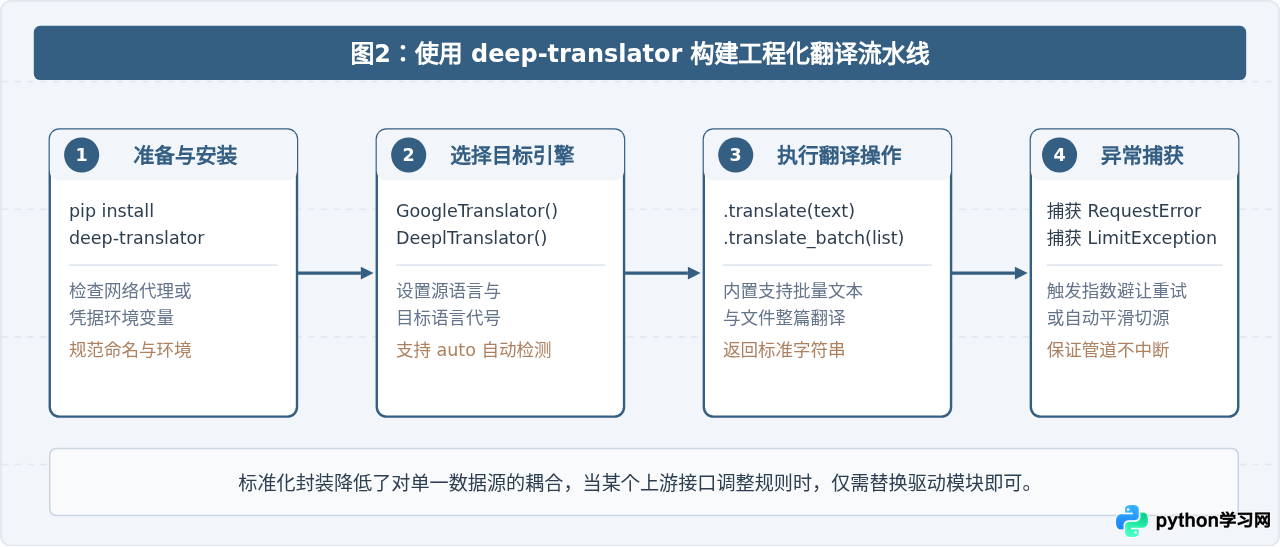
实战代码 1:调用 Google 免密引擎与批量翻译
from deep_translator import GoogleTranslator

# 单文本翻译:指定源语言为中文,目标语言为英文
translator = GoogleTranslator(source='zh-CN', target='en')
translated_text = translator.translate('数据库连接超时,正在尝试重新连接')
print("翻译结果:", translated_text)

# 批量列表翻译:高效处理多段文本
texts = [
    '用户权限校验失败',
    '系统进入维护模式',
    '数据同步完成'
]
batch_results = translator.translate_batch(texts)
for origin, trans in zip(texts, batch_results):
    print(f"[{origin}] -> [{trans}]")
实战代码 2:切换为 DeepL 引擎(高质量商务/专业语料)
from deep_translator import DeeplTranslator

# 通过 API Key 使用 DeepL 官方接口,保证高可靠性与翻译质量
# 注意:DeepL 分为 Free API 和 Pro API,需根据注册类型填入参数
deepl_engine = DeeplTranslator(api_key="your_deepl_api_key", source="zh", target="en", use_free_api=True)
res = deepl_engine.translate("本协议自双方签字盖章之日起生效。")
print("DeepL 翻译:", res)
3. Argos Translate:完全离线的神经机器翻译
在涉及敏感业务数据、医疗健康、金融机密或纯粹内网服务器(无法访问公网)时,任何基于云端和网页的翻译库均不适用。此时可以使用 argos-translate。
# 安装 Argos Translate
pip install argos-translate
离线安装语言包与本地翻译代码:
import argostranslate.package
import argostranslate.translate

# 1. 下载并安装模型包(可预先下载好模型文件并在离线环境直接通过 package.install_from_path 安装)
argostranslate.package.update_package_index()
available_packages = argostranslate.package.get_available_packages()

# 筛选中文到英文的离线翻译包
zh_en_package = next(
    filter(lambda x: x.from_code == "zh" and x.to_code == "en", available_packages)
)
argostranslate.package.install_from_path(zh_en_package.download())

# 2. 获取已安装的翻译实例
installed_languages = argostranslate.translate.get_installed_languages()
from_lang = list(filter(lambda x: x.code == "zh", installed_languages))[0]
to_lang = list(filter(lambda x: x.code == "en", installed_languages))[0]
translation = from_lang.get_translation(to_lang)

# 3. 本地执行推断
output = translation.translate("本地离线推理不依赖任何外部网络。")
print("离线翻译输出:", output)
三、生产环境稳定性与容错架构
许多开发者在开发环境中运行免密翻译库(如 googletrans 或 deep-translator 的 Google 模块)感觉流畅,但一旦上线处理数万条数据,就会在几分钟内收到大量 HTTP 429 Too Many Requests 或 ReadTimeout 异常。要在生产场景稳定使用免密/低成本翻译,必须建立健壮的重试与降级机制。
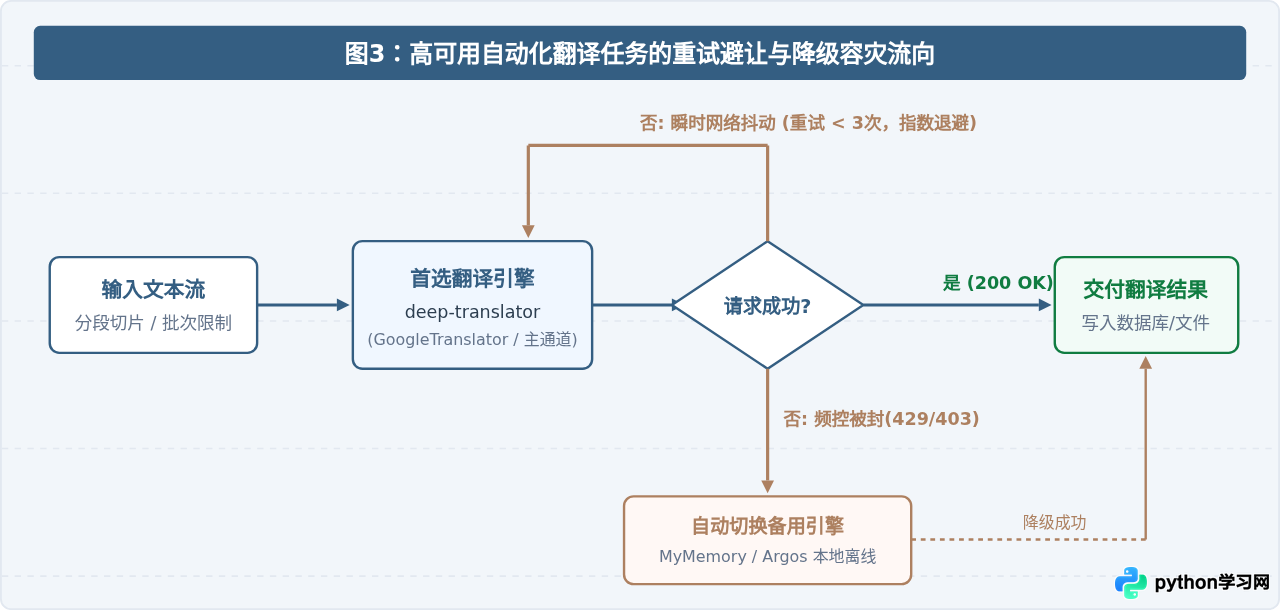
高可靠翻译适配器实现代码:
import time
from deep_translator import GoogleTranslator, MyMemoryTranslator
from deep_translator.exceptions import RequestError, TooManyRequests

class RobustTranslator:
    def __init__(self, source='zh-CN', target='en'):
        self.source = source
        self.target = target
        # 主引擎:Google Translator
        self.primary = GoogleTranslator(source=self.source, target=self.target)
        # 降级备用引擎:MyMemory
        self.fallback = MyMemoryTranslator(source=self.source, target=self.target)

    def translate_with_retry(self, text: str, max_retries: int = 3) -> str:
        # 第一阶段:尝试主引擎并施加指数退避
        for attempt in range(max_retries):
            try:
                # 间隔 0.3 秒,避免突发速率过高
                time.sleep(0.3)
                return self.primary.translate(text)
            except (RequestError, TooManyRequests) as e:
                wait_time = (2 ** attempt)
                print(f"[警告] 主引擎第 {attempt + 1} 次请求失败: {e},将在 {wait_time} 秒后重试...")
                time.sleep(wait_time)
            except Exception as e:
                print(f"[未知异常] {e}")
                break

        # 第二阶段:主引擎失效,无缝降级到备用引擎
        print("[降级] 主引擎多次尝试失败或被封禁,正在切换至备用引擎 MyMemory...")
        try:
            return self.fallback.translate(text)
        except Exception as e:
            print(f"[严重错误] 所有翻译引擎均失败: {e}")
            return text  # 返回原文本避免流程中断

# 执行测试
translator = RobustTranslator()
content = "分布式任务队列已启动"
result = translator.translate_with_retry(content)
print("安全翻译输出:", result)
四、主流方案综合多维对比与决策树
以下将当前 Python 开发者最常用的方案在多个关键工程维度上进行横向比较:
| 方案名称 | 底层实现原理 | API Key 依赖 | 生产稳定性 | 多引擎扩展 | 离线环境支持 | 适用业务场景 |
|---|---|---|---|---|---|---|
| deep-translator | 多后端适配器框架 | 可选 (支持免密及各家 Key) | 高 (支持多源切换) | 极佳 (支持 10+ 引擎) | 部分 (通过 LibreTranslate) | 生产项目首选、大批量数据管道 |
| googletrans | 爬取 Web 端非公开接口 | 无需 Key | 极低 (频繁遭遇 429 封禁) | 无 (仅限 Google) | 不支持 | 个人学习、本地单次调试短脚本 |
| translate | 标准封装包 | 可选 | 中等 | 一般 (仅少数 Provider) | 不支持 | 轻量翻译小工具 |
| Argos Translate | 本地 OpenNMT 深度学习模型 | 无需 Key | 极高 (完全掌控在本地) | 基于本地预下载模型 | 原生完全支持 | 内网合规、医疗/金融等数据隐私严控场景 |
五、总结
在 Python 文本翻译库的实际选型中,googletrans 和 deep-translator 代表了两种完全不同的工程思路:前者偏向快速便捷的单点逆向脚本,后者则是面向多服务提供商的标准化聚合门面。对于大多数具备网络条件的自动化任务,采用 deep-translator 配合指数退避与备用源切换是兼顾灵活性与稳定性的最优方案;而在对数据安全有极高要求的内网或本地嵌入式环境,结合 Argos Translate 进行离线推理则是最扎实的兜底手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















