掌握 Python 并不在于死记硬背枯燥的语法手册,而在于把高频使用的语法糖、控制流与四大核心数据结构(列表、元组、字典、集合)的代码原型转化为肌肉记忆。本文紧扣核心业务开发与日常脚本编写中最为关键的 100 个典型代码片段,以“代码原型 + 运行输出 + 原理解释 + 避坑要点”的实用结构组织,助你在面对复杂任务时快速做出最优的结构选型与语法表达。
一、基础语法与变量操作核心示例(001 - 020)
Python 采用动态类型和引用传递机制。基础语法层面的核心在于理解变量的绑定本质、字符串现代格式化(f-string)、数值运算中的边界效应以及严谨的真假值裁决逻辑。
多重变量声明与解包赋值
示例 001
x, y, z = 10, "Python", [1, 2]
a = b = c = 0
[运行示例输出] x: 10, y: 'Python', z: [1, 2], a: 0, b: 0, c: 0
支持一行同时解包赋值多个不同类型的变量,也可使用链式赋值将同一初始值赋予多个变量(注意:若初始值为可变对象,链式赋值会导致变量指向同一内存)。
\n
变量值原地交换 (无中间临时变量)
示例 002
a, b = "apple", "banana"
a, b = b, a
[运行示例输出] a: 'banana', b: 'apple'
利用元组打包与解包机制(Tuple Packing & Unpacking),先在右侧构建临时元组 `(b, a)` 再解包给左侧变量,无需声明第三方临时变量 `temp`。
\n
严格类型检查:type 与 isinstance 边界
示例 003
val = True
is_bool = isinstance(val, bool)
is_int_strict = type(val) is int
is_int_instance = isinstance(val, int)
[运行示例输出] is_bool: True, is_int_strict: False, is_int_instance: True
在 Python 中 `bool` 是 `int` 的子类。若需允许子类多态,应优先使用 `isinstance()`;若需排他性地限制必须为具体类型本身,使用 `type(x) is T`。
\n
整除、取模与负数商数陷阱
示例 004
q1, r1 = 7 // 3, 7 % 3
q2, r2 = -7 // 3, -7 % 3
[运行示例输出] q1: 2, r1: 1, q2: -3, r2: 2
Python 的整除采用“向下取整”(Floor Division)而非向零截断,负数除法满足公式 `a = (a // b) * b + (a % b)`,余数始终与除数同号。
\n
高精度除法与 divmod 原子操作
示例 005
total_seconds = 3665
minutes, seconds = divmod(total_seconds, 60)
hours, minutes = divmod(minutes, 60)
[运行示例输出] hours: 1, minutes: 1, seconds: 5
`divmod(a, b)` 同时返回商和余数 `(a // b, a % b)`,单次 C 层面计算完成,效率高于分别计算 `//` 与 `%`,适合时间换算、分页计算。
\n
浮点数精度误差与 Decimal 安全计算
示例 006
from decimal import Decimal
diff_float = (0.1 + 0.2) == 0.3
diff_decimal = (Decimal('0.1') + Decimal('0.2')) == Decimal('0.3')
[运行示例输出] diff_float: False, diff_decimal: True
标准 IEEE 754 浮点数无法精准表示十进制分数 0.1。在金融、计费等强确定性业务中,必须传入字符串构建 `Decimal` 实例进行绝对精准运算。
\n
布尔真值性 (Falsy) 规则判断
示例 007
falsy_items = [False, None, 0, 0.0, "", [], (), {}, set()]
truth_results = [bool(item) for item in falsy_items]
[运行示例输出] truth_results: [False, False, False, False, False, False, False, False, False]
Python 规定空容器、数值零、None 及 False 在条件判断中均被隐式视为 `False`。判定列表是否为空时,推荐直接 `if not lst:`,而非 `if len(lst) == 0:`。
\n
逻辑运算符短路求值与默认值兜底
示例 008
user_input = ""
clean_name = user_input or "Default Guest"
valid_score = (100 >= 60) and "Pass"
[运行示例输出] clean_name: 'Default Guest', valid_score: 'Pass'
`or` 在遇到首个真值时立即返回该操作数并终止后续计算;`and` 遇到首个假值时立即返回假值,若全为真则返回最后一个操作数。可用于简洁的缺省回退。
\n
条件三元表达式规范书写
示例 009
status_code = 200
msg = "Success" if status_code == 200 else "Failed"
[运行示例输出] msg: 'Success'
语法结构为 `值1 if 条件 else 值2`。适合赋值单一确定值的短逻辑,不建议在一个表达式中嵌套多层三元运算,避免可读性骤降。
\n
f-string 变量内嵌与格式化对齐
示例 010
title = "Python"
banner = f"{title:*^20}"
left_align = f"{title:<10}END"
[运行示例输出] banner: '*******Python*******', left_align: 'Python END'
f-string 中可在变量后添加 `:` 声明格式化指令。`<` 左对齐、`>` 右对齐、`^` 居中对齐,并在前面补充填充字符,极大简化文本报表对齐排版。
\n
f-string 浮点保留位与千分位分隔符
示例 011
amount = 1234567.8912
formatted = f"¥{amount:,.2f}"
pct = f"{0.856: .1%}"
[运行示例输出] formatted: '¥1,234,567.89', pct: ' 85.6%'
使用 `,.2f` 组合可一次性完成千分位逗号逗开以及保留两位小数的四舍五入;`:.1%` 直接换算为百分比并保留一位小数。
\n
f-string 调试表达式输出 (3.8+)
示例 012
x = 42
y = 10
debug_log = f"{x=}, {y=}, {x + y=}"
[运行示例输出] debug_log: 'x=42, y=10, x + y=52'
在变量或表达式后追加 `=`,格式化字符串将自动附带表达式文本及其求值结果,省去手动编写提示字符串,是本地打印调试的利器。
\n
标准输入行流读取与批量类型转换
示例 013
# 模拟输入流 '10 20 30'
raw_input = "10 20 30"
a, b, c = map(int, raw_input.split())
[运行示例输出] a: 10, b: 20, c: 30
使用 `str.split()` 将空白符分割为字符串列表,再用 `map(int, ...)` 执行惰性映射,最后解包到独立变量,是算法题与命令行交互的标准输入范式。
\n
print 输出自定义间隔符与不换行控制
示例 014
import sys
print("A", "B", "C", sep=" -> ", end=" | ")
print("END")
[运行示例输出] A -> B -> C | END
`print` 默认 `sep=' '`、`end='\n'`。通过指定 `sep` 可以快速输出自定义格式的分隔线,将 `end` 改为空字符或空格可实现同一行连续刷新输出。
\n
链式连续比较运算符
示例 015
score = 85
is_valid = 60 <= score < 90
in_range = 10 < 20 < 30 < 40
[运行示例输出] is_valid: True, in_range: True
Python 原生支持数学意义上的链式比较,`a < b < c` 等价于 `(a < b) and (b < c)`,且中间的操作数只会被求值一次,逻辑表达极为自然。
\n
同一性 is 与 相等性 == 核心区别
示例 016
l1 = [1, 2]
l2 = [1, 2]
eq_check = (l1 == l2)
id_check = (l1 is l2)
[运行示例输出] eq_check: True, id_check: False
`==` 比较两个对象的内容(调用 `__eq__`);`is` 比较对象的内存地址(即 `id(a) == id(b)`)。除单例对象(如 `None`)推荐用 `is None` 外,值判断必须用 `==`。
\n
复合逻辑分支与短路早退
示例 017
def check_user(user):
    if not user:
        return "Empty user"
    if user.get("role") == "admin":
        return "Admin access"
    return "Guest access"
res = check_user({"role": "admin"})
[运行示例输出] res: 'Admin access'
使用“保镖子句”(Guard Clauses)尽早返回(Early Return),避免在多重 `if` 之间嵌套大量缩进,使代码主干逻辑平铺展开,可维护性强。
\n
海象运算符 (Walrus Operator :=) 条件赋值 (3.8+)
示例 018
data = "Python_Programming"
if (n := len(data)) > 10:
    msg = f"Length {n} exceeds threshold"
[运行示例输出] msg: 'Length 18 exceeds threshold'
`:=` 允许在表达式内部同时完成变量赋值与值返回,避免了为了判断长度而提前单独写一行 `n = len(...)`,使逻辑聚合度更高。
\n
结构化模式匹配 (Pattern Matching 3.10+)
示例 019
command = ["upload", "avatar.png"]
match command:
    case ["quit"]:
        action = "Stop"
    case ["upload", filename]:
        action = f"Uploading {filename}"
    case _:
        action = "Unknown"
[运行示例输出] action: 'Uploading avatar.png'
`match-case` 不仅做值匹配,更结合了解包和类型匹配,下划线 `_` 作为通配符处理兜底场景,比传统的 `elif` 链条更直观清晰。
\n
数学内置聚合:abs, pow, round 特殊舍入
示例 020
dist = abs(-15)
power = pow(2, 10, 1000)  # 2^10 % 1000
banker_round1 = round(2.5)
banker_round2 = round(3.5)
[运行示例输出] dist: 15, power: 24, banker_round1: 2, banker_round2: 4
`round()` 采用“银行家舍入法”(偶数舍入),向最接近的偶数取整,`2.5` 变为 `2`,`3.5` 变为 `4`;`pow(x, y, z)` 在计算大数幂模运算时效率极高。
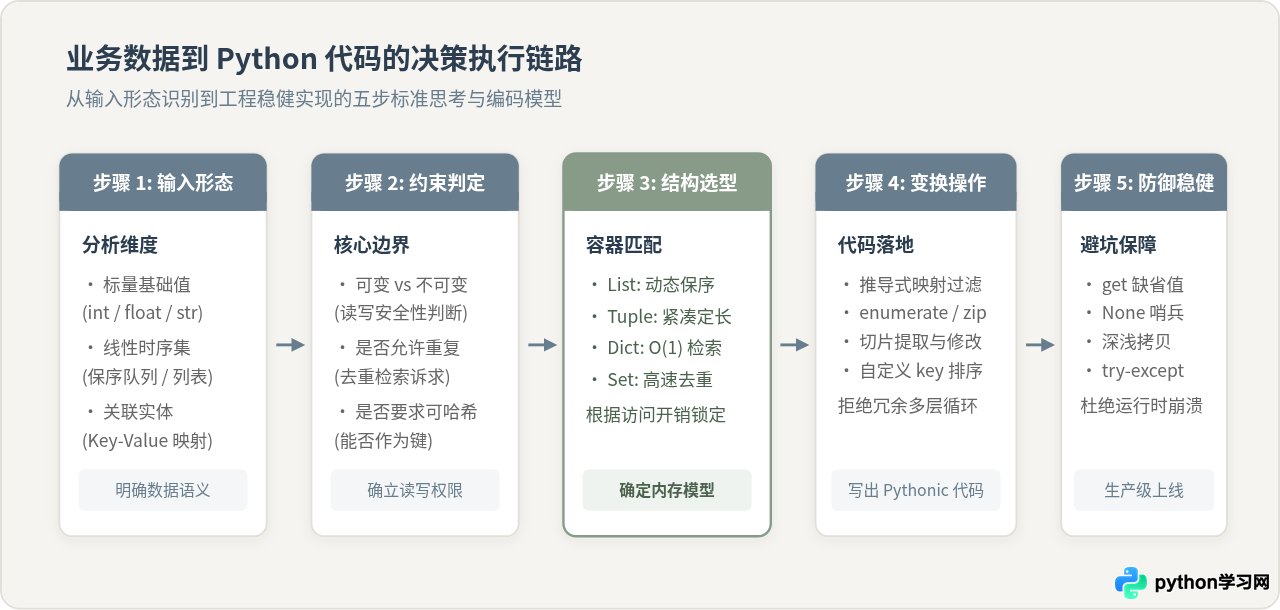
图 1:业务数据到 Python 代码的决策执行链路(从形态识别到防御落地的五步思考模型)
语法要点提醒:
在 Python 3.8+ 中引入的海象运算符(:=)与 3.10+ 的 match-case 语法极大提升了复杂分支判断的代码紧凑度。但在团队工程中,应优先保证表达式可读性,避免单行嵌套过密。
二、流程控制与高效迭代核心示例(021 - 035)
迭代协议是 Python 运行模型的基石。编写高效循环的核心原则是:避免手动通过数组下标 `lst[i]` 寻址,充分借助 `enumerate()`、`zip()`、`reversed()` 等内置迭代生成器,结合哨兵控制与提前退出机制降低算法复杂度。
for 循环配合 range 的正反向步长迭代
示例 021
evens = [x for x in range(0, 10, 2)]
countdown = list(range(5, 0, -1))
[运行示例输出] evens: [0, 2, 4, 6, 8], countdown: [5, 4, 3, 2, 1]
`range(start, stop, step)` 生成前闭后开的整数序列。步长为负数时必须保证 `start > stop`,它返回的是惰性序列对象,占用极小的常数内存。
\n
while 循环与边界哨兵防护
示例 022
count = 0
items = []
while count < 3:
    items.append(count)
    count += 1
[运行示例输出] items: [0, 1, 2], final count: 3
`while` 循环适合迭代次数非预先已知的场景。务必在循环体内部严格推进循环条件更新(如递增或指针下移),杜绝由于条件遗漏造成的死循环。
\n
break 提前终止循环与资源早退
示例 023
target = 7
found = None
for num in [2, 4, 7, 9, 11]:
    if num == target:
        found = num
        break
[运行示例输出] found: 7
`break` 立即跳出当前所在的最内层循环,后续尚未遍历的元素将被跳过。常用于线性查找、命中目标即停的业务逻辑中以节省无效开销。
\n
continue 跳过当次迭代与条件过滤
示例 024
odds = []
for n in range(1, 8):
    if n % 2 == 0:
        continue
    odds.append(n)
[运行示例输出] odds: [1, 3, 5, 7]
`continue` 中断当前轮次的执行,直接跃迁至下一轮迭代的条件判断。能够减少深层 `if-else` 的嵌套层级,使业务过滤流程更平顺。
\n
for-else 哨兵循环完成检测机制
示例 025
users = ["alice", "bob", "charlie"]
search_target = "david"
status = ""
for u in users:
    if u == search_target:
        status = "Found"
        break
else:
    status = "Not Found in collection"
[运行示例输出] status: 'Not Found in collection'
循环末尾的 `else` 子句仅在循环“完整遍历完毕、且未被 `break` 触发打断”时执行,彻底消除了手动设置 `found_flag = False` 标记变量的冗余做法。
\n
enumerate 获取索引与元素的标准姿态
示例 026
fruits = ["apple", "banana", "orange"]
indexed = [f"{idx}:{fruit}" for idx, fruit in enumerate(fruits, start=1)]
[运行示例输出] indexed: ['1:apple', '2:banana', '3:orange']
杜绝使用 `range(len(lst))` 来通过索引查找元素。`enumerate(iterable, start=0)` 以优雅、无额外查找开销的方式同时返回索引与元素。
\n
zip 并行同步迭代多个独立序列
示例 027
names = ["Alice", "Bob", "Charlie"]
scores = [95, 88, 92]
report = [f"{n}: {s}" for n, s in zip(names, scores)]
[运行示例输出] report: ['Alice: 95', 'Bob: 88', 'Charlie: 92']
`zip()` 将多个可迭代对象对应位置的元素打包成元组。默认以最短输入序列的长度为准截断,适合多序列数据对齐映射。
\n
zip(..., strict=True) 长度对齐防护 (3.10+)
示例 028
a = [1, 2, 3]
b = ['x', 'y']
aligned_data = []
try:
    for x, y in zip(a, b, strict=True):
        aligned_data.append((x, y))
except ValueError as err:
    err_msg = "Lengths do not match"
[运行示例输出] err_msg: 'Lengths do not match'
在严谨的数据处理中,若各列长度不一致往往预示着脏数据。`strict=True` 能够在长度不对齐时主动抛出 `ValueError`,防止静默丢弃长序列末尾数据。
\n
reversed 反转序列的惰性轻量迭代
示例 029
seq = [10, 20, 30]
rev_iter = reversed(seq)
first = next(rev_iter)
rest = list(rev_iter)
[运行示例输出] first: 30, rest: [20, 10]
`reversed()` 产生一个反向迭代器,无需额外为整个序列克隆出新的内存副本,相比 `seq[::-1]` 在大规模列表倒序遍历时节省巨量内存。
\n
sorted 迭代中安全保护原列表不被污染
示例 030
raw_scores = [78, 95, 62, 88]
sorted_scores = sorted(raw_scores, reverse=True)
[运行示例输出] raw_scores: [78, 95, 62, 88], sorted_scores: [95, 88, 78, 62]
`sorted()` 会构建并返回一个全新的排序列表,而原列表 `raw_scores` 保持原有顺序不变,是多线程读取或不可变数据流中的安全做法。
\n
二维坐标系与矩阵的嵌套遍历
示例 031
matrix = [[1, 2], [3, 4]]
flattened = [val for row in matrix for val in row]
[运行示例输出] flattened: [1, 2, 3, 4]
列表推导式支持多层嵌套循环,外层循环在前,内层循环在后,执行语义等同于嵌套的 `for` 结构,能以一行代码扁平化二维数组。
\n
避免遍历中修改原列表:过滤与新建模式
示例 032
nums = [1, 2, 3, 4, 5, 6]
# 错误做法:for x in nums: nums.remove(x) -> 会导致索引位移漏删
filtered_nums = [x for x in nums if x % 2 != 0]
[运行示例输出] filtered_nums: [1, 3, 5]
在迭代正在被修改的列表时,内部游标会导致元素跳过或重复访问。最稳健的模式是使用推导式生成新列表,或对列表的浅拷贝 `nums[:]` 进行遍历。
\n
itertools.chain 高效链式串联多序列
示例 033
import itertools
list_a = [1, 2]
list_b = [3, 4]
combined = list(itertools.chain(list_a, list_b))
[运行示例输出] combined: [1, 2, 3, 4]
使用 `itertools.chain()` 串联多个序列时,不会在内存中提前拼接大列表,而是逐个产出元素,极大降低了超大数据集合并时的瞬时内存峰值。
\n
内置聚合函数 sum, min, max 的单行求值
示例 034
prices = [29.9, 15.5, 99.0, 4.2]
total = sum(prices)
cheapest = min(prices)
priciest = max(prices)
[运行示例输出] total: 148.6, cheapest: 4.2, priciest: 99.0
内置聚合函数以底层的 C 实现执行循环,相比显式手写 `for` 累加更短小、更易读,且运行性能通常有 2-5 倍的提升。
\n
pass 占位语句与抽象接口骨架搭建
示例 035
class DataProcessor:
    def parse_header(self):
        pass  # 待后续子类或具体模块实现
    def execute(self):
        return "Executed"
res = DataProcessor().execute()
[运行示例输出] res: 'Executed'
`pass` 是一个空操作(No-op)语句。当语法上需要一个代码块,但逻辑上尚未编写或无需执行任何指令时,用于充当合法的占位符。
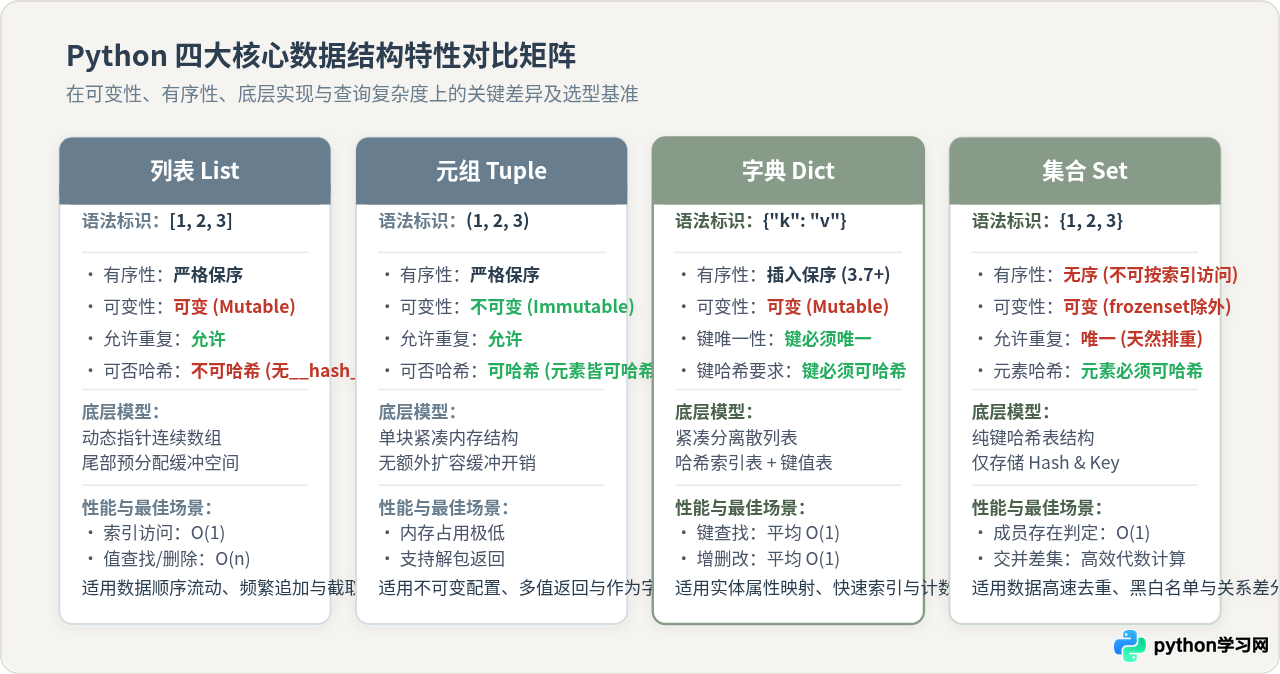
图 2:Python 四大核心数据结构特性对比矩阵(可变性、底层模型与复杂度基准)
三、核心序列数据结构:字符串与列表(036 - 060)
字符串与列表构成了 Python 中最常用的有序线性序列。字符串是不可变序列,任何修改操作都会返回全新对象;列表则是连续存储指针的动态数组,支持就地变异修改。正确理解它们的内存机制是规避性能陷阱与数据污染的前提。
深度对比:`list.sort()` 就地排序 vs `sorted()` 内置函数 1. 内存与调用对象差异: `list.sort()` 是列表类型的专属方法,直接在原列表底层的连续内存上重新排列指针,返回值为 `None`;`sorted()` 是全局内置函数,接受任何可迭代对象(如元组、字典视图、生成器),并始终分配内存构建一个新的列表返回。2. 适用场景差异: 当原序列不再需要保留原始顺序、且列表规模庞大需要节省内存时,必须使用 `list.sort()`;当数据源是只读序列(如元组)、或者处于多线程读写环境需要保持原列表状态不变时,必须选用 `sorted()`。
字符串基础切片与极速回文倒序
示例 036
text = "PythonCode"
prefix = text[:6]
suffix = text[6:]
reversed_text = text[::-1]
[运行示例输出] prefix: 'Python', suffix: 'Code', reversed_text: 'edoCnohtyP'
切片语法 `[start:stop:step]`。负步长 `-1` 表示从右往左截取,`text[::-1]` 是 Python 中翻转字符串或检测回文字符串最精炼的惯用法。
\n
前后缀空白与特定字符剔除 (strip/lstrip/rstrip)
示例 037
raw_str = "   ==Welcome to Admin==   \n"
clean_str = raw_str.strip().strip("=")
[运行示例输出] clean_str: 'Welcome to Admin'
`strip()` 默认去除首尾所有的空白字符(空格、换行 `\n`、制表符 `\t`)。传入字符串参数时,会将包含的所有字符集合在两侧剥除。
\n
字符串定点分割与最大分割数限制 (split / rsplit)
示例 038
log_line = "2026-11-17|INFO|UserLogin|IP=127.0.0.1"
parts = log_line.split("|", maxsplit=2)
[运行示例输出] parts: ['2026-11-17', 'INFO', 'UserLogin|IP=127.0.0.1']
通过设置 `maxsplit` 参数,可以限制分割次数,保留剩余未分割的文本作为一个整体,特别适合解析带固定头部的日志或键值字符串。
\n
字符串高效连接拼接 (str.join 优于 + 拼接)
示例 039
words = ["High", "Performance", "Python"]
sentence = " ".join(words)
csv_line = ",".join(map(str, [101, 202, 303]))
[运行示例输出] sentence: 'High Performance Python', csv_line: '101,202,303'
由于字符串是不可变对象,循环中使用 `+` 会反复在内存中申请新空间并拷贝旧数据,时间复杂度退化为 $O(n^2)$;`join()` 预先计算总长度后一次性分配,为 $O(n)$。
\n
字符串查找定位:find 与 index 的安全权衡
示例 040
msg = "Hello World"
pos_found = msg.find("World")
pos_missing = msg.find("Python")  # 返回 -1
# msg.index("Python")  # 若不存在则抛出 ValueError
[运行示例输出] pos_found: 6, pos_missing: -1
若子串不存在,`str.find()` 优雅返回 `-1`,而 `str.index()` 会直接中断抛出 `ValueError`。在无异常捕获保护的判断逻辑中,应优先使用 `find()` 或 `in`。
\n
前后缀模式校验 (startswith 与 endswith 元组匹配)
示例 041
filename = "report_2026.xlsx"
is_doc = filename.endswith((".xlsx", ".xls", ".csv"))
is_report = filename.startswith("report_")
[运行示例输出] is_doc: True, is_report: True
`startswith()` 和 `endswith()` 接受元组参数,允许一次性传入多个备选后缀进行多重校验,免去了手写一长串 `or` 条件的冗余。
\n
字符串内容局部精确替换 (replace 与数量限制)
示例 042
doc = "cat and dog, cat and bird"
replaced_one = doc.replace("cat", "tiger", 1)
replaced_all = doc.replace("cat", "tiger")
[运行示例输出] replaced_one: 'tiger and dog, cat and bird', replaced_all: 'tiger and dog, tiger and bird'
`replace(old, new, count)` 返回新字符串,原始字符串保持不变。指定 `count` 参数可限定最大替换次数。
\n
列表追加元素与批量合并 (append vs extend)
示例 043
list_a = [1, 2]
list_b = [3, 4]
list_a.append([3, 4])  # 作为一个子列表追加
list_b.extend([5, 6])  # 展开元素依次追加
[运行示例输出] list_a: [1, 2, [3, 4]], list_b: [3, 4, 5, 6]
`append(obj)` 将参数作为单一整体元素推入列表尾部;`extend(iterable)` 遍历可迭代对象将其内元素逐一推入,两者混淆会导致嵌套列表层级错误。
\n
任意索引位置插入与安全弹出 (insert 与 pop)
示例 044
stack = [10, 20, 30]
stack.insert(1, 15)  # 在下标 1 插入 15
tail = stack.pop()    # 弹出末尾元素 O(1)
first = stack.pop(0)  # 弹出头部元素 O(n)
[运行示例输出] stack: [15, 20], tail: 30, first: 10
`pop()` 默认移除末尾并返回该值,耗时为 $O(1)$;`insert()` 或 `pop(0)` 会引发后续所有内存元素的整体搬移,时间复杂度为 $O(n)$。
\n
列表元素按值删除与安全性检查 (remove 与 in)
示例 045
queue = ["task1", "task2", "task3"]
if "task2" in queue:
    queue.remove("task2")
[运行示例输出] queue: ['task1', 'task3']
`remove(x)` 仅删除列表中第一个出现的匹配值。若元素不存在会直接触发 `ValueError` 导致程序崩溃,因此必须前置 `if x in lst:` 检查或进行异常捕获。
\n
元素出现频次统计与首次索引检索 (count 与 index)
示例 046
scores = [80, 90, 80, 100, 80]
freq = scores.count(80)
first_idx = scores.index(80)
[运行示例输出] freq: 3, first_idx: 0
`count()` 进行全表线性扫描计算出现总次数;`index()` 从左往右检索第一个匹配项下标,支持指定检索切片区间 `scores.index(val, start, stop)`。
\n
就地反转与切片反转对比 (reverse 与 [::-1])
示例 047
arr1 = [1, 2, 3]
arr1.reverse()  # 原地修改,返回 None
arr2 = [1, 2, 3]
arr3 = arr2[::-1]  # 返回全新列表副本
[运行示例输出] arr1: [3, 2, 1], arr2: [1, 2, 3], arr3: [3, 2, 1]
`list.reverse()` 是就地操作,不产生新对象,开销极小;`arr[::-1]` 会深复制出一个独立的全新列表,需要消耗与原列表等量的内存空间。
\n
列表就地排序 vs 内置排序函数 (sort vs sorted)
示例 048
raw = [3, 1, 4, 1, 5]
raw.sort()  # 就地改变 raw,返回 None
names = ["Bob", "Alice", "Charlie"]
ordered_names = sorted(names, reverse=True)
[运行示例输出] raw: [1, 1, 3, 4, 5], ordered_names: ['Charlie', 'Bob', 'Alice']
`list.sort()` 仅能用于列表且会直接改动原列表;`sorted()` 可接受任何可迭代对象(元组、字典、生成器等)并恒定输出一个新列表。
\n
基于 key 参数的高级自定义单规则排序
示例 049
students = [("Alice", 88), ("Bob", 95), ("Charlie", 72)]
# 按分数降序
students.sort(key=lambda s: s[1], reverse=True)
[运行示例输出] students: [('Bob', 95), ('Alice', 88), ('Charlie', 72)]
Python 内部采用 Timsort 算法,排序过程对每个元素仅调用一次 `key` 函数提取键值并缓存,比手写比较器更迅速且具备稳定性(保留同键原始先后顺序)。
\n
多字段复合优先级排序 (利用元组次序对比)
示例 050
employees = [
    {"dept": "Dev", "age": 30},
    {"dept": "Dev", "age": 25},
    {"dept": "HR", "age": 28}
]
# 先按 dept 升序,同部门按 age 降序
employees.sort(key=lambda x: (x["dept"], -x["age"]))
[运行示例输出] employees: [{'dept': 'Dev', 'age': 30}, {'dept': 'Dev', 'age': 25}, {'dept': 'HR', 'age': 28}]
Python 原生支持元组逐位对比机制。在 `key` 函数中返回 `(字段1, -数值字段2)`,可以极为简洁地实现“多维度复合排序”。
\n
基础列表推导式:数学映射变换
示例 051
squares = [x ** 2 for x in range(1, 6)][运行示例输出] squares: [1, 4, 9, 16, 25]
列表推导式在字节码层面比 `for` 循环搭配 `append()` 执行更快,代码也更为紧凑,是 Pythonic 编码的核心特征之一。
\n
带条件过滤的列表推导式
示例 052
raw_data = ["apple", "", "banana", " ", "cherry", None]
clean_data = [item.strip() for item in raw_data if item and item.strip()]
[运行示例输出] clean_data: ['apple', 'banana', 'cherry']
在推导式末尾追加 `if` 筛选子句,只有满足真值条件的元素才会被计算并装入目标列表,自动完成非法空数据的过滤剔除。
\n
双层嵌套推导式展平二维矩阵
示例 053
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
flat = [num for row in matrix for num in row if num % 2 == 0]
[运行示例输出] flat: [2, 4, 6, 8]
两层 `for` 按照从左到右的次序书写(等价于先遍历外层 `row` 再遍历内层 `num`),并可搭配最后的 `if` 过滤,一行完成矩阵降维与条件筛选。
\n
切片批量赋值与局部元素清除
示例 054
nums = [0, 1, 2, 3, 4, 5]
nums[1:4] = [8, 9]     # 将 [1, 2, 3] 替换为 [8, 9]
nums[0:1] = []         # 清除首个元素
[运行示例输出] nums: [8, 9, 4, 5]
通过对切片赋值(如 `nums[start:stop] = iterable`),可以在不改变容器引用身份的前提下,对内部某段连续区间进行原地扩容、收缩或替换。
\n
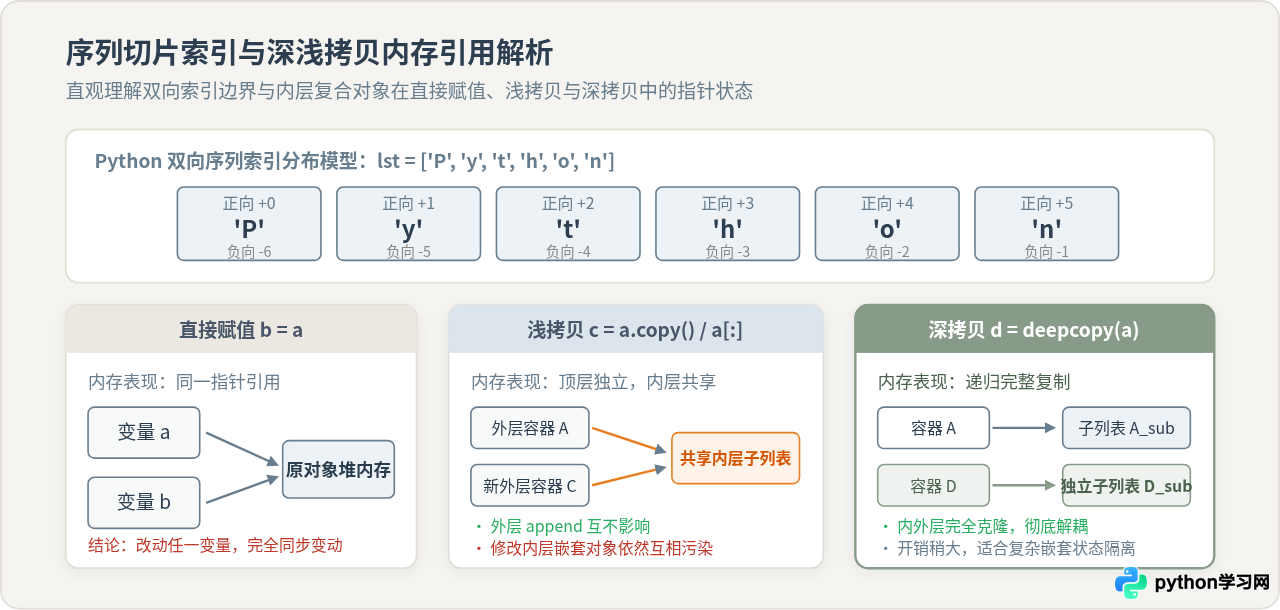
列表浅拷贝与深拷贝隔离 (copy vs deepcopy)
示例 055
import copy
orig = [[1, 2], [3, 4]]
shallow_copied = orig.copy()
deep_copied = copy.deepcopy(orig)
orig[0][0] = 99
[运行示例输出] orig: [[99, 2], [3, 4]], shallow: [[99, 2], [3, 4]], deep: [[1, 2], [3, 4]]
浅拷贝只复制外层容器本身,内层复合子对象仍旧是指向同一内存地址的指针;深拷贝通过递归克隆全部嵌套结构,彻底斩断对原对象的依赖。
\n
列表乘法创建的“共享引用”深坑与正解
示例 056
# 错误做法:bad = [[0] * 3] * 3 -> 会导致修改一行影响全部三行
correct_grid = [[0] * 3 for _ in range(3)]
correct_grid[0][0] = 1
[运行示例输出] correct_grid: [[1, 0, 0], [0, 0, 0], [0, 0, 0]]
使用 `[子列表] * n` 进行乘法复制时,外层列表存储的实际上是同一子列表引用的多次复制;必须使用列表推导式在每轮循环中独立创建全新的子列表。
\n
带条件的极值索引检索 (min / max 搭配 key)
示例 057
players = [{"name": "A", "score": 92}, {"name": "B", "score": 98}, {"name": "C", "score": 85}]
champion = max(players, key=lambda p: p["score"])
[运行示例输出] champion: {'name': 'B', 'score': 98}
`max()` 与 `min()` 同样接受 `key` 参数,直接返回具有最大键值的对象实体,避免了为了找最高分而遍历排序的冗余步骤。
\n
列表批量分块处理 (Chunking 切片技法)
示例 058
data = list(range(1, 10))
chunk_size = 3
chunks = [data[i:i + chunk_size] for i in range(0, len(data), chunk_size)]
[运行示例输出] chunks: [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
以 `chunk_size` 作为步长生成循环索引,通过动态切片 `data[i:i+chunk_size]` 实现数据分段分批加载,广泛应用于批量写入数据库或接口分页调用。
\n
高效过滤容器中的所有空值假值
示例 059
mixed_list = [0, "Valid", None, False, "", [1], {}]
valid_items = list(filter(None, mixed_list))
[运行示例输出] valid_items: ['Valid', [1]]
`filter(None, iterable)` 是 Python 的高能特性:当第一个参数传入 `None` 时,会自动采用各元素的布尔真值判定进行过滤,剔除所有 Falsy 元素。
\n
列表实现栈与双端队列 deque 的性能取舍
示例 060
from collections import deque
# 列表作为栈 LIFO
stack = []
stack.append(1)
top = stack.pop()  # O(1)
# 队列 FIFO 使用 deque 替代 list.pop(0)
q = deque([1, 2])
q.append(3)
head = q.popleft()  # O(1) 性能极佳
[运行示例输出] top: 1, head: 1, remaining_q: deque([2, 3])
列表尾部操作 `append/pop` 极快(栈)。但在需要先进先出(FIFO 队列)时,`list.pop(0)` 会引发全量重排;必须使用 `collections.deque` 实现两端 $O(1)$ 操作。
图 3:序列双向切片索引与对象拷贝内存引用解析(直接赋值、浅拷贝与深拷贝的底层指针流向)
深度对比:浅拷贝 (Shallow Copy) vs 深拷贝 (Deep Copy) 1. 关键差异: 浅拷贝(如 `lst.copy()` 或 `lst[:]`)只为最外层的容器分配全新内存,其内部容纳的子元素如果是列表或字典等复合对象,仍是指向原对象同一堆内存地址的指针;深拷贝(`copy.deepcopy()`)则会递归遍历并完整克隆整个对象图谱中的所有嵌套层级。2. 避坑指南: 若列表元素全为标量(数字、字符串),浅拷贝完全足够且轻快;若列表包含嵌套子列表(如多维网格配置),必须使用 `deepcopy`,否则修改副本子列表会无意识地篡改原对象。
四、关联映射与集合运算:字典与集合(061 - 080)
字典与集合均基于哈希表(Hash Table)构建,具备平均复杂度为 O(1) 的常数级查找与增删性能。熟练掌握安全取值、原子写入与集合代数运算,能让大量多表关联与排重逻辑在毫秒级内完成。
深度对比:直接下标访问 `dict[key]` vs 安全取值 `dict.get(key, default)` 1. 崩溃风险差异: 当所查询的键在字典中不存在时,直接使用下标 `dict[key]` 会直接触发致命的 `KeyError` 异常中断程序;而 `dict.get(key)` 能够安全返回预设的缺省值(默认 `None`),避免了业务流程的意外崩溃。2. 意图差异: 如果该键“在业务逻辑上必须存在,不存在说明发生了严重状态错误”,应当使用 `dict[key]` 促使问题尽早暴露;如果该配置项是可选的或用户输入不确定的,则必须使用 `dict.get()` 进行防御性兜底。
字典创建与由键值对序列快速组装 (dict 构造函数)
示例 061
keys = ["id", "username", "level"]
values = [1001, "coder_x", "Gold"]
user_profile = dict(zip(keys, values))
[运行示例输出] user_profile: {'id': 1001, 'username': 'coder_x', 'level': 'Gold'}
`dict(zip(keys, vals))` 能够将两个长度平行的序列在一行内合并转化为标准哈希字典,底层直接调用 C 级哈希装填,效率极高。
\n
防御性键访问:dict.get 缺省值兜底
示例 062
config = {"host": "127.0.0.1", "port": 8080}
timeout = config.get("timeout", 30)
missing_err = config.get("api_key")  # 返回 None 而非崩溃
[运行示例输出] timeout: 30, missing_err: None
直接使用下标 `config['timeout']` 在键不存在时会抛出致命的 `KeyError`;使用 `.get(key, default)` 可以安全返回默认缺省值,大幅提升系统鲁棒性。
\n
原子的取值与缺省初始化 (dict.setdefault)
示例 063
group_data = {}
# 若键不存在,则初始化为空列表并返回该列表对象
group_data.setdefault("fruits", []).append("apple")
group_data.setdefault("fruits", []).append("banana")
[运行示例输出] group_data: {'fruits': ['apple', 'banana']}
`setdefault(key, default)` 检查键是否存在:若存在则返回已有值;若不存在则将 `default` 写入字典并返回该对象引用,省去一次单独的 `if key not in d:` 查询。
\n
字典键值弹出与安全删除 (pop 与 popitem)
示例 064
cache = {"a": 1, "b": 2, "c": 3}
val_b = cache.pop("b", None)
last_key, last_val = cache.popitem()  # 弹出最后插入项 (3.7+)
[运行示例输出] val_b: 2, last_key: 'c', last_val: 3, remaining_cache: {'a': 1}
`pop(key, default)` 能够获取值的同时将其从字典中剔除;`popitem()` 遵循 LIFO 顺序移除并返回最后一个键值对,常用于构建轻量缓存剔除逻辑。
\n
字典合并运算符 | 与批量更新 (Python 3.9+ 现代化合并)
示例 065
defaults = {"theme": "light", "font": "sans", "size": 12}
custom = {"theme": "dark", "size": 14}
merged = defaults | custom  # 新增的合并语法,后者覆盖前者
[运行示例输出] merged: {'theme': 'dark', 'font': 'sans', 'size': 14}
Python 3.9 引入了直观的 `|`(合并)与 `|=`(就地更新)运算符,取代了以往冗长的 `copy() + update()` 或 `{**d1, **d2}` 语法。
\n
遍历字典的键、值与键值对 (keys, values, items)
示例 066
stats = {"views": 1200, "likes": 350, "shares": 80}
summary = [f"{k}={v}" for k, v in stats.items()]
[运行示例输出] summary: ['views=1200', 'likes=350', 'shares=80']
在遍历字典时,推荐直接遍历 `.items()` 避免每次都在循环内部通过 `dict[key]` 进行二次哈希寻址,运行更加经济高效。
\n
条件筛选与映射变换的字典推导式
示例 067
raw_scores = {"Alice": 95, "Bob": 58, "Charlie": 82, "David": 45}
passed_students = {k: v for k, v in raw_scores.items() if v >= 60}
[运行示例输出] passed_students: {'Alice': 95, 'Charlie': 82}
使用字典推导式 `{k: v for ... in ... if ...}` 可以高效地对字典进行过滤与重新组装,是数据清洗的关键工具。
\n
字典键值无损反转 (Key-Value 互换)
示例 068
code_to_status = {200: "OK", 404: "Not Found", 500: "Server Error"}
status_to_code = {v: k for k, v in code_to_status.items()}
[运行示例输出] status_to_code: {'OK': 200, 'Not Found': 404, 'Server Error': 500}
当字典的值全部为可哈希对象且不存在重复值时,通过字典推导式互换 `k` 与 `v` 可以实现快速双向查找索引的建立。
\n
按字典的值进行精准排序生成有序列表
示例 069
salaries = {"dev_1": 15000, "dev_2": 28000, "dev_3": 21000}
sorted_devs = sorted(salaries.items(), key=lambda item: item[1], reverse=True)
[运行示例输出] sorted_devs: [('dev_2', 28000), ('dev_3', 21000), ('dev_1', 15000)]
字典本身是无序或按插入保序的,不能直接按值重排。通过 `sorted(d.items(), key=lambda x: x[1])` 输出元组列表,是处理排行榜、 Top-K 的经典解法。
\n
collections.defaultdict 避免 KeyError 初始判断
示例 070
from collections import defaultdict
grouped = defaultdict(list)
data_pairs = [("tech", "python"), ("tech", "rust"), ("art", "design")]
for category, val in data_pairs:
    grouped[category].append(val)
[运行示例输出] grouped: {'tech': ['python', 'rust'], 'art': ['design']}
`defaultdict(工厂函数)` 在首次访问不存在的键时,会自动调用工厂函数(如 `list`、`int`、`set`)生成缺省值,代码不再充斥 `if k not in d`。
\n
collections.Counter 高性能元素词频极速统计
示例 071
from collections import Counter
words = ["python", "go", "python", "rust", "python", "go"]
counter = Counter(words)
top_1 = counter.most_common(1)
[运行示例输出] counter: Counter({'python': 3, 'go': 2, 'rust': 1}), top_1: [('python', 3)]
`Counter` 是专为计数优化的字典子类,内部集成高效的计数逻辑,`.most_common(n)` 可以直接提取出现频次最高的前 n 个元素。
\n
集合定义与海量数据高速去重
示例 072
raw_ids = [101, 102, 101, 103, 102, 104]
unique_ids = set(raw_ids)
is_in_set = 103 in unique_ids  # O(1) 极速查询
[运行示例输出] unique_ids: {101, 102, 103, 104}, is_in_set: True
利用集合底层哈希表的排他性,可以在 $O(n)$ 时间内剔除一切重复数据。在需要进行大量 `x in container` 判定时,转换为集合可将查询开销由 $O(n)$ 降为 $O(1)$。
\n
集合增删操作:discard 与 remove 的安全权衡
示例 073
tags = {"python", "database", "backend"}
tags.add("cloud")
tags.discard("frontend")  # 即使不存在也不会报错
# tags.remove("frontend") # 若不存在会触发 KeyError
[运行示例输出] tags: {'backend', 'cloud', 'database', 'python'}
向集合推入元素用 `add()`;移除元素时,`discard()` 会在元素不存在时静默跳过,而 `remove()` 会报 `KeyError`,在不确定元素是否存在时应选用 `discard()`。
\n
集合代数运算:并集、交集与差集 (|, &, -)
示例 074
frontend_skills = {"HTML", "CSS", "JS", "TypeScript"}
fullstack_target = {"JS", "Python", "Docker"}
union_set = frontend_skills | fullstack_target
intersect_set = frontend_skills & fullstack_target
diff_set = frontend_skills - fullstack_target
[运行示例输出] union: {'HTML', 'CSS', 'JS', 'TypeScript', 'Python', 'Docker'}, intersect: {'JS'}, diff: {'HTML', 'CSS', 'TypeScript'}
集合运算符提供极为强大的关系数学运算:`|` 求并集(包含两者全部技能),`&` 求交集(共同掌握技能),`-` 求差集(属于前者但不属于后者)。
\n
集合对称差集与子集超集关系判定 (^, <=, >=)
示例 075
set_a = {1, 2, 3}
set_b = {2, 3, 4}
sym_diff = set_a ^ set_b  # 独有元素集合 (非共有部分)
is_subset = {2, 3} <= set_a
[运行示例输出] sym_diff: {1, 4}, is_subset: True
`^`(对称差集)提取只在其中一个集合出现、不在两者同时出现的元素;`<=` 用于判断前者是否为后者的完全子集,常用于权限范围验证。
\n
集合推导式 (Set Comprehension)
示例 076
raw_words = ["apple", "BANANA", "Apple", "CHERRY"]
clean_vocab = {w.lower() for w in raw_words}
[运行示例输出] clean_vocab: {'apple', 'banana', 'cherry'}
语法与列表推导式类似但使用大括号 `{}`,能够在处理数据映射(如统一小写化)的同时,自动完成去重工作。
\n
不可变集合 frozenset 作为字典键与嵌套集合
示例 077
frozen_key = frozenset([1, 2, 3])
cache = {frozen_key: "group_alpha"}
set_of_sets = {frozenset([1, 2]), frozenset([3, 4])}
[运行示例输出] cache[frozen_key]: 'group_alpha', size: 2
普通 `set` 是可变对象,没有实现 `__hash__`,无法作为字典的键或另一个集合的元素;`frozenset` 具备不可变性与哈希值,专门填补这一空白。
\n
两组大型数据集的双向快速差分比对
示例 078
db_users = {"user_1", "user_2", "user_3"}
incoming_users = {"user_2", "user_3", "user_4"}
to_insert = incoming_users - db_users
to_delete = db_users - incoming_users
[运行示例输出] to_insert: {'user_4'}, to_delete: {'user_1'}
在数据库数据同步、全量状态对账等工程任务中,利用集合差集能在微秒级内定位新增与失效记录,避免昂贵的全表逐条比对。
\n
多层嵌套字典的安全深层链式提取模式
示例 079
meta = {"response": {"data": {"user": {"id": 99}}}}
# 避免 meta['response']['error']['msg'] 崩溃
user_id = meta.get("response", {}).get("data", {}).get("user", {}).get("id")
[运行示例输出] user_id: 99
在解析来自三方接口或 JSON 的深层嵌套对象时,每层利用 `.get(key, {})` 提供空字典兜底,形成链式防御,彻底免除层层 `try-except` 的臃肿代码。
\n
字典与集合的哈希碰撞与不可变键约束验证
示例 080
valid_dict = {("code", 10): "tuple_key_is_ok"}
# 尝试使用列表作为键:{ [1, 2]: "err" } 会触发 TypeError: unhashable type: 'list'
key_hashable = isinstance(hash(("code", 10)), int)
[运行示例输出] key_hashable: True, mapped_val: 'tuple_key_is_ok'
字典键与集合元素必须满足“可哈希协议”(实现了稳定的 `__hash__` 与 `__eq__`)。不可变类型(int, str, tuple)可哈希,而列表、字典等可变类型严禁作为键。
五、元组、函数封装与健壮防御示例(081 - 100)
元组为数据提供了不可变性(Immutability)的确定性保障,而规范的函数参数设计与完备的异常处理机制则是生产级健壮系统的护城河。
深度对比:列表 (List) vs 元组 (Tuple) 的选型与底层权衡 1. 可变性与安全: 列表是动态可变的,适合用于聚合生命周期内需要频繁增删改的同质业务实体;元组一旦创建则不可更改,用于表达异构的只读数据记录(如数据库的一行结果),在多函数流转中能够防止被调用方意外篡改。2. 性能与哈希: 元组的内存结构单块连续且无预分配缓冲,内存占用显著低于同等长度的列表;更重要的是,纯不可变元组是可哈希的(Hashable),能够直接充当字典的键或加入集合,而列表则严禁作为键。
元组定义与单元素逗号语法陷阱
示例 081
single_elem_tuple = (42,)   # 必须带逗号
not_a_tuple = (42)           # 仅仅是带括号的整数 int
tuple_type = type(single_elem_tuple).__name__
int_type = type(not_a_tuple).__name__
[运行示例输出] tuple_type: 'tuple', int_type: 'int'
在 Python 语法中,决定元组身份的本质是“逗号 `,`”而非圆括号。定义单元素元组时若漏掉逗号,Python 会将其作为普通数学运算括号解析。
\n
扩展元组解包 (Star Unpacking *) 截取任意段落
示例 082
first, *middle, last = [10, 20, 30, 40, 50]
head, *tail = (1, 2, 3)
[运行示例输出] first: 10, middle: [20, 30, 40], last: 50, tail: [2, 3]
在解包时为变量添加前缀 `*`,该变量将以列表形式自动吸收所有剩余未被匹配的元素,能够灵活获取两端或截断中间数据。
\n
函数多值返回本质与元组解包接收
示例 083
def calculate_stats(scores):
    return min(scores), max(scores), sum(scores) / len(scores)
lowest, highest, avg = calculate_stats([80, 90, 100])
[运行示例输出] lowest: 80, highest: 100, avg: 90.0
Python 并不真正支持返回多个独立实体。语法 `return a, b, c` 实际是将其打包为一个三元组返回,调用方通过多变量解包无缝接收。
\n
typing.NamedTuple 强类型自文档化记录
示例 084
from typing import NamedTuple
class ServerNode(NamedTuple):
    ip: str
    port: int
    is_active: bool = True
node = ServerNode("192.168.1.1", 8080)
[运行示例输出] node: ServerNode(ip='192.168.1.1', port=8080, is_active=True), ip: '192.168.1.1'
`NamedTuple` 拥有元组的不可变性与超低内存消耗,同时允许像类属性一样通过 `node.ip` 进行语义化访问,是替代简单字典的优雅方案。
\n
函数参数定义与默认参数位置顺序
示例 085
def send_mail(to_addr, title, content="Empty", priority=1):
    return f"To: {to_addr} | Title: {title} | P:{priority}"
mail = send_mail("admin@test.com", "Urgent Alert", priority=0)
[运行示例输出] mail: 'To: admin@test.com | Title: Urgent Alert | P:0'
没有默认值的必填位置参数必须严格置于所有具备默认值的参数之前,否则会导致语法解析歧义直接抛出 `SyntaxError`。
\n
可变默认参数致命陷阱与 None 哨兵法则
示例 086
# 错误做法:def append_item(val, container=[]): container.append(val)
def append_item_safe(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container
res1 = append_item_safe(1)
res2 = append_item_safe(2)
[运行示例输出] res1: [1], res2: [2]
函数的默认参数在 `def` 定义加载时只被创建并求值一次。若默认值为列表或字典等可变对象,多次调用会共享并累积污染同一对象;必须用 `None` 作为哨兵。
\n
仅限位置参数与仅限关键字参数规范 (/ 与 *) (3.8+)
示例 087
def configure_api(endpoint, /, timeout=30, *, api_key):
    return f"Endpoint: {endpoint}, Timeout: {timeout}, Key: {api_key}"
# endpoint 只能按位置传入,api_key 必须以键值对显式指定
cfg = configure_api("https://api.io", 60, api_key="secret_xyz")
[运行示例输出] cfg: 'Endpoint: https://api.io, Timeout: 60, Key: secret_xyz'
`/` 之前的参数为“仅限位置参数”(调用者不能使用关键字传参,方便后续无痛重命名形参名);`*` 之后的参数为“仅限关键字参数”(强制调用者显式写出键名)。
\n
可变位置参数打包与解包转发 (*args)
示例 088
def sum_all(*args):
    return sum(args)
numbers = [1, 2, 3, 4]
total = sum_all(*numbers)
[运行示例输出] total: 10
函数形参中的 `*args` 将调用方传入的任意数量的位置参数打包为元组;而在调用函数时传入 `*lst` 则是将列表解包拆分为独立位置参数。
\n
可变关键字参数打包与解包转发 (**kwargs)
示例 089
def render_html_tag(tag, **attributes):
    attr_str = " ".join(f'{k}="{v}"' for k, v in attributes.items())
    return f"<{tag} {attr_str}>" if attr_str else f"<{tag}>"
html_img = render_html_tag("img", src="pic.png", alt="Profile")
[运行示例输出] html_img: '<img src="pic.png" alt="Profile">'
`**kwargs` 将多余的关键字参数聚拢为字典;在调用下游接口时使用 `**dict` 能够将字典展开为平级的参数传递,是构建装饰器和通用代理的基石。
\n
匿名函数 lambda 语法与即时计算
示例 090
square = lambda x: x ** 2
add = lambda a, b: a + b
res = add(square(3), 1)
[运行示例输出] res: 10
`lambda` 表达式仅允许包含单行计算表达式,其执行结果隐式返回。适合在不需要复用函数名的高阶函数参数位置(如 `key=`)就地声明短小逻辑。
\n
map 函数流式数据转换
示例 091
raw_strs = ["10", "20", "30"]
mapped_ints = list(map(int, raw_strs))
[运行示例输出] mapped_ints: [10, 20, 30]
`map(func, iterable)` 将函数逐个应用在可迭代对象上,返回的是惰性迭代器,只有在显式消费时才会产生计算开销。
\n
filter 函数流式条件筛选
示例 092
data = [12, -5, 0, 8, -2, 19]
positive_nums = list(filter(lambda x: x > 0, data))
[运行示例输出] positive_nums: [12, 8, 19]
`filter(predicate, iterable)` 保留使判定函数返回真值的元素,同样以惰性流方式产出结果,在大数据流过滤时相比直接构建大列表更加节省内存。
\n
any 与 all 全局状态聚合断言
示例 093
checks = [True, True, False]
has_any_true = any(checks)
are_all_true = all(checks)
has_negative = any(x < 0 for x in [1, -2, 3])
[运行示例输出] has_any_true: True, are_all_true: False, has_negative: True
`any()` 在遇到首个 True 时短路返回 True;`all()` 在遇到首个 False 时短路返回 False。常结合生成器表达式进行系统权限或约束检查。
\n
基础异常捕获与隔离 (try-except)
示例 094
raw_str = "abc"
try:
    val = int(raw_str)
except ValueError as e:
    val = 0
    err_type = type(e).__name__
[运行示例输出] val: 0, err_type: 'ValueError'
严禁裸写 `except:` 捕获一切异常(这会静默吞掉键盘中断 `KeyboardInterrupt` 和系统退出信号)。务必指定具体明确的异常类进行精细化兜底。
\n
多重异常分支独立处理
示例 095
def safe_divide(a, b):
    try:
        return a / b
    except ZeroDivisionError:
        return "Division by zero"
    except TypeError:
        return "Invalid operand type"
res_zero = safe_divide(10, 0)
res_type = safe_divide(10, "2")
[运行示例输出] res_zero: 'Division by zero', res_type: 'Invalid operand type'
针对不同的错误成因制定差异化的挽救策略,自上而下匹配首个符合条件的 `except` 分支。
\n
完整异常架构闭环 (try-except-else-finally)
示例 096
log = []
try:
    f = open("/dev/null", "w")
    f.write("test")
except IOError:
    log.append("Handled error")
else:
    log.append("Success with no exceptions")
finally:
    f.close()
    log.append("Cleanup completed")
[运行示例输出] log: ['Success with no exceptions', 'Cleanup completed']
`else` 分支仅在 `try` 块内未发生任何异常时执行;`finally` 分支无论是否产生异常、甚至在包含 `return` 的情况下都必定强制执行,用于终极清理。
\n
主动抛出异常与前置断言防卫 (raise ValueError)
示例 097
def set_age(age):
    if not isinstance(age, int) or age < 0:
        raise ValueError(f"Invalid age: {age}, must be non-negative int")
    return age
try:
    set_age(-5)
except ValueError as err:
    caught_msg = str(err)
[运行示例输出] caught_msg: 'Invalid age: -5, must be non-negative int'
在核心业务方法开头,对非法参数主动使用 `raise` 抛出带明确上下文信息的异常,遵循“快速失败”(Fail-Fast)哲学,防止脏数据渗透到下游。
\n
上下文管理器与资源自动释放 (with 语句)
示例 098
# 自动安全回收文件句柄、网络锁
with open("/dev/null", "r") as f:
    content = f.read()
is_closed = f.closed
[运行示例输出] content: '', is_closed: True
`with` 语句基于上下文管理协议(`__enter__` 与 `__exit__`),即使代码块内部发生崩溃或异常中断,也会确保文件、数据库连接等系统底层资源平稳关闭。
\n
闭包实现简单函数执行耗时计时装饰器
示例 099
import time
from functools import wraps

def time_it(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start
        return result, duration
    return wrapper

@time_it
def simulate_task():
    return sum(range(100000))
_, elapsed = simulate_task()
[运行示例输出] task executed, elapsed_seconds: > 0.0001s
利用 `@wraps(func)` 保留原函数的元信息(名字、文档)。装饰器以无侵入的方式为目标函数扩展性能分析、日志审计或权限验证功能。
\n
模块独立运行入口防卫 (if __name__ == '__main__':)
示例 100
def run_system_diagnostics():
    return "All tests passed"

if __name__ == "__main__":
    report = run_system_diagnostics()
[运行示例输出] report: 'All tests passed'
当模块作为脚本直接执行时,内置变量 `__name__` 的值为 `'__main__'`;当其被其他模块 `import` 导入时,`__name__` 为文件名。此写法保证作为库导入时不被意外触发。
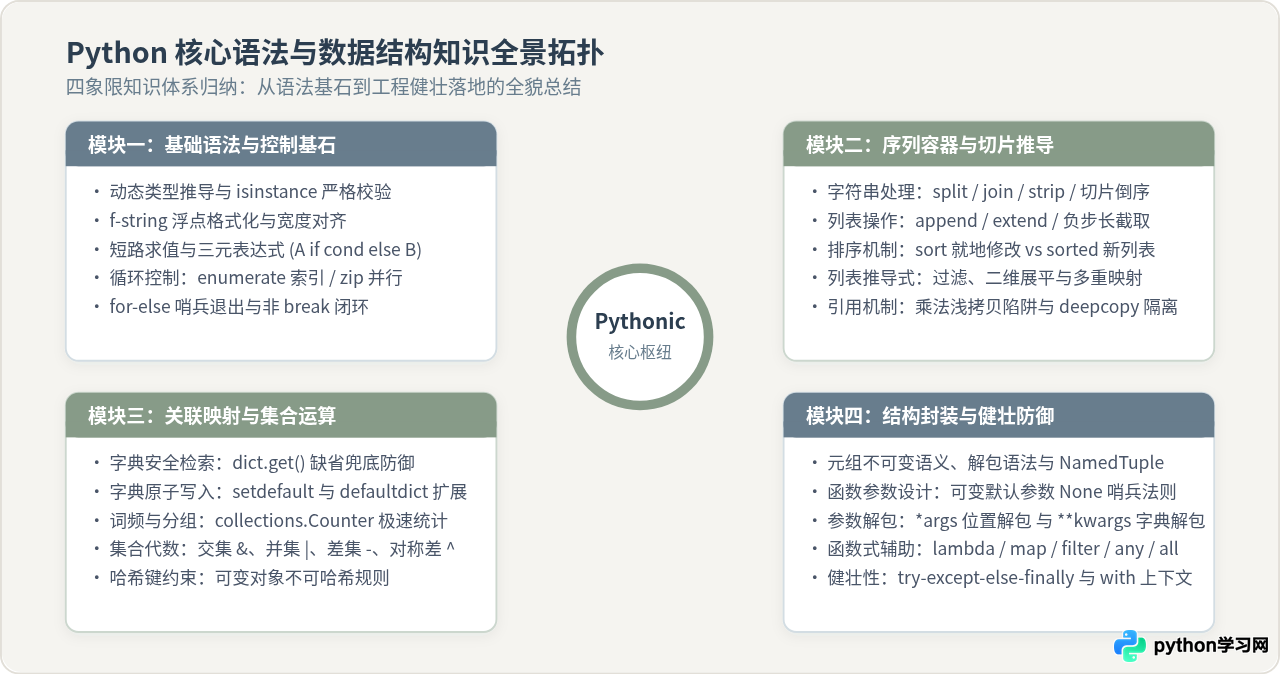
图 4:Python 核心语法与数据结构知识全景拓扑(四象限归纳模型与核心枢纽)