


Python官方文档怎么看:标准库模块参考手册快速索引指南
针对Python官方文档与标准库模块参考手册的查阅难点,提供结构解析、高效检索路径、核心段落速读方法与实际场景排查指南。
很多开发者在查阅 Python 官方文档时,常因海量术语和层层嵌套的章节而感到无从下手,甚至直接放弃官方资料转向碎片化的搜索结果。掌握 Python 标准库文档的核心在于理清三层检索逻辑:从入口版本确认开始,依据任务类型选择索引路径,最后按标准库模块页面的通用布局精准读取函数签名、默认参数与版本变更说明。本文将具体拆解官方参考手册的架构与定位方法,帮助读者在几秒内直达目标 API 详情。
一、标准库文档的全局架构与入口选择
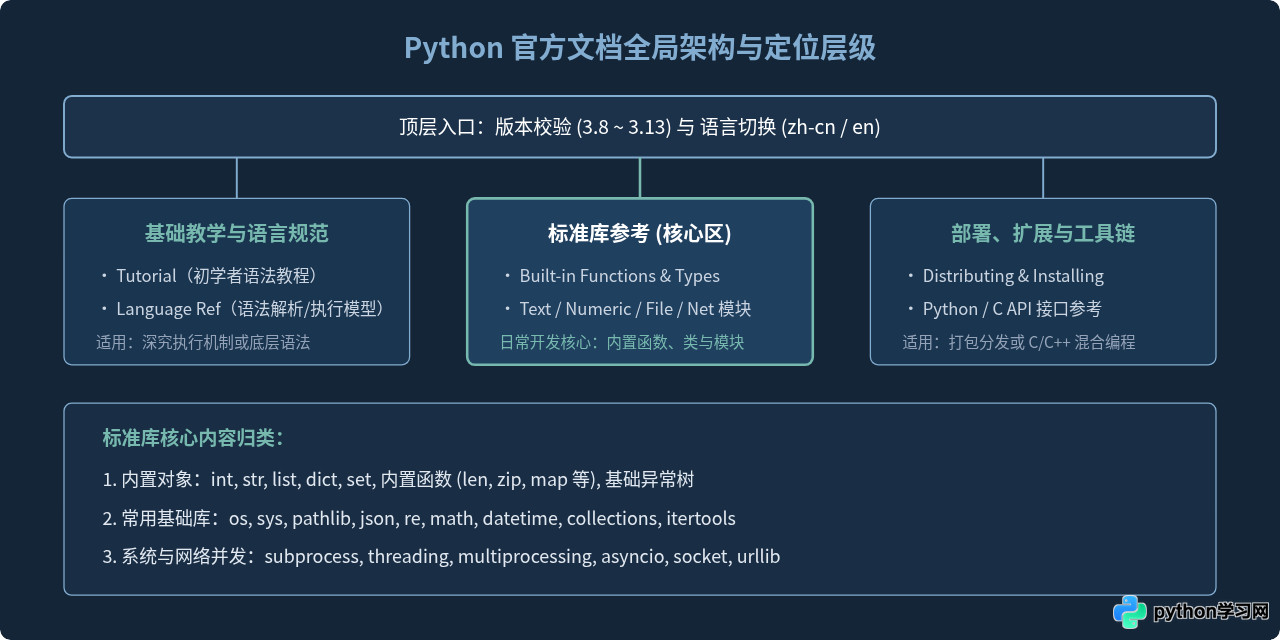
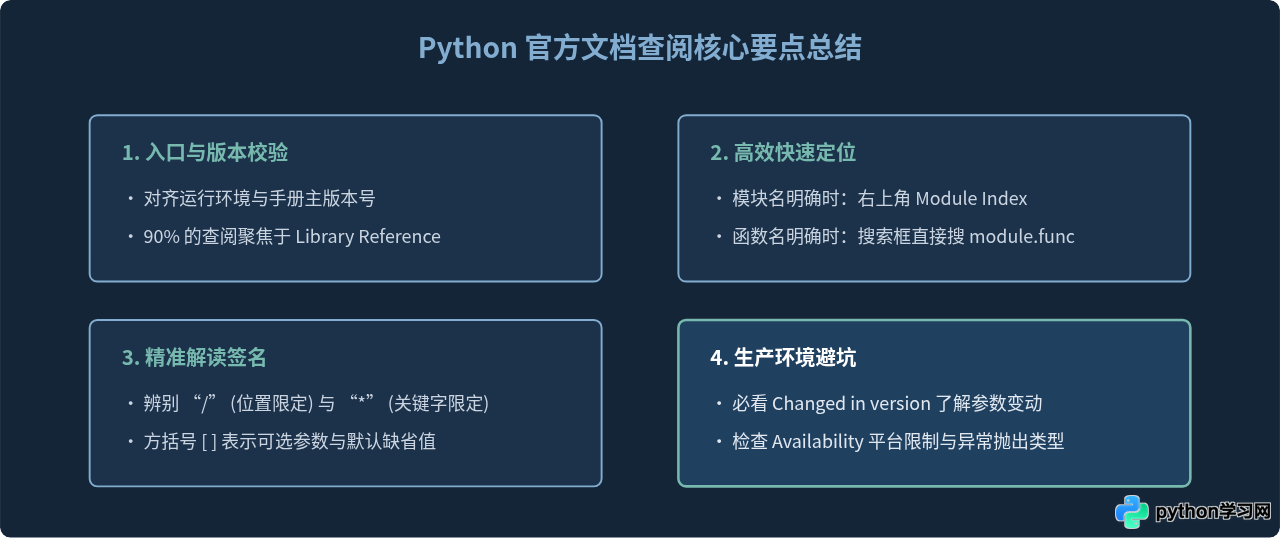
打开 Python 官方文档(docs.python.org)时,顶部版本选择器是必须首先核对的要素。如果本地开发环境使用的是 Python 3.10,而页面默认停留在最新主干分支(如 Python 3.13 或 prerelease),某些新增语法、弃用模块(如已被移除的 cgi 或 asyncore)或参数变动会导致查阅结论与实际运行不符。
在确认语言版本后,文档顶层体系主要划分为五大板块:入门教程(Tutorial)、语言参考手册(Language Reference)、标准库参考(Library Reference)、安装与分发说明,以及 C API 扩展手册。开发者日常排查内建类型、核心库和系统交互时,90% 的查阅需求均集中在标准库参考(The Python Standard Library)中。
二、四步高效检索法:从模糊需求到精确函数
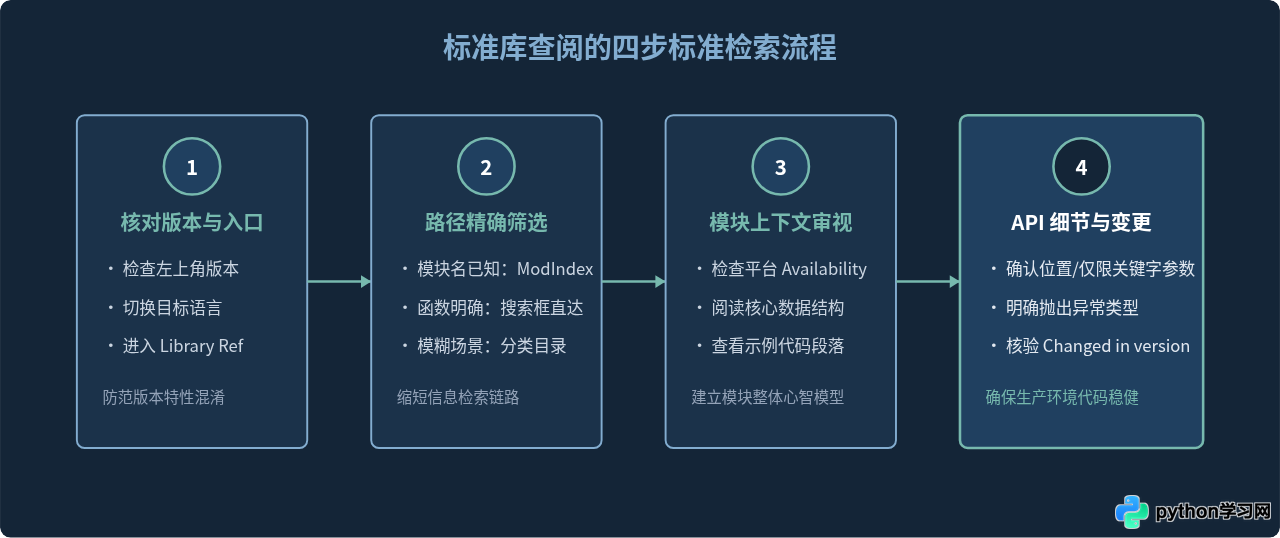
直接在搜索引擎输入零散关键词往往会得到过期博客。利用官方系统内置工具,可以通过以下四个步骤建立稳定的查阅路径:
- 使用模块索引页(Global Module Index):页面右上角的
modules链接包含了所有官方模块的字母 A-Z 索引。当明确模块名(如dataclasses、shutil)时,点击即可一键跳转,避免在目录树中反复翻找。 - 善用快速搜索框与精确前缀:文档搜索框支持直接定位标识符。输入
str.split或json.dumps可以跳过中间列表直接定位函数定义。 - 查看模块开篇的“可用性”与“导航表”:模块页第一段通常标明
Availability: Unix, Windows等平台约束,以及该模块是否支持特定的并发模型。 - 优先定位示例(Tutorial / Examples 节):官方标准库页面在正文靠后或前段通常设有独立的“Examples”或“Recipes”小节(如
itertools recipes),优先看代码范例能极快验证用法。
三、透视模块详情页:API 签名中的隐藏规范
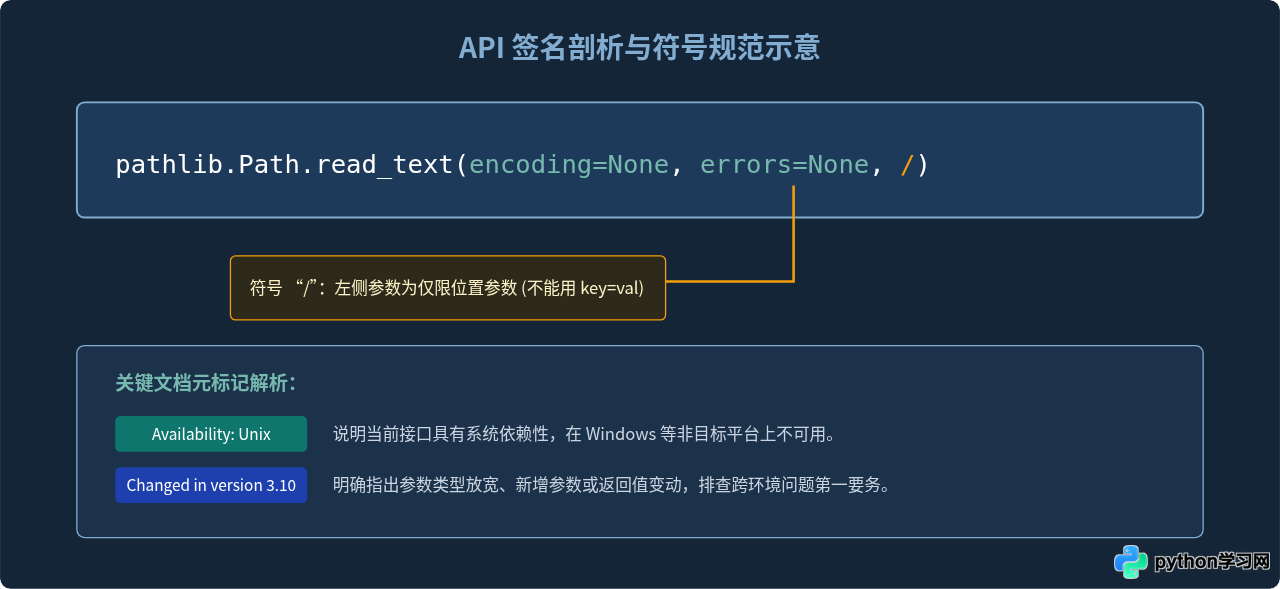
标准库函数或类方法的描述区域是查阅频率最高的部分。Python 官方文档采用严格的书写规范,许多关键约束往往以特殊符号表达:
- 方括号
[ ]:代表可选参数。例如str.split([sep[, maxsplit]]),表示sep和maxsplit均为可选,且若要提供maxsplit,必须先提供sep。 - 斜杠
/与星号*:斜杠左侧的所有参数均为仅限位置参数(Positional-only),调用时不能使用关键字传参;星号右侧的所有参数均为仅限关键字参数(Keyword-only),必须显式指明参数名。 - 版本指示标签(Version Added / Changed):用不同颜色醒目标注。例如
Changed in version 3.8,会详细列出某个参数由必须传入变为可选,或者默认行为的重大演进。
四、实际查阅演练:以 pathlib 与 subprocess 为例
为了直观说明如何将上述检索方法转化为解决具体问题的能力,我们以日常文件处理模块 pathlib 与进程管理模块 subprocess 的查阅场景为例。
场景一:读取文件时的编码控制(pathlib.Path)
假设我们希望使用面向对象的 Path 替代传统的 open() 处理 UTF-8 文本。直接查阅 pathlib 模块索引:
from pathlib import Path

# 在文档中检索:Path.read_text
target = Path("sample.txt")

# 文档指明 encoding 默认为 None(使用系统默认编码,易在 Windows 下引发 UnicodeDecodeError)
# 因此必须显式指定 encoding
content = target.read_text(encoding="utf-8")
print(f"读取字数: {len(content)}")read_text 的说明明确强调:“该方法在底层打开文件,读取内容并自动关闭”。这解释了为什么不需要使用 with 上下文管理器。
场景二:避免子进程管道死锁(subprocess.run)
在执行系统命令时,许多开发者常纠结于该用 os.system、subprocess.Popen 还是 subprocess.run。在官方文档 subprocess 章节第一段,官方给出了最高层级的原则性指引:
“推荐使用run()函数处理所有能够等待执行完成的常见场景。只有在需要复杂交互或异步流式读取时,才直接使用底层Popen类。”
import subprocess

# 根据文档说明:capture_output=True 在 3.7 加入,等同于 stdout=PIPE, stderr=PIPE
result = subprocess.run(
    ["echo", "hello official docs"],
    capture_output=True,
    text=True,  # text=True 会将 bytes 自动根据默认编码解码为 str
    check=True  # 若返回码非 0 则抛出 CalledProcessError
)

# 验证返回对象
print("标准输出内容:", result.stdout.strip())
五、文档查阅核心速查与排查对照
下表总结了阅读 Python 标准库参考时,最常见的符号含义与排查切入点:
| 文档标记 / 符号 | 语法规范含义 | 实际编码中的约束与影响 |
|---|---|---|
func(a, b, /) |
Positional-only 参数 | 不能使用 func(a=1, b=2),必须直接传值 func(1, 2),否则报 TypeError。 |
func(*, key=val) |
Keyword-only 参数 | 必须以 func(key=val) 显式指定名称,不能直接使用位置参数。 |
[param] |
可选参数标记 | 签名表示该参数具有默认值或可不提供。 |
Deprecated since... |
废弃警示 | 将在后续主版本中被移除,新编写的代码应立即选用推荐的替代 API。 |
Availability: Unix |
平台可用性说明 | 特定平台独占接口,跨平台(如同时支持 Windows 与 Linux)项目应避免依赖。 |
结语
阅读官方文档并不是从第一页逐字读到最后一页,而是把它当作一本索引清晰、逻辑严密的工具字典。建立“确认版本 → 检索模块/函数 → 拆解签名约束 → 验证版本变更与示例”的严谨查阅习惯,不仅能够彻底摆脱第三方二手教程的错误误导,也是理解 Python 语言设计哲学与编写高稳定性代码的基础技能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















