


Python轻量级爬虫工具推荐:适合小规模数据采集的库

针对小规模数据采集任务,盘点与对比适合 Python 开发者的轻量级爬虫库,涵盖网络请求与内容解析的核心选型与实战建议。
小规模数据采集通常指采集目标在几百到几万条记录以内、目标网站结构单一、不需要多节点调度和复杂分布式中间件的任务。对于这类需求,引入类似 Scrapy 这样的大型工程框架往往会带来不必要的模板配置与维护成本;而采用简单透明的轻量级库进行组合,不仅十几行代码就能启动,排查问题与部署运行也更加直接高效。
一、轻量爬虫的分层架构与工具组合
编写爬虫本质上可以拆解为三个基础环节:向目标服务器发起网络请求获取原始响应、从 HTML 或 JSON 文本中提取所需字段,以及将清洗后的数据持久化保存到本地文件或轻量数据库中。在小规模采集场景下,我们只需要按需选择每一层的轻量级工具进行拼装,即可完成稳定可靠的单脚本闭环。
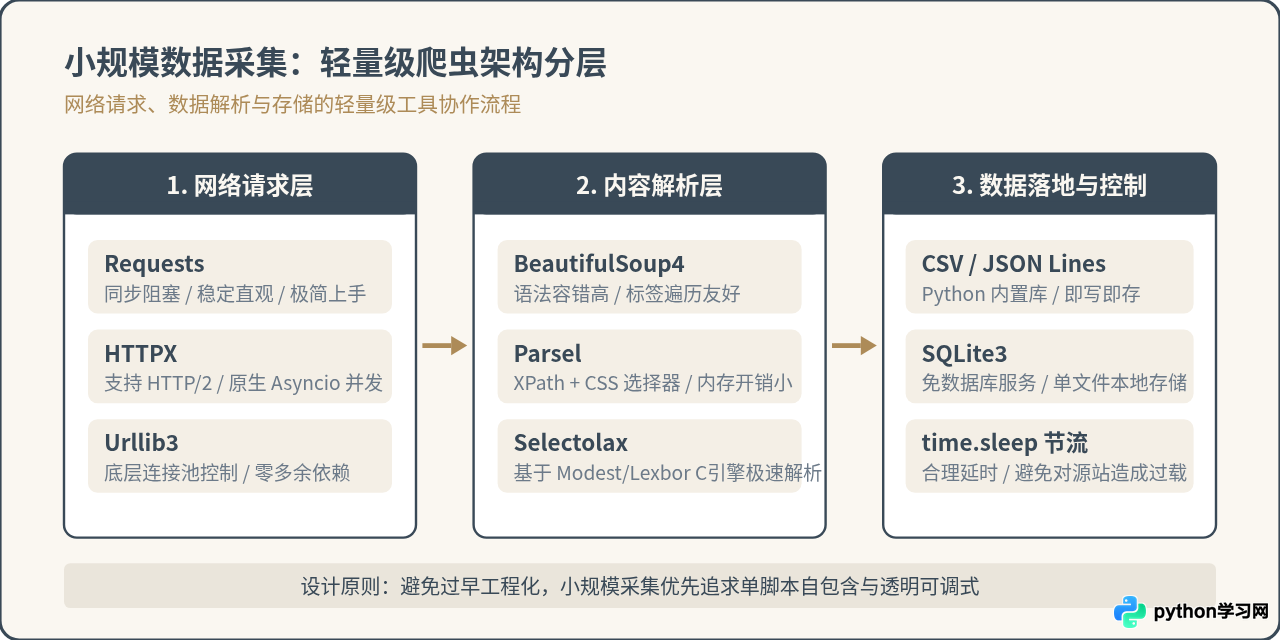
二、网络请求库:Requests 与 HTTPX 的核心取舍
网络请求是数据采集的第一道门槛。对于轻量级场景,选择请求库的关键在于考量代码简洁性与并发吞吐需求。
1. Requests:经久考验的同步利器
requests 是 Python 生态中最经典的 HTTP 库,其核心优势是 API 极其符合直觉。对于几百页的顺序采集任务,配合常规的 for 循环和适度延迟,通常几分钟内就能运行完毕,完全没有必要引入复杂的异步事件循环。
import requests

url = "https://api.example.com/items"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}
params = {"page": 1, "limit": 20}

try:
    response = requests.get(url, headers=headers, params=params, timeout=10)
    response.raise_for_status()  # 检查 HTTP 状态码是否为 200 系列
    data = response.json()
    print("成功获取记录数:", len(data))
except requests.exceptions.RequestException as err:
    print("请求发生异常:", err)
2. HTTPX:原生支持并发与 HTTP/2 的现代化选择
如果采集规模在几千到一两万页之间,按序单线程抓取会花费较长时间。此时 httpx 是首选工具。它的同步调用语法与 requests 保持了 95% 以上的一致性,同时提供了原生的 async/await 异步客户端,能够利用 asyncio 在单进程内轻松达成每秒数十次非阻塞请求,并原生支持 HTTP/2 协议。
import asyncio
import httpx

async def fetch_page(client, page_id):
    url = f"https://example.com/posts/{page_id}"
    headers = {"User-Agent": "CustomScraper/1.0"}
    try:
        resp = await client.get(url, headers=headers, timeout=10.0)
        if resp.status_code == 200:
            return resp.text
    except httpx.HTTPError:
        return None

async def main():
    async with httpx.AsyncClient() as client:
        tasks = [fetch_page(client, i) for i in range(1, 21)]
        results = await asyncio.gather(*tasks)
        print("采集完成,有效页面数:", sum(1 for r in results if r is not None))

# asyncio.run(main())
三、内容解析库:BeautifulSoup、Parsel 与 Selectolax 对比
获取到 HTML 字符串之后,如何精准抽取文本或属性决定了数据质量与解析耗时。选择解析库时,主要根据网页标签的规范程度与解析吞吐量进行判断。
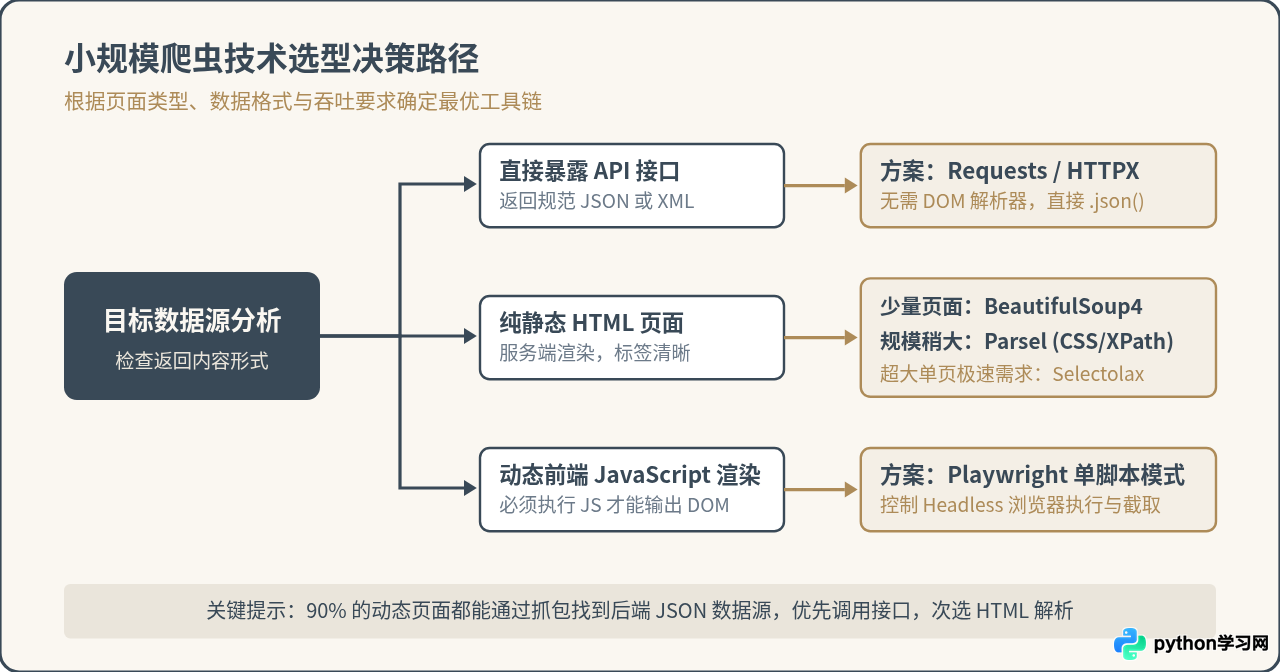
1. BeautifulSoup4:易用性与容错性的典范
bs4(需搭配 lxml 或 html.parser 引擎)支持将破碎甚至未完全闭合的 HTML 片段重构成易于遍历的树形对象。通过 soup.find() 或 soup.select(),开发者可以非常直观地根据标签名、class 或属性层级定位节点,特别适合入门开发者或快速原型验证。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
    <h2 class="title">示例文章标题</h2>
    <span class="author">作者:张三</span>
    <a href="/detail/123" class="link">查看原文</a>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
title = soup.find("h2", class_="title").get_text(strip=True)
author = soup.find("span", class_="author").get_text(strip=True)
link = soup.find("a", class_="link")["href"]

print(f"提取结果: {title} | {author} | {link}")
2. Parsel:灵活强大的 CSS 与 XPath 双语法引擎
parsel 是著名爬虫框架 Scrapy 底层抽取的独立解析器。它不仅运行效率高,而且允许在同一个选择器中自由链式混用 CSS 选择器与 XPath。例如先用 CSS 快速定位父容器,再用 XPath 的精准文本函数提取特定兄弟节点,表达能力极强。
from parsel import Selector

selector = Selector(text=html_doc)
# 支持链式调用与正则抽取
title = selector.css("div.content h2.title::text").get()
link = selector.xpath('//a[@class="link"]/@href').get()
print(f"Parsel 提取: {title} -> {link}")
3. Selectolax:极端性能场景下的 C 引擎利器
当单页 HTML 体积达到几兆字节(如包含大量嵌套表格),或者需要连续高速解析上万个页面时,纯 Python 封装的解析器可能会消耗大量 CPU 时间。selectolax 底层采用 Modest 和 Lexbor 的纯 C 语言引擎,其解析速度和内存占用通常是传统解析器的数倍到数十倍,对于对性能有苛求的轻量级爬虫是绝佳补充。
四、实战规范:轻量爬虫开发的四个关键步骤
轻量并不意味着随意堆砌代码。遵循标准化的四步操作流程,不仅能让爬虫运行更为稳健,还能有效减少被源站风控拦截的概率。
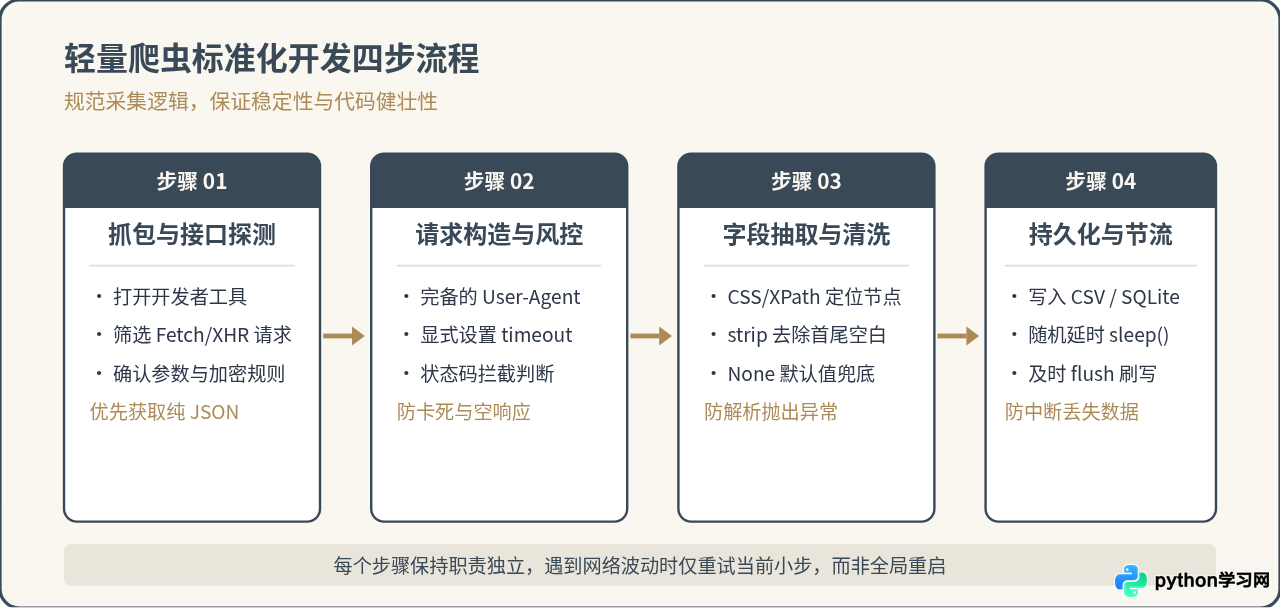
- 务必显式指定
timeout:无论requests还是httpx,默认超时时间若为None,在遭遇目标服务器连接假死时会导致爬虫永久阻塞。通常建议设置timeout=10或分别指定连接与读取超时。 - 即时写入或追加模式:不要把数千条结果全部存入内存列表最后再一次性写盘。推荐使用
csv.writer在每页采集完毕后立即写入并调用flush(),即使中途断电或抛出异常,前面已抓取的数据也不会丢失。 - 加入随机延迟保护目标站点:连续不间断的高频请求极易触发防火墙限流。使用
time.sleep(random.uniform(0.5, 1.5))能有效平摊请求负载。
五、动态渲染的极简补丁方案
部分现代网页的核心内容是通过 JavaScript 异步生成,且加密混淆导致逆向 API 成本过高。在小规模任务下,编写庞大的逆向破解脚本并不划算,可以直接借助 Playwright 的同步单脚本模式进行最小化渲染控制。
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # 启动无头浏览器
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://spa-example.com/products", timeout=30000)

    # 等待关键目标元素渲染完成
    page.wait_for_selector(".product-card")

    # 直接提取 DOM 文本或 HTML 进行后续解析
    items = page.locator(".product-card .title").all_text_contents()
    for item in items:
        print("商品名称:", item.strip())

browser.close()该方案代码量极少,但浏览器内核启动会占用几百兆内存。因此建议:仅在纯文本请求完全无法获取有效数据时,才将 Playwright 作为针对特定页面的后备工具使用。
六、轻量爬虫工具特性综合评定与总结
根据库的职能、性能表现与适用范围,我们可以对上述轻量工具做出客观横向对比:
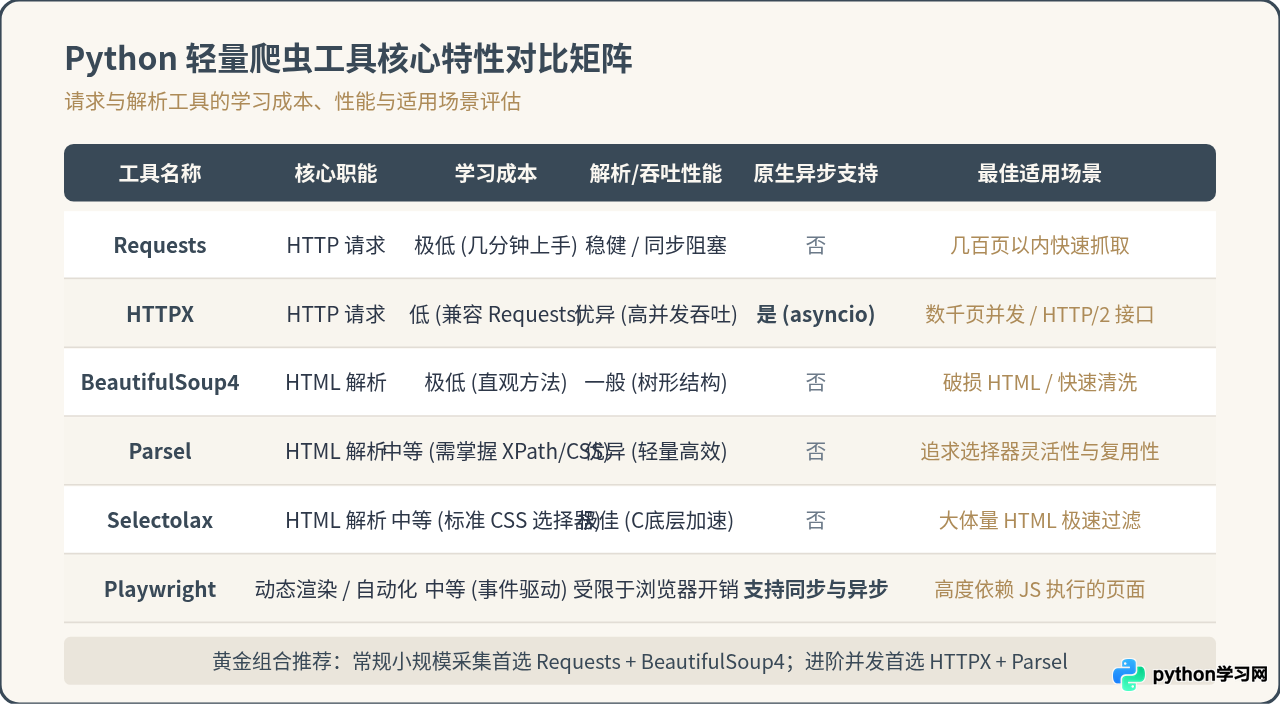
小规模数据采集的核心原则在于实用至上、克制选型。在绝大多数情况下,使用 requests 结合 BeautifulSoup4 或 parsel,再辅以内置的 csv 模块和 time.sleep 频率控制,就足以在几十行代码内高品质地交付采集目标。只有当遇到具体的性能瓶颈或动态渲染阻碍时,再按需平滑升级为 httpx 或 playwright,这样既能大幅缩短初期编码与排错时间,也确保了脚本逻辑的高度清晰与可维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















