


Python怎么分块读取超大CSV文件以节省内存
详细讲解在Python中如何使用Pandas chunksize以及标准库csv模块分块读取超大CSV文件,结合列裁剪与数据类型优化控制内存峰值,提供可落地的实战代码与常见误区避坑指南。
在 Python 中读取数十兆至数十吉字节(GB)的超大 CSV 文件时,如果直接使用常规的 pandas.read_csv(),程序会尝试将整个文件一次性完整载入物理内存。由于 Pandas 在内部构建 DataFrame 时需要存储类型元数据、对象指针以及索引结构,其实际内存开销通常达到原始 CSV 文件体积的 2 至 5 倍,极易触发操作系统的内存耗尽错误(OOM, Out of Memory)。解决这一问题的根本途径是分块读取(Chunking)与流式处理:通过指定每次载入的行数,让程序以生成器的方式逐批处理数据,在前一批次处理完成、写入磁盘或计算出局部汇总值后再载入下一批次,将整个运行期的峰值内存牢牢锁定在单个数据块的体量内。
一、全量载入与分块流式读取的内存机制对比
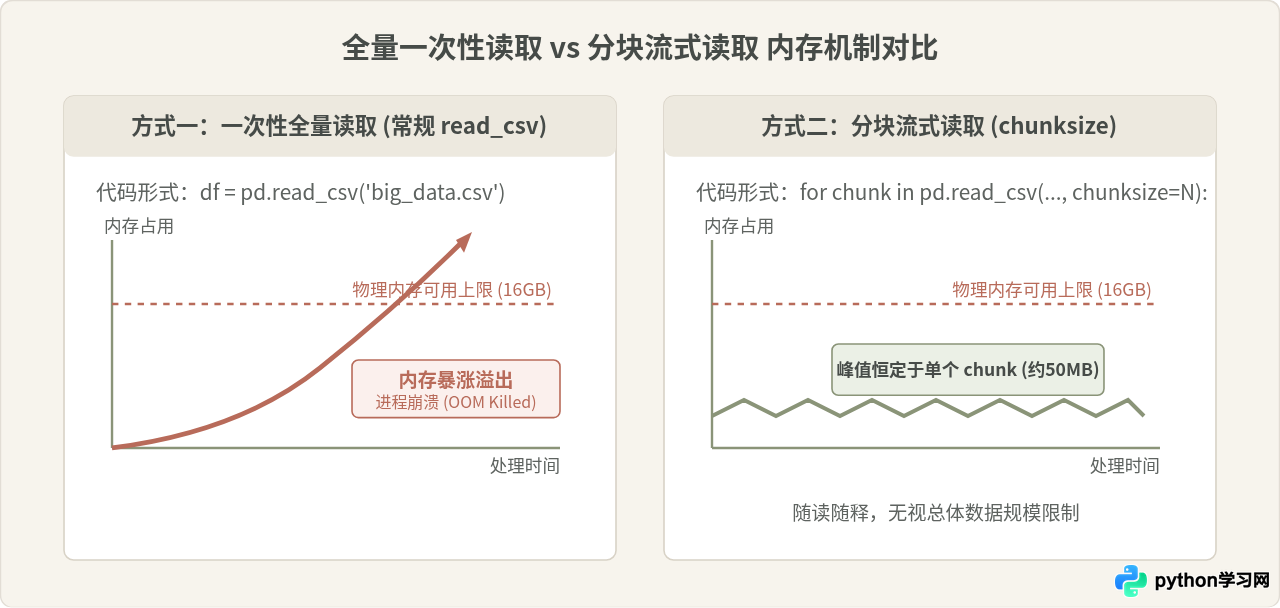
理解分块读取的必要性,首先需要明确一次性全量加载与分块迭代在物理内存中的生命周期差异。在全量模式下,解析器必须完整扫描文件并在堆内存中分配连续或半连续的数据空间,内存曲线随着文件解析呈陡峭上升态势,直到数据全部载入完成;如果文件大小超过可用 RAM,进程就会立刻被操作系统终止。
而在分块模式下,解析器每次只读取固定数量的行(例如 10 万行),构建出一个小型的 DataFrame 片段供业务逻辑运算。当该片段在当前循环轮次处理完毕后,Python 的引用计数机制与垃圾回收器(Garbage Collector)会迅速释放这部分临时对象,使整体内存使用曲线保持为平稳的水平线,与文件本身的整体体积彻底解耦。
二、使用 Pandas 的 chunksize 参数分块读取
在 Pandas 中,pd.read_csv() 提供了一个专用的整数参数 chunksize。只要传入大于 0 的整数,该函数便不再直接返回单个庞大的 DataFrame,而是返回一个可迭代的 TextFileReader 对象。读者可以通过标准的 for 循环按顺序提取出每一个数据块进行操作。
1. 典型应用场景:逐块清洗与流式输出
如果业务目标是对超大文件进行过滤、格式清洗并另存为新文件,最佳实践是采用“边读、边洗、边追加写入”的流水线模式。为了确保生成的 CSV 文件格式正确,只在写入第一个数据块时保留表头(Header),随后的块全部使用追加模式(mode='a')且不输出表头。
import pandas as pd

input_path = "large_dataset.csv"
output_path = "cleaned_dataset.csv"
chunk_size = 100_000  # 每次仅读取 10 万行

# 使用上下文管理器安全打开并迭代
with pd.read_csv(input_path, chunksize=chunk_size) as reader:
    for index, chunk in enumerate(reader):
        # 针对当前块执行业务清洗与条件筛选
        filtered_chunk = chunk[chunk["status"] == "active"]

        # 仅首块写入列名,后续块纯追加数据行
        is_first_chunk = (index == 0)
        filtered_chunk.to_csv(
            output_path,
            mode="a",
            index=False,
            header=is_first_chunk,
            encoding="utf-8"
        )
2. 典型应用场景:逐块局部聚合统计
如果不需要保存所有明细,而是需要统计全局指标(例如计算某列数值的总和、有效记录数或分组计数),切忌将各个 chunk 收集到全局列表中。正确做法是在循环体内维护全局标量或聚合字典,逐块完成局部累加:
import pandas as pd

total_amount = 0.0
total_count = 0

with pd.read_csv("transactions.csv", chunksize=100_000) as reader:
    for chunk in reader:
        # 在块内进行初级计算,避免保留全行数据
        valid_rows = chunk.dropna(subset=["amount"])
        total_amount += valid_rows["amount"].sum()
        total_count += len(valid_rows)

global_mean = total_amount / total_count if total_count > 0 else 0
print(f"全局平均金额为: {global_mean:.2f}")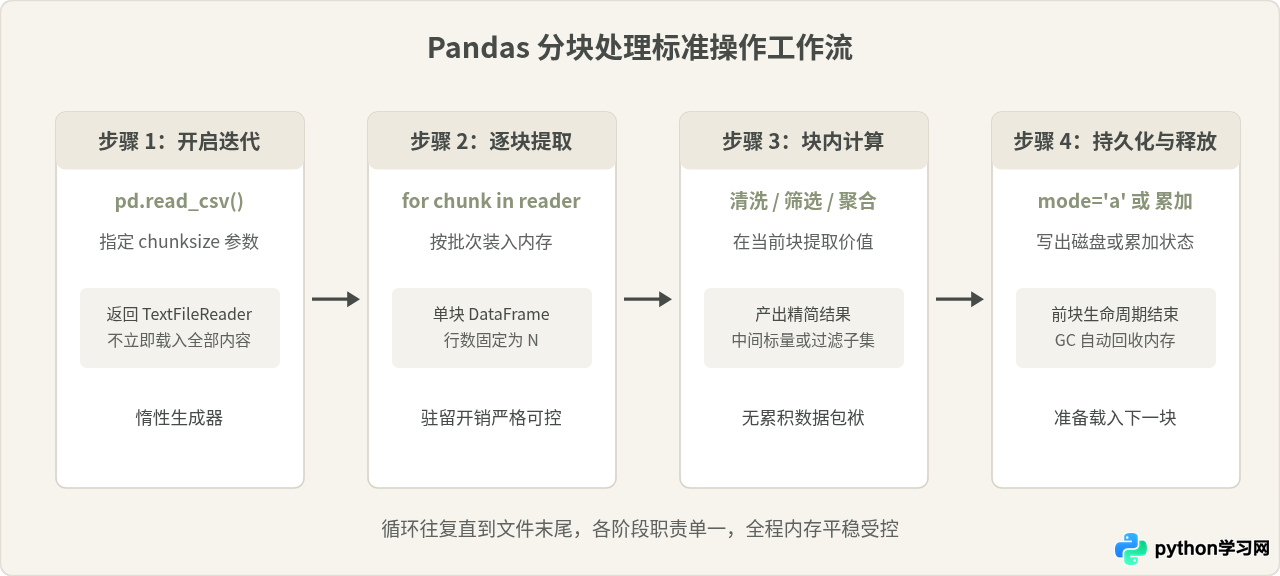
三、协同优化:裁剪列宽与压缩数据类型
分块读取仅控制了行数(纵向),但每一行的列数与数据类型(横向)同样是内存占用的决定性因素。很多超大 CSV 文件往往包含数十甚至上百个字段,若实际分析中仅需其中两三个关键字段,全量读入各列仍然会浪费大量开销。将 chunksize 与 usecols、dtype 协同使用,能进一步把单块内存压缩 50% 至 80% 以上。
1. 使用 usecols 丢弃无用列
usecols 参数允许直接传入需要保留的列名列表或可调用函数。Pandas 底层的 C 语言解析器会在文件扫描阶段直接跳过未被选中的字段,不仅成倍节约内存,还会大幅降低字符串解析与类型推断所耗费的 CPU 时间。
2. 使用 dtype 显示指定低精度或分类类型
在默认情况下,Pandas 会将整数推断为 64 位的 int64,浮点数推断为 float64,而字符串则被赋予通用的 object 类型(每个字符串都包裹为独立的 Python 对象,指针开销极大)。通过指定更为紧凑的类型,可以显著减少内存消耗:
- 数值型下转型:对于取值范围有限的数字,指定
int32、int16或float32。 - 字符串转 Category:对于枚举类型(如状态码、省份、性别等低基数文本列),将其声明为
category类型,底层仅存储小整数映射,能减少 80% 以上的对象内存。
import pandas as pd

# 明确约束目标列和精确类型
target_columns = ["user_id", "status", "score"]
optimized_dtypes = {
    "user_id": "int32",
    "status": "category",
    "score": "float32"
}

with pd.read_csv(
    "giant_logs.csv",
    chunksize=100_000,
    usecols=target_columns,
    dtype=optimized_dtypes
) as reader:
    for chunk in reader:
        # 当前块占用的内存远低于默认 object/int64 配置
        pass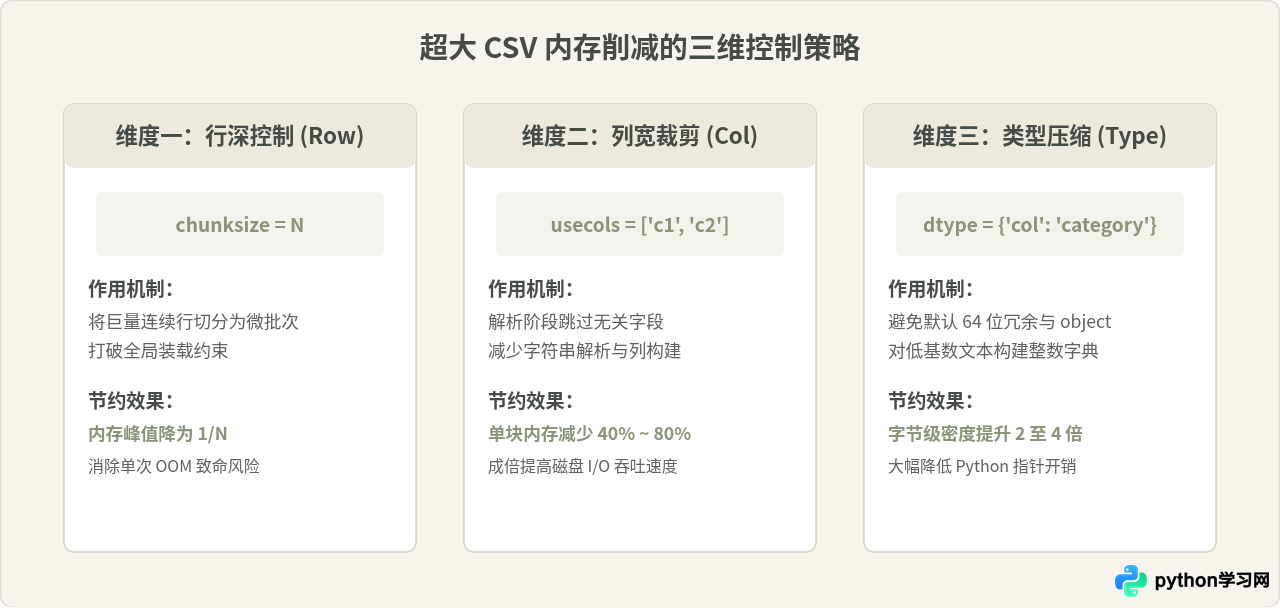
四、零第三方依赖方案:Python 标准库 csv 模块
在没有安装 Pandas、或运行环境资源极度受限(如小型云服务器、轻量 Docker 容器)时,直接使用 Python 内置的 csv 模块是另一种高效且极致节省内存的解法。与 Pandas 默认加载结构化表不同,标准库的 csv.reader 本质上就是行级流式生成器,读取过程几乎不消耗除单行字符串缓存外的任何内存(常驻内存仅有几兆字节)。
标准库逐批次(Batching)处理示例
虽然可以逐行迭代,但在很多网络回传或数据库入库场景中,逐行提交会导致巨大的网络握手延迟。此时可以将内置 csv.reader 包装为按批聚合的生成器,既保持极低内存,又兼顾批量处理效率:
import csv

def read_csv_in_batches(file_path, batch_size=50_000):
    """使用标准库将 CSV 文件流式切分为批次列表"""
    with open(file_path, mode="r", encoding="utf-8") as f:
        reader = csv.reader(f)
        header = next(reader)  # 提取表头

        batch = []
        for row in reader:
            batch.append(row)
            if len(batch) >= batch_size:
                yield header, batch
                batch = []  # 清空缓存,释放当前批次内存

        # 产生剩余未满一个批次的数据
        if batch:
            yield header, batch

# 使用示例
for header, rows in read_csv_in_batches("huge_data.csv", batch_size=50_000):
    # 针对当前批次 rows 执行入库操作或写入
    print(f"成功处理当前批次,行数: {len(rows)}")
五、容易混淆的认知误区与避坑指南
在实际编码中,很多开发者虽然加上了 chunksize 参数,却因为后续处理不当导致内存依旧爆炸,或者执行速度异常缓慢。以下是几个需要明确辨析的典型误区:
辨析与纠正:这是导致“延迟 OOM”的最常见原因。将每个 chunk 追加到列表
chunks.append(chunk),实际上依然把所有数据块的引用保留在内存中,在执行 pd.concat(chunks) 的瞬间,系统不仅需要容纳所有分块,还需要额外分配全表合并的物理空间,内存峰值瞬间翻倍。正确做法是就地持久化(追加写入新文件)或就地累加,绝不长期持有分块的引用。
辨析与纠正:虽然理论上 100 行占用的内存极小,但频繁构建微型 DataFrame 会产生极其可观的 Python 解释器循环开销、底层 C 结构体初始化损耗以及磁盘高频碎片 I/O,可能导致几分钟的任务变成几个小时。通常情况下,推荐将 chunksize 设置在 50,000 到 200,000 行之间,在内存安全与计算吞吐量之间取得最佳平衡。
辨析与纠正:均值、求和、计数等可加性指标天然支持流式增量计算;但对于非线性的全局指标(如中位数、分位数),直接在分块内求中位数无法推导出全局中位数。面对这类任务,不能简单在一个循环内搞定,应采用双趟扫描法(第一趟生成数值直方图或分箱范围,第二趟定位精细区间),或者将中间 ID 键存入轻量级集合/外部数据库,而非把全量行读入内存。
六、技术方案选型总结
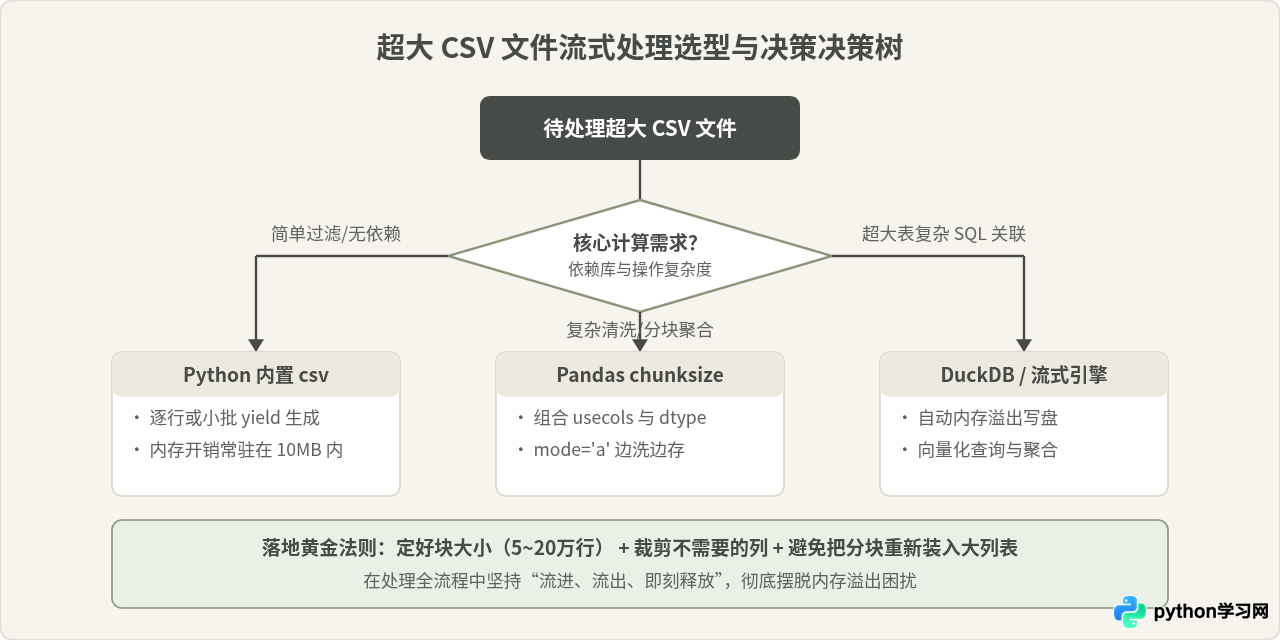
面对不同文件体量、任务目标与环境约束,应当选择最合适的技术路径:
| 场景需求 | 推荐方案 | 内存表现 | 核心优势与适用条件 |
|---|---|---|---|
| 纯行级清洗、过滤、小批入库 | 标准库 csv.reader |
极低 (< 20MB) | 零依赖、启动速度极快、不占内存 |
| 复杂列变换、统计聚合、关联分析 | Pandas chunksize |
可控 (50MB ~ 300MB) | 语法表达力强,支持向量化加速 |
| 多文件联查、全表复杂 SQL 分析 | DuckDB / Polars 惰性模式 | 极低至中等 | 具备流式执行引擎,支持开箱即用 SQL |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















