


Python3.14执行脚本有什么新特性变化
全面解析Python 3.14在执行脚本时的核心新特性与底层变化,包括延迟注解求值对启动速度的提升、模板JIT编译器的演进、自由线程无GIL执行模式及终端回溯诊断优化。
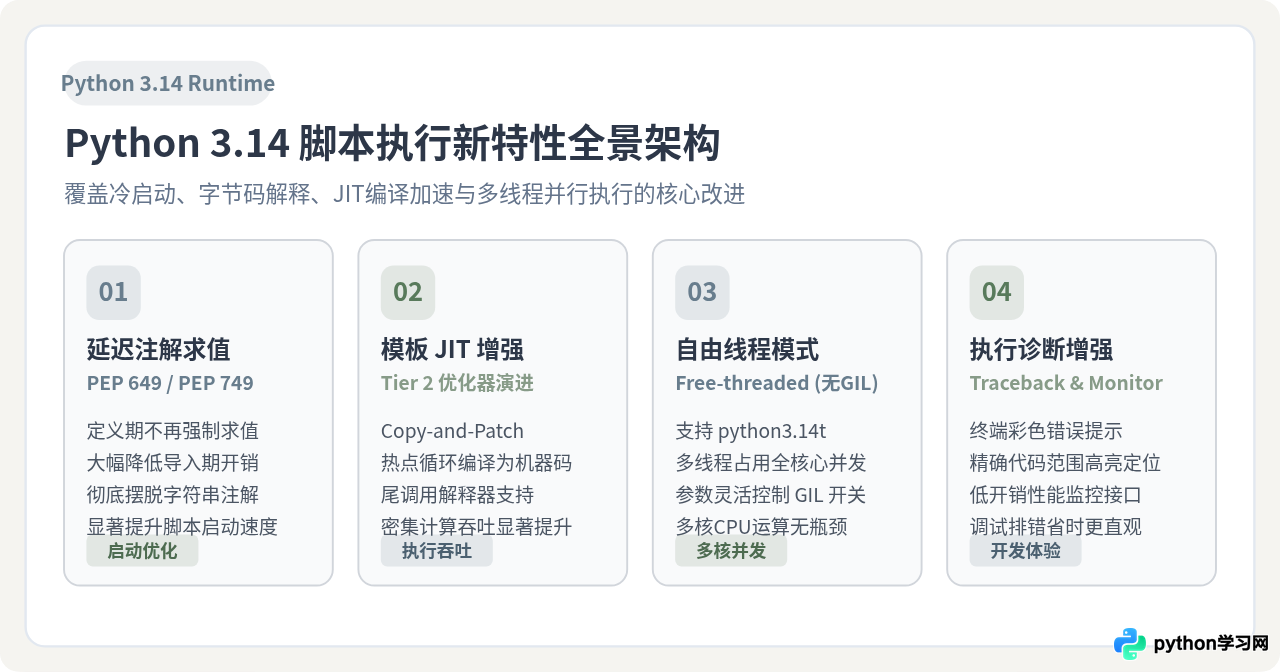
一、冷启动与导入加速:延迟注解求值(PEP 649 / PEP 749)
日常运行 Python 脚本时,第一道瓶颈往往在于脚本载入与模块导入。随着类型提示(Type Hints)在现代 Python 工程中广泛普及,旧版本 Python 在解释执行 import 或脚本顶层代码时,会在定义期(Definition time)直接计算每一个函数、类和变量上的注解表达式。这种行为不仅导致脚本冷启动变慢,还容易引发循环导入报错,迫使开发者添加大量的 from __future__ import annotations 或字符串引号。
在 Python 3.14 中,默认行为发生了实质性转变:注解在定义时不再立即求值,而是被编译为一个独立的、延迟执行的代码对象。只有当代码显式反射查询类型信息时,解释器才会按需计算。
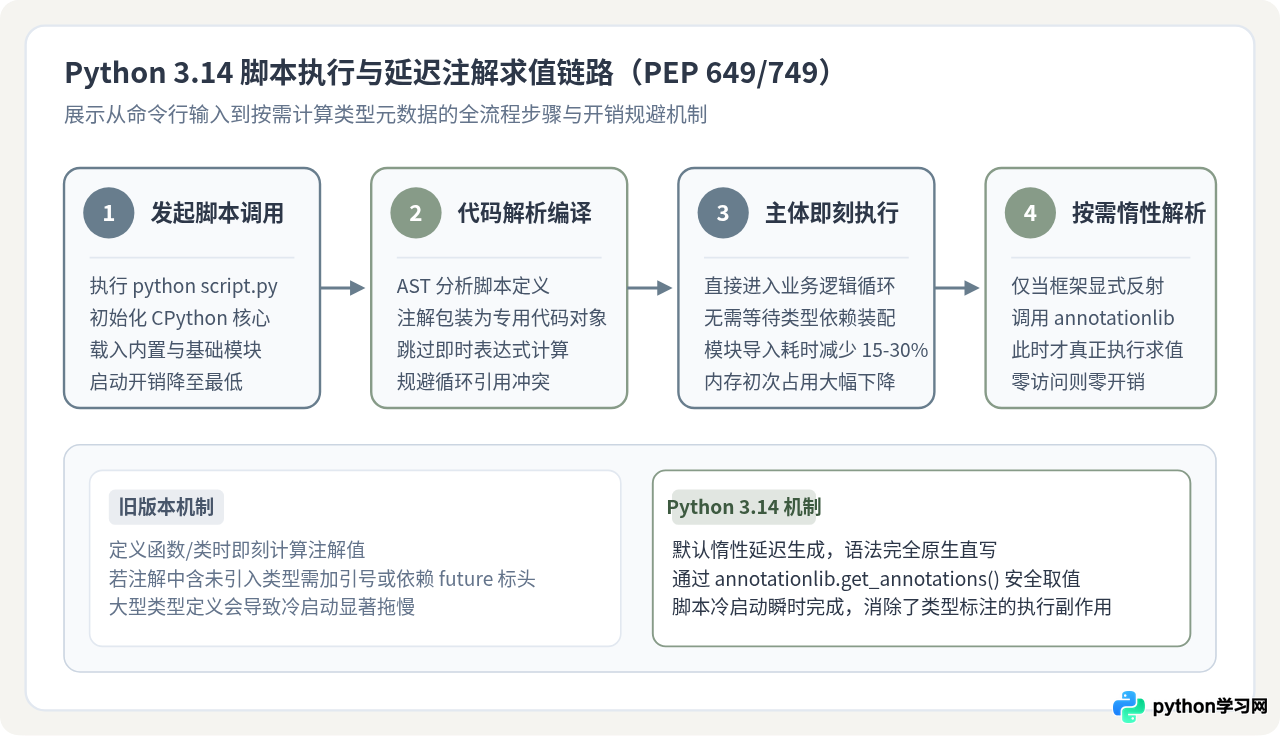
1.1 机制差异:定义期求值 vs 延迟惰性求值
我们可以通过一段具体的类型引用代码,直观理解在相同条件下的执行机制差异:
# 在 Python 3.14 中,无需使用 from __future__ import annotations
class Node:
    def __init__(self, value: int, next_node: Node | None = None):
        self.value = value
        self.next_node = next_node

def fetch_data() -> ComplexExternalType:
    # 假设 ComplexExternalType 定义在尚未加载的外部模块中
    pass
在旧版本 Python 中直接执行此脚本,解释器在读取 next_node: Node | None 时,类 Node 尚未完成构建,会立即抛出 NameError: name 'Node' is not defined。而在 Python 3.14 下执行该脚本:
- 脚本装载阶段:解释器生成一个专门的注解函数对象关联到
__annotate__属性上,不执行名字查找,因此脚本能顺畅执行完毕,毫无额外耗时。 - 按需访问阶段:若后续脚本需要内省(例如 FastAPI、Pydantic 等框架做运行时校验),则通过 Python 3.14 新增的标准库模块安全获取。
1.2 新标准库 annotationlib 的标准操作
为了规范延迟求值的读取,Python 3.14 引入了官方推荐的 annotationlib 标准库,取代直接访问 obj.__annotations__ 字典的旧做法:
import annotationlib

# 显式按需求值,支持三种求值格式 (Format.VALUE, Format.FORWARDREF, Format.SOURCE)
annotations = annotationlib.get_annotations(Node.__init__, format=annotationlib.Format.VALUE)
print("运行时解析的注解:", annotations)
运行时解析的注解: {'value': <class 'int'>, 'next_node': Node | None, 'return': <class 'NoneType'>}
二、运行时执行引擎演进:模板 JIT(Copy-and-Patch)
启动之后,脚本的主体循环与函数调用如何被执行,是 Python 3.14 的另一大核心看点。Python 3.13 首次引入了基于 Copy-and-Patch 技术的实验性 JIT 编译器,而在 Python 3.14 中,这一架构得到了实质性的成熟与深化,并深度结合了 Tier 2 优化器 和 尾调用解释器。
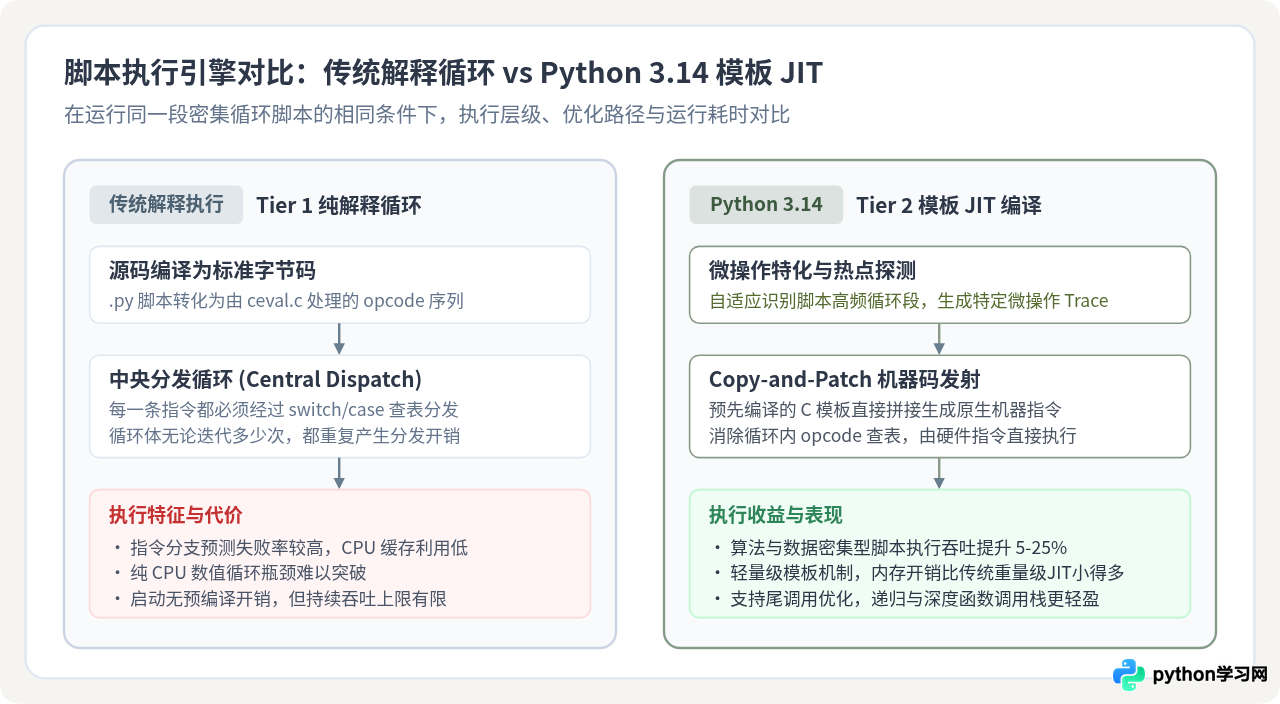
2.1 执行模式的关键差异
| 对比维度 | 标准解释执行(旧模式 / Tier 1) | Python 3.14 模板 JIT 执行(Tier 2) |
|---|---|---|
| 指令分发方式 | 中央巨型 switch/case 逐条查表分发 |
热点代码拼装为连续的底层机器指令块直接执行 |
| 循环开销 | 每次循环都产生解释器堆栈和分发跳转损耗 | 消除循环体内的解释器跳转开销,硬件分支预测友好 |
| 编译内存占用 | 无额外代码生成内存占用 | 采用轻量级模板补丁技术,内存开销远低于 LLVM 等传统 JIT |
| 适用场景 | 快速退出的一次性小脚本、短作业 | 算法迭代、复杂文本处理、包含长运行循环的脚本 |
2.2 启用与验证 JIT 执行
如果当前使用的 Python 3.14 二进制构建版本开启了 JIT 支持,在执行长时计算脚本时,可通过指定运行参数或环境变量开启 Tier 2 JIT 加速:
# 方式 1:通过 -X 参数开启 JIT 优化
python3.14 -X jit heavy_calculation.py

# 方式 2:通过环境变量全局指定
export PYTHON_JIT=1
python3.14 heavy_calculation.py
在纯 Python 实现的密集数学计算或图遍历脚本中,开启 JIT 后执行耗时通常会有 5% 到 25% 的稳健改善。对于频繁进行 I/O 等待的脚本,该收益可能不明显,但 JIT 的低内存占用特性保证了脚本不会因为开启编译器而出现明显的内存暴涨。
三、并发突破:自由线程(Free-threaded)模式执行脚本
过去在 Python 中运行多线程脚本,多核 CPU 往往只能“一核有难,八核围观”,原因在于全局解释器锁(GIL)强制要求同一时刻只有一个操作系统线程执行 Python 字节码。Python 3.14 在自由线程构建(PEP 703)上更进一步,提供了高度可控的无 GIL 脚本执行环境。
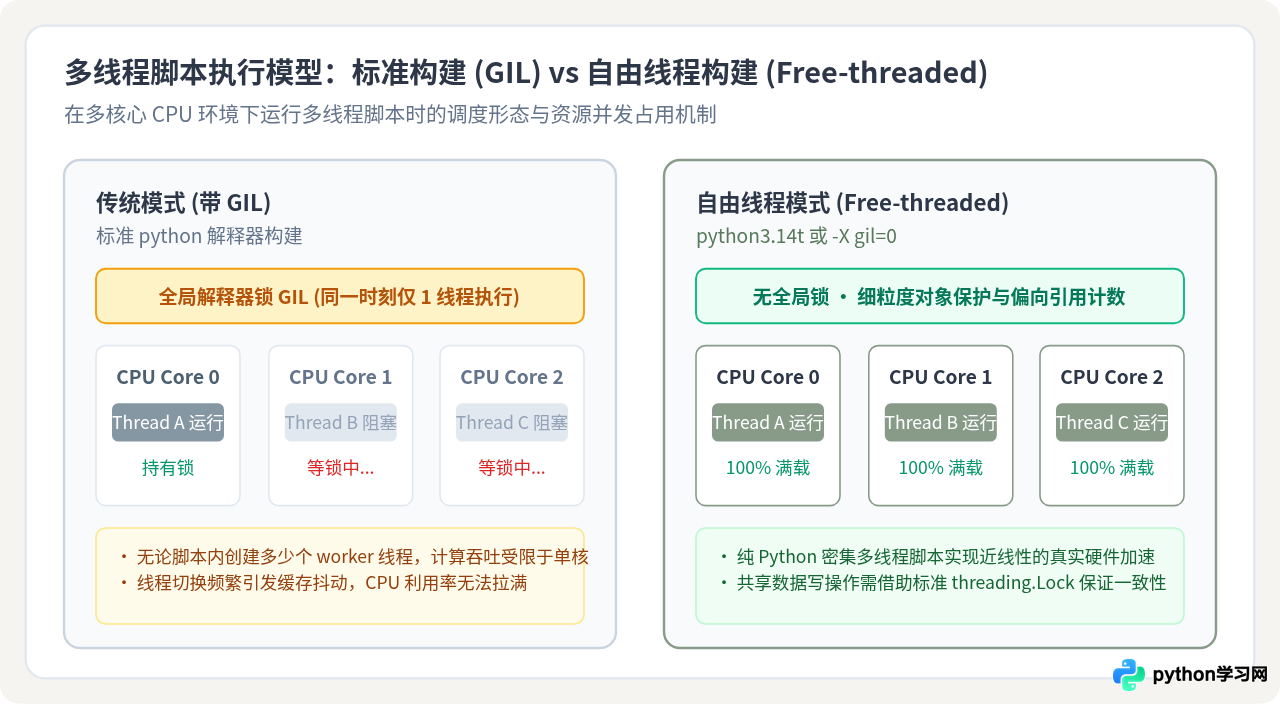
3.1 如何以无 GIL 状态运行脚本
在安装了自由线程版本(可执行文件通常命名为 python3.14t)后,可以通过命令行选项精准调控 GIL 的激活状态:
# 显式关闭 GIL 运行并发脚本
python3.14t -X gil=0 concurrent_worker.py

# 或者通过环境变量配置
PYTHON_GIL=0 python3.14t concurrent_worker.py
3.2 观察多核吞吐差异的测试脚本
编写一个标准的 Python 密集计算多线程脚本:
import sys
import threading
import time

def count_work(n):
    total = 0
    for i in range(n):
        total += i
    return total

if __name__ == "__main__":
    # 检查当前运行时 GIL 状态
    gil_status = getattr(sys, "_is_gil_enabled", lambda: True)()
    print(f"当前脚本运行环境:Python {sys.version.split()[0]} | GIL 激活状态: {gil_status}")

    threads = []
    start_time = time.perf_counter()
    for _ in range(4):
        t = threading.Thread(target=count_work, args=(15_000_000,))
        threads.append(t)
        t.start()

    for t in threads:
        t.join()

    elapsed = time.perf_counter() - start_time
    print(f"4 个线程并行计算总耗时: {elapsed:.3f} 秒")
# 1. 传统带 GIL 执行输出示例:
当前脚本运行环境:Python 3.14.0 | GIL 激活状态: True
4 个线程并行计算总耗时: 3.241 秒

# 2. 自由线程模式 (-X gil=0) 执行输出示例:
当前脚本运行环境:Python 3.14.0 | GIL 激活状态: False
4 个线程并行计算总耗时: 0.912 秒
-X gil=0 模式下执行脚本,虽然多线程 CPU 吞吐获得了真正的并行,但如果有共享的可变数据结构(如全局字典、列表的并发写入),必须按照并发编程规范显式使用 threading.Lock 互斥锁,避免引发竞态条件。
四、终端交互与错误诊断优化
除了底层性能提升,Python 3.14 在执行脚本报错时的人机交互体验也有显著升级:
4.1 彩色终端 Traceback 默认支持
在支持 ANSI 彩色的终端中运行脚本时,Python 3.14 默认启用了更醒目的彩色回溯提示(可通过 PYTHON_COLORS=0 禁用)。错误消息不仅用颜色区分文件名、行号与异常类型,还会用波浪线 ^^^^^^ 精确标注出哪一个子表达式导致了崩溃。
Traceback (most recent call last):
  File "data_pipeline.py", line 42, in process_record
    record_id = raw_payload["metadata"]["system"]["id"]
                ~~~~~~~~~~~~~~~~~~~~~~~^^^^^^^^^^
KeyError: 'system'
这种精确到列号的高亮提示,使得在面对深层字典解构或长链式调用(如 a.b().c[0].d)时,可以一眼看出是哪一个属性或键缺失,大幅减少了在脚本中打断点或加 print 排错的时间。
4.2 更低开销的执行监控(sys.monitoring)
Python 3.14 进一步优化了 sys.monitoring 接口的性能损耗。如果开发运维团队在生产环境使用 APM 工具(如 Datadog、OpenTelemetry 或自定义性能分析脚本)对执行中的脚本进行采样分析,新版本能将监控探针带来的性能惩罚降低到极小幅度,更适合高要求的自动化脚本作业。
五、脚本迁移与执行模式选择指南
面对 Python 3.14 带来的各项新特性,不同用途的脚本应该如何合理选择运行方式?下面的决策树梳理了推荐的适配路径:
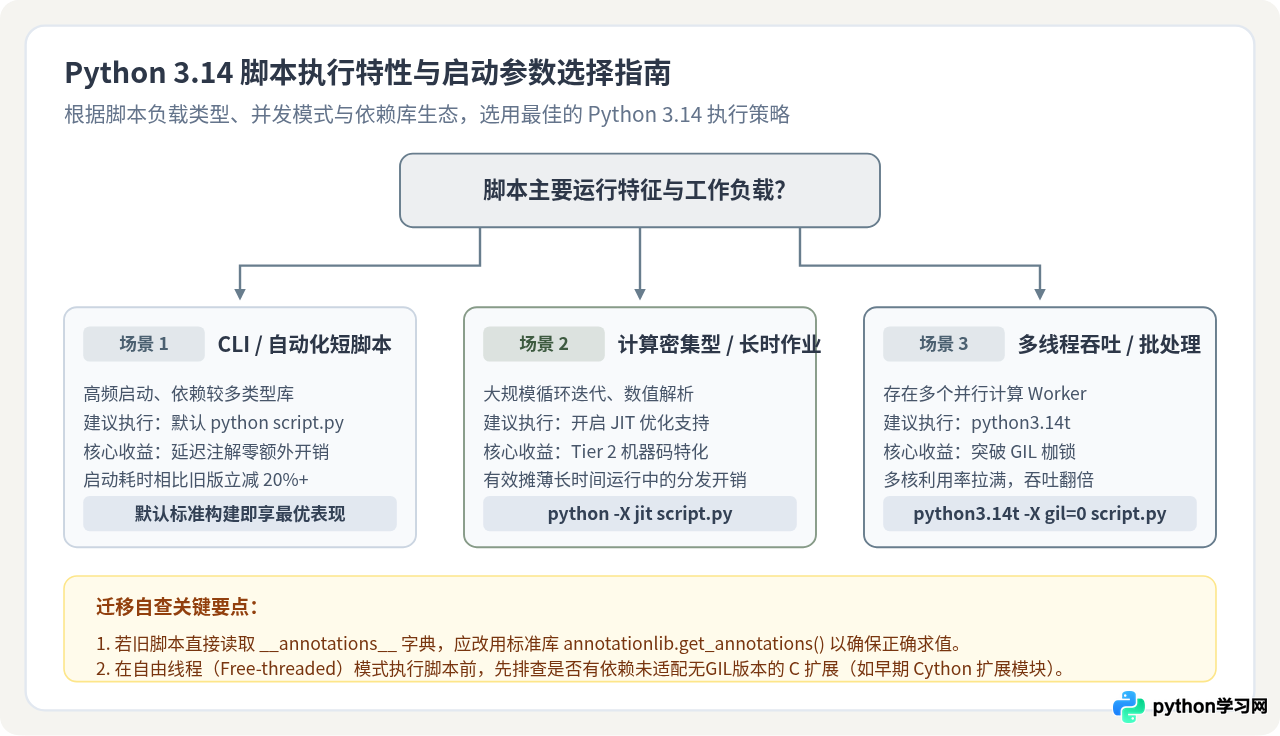
5.1 快速迁移排查清单
- 检查类型注解反射逻辑:搜索脚本中是否存在直接调用
func.__annotations__或getattr(obj, "__annotations__")的代码。如果有,建议统一重构成annotationlib.get_annotations(obj),以确保在延迟求值机制下获得一致的类型数据。 - 评估 JIT 开启收益:对于单次运行时间超过数秒的批处理脚本或算法脚本,在测试环境中尝试以
python -X jit script.py运行并压测,若吞吐有提升则可在生产启动命令中固化该参数。 - 谨慎引入 Free-threaded:若计划利用
python3.14t释放多核并发,先检查依赖的第三方 C 扩展模块(如部分未更新的 C 绑定库)是否已发布支持无 GIL 的轮子(wheels),避免因底层 C 扩展引发兼容性异常。
总体而言,Python 3.14 在执行脚本方面的改动兼顾了透明提速与架构突破:普通开发者即使不做任何代码修改,也能立即获得延迟注解求值带来的冷启动提速和更清晰的排错体验;而需要压榨硬件潜力的计算与并发脚本,则有了模板 JIT 与自由线程这两件强力武器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















