


Python爬虫开发的五个核心步骤详解
深入解析Python网络爬虫开发的五个核心步骤,从需求分析与数据源定位、构建网络请求、数据解析提取、清洗与持久化存储到异常处理与合规反爬,提供清晰完整的全流程实践指导。
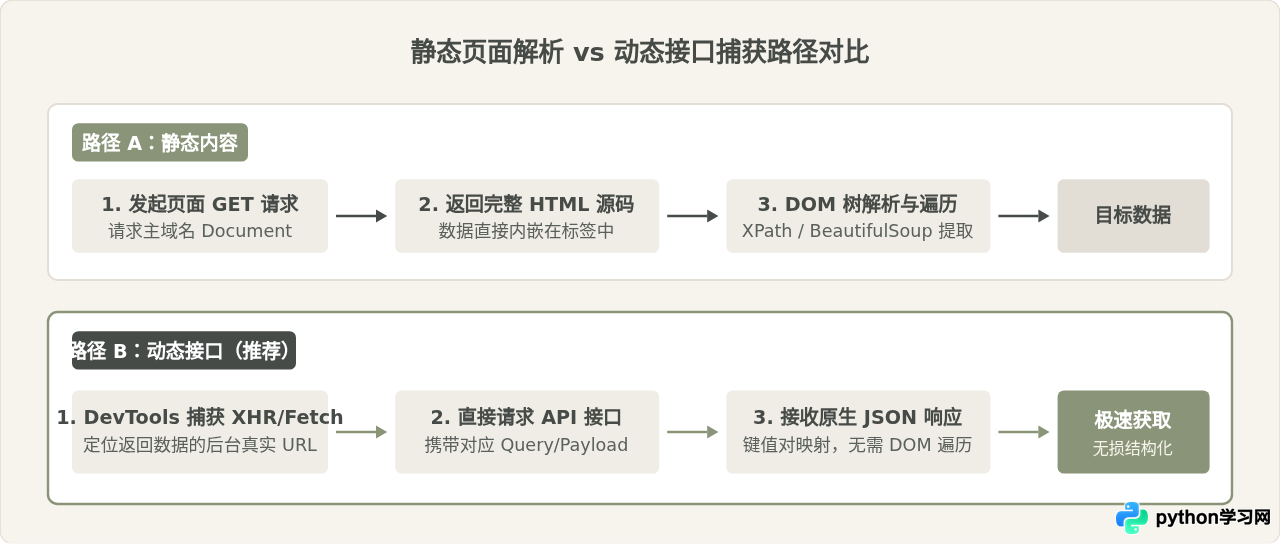
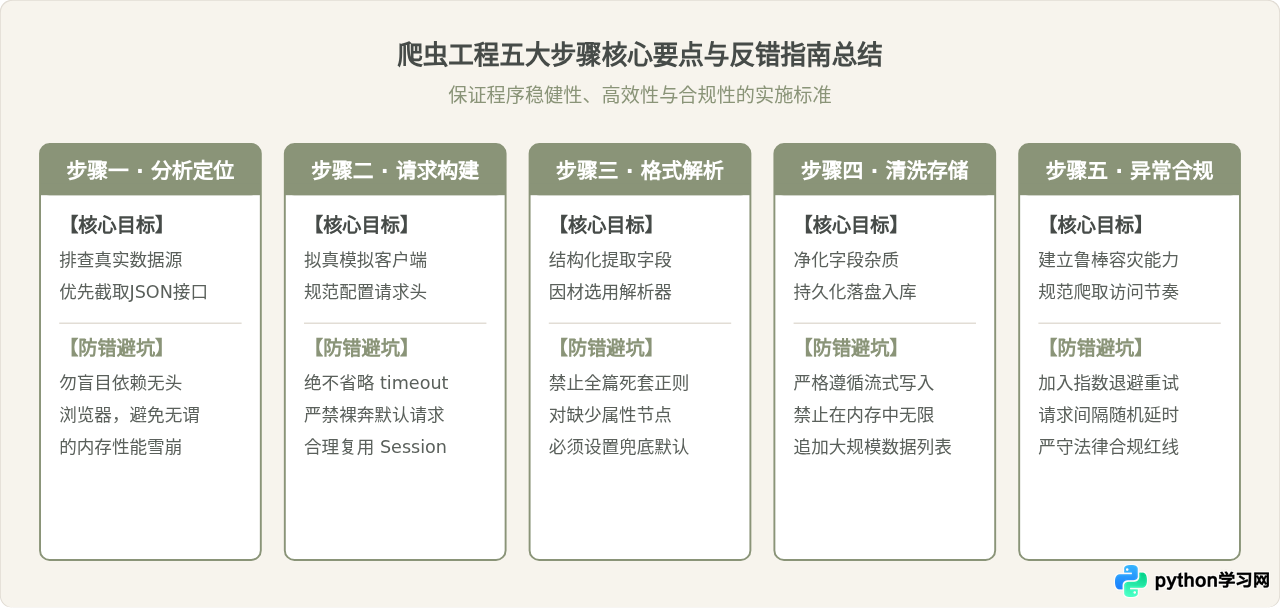
一个标准的 Python 网络爬虫程序,本质上是模拟客户端与目标服务器交互并有序提取目标信息的自动化流水线。无论数据采集任务的规模多大,稳健的爬虫工程都遵循一套成熟的实施路径:需求分析与数据源定位、构建并发送网络请求、**数据解析与结构化提取**、**数据清洗与持久化存储**,以及**异常处理与合规风控机制**。掌握这五个步骤的技术落地点与衔接逻辑,能够帮助开发者理清开发脉络,高效编写出鲁棒、可扩展的数据采集程序。
一、步骤一:目标分析与数据源定位
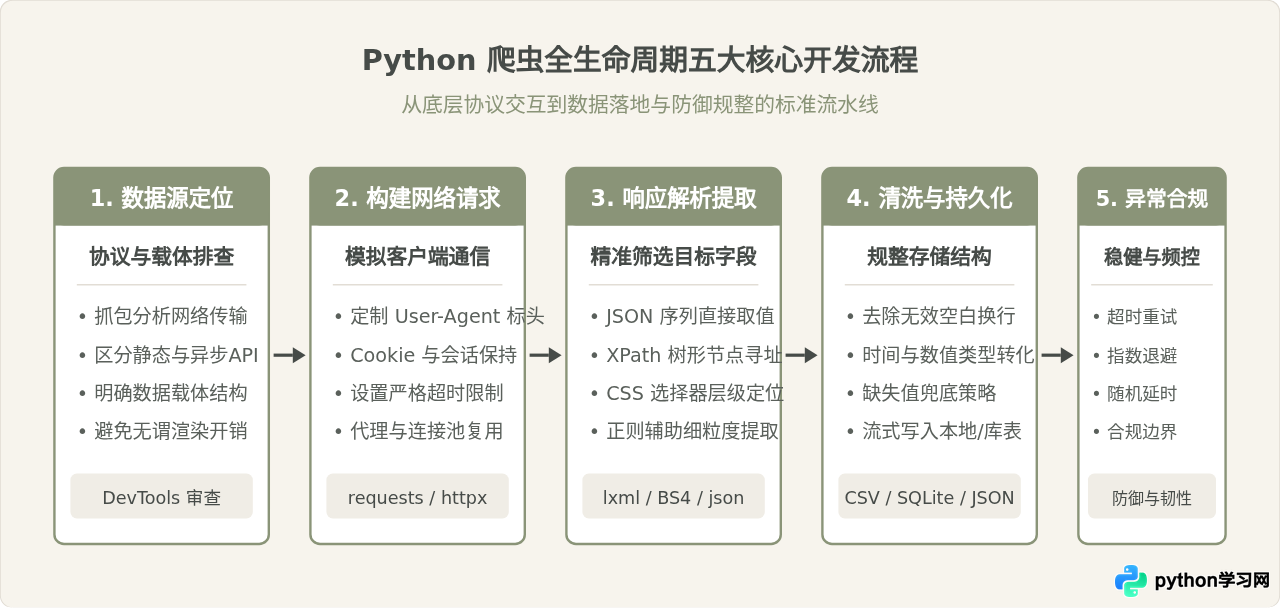
在写下任何一行爬虫代码之前,第一项也是最关键的工作是对目标页面进行逆向网络审查。目标分析的核心在于确定:读者想要提取的数据,究竟是以何种形式由服务器交付给客户端的。
打开浏览器的开发者工具(F12),切换至 Network(网络) 面板,刷新页面并观察数据包流动。现代 Web 页面主要分为两类数据交付方式:
- 服务端渲染(SSR)的静态页面:查看 Network 中的 Doc 类别,检查初始请求的响应内容。如果目标文字或表格直接包含在服务器返回的 HTML 源码内,说明属于静态内容,后续只需针对该 URL 发起常规 GET 请求。
- 客户端渲染(CSR)的动态页面:如果在原始 HTML 中搜索不到目标数据,说明页面是通过 JavaScript 异步加载数据后渲染进 DOM 的。此时应在 Network 面板中筛选
Fetch/XHR标签,滚动页面或点击翻页,寻找返回 JSON 格式纯数据的后台接口。
这种说法看似合理,因为自动化浏览器能够“所见即所得”地执行 JavaScript、加载所有页面元素,省去了分析网络请求的过程。但在工程实践中,该理解必须进行修正:
自动化浏览器启动时需要加载排版引擎、执行 CSS 渲染与图片下载,内存消耗通常是轻量 HTTP 库的数十倍,抓取速度要慢 10 至 50 倍以上。因此,直接定位并调用底层的 Fetch/XHR 接口才是最高效的首选方案;只有当目标站点存在高度复杂的动态加密参数、前端指纹对抗且逆向成本不可承受时,无头浏览器才作为兜底手段使用。
二、步骤二:构建网络请求与会话交互
确定了数据来源后,第二步是通过 Python 的 HTTP 客户端库(主流为 requests 或异步的 httpx)构建出符合目标服务器期待的请求包。
服务器往往具备基础的安全防护措施,能够识别缺失浏览器特征的裸请求。构建请求时,必须重点关注以下三个核心要素:
- 请求头伪装(Headers):至少配置合法的
User-Agent,防止被直接识别为 Python 脚本工具;若抓取防盗链资源或 API,还应补充Referer、Origin以及Accept-Language。 - 会话机制(Session):如果需要登录或者在多次请求间保留 Cookie、复用底层 TCP 链接以减少 TLS 握手耗时,务必使用
requests.Session()对象。 - 显式超时控制(timeout):Python 的
requests默认不设超时,若目标服务器由于网络拥塞挂起连接,脚本将无限期阻塞等待。生产环境中必须显式指定timeout=(连接超时, 读取超时)。
import requests

def create_crawler_session() -> requests.Session:
    """初始化配置完善的爬虫会话对象"""
    session = requests.Session()
    session.headers.update({
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    })
    return session

def fetch_page_content(session: requests.Session, url: str) -> str:
    """发送请求并获取响应文本,加入显式超时约束"""
    try:
        response = session.get(url, timeout=(5.0, 15.0))
        # 针对常见中文网页编码进行自动校正
        if response.encoding.lower() == "iso-8859-1":
            response.encoding = response.apparent_encoding
        response.raise_for_status()
        return response.text
    except requests.exceptions.RequestException as e:
        print(f"[错误] 请求发生异常: {url}, 原因: {e}")
        return ""
三、步骤三:数据解析与结构化提取
当网络请求成功返回内容后,程序获得的是未经筛选的原始文本(HTML 字符串或 JSON 文本)。第三步的任务是运用恰当的解析器,定位并抽取具体业务字段(如标题、发布时间、价格、正文)。
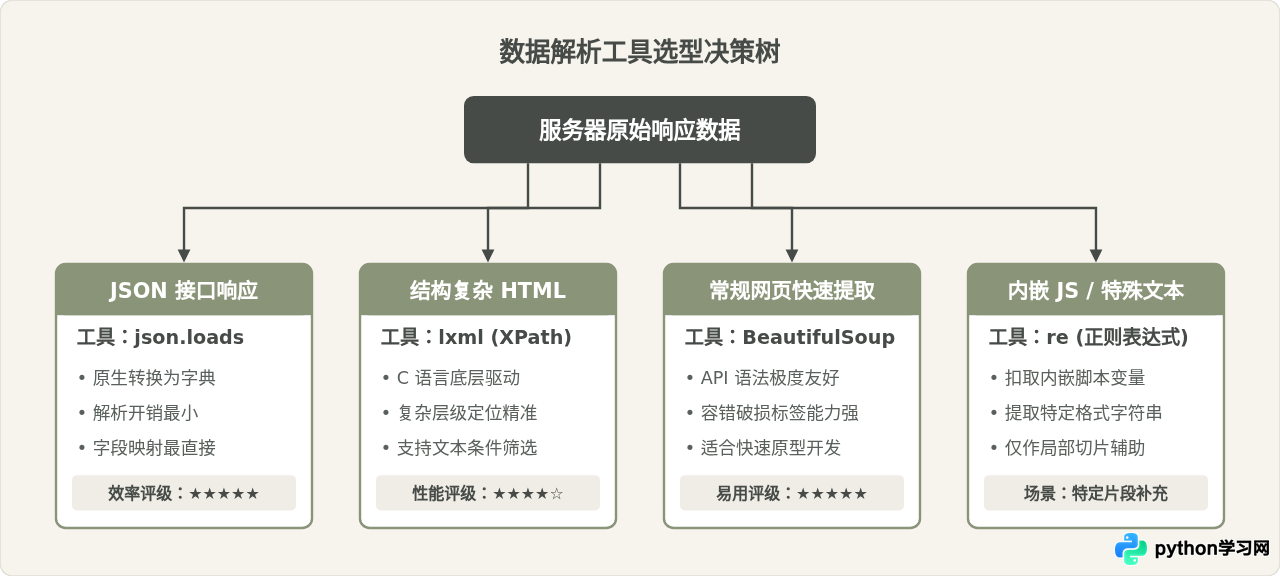
Python 生态提供了多种解析方案,面对不同的数据源形态,合理的选型策略能够大幅提升开发效率与运行性能:
- 内置
json库 /response.json():适用于前面通过接口捕获的 JSON 响应,直接映射为 Python 字典或列表,执行效率最高,开发最为直观。 lxml结合 XPath:对于标准 HTML 页面,lxml基于 C 语言底层实现,解析速度极快。XPath 路径语法(如//div[@class="item"]//h3/text())支持向上追溯父级与同级轴寻址,在复杂树形结构中表现出色。BeautifulSoup4:语法极具人性化,容错能力极高,能够自动修复格式残缺的 HTML。搭配lxml解析内核时兼顾了易用性与速度。- 正则表达式
re:用于局部辅助匹配。当页面将某些全局状态变量(如window.__INITIAL_STATE__ = {...})序列化在<script>标签中时,先用正则扣出该 JSON 字符串,再交给json.loads()解析。
这种想法在提取单一特定字段时看似可行,但在处理整篇 HTML 文档时极易失效。HTML 是典型的上下文无关文法驱动的树状嵌套结构,标签的属性排列顺序、单双引号混用、换行空格以及属性缺失具有极大的不确定性。全量使用正则表达式解析网页不仅表达式极其冗长脆弱,而且目标站点一旦微调前端排版就会全部报错。对于 HTML,始终优先采用 DOM 树解析器(XPath 或 CSS 选择器)。
from bs4 import BeautifulSoup
from lxml import etree

def parse_html_with_xpath(html_text: str) -> list[dict]:
    """使用 lxml 与 XPath 提取文章列表字段"""
    tree = etree.HTML(html_text)
    items = []

    # 获取每个文章卡片容器节点
    article_nodes = tree.xpath('//article[contains(@class, "post-card")]')
    for node in article_nodes:
        # 使用相对路径 ./ 提取子节点内容,并提供默认空列表防止下标越界
        title_list = node.xpath('.//h2/a/text()')
        link_list = node.xpath('.//h2/a/@href')
        time_list = node.xpath('.//time/@datetime')

        title = title_list[0].strip() if title_list else "无标题"
        link = link_list[0].strip() if link_list else ""
        pub_time = time_list[0].strip() if time_list else ""

        items.append({
            "title": title,
            "link": link,
            "pub_time": pub_time
        })
    return items
四、步骤四:数据清洗与持久化存储
从 DOM 树或接口中直接拿出的字段往往包含首尾空格、冗余换行符、HTML 实体字符(如 )以及不规范的时间格式。第四步的任务是将脏数据清洗规整为标准数据类型,并将其持久化到存储介质中。
清洗工作通常包含以下关键动作:
- 文本净化:利用字符串操作或正则,剔除多余的制表符、换行符和无意义 HTML 标签;
- 类型规范化:将抓到的价格字符串(如
"¥199.00")去除货币符号并转换为浮点数float,将计数转换为整数int;将相对时间(如"3小时前")统一换算为 ISO 8601 标准日期时间格式; - 缺省值填补:遇到部分字段缺失的条目时,必须设置合理的默认值(如
None或空字符),严禁导致整条数据处理中断。
在持久化阶段,严禁把抓到的所有数据保存在内存列表里直到全部抓完才一次性写入。当抓取规模达到数万条以上时,一旦程序因网络中断崩溃,未持久化的数据将全部丢失,且长时间常驻内存易引发 OOM 异常。标准做法是**边抓边存(流式持久化)**:
import csv
import json
from typing import Iterable, Mapping

def append_to_csv(file_path: str, fieldnames: list[str], row: dict):
    """增量流式写入 CSV 文件,自动判断表头创建"""
    import os
    file_exists = os.path.exists(file_path)

    with open(file_path, mode="a", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if not file_exists:
            writer.writeheader()
        writer.writerow(row)

def append_to_json_lines(file_path: str, record: dict):
    """以 JSON Lines 格式逐行追加数据,具备极高的追加容错性"""
    with open(file_path, mode="a", encoding="utf-8") as f:
        line = json.dumps(record, ensure_ascii=False)
        f.write(line + "\n")
五、步骤五:异常处理与合规风控机制
网络环境存在天然的不确定性,服务器可能临时过载、连接发生抖动,或站点触发了防刷频机制返回 HTTP 429。第五步是为爬虫程序装配**容错重试**与**合规控制**,使其能够长期稳定运行。
1. 网络抖动与异常重试(指数退避)
当遇到网络连接超时或短暂的 5xx 状态码时,直接报错退出是极其脆弱的。成熟的做法是采用指数退避(Exponential Backoff)重试机制:首次失败等待 1 秒重试,二次失败等待 2 秒,三次等待 4 秒,重试超过上限后记录日志并跳过该项,保证任务整体不中断。
2. 频率控制与礼貌抓取
爬虫切忌使用无限制的并发循环连续发起请求。高频请求不仅会瞬间消耗目标站点的服务器带宽与 CPU,极易被防火墙直接封禁 IP,还可能对正常用户的访问造成干扰。必须在每次请求之间加入随机延时(如 time.sleep(random.uniform(1.0, 3.0)))。
3. 合规边界与 robots.txt 规范
开发爬虫必须尊重数据主权与法律边界:遵守目标站点的 robots.txt 协议中规定的禁止爬取目录;严禁抓取涉及用户隐私、商业机密等未经授权的个人数据;严禁在交易或抢票等高负载业务接口上进行攻击性抓取。
import time
import random
import requests

def robust_fetch(url: str, max_retries: int = 3) -> str:
    """具备指数退避重试与随机频控延时的健壮请求函数"""
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0 Safari/537.36"
    }

    for attempt in range(1, max_retries + 1):
        try:
            # 引入 1.0 ~ 2.5 秒的随机延时,平滑请求频次
            time.sleep(random.uniform(1.0, 2.5))

            response = requests.get(url, headers=headers, timeout=10.0)
            if response.status_code == 200:
                return response.text
            elif response.status_code in (429, 500, 502, 503, 504):
                # 状态码提示限流或服务端故障,进入指数退避
                backoff_time = (2 ** attempt) + random.uniform(0.1, 1.0)
                print(f"[警告] 收到状态码 {response.status_code},正在进行第 {attempt} 次重试,等待 {backoff_time:.1f} 秒...")
                time.sleep(backoff_time)
            else:
                print(f"[失败] 收到客户端不可恢复状态码 {response.status_code},终止重试。")
                break
        except (requests.exceptions.Timeout, requests.exceptions.ConnectionError) as e:
            backoff_time = (2 ** attempt) + random.uniform(0.1, 1.0)
            print(f"[超时] 网络连接抖动: {e},等待 {backoff_time:.1f} 秒后重试...")
            time.sleep(backoff_time)

    return ""
六、工程总结
Python 爬虫的开发并非零散代码片段的拼凑,而是一项包含网络探测、协议交互、数据解析、流式持久化与异常防御的完整工程实践。
将开发逻辑清晰划分为数据源定位、网络请求构建、格式解析提取、清洗与流式存储及异常合规风控五个阶段,有助于我们在面对不同形态的站点时迅速建立解决路径,避免在技术选型上走弯路,开发出兼具高执行效率与卓越稳定性的自动化数据采集系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















