


python必背源代码多线程threading代码
精选Python多线程threading核心必背源代码模板,涵盖Thread函数创建、面向对象封装、Lock互斥锁同步以及Queue生产者消费者队列等实用模式与完整运行示例。
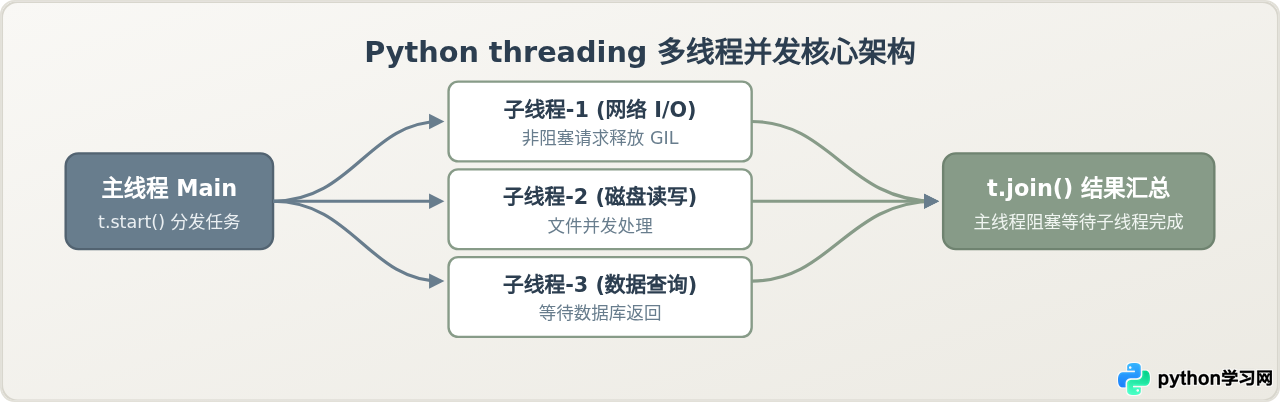
threading 模块是处理网络请求、文件读写和数据库批量查询等 I/O 密集型并发任务的基础工具。在 CPython 解释器的全局解释器锁(GIL)机制下,多线程虽无法在多核 CPU 上实现纯算力的并行运算,但在等待 I/O 阻塞时会自动让出执行权限,从而大幅削减整体等待耗时。掌握 Thread 基础调用、面向对象继承封装、Lock 互斥锁同步以及 Queue 生产者-消费者通信四套核心模板代码,即可覆盖绝大多数日常多线程开发场景。
一、基础起手式:函数式创建与等待结束(Thread + join)
在 Python 中启动一个子线程最直接的方式,是将一个现有的普通函数作为目标参数传递给 threading.Thread。通过 target 参数指定函数名,通过 args 元组传递位置参数,随后调用 start() 让操作系统调度执行,最后通过 join() 保证主线程在子线程工作彻底完成前保持等待。
很多初学者容易遗漏 join() 调用。如果主线程没有执行 join(),主程序会直接越过子线程继续向下执行;若主进程结束,可能导致未完成的子线程被强制中断或输出错位。规范的代码模式必然是“批量创建并启动、统一列表收集、循环逐个调用 join()”。
import threading
import time

def download_file(filename, delay):
    """模拟耗时下载任务的执行函数"""
    print(f"[{threading.current_thread().name}] 开始下载: {filename}")
    time.sleep(delay)
    print(f"[{threading.current_thread().name}] 下载完成: {filename}")

if __name__ == "__main__":
    tasks = [
        ("report_a.pdf", 2),
        ("data_b.csv", 1),
        ("image_c.png", 3),
    ]

    threads = []
    start_time = time.time()

    # 1. 批量实例化并启动线程
    for name, delay in tasks:
        t = threading.Thread(
            target=download_file,
            args=(name, delay),
            name=f"Worker-{name.split('.')[0]}"
        )
        threads.append(t)
        t.start()

    # 2. 阻塞主线程,等待所有任务彻底结束
    for t in threads:
        t.join()

    total_cost = time.time() - start_time
    print(f"全部文件下载完毕,总耗时: {total_cost:.2f} 秒")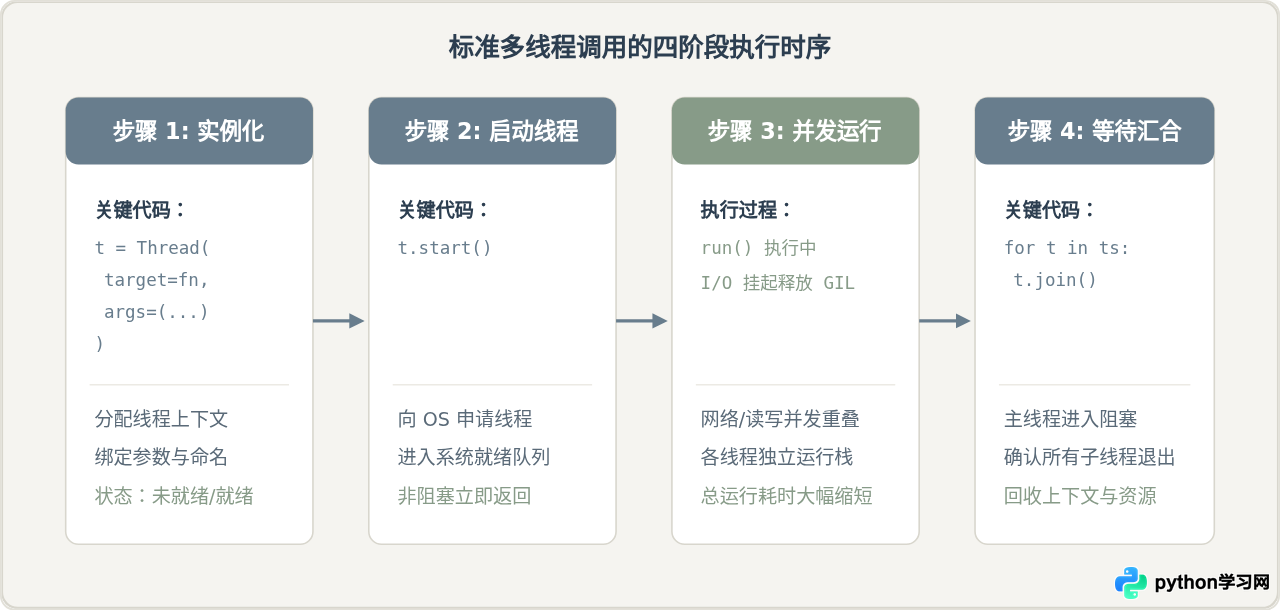
二、两种构建方式对比:函数传参 vs 继承 Thread 类
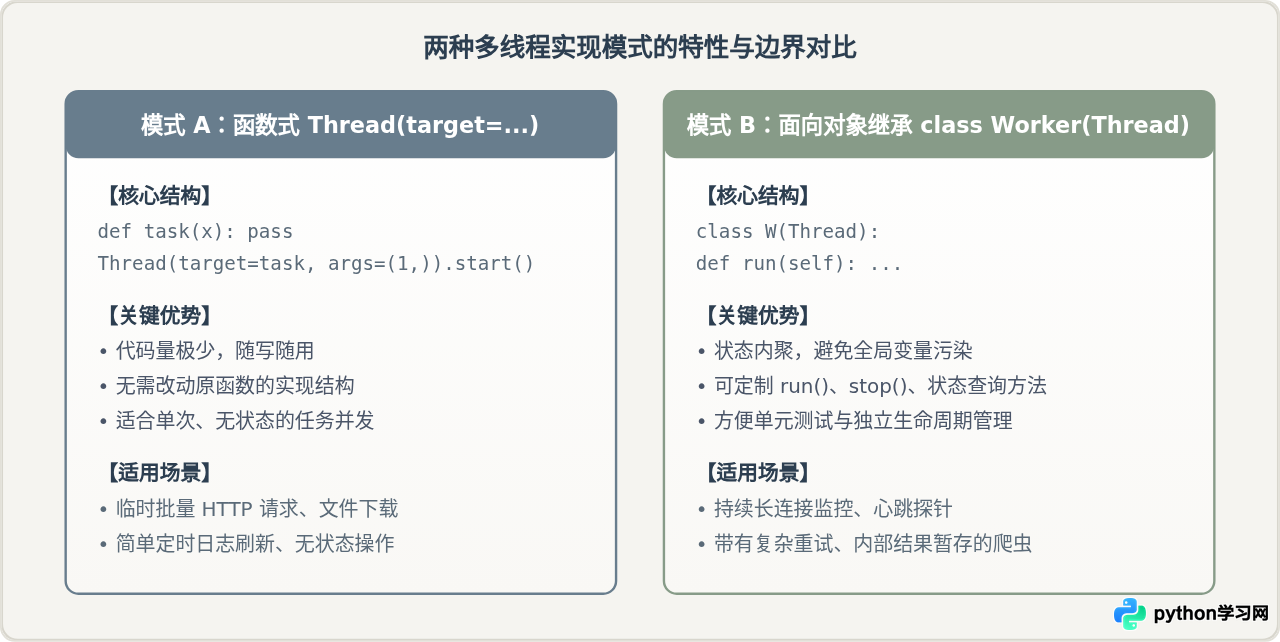
在编写多线程代码时,主要有两种设计方式:一种是上一小节展示的直接向 threading.Thread 传递函数对象的“函数传参模式”;另一种是自定义一个继承自 threading.Thread 的类并重写 run() 方法的“面向对象继承模式”。理解两者的关键差异,有助于在面对不同业务规模时做出合理的结构选择。
两种方式的底层调度机制完全一致,但在状态管理与逻辑解耦上有明显区别:
- 函数传参模式(轻量解耦):逻辑简单直观,适合已有独立函数的快速包装。不需要为了并发而重构已有代码,但如果要让线程记录内部执行状态(例如重试次数、错误日志、中间结果),通常必须依赖外部可变对象或闭包,稍有不慎容易引发变量污染。
- 继承 Thread 类模式(高内聚封装):把线程需要的参数、连接句柄、执行状态和重试机制封装在类的属性中,实例本身就是一个完整的作业执行器。对于需要长生命周期维护状态或封装复杂生命周期钩子的场景,可读性和维护性更高。
以下是使用继承方式实现自包含状态的完整代码模板。重写 __init__ 时,必须显式调用 super().__init__() 初始化基类线程属性:
import threading
import time

class APIChecker(threading.Thread):
    """继承 Thread 类封装带有状态和重试机制的探针线程"""
    def __init__(self, endpoint_url, timeout=2):
        super().__init__()
        self.endpoint_url = endpoint_url
        self.timeout = timeout
        self.success = False
        self.elapsed = 0.0

    def run(self):
        """线程核心工作逻辑:覆写 run 方法"""
        t0 = time.time()
        print(f"[{self.name}] 正在探测端点: {self.endpoint_url}")
        # 模拟 I/O 网络请求延迟
        time.sleep(self.timeout)
        self.elapsed = round(time.time() - t0, 3)
        self.success = True
        print(f"[{self.name}] 探测完成,耗时: {self.elapsed}s")

if __name__ == "__main__":
    targets = [
        "https://api.example.com/v1/auth",
        "https://api.example.com/v1/users",
        "https://api.example.com/v1/orders",
    ]

    workers = [APIChecker(url, timeout=1.5) for url in targets]

    # 依次启动
    for w in workers:
        w.start()

    # 依次等待
    for w in workers:
        w.join()

    # 直接从实例内部读取采集结果
    print("=== 所有探测结果采集完成 ===")
    for w in workers:
print(f"URL: {w.endpoint_url} | 状态: {'成功' if w.success else '失败'} | 耗时: {w.elapsed}s")三、线程同步与数据安全:threading.Lock 的正确用法
由于同一个进程内的所有线程共享堆内存空间,一旦多个线程并发修改同一个变量(如全局计数器、字典或列表),就会产生竞态条件(Race Condition)。即使在具有 GIL 的 CPython 解释器中,看似只有一行的 count += 1 操作,在底层虚拟机中其实拆分为三个字节码指令:LOAD_GLOBAL(读取当前值)、BINARY_ADD(加 1)、STORE_GLOBAL(写回变量)。如果在这三个操作之间发生了线程调度切换,最终计算结果就会严重小于预期。
解决共享资源并发修改的标准手段是使用 threading.Lock。推荐始终使用 Python 上下文管理器语法 with lock:,它能在进入临界区前自动调用 lock.acquire(),并在无论正常退出还是抛出异常时都能自动调用 lock.release(),彻底杜绝死锁风险。
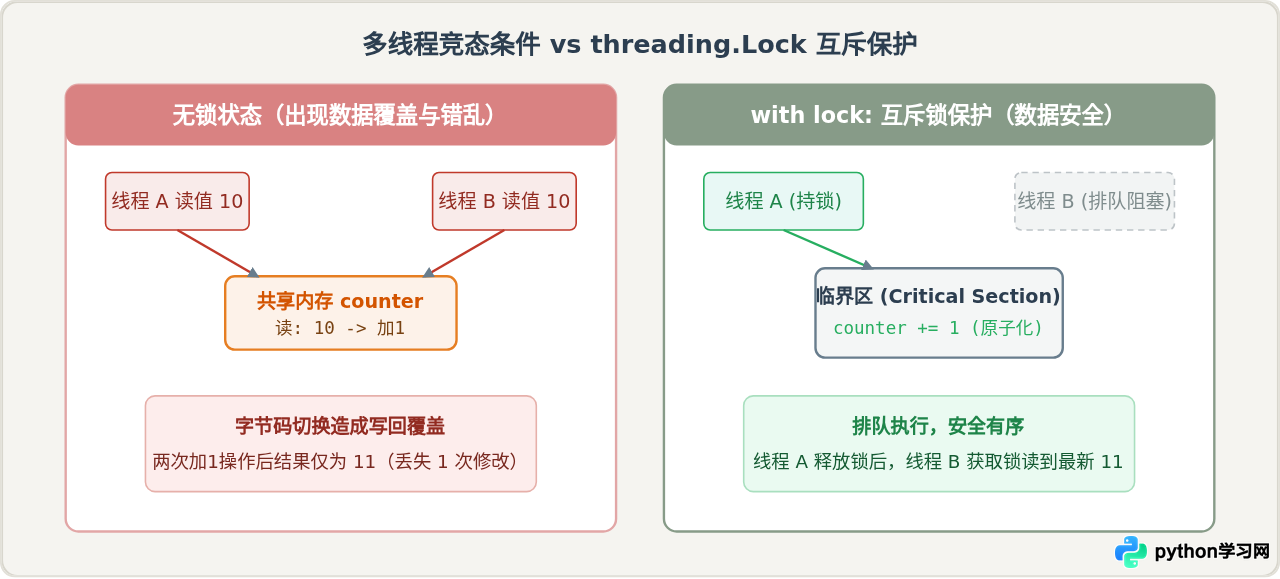
下面是多线程高并发累加的对比验证模板。通过互斥锁保护,无论线程数和循环次数如何增加,最终计数均能精准吻合:
import threading

counter = 0
lock = threading.Lock()

def safe_increment(iterations):
    """使用互斥锁保护共享变量的自增函数"""
    global counter
    for _ in range(iterations):
        # 使用 with 语句自动获取与释放锁
        with lock:
            counter += 1

if __name__ == "__main__":
    threads = []
    thread_count = 5
    iters_per_thread = 100000

    for i in range(thread_count):
        t = threading.Thread(target=safe_increment, args=(iters_per_thread,))
        threads.append(t)
        t.start()

    for t in threads:
        t.join()

    expected = thread_count * iters_per_thread
    print(f"实际计算结果: {counter}")
    print(f"预期目标结果: {expected}")
print(f"数据一致性校验: {'通过' if counter == expected else '失败'}")四、生产者-消费者解耦:结合 queue.Queue 传递数据
在实际工程中,频繁手动使用 Lock 管理列表或字典容易因锁粒度设计不当导致死锁或性能瓶颈。Python 官方推荐的标准解耦方式是结合 queue.Queue(线程安全队列)构建生产者-消费者模型。
queue.Queue 内部已经封装好了所有的互斥锁与条件变量,在多个线程同时 put() 放入任务或 get() 取出任务时,无需用户手动编写任何加锁代码。结合 daemon=True(守护线程)机制,子工作线程在主线程完成时会自动随主进程退出,防止后台线程因阻塞在 get() 上导致程序挂起无法终止。
import threading
import queue
import time

# 实例化线程安全队列,可设置最大容量防止内存无节制占用
task_queue = queue.Queue(maxsize=10)

def producer(q, total_items):
    """生产者:生成任务并推入队列"""
    for item_id in range(1, total_items + 1):
        task_name = f"Task-{item_id}"
        q.put(task_name)  # 若队列满则自动阻塞等待
        print(f"[生产者] 生产任务: {task_name} (当前排队: {q.qsize()})")
        time.sleep(0.1)

def consumer(q, worker_id):
    """消费者:持续从队列提取任务并处理"""
    while True:
        task_name = q.get()  # 若队列空则自动阻塞等待
        print(f"  [消费者-{worker_id}] 正在处理: {task_name}")
        time.sleep(0.25)     # 模拟任务处理耗时
        q.task_done()        # 关键通知:向队列声明当前单元工作已完成

if __name__ == "__main__":
    total_tasks = 6
    num_consumers = 2

    # 1. 启动消费者工作线程(设置为守护线程,主进程结束时自动释放)
    for cid in range(1, num_consumers + 1):
        t = threading.Thread(target=consumer, args=(task_queue, cid), daemon=True)
        t.start()

    # 2. 启动单生产者线程
    prod_thread = threading.Thread(target=producer, args=(task_queue, total_tasks))
    prod_thread.start()

    # 3. 等待生产者推完所有任务
    prod_thread.join()

    # 4. 等待队列中全部任务的 task_done() 确认信号
    task_queue.join()
print("所有队列任务均已处理完毕,主程序正常退出。")五、threading 必背代码速查与关键避坑清单
为了在实际开发中快速定位多线程代码模块,以下是常用的关键 API、适用场景与选型决策总结:
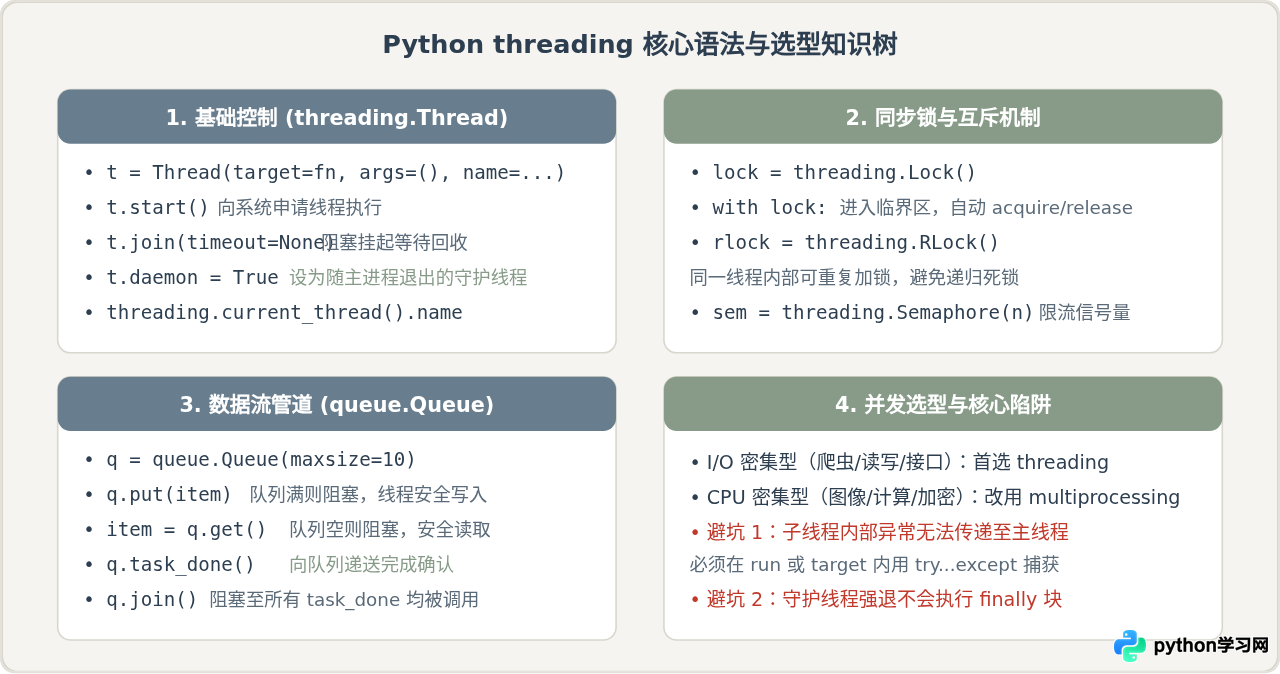
- 子线程异常隔离:子线程中抛出的未捕获异常只会打印报错并退出当前子线程,不会自动抛向主线程中断主程序。如需收集异常,应在子线程函数内部通过
try...except捕获并将异常对象放入队列或实例属性中。 - 守护线程(daemon=True)文件写入风险:当主线程结束时,所有仍存活的守护线程会被操作系统直接无情销毁,其
finally块甚至文件缓存刷盘(flush)都不会被保证执行。因此涉及文件写入、数据库提交的业务线程切勿盲目设为守护线程,必须使用t.join()优雅等待关闭。 - CPU 密集型勿用多线程:在 CPython 中,单纯进行科学计算、矩阵乘法或大数运算的多线程程序不仅不会提速,还会因 GIL 争抢和上下文切换开销导致运行比单线程更慢。此类场景请直接使用
multiprocessing模块或concurrent.futures.ProcessPoolExecutor。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















