


Python中print和return有什么区别?新手常见误区解答
深入解析Python中print与return的核心区别,通过直观图解、代码示例与典型新手误区拆解,彻底理清终端输出与函数返回值的运作机制。
很多刚学习 Python 的新手在写函数时,经常会产生这种困惑:明明在函数里面用 print() 把结果打印出来了,为什么把函数赋值给变量之后,变量却变成了 None?为什么拿这个变量继续做加减乘除会直接报错?或者反过来,写了 return 却发现屏幕上什么动静都没有。
这种混淆源于对“数据流向”的误解。本文将通过图解与典型实例,拆解 print 和 return 的底层机制与运作流程,并逐一解答初学者最容易踩中的三大认知误区。
一、本质区别:数据究竟流向了哪里?
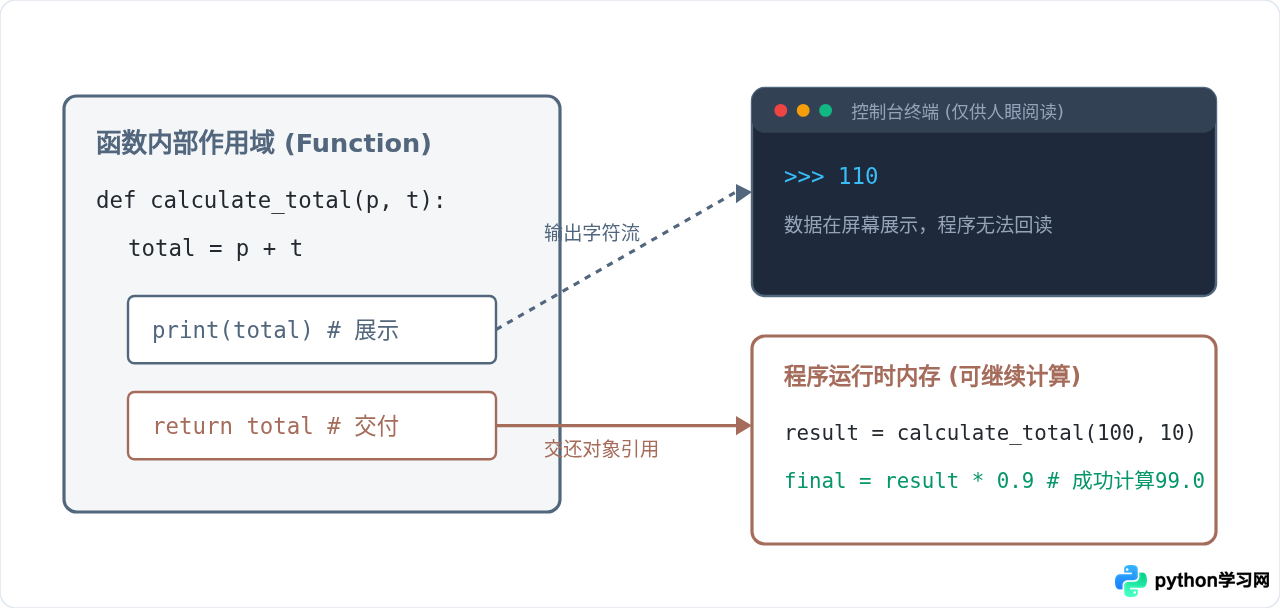
理解两者区别的关键,在于看清函数执行完毕后,数据到底交给了谁。
当你在函数内调用 print(x) 时,Python 只是把变量 x 转换成字符串文本,推送到标准输出流(通常就是你的控制台终端屏幕)。屏幕把字符渲染出来供人眼阅读。一旦渲染完成,这串文字在程序世界里就“消失”了——后续代码没有任何机制能把屏幕上的这串字抓回来当作数字或列表参与运算。
而 return x 则是把 x 所代表的对象直接从函数调用栈中“送出”,交回给调用这个函数的语句。你可以用变量稳稳接住它,或者把它作为参数继续传进下一个函数中。
二、核心机制:返回值与控制流
除了去向不同,它们对函数内部代码的执行控制也有根本差异。
1. 函数的默认返回值:None
在 Python 中,每一个函数都有返回值。如果你在函数体中没有显式写 return 语句,或者只写了一个空的 return,Python 会在函数执行到最后一行时隐式返回一个特殊对象:None。
print() 本身也是一个内置函数。它负责将传入的参数打印到终端,而它自己的返回值就是 None。
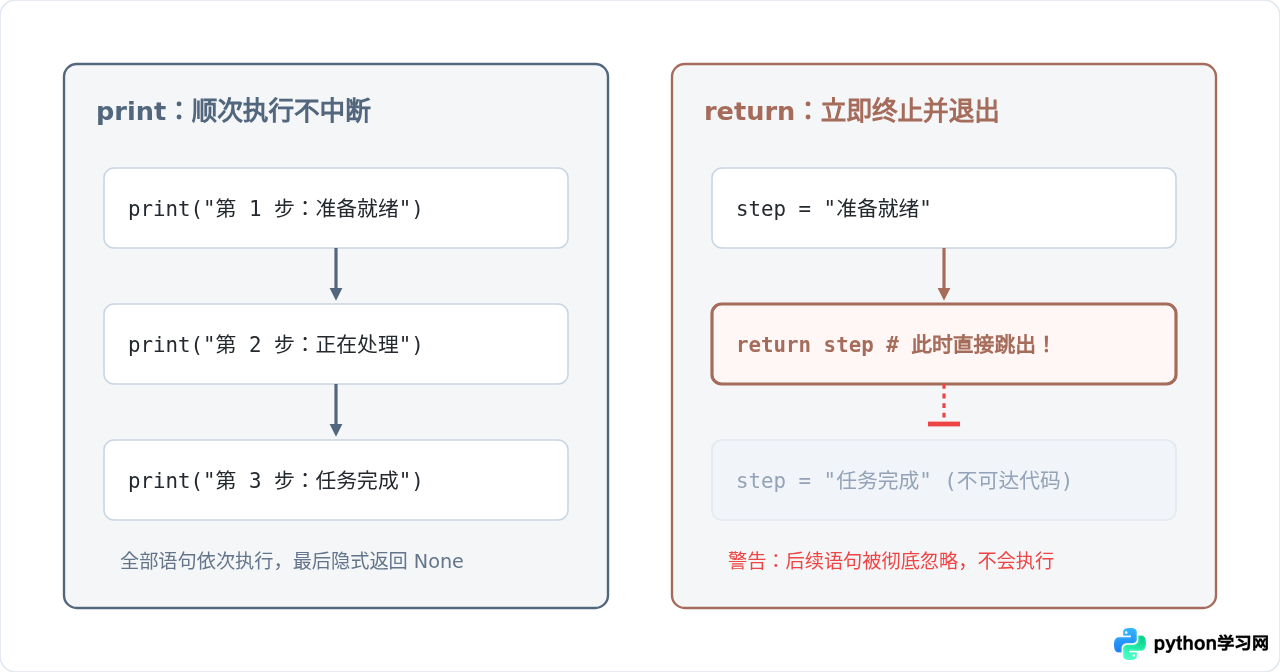
2. return 具有“立即终结”特性
一旦函数遇到 return 语句,它会立即计算返回表达式的值,并将控制权交还给调用处,同时退出当前函数。位于 return 之后的任何代码语句都将被跳过,根本不会被执行。
相反,print() 仅仅是一个普通的函数调用,打印结束后,程序会毫不停留地继续向下执行下一行代码。
三、新手最常见的三个误区拆解
误区一:把 print 当作运算产出,导致 TypeError: NoneType
这是 Python 初学阶段最高频的报错诱因之一。请观察以下代码:
# 错误示例:只在函数内 print,没有写 return
def add_numbers(a, b):
    print(a + b)

# 调用函数并试图把结果存入变量
result = add_numbers(5, 3)
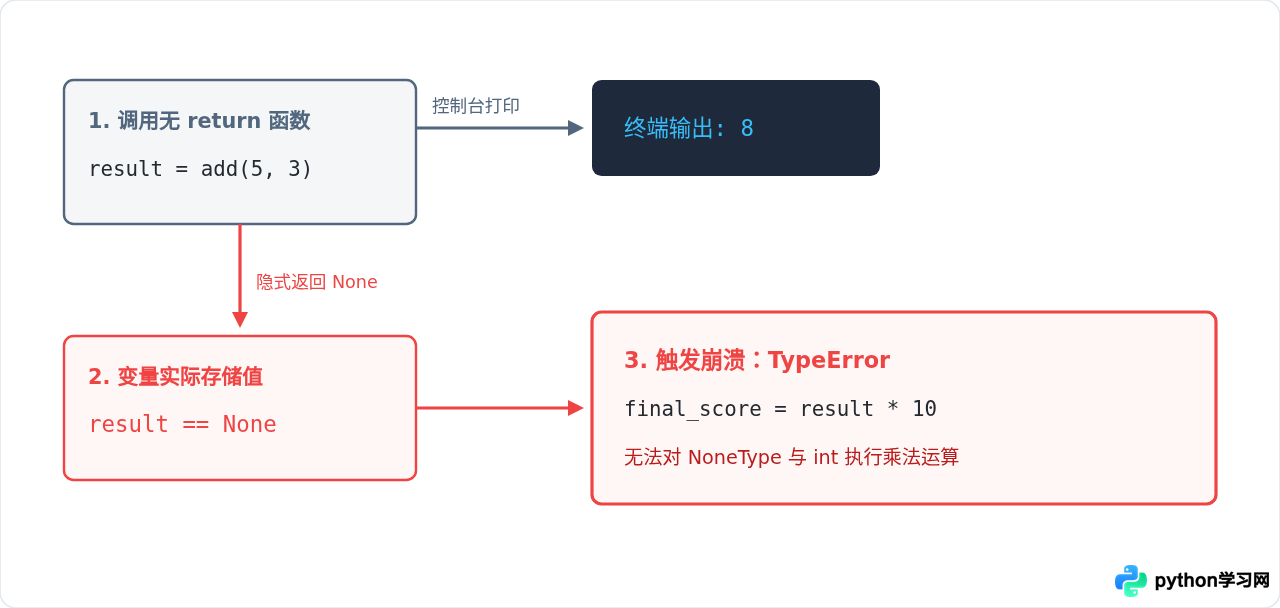
final_score = result * 10很多新手会纳闷:“终端明明打印了 8,说明加法算对了,为什么第 7 行说 result 是 NoneType?”
原因就在于:屏幕上打印的 8,是 add_numbers 内部的 print(a + b) 执行时的输出效果;而函数本身并没有写 return,所以 add_numbers(5, 3) 这个表达式的返回值其实是 None。因此,变量 result 实际接收到的是 None。当程序试图让 None 和整数 10 做乘法运算时,Python 解释器自然会抛出 TypeError。
如果后续需要继续使用计算结果,必须显式使用 return:
def add_numbers(a, b):
    return a + b  # 显式返回计算值

result = add_numbers(5, 3)
final_score = result * 10  # 正常运算,final_score 为 80
误区二:在脚本文件中写了 return,误以为屏幕会自动显示
另一个反向误区常见于从命令行交互界面(REPL / Jupyter Notebook)转向编写独立 .py 脚本的新手。
在 Python 交互式命令行(终端敲 python 后的 >>> 提示符)中,当你直接输入一个表达式(例如 add_numbers(5, 3)),交互环境会自动把表达式的求值结果打印出来展示。但这只是交互环境为了方便调试提供的自动回显特性。
一旦你把代码写入 script.py 脚本并通过 python script.py 命令在终端运行时,单纯的 return 只会默默地完成数值交付,控制台不会产生任何输出。如果你希望在终端看到结果,必须显式调用 print() 将返回值打印出来:
def get_greeting(name):
    return f"你好,{name}!"

# 错误做法(在脚本中执行该文件,控制台一片空白):
get_greeting("小明")

# 正确做法(显式打印返回的数据):
message = get_greeting("小明")
print(message)  # 此时终端才会输出:你好,小明!
误区三:在 return 后面写代码,误以为还会执行
正如前面控制流部分所述,return 是函数的终点线。任何写在 return 同级或后续无条件分支中的代码,都是永远无法触达的死代码(Dead Code)。
def calculate_discount(price):
    if price > 100:
        return price * 0.8
    else:
        return price * 0.9

    # 下面这行代码永远不会执行,因为前面的 if-else 必然会触发某一个 return
    print("折扣计算完成")
如果你需要在函数退出前记录日志或查看状态,必须把 print() 语句放置在 return 之前。
四、对比速查与使用场景决策
为了在实际开发中不再选错,可以通过以下维度矩阵快速对照:
| 对比维度 | print() | return |
|---|---|---|
| 核心定位 | 输出工具 / 交互展示 | 语言语法关键字 / 数据流转 |
| 数据去向 | 标准输出设备(屏幕终端) | 函数调用处(保存在内存变量中) |
| 对函数流程的影响 | 不影响流程,继续向下执行 | 立即终结函数执行并跳出 |
| 是否可在函数外使用 | 可以,能在任何代码位置调用 | 不可以,只能在 def 函数内部使用 |
| 后续代码可用性 | 不可用(屏幕文字无法回读) | 完全可用(支持赋值、传递、链式调用) |
| 典型使用场景 | 临时调试变量、命令行交互提示、程序运行进度汇报 | 业务计算处理、数据转换提取、API逻辑封装 |
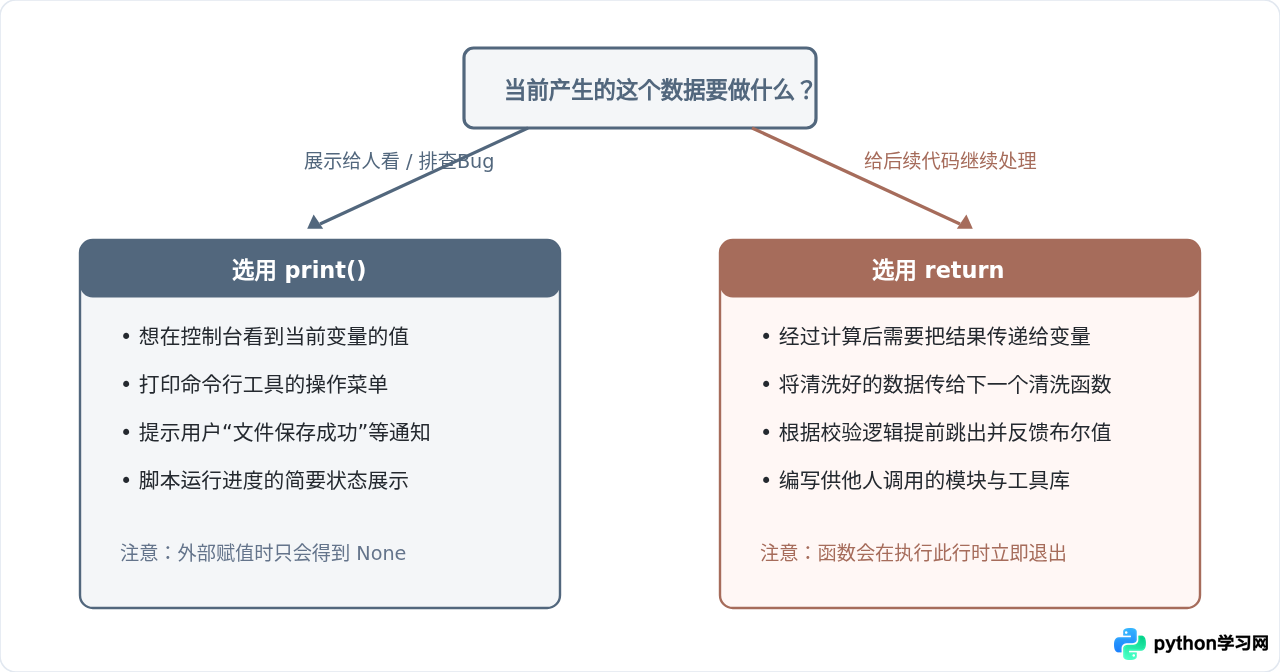
五、编写健壮函数的实用习惯
在编写高质量可复用代码时,推荐养成以下习惯:
- 业务函数尽量保持“纯净”:负责数据处理、业务计算的函数应当专注于使用
return产出数据,不要在函数内部滥用print()。这样可以让函数更易于测试、被其他模块导入复用。 - 将展示与计算分离:让专门负责计算的函数返回值,把
print()留在主程序入口(例如if __name__ == '__main__':代码块)中负责展示。 - 调试完成后清理 print:开发排查问题时插入的临时
print(),在确认逻辑无误后应及时删除,或者使用标准库中的logging模块进行分级日志管理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















