


Python读取超大CSV文件的性能优化与分块处理技巧
针对几GB乃至几十GB超大CSV文件导致Python内存溢出(OOM)的问题,系统讲解基于Pandas chunksize的分块迭代处理、usecols与dtype内存深度优化、PyArrow引擎加速及Polars流式计算技巧。
当处理体积达到数GB乃至几十GB的CSV文件时,使用 pandas.read_csv() 直接载入极易触发系统的 MemoryError 导致程序崩溃。解决这一问题的根本路径不是盲目升级物理内存,而是转变数据载入模型:通过分块迭代读取(chunksize)实现内存恒定常数级占用,结合精确列裁剪(usecols)与数据类型压缩(dtype)降低解析开销,并在高算力需求场景下引入新一代高性能分析引擎。
一、超大CSV读取中的内存瓶颈根源
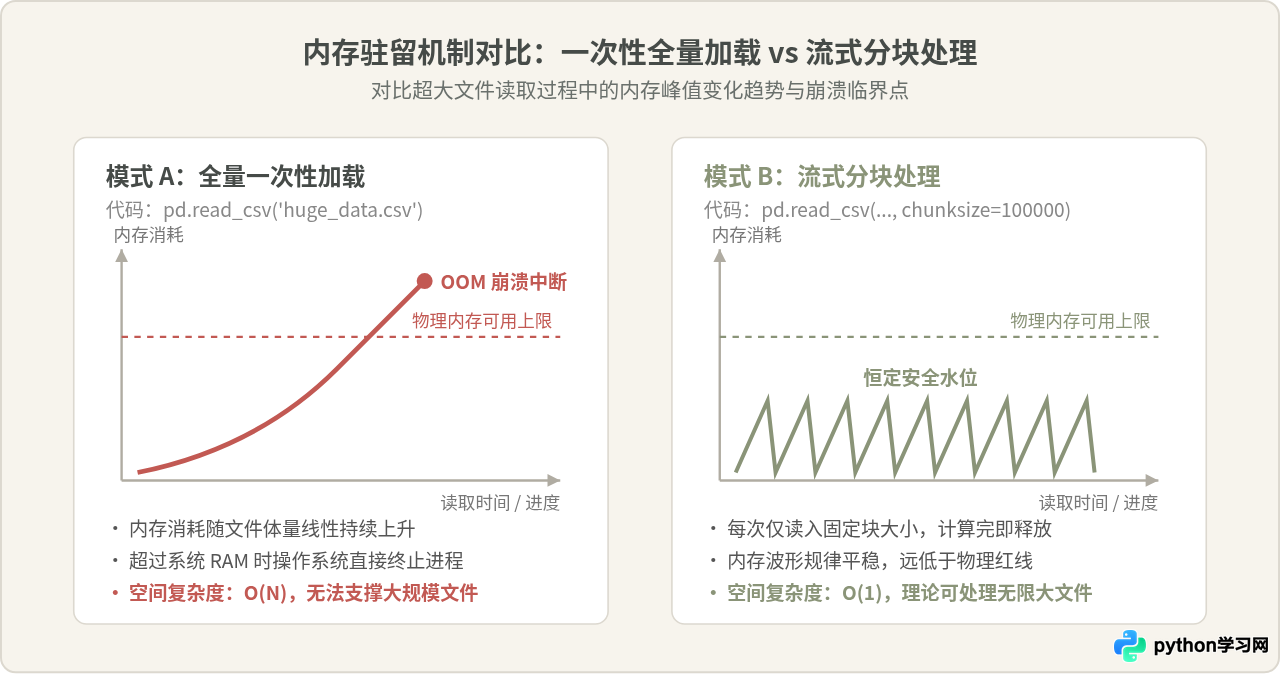
在默认情况下,Pandas 的 read_csv 会尝试将整张表格的所有行与所有列一次性读入操作系统物理内存。由于纯文本格式的 CSV 在解析为内存对象时会伴随显著的体积膨胀(通常在内存中的占用是原始磁盘文件的 2 到 5 倍),一个 4GB 的 CSV 文件往往需要 10GB 以上的可用内存才能完成加载。
更关键的原因在于 Pandas 默认的自动类型推断机制。在未指定数据类型时,Pandas 会读取前段数据推断列类型,字符串列会被解析为通用的 object 类型。每个 object 本质上都是一个独立的 Python 字符串指针与堆内存对象,伴随着大量的指针开销和内存碎片,使得内存占用呈爆炸式增长。
二、核心技巧:使用 Pandas chunksize 进行分块迭代与流水线聚合
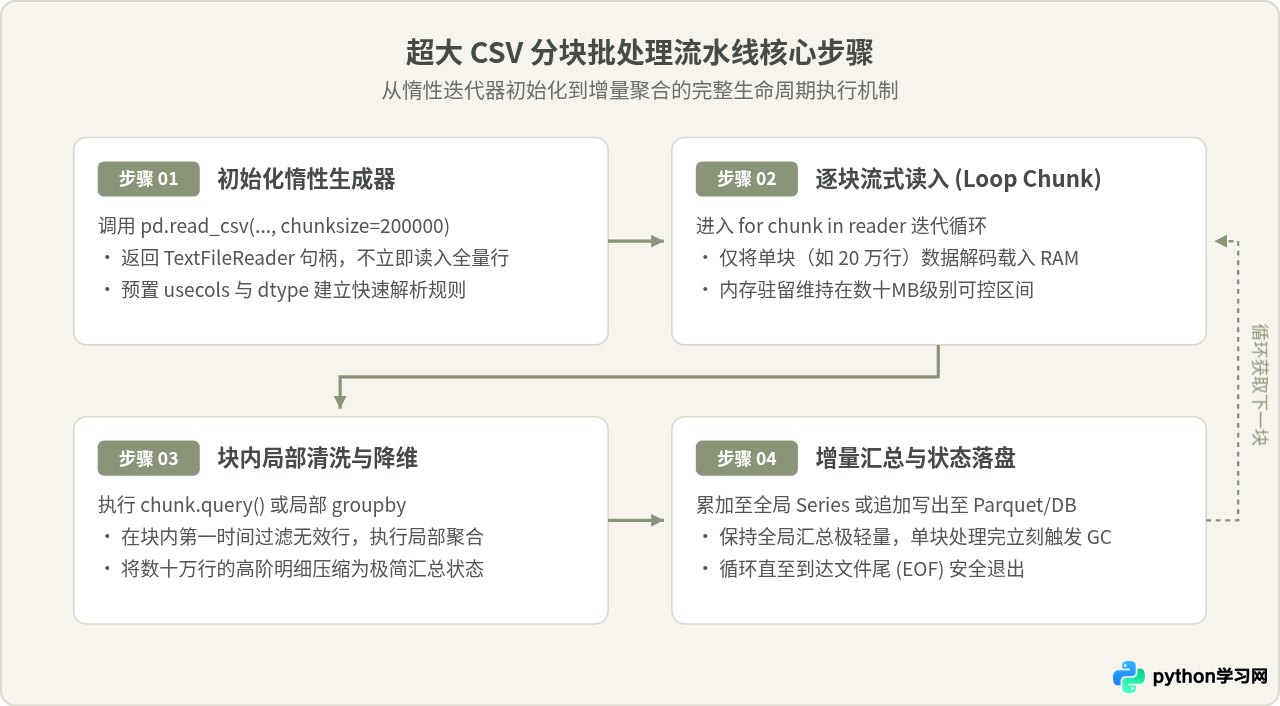
Pandas 内置了对分块读取的原生支持。当在 pd.read_csv() 中指定 chunksize 参数后,该函数不再返回完整的 DataFrame,而是返回一个可迭代的 TextFileReader 对象。通过 Python 的标准迭代循环,程序可以在恒定的内存空间内逐批消化数据。
1. 增量聚合模式实战
分块处理中最常见的场景是统计汇总。例如,我们需要从一个包含几千万行交易记录的 CSV 中,按“所属城市”统计总交易额。如果将整个文件载入再做 groupby,极易发生内存溢出。正确的做法是在每个块内做局部聚合,然后累加到全局结果中:
import pandas as pd

csv_file = "massive_transactions.csv"
chunk_size = 200_000  # 每次读入20万行

# 初始化全局结果累加容器
city_revenue = pd.Series(dtype="float64")

# 使用 with 语句确保读取完毕后及时关闭文件句柄
with pd.read_csv(
    csv_file,
    chunksize=chunk_size,
    usecols=["city", "amount"],
    dtype={"city": "category", "amount": "float32"}
) as reader:
    for chunk_idx, chunk in enumerate(reader, start=1):
        # 1. 过滤异常脏数据
        valid_chunk = chunk[chunk["amount"] > 0]

        # 2. 块内局部聚合(将数十万行瞬间压缩为少数城市汇总)
        local_summary = valid_chunk.groupby("city", observed=False)["amount"].sum()

        # 3. 增量累加至全局汇总
        city_revenue = city_revenue.add(local_summary, fill_value=0.0)

print("处理完成,各城市总金额:")
print(city_revenue)
2. 常见误区辨析:只要加了 chunksize,读取速度就会变快吗?
这是一个容易混淆的认知误区。分块处理核心解决的是空间复杂度(内存峰值),而不是时间复杂度(运行耗时)。
事实上,如果分块过小(例如设置 chunksize=1000),由于频繁创建成千上万个小 DataFrame 对象,伴随频繁的 Python 解释器循环和 I/O 切换开销,代码的总运行时间通常比一次性读取还要慢上数倍。只有当分块大小设置合理(通常在 10 万到 50 万行之间),既保证单块数据能充分利用 CPU 缓存与向量化计算,又将内存峰值严格压制在可用 RAM 之内时,才能达到内存安全与执行效率的最佳平衡点。
3. 分块批量清洗后追加落盘 (Append Mode)
若任务目标是对超大 CSV 进行格式清洗并转换存储(如转存至 SQLite 数据库或 Parquet 列式存储),可以采用批量追加模式,避免在内存中拼接大列表:
import pandas as pd
import sqlite3

db_conn = sqlite3.connect("cleaned_storage.db")
csv_file = "raw_server_logs.csv"

# 分批将清洗结果写入数据库
with pd.read_csv(csv_file, chunksize=150_000) as reader:
    for i, chunk in enumerate(reader):
        # 清洗逻辑:剔除空值并转换时间戳
        chunk = chunk.dropna(subset=["user_id"])
        chunk["created_at"] = pd.to_datetime(chunk["created_at"])

        # 首次创建表结构,后续批次使用 append 追加
        chunk.to_sql(
            name="user_events",
            con=db_conn,
            if_exists="append" if i > 0 else "replace",
            index=False
        )

db_conn.close()
三、在读取前做减法:列裁剪与数据类型深度优化
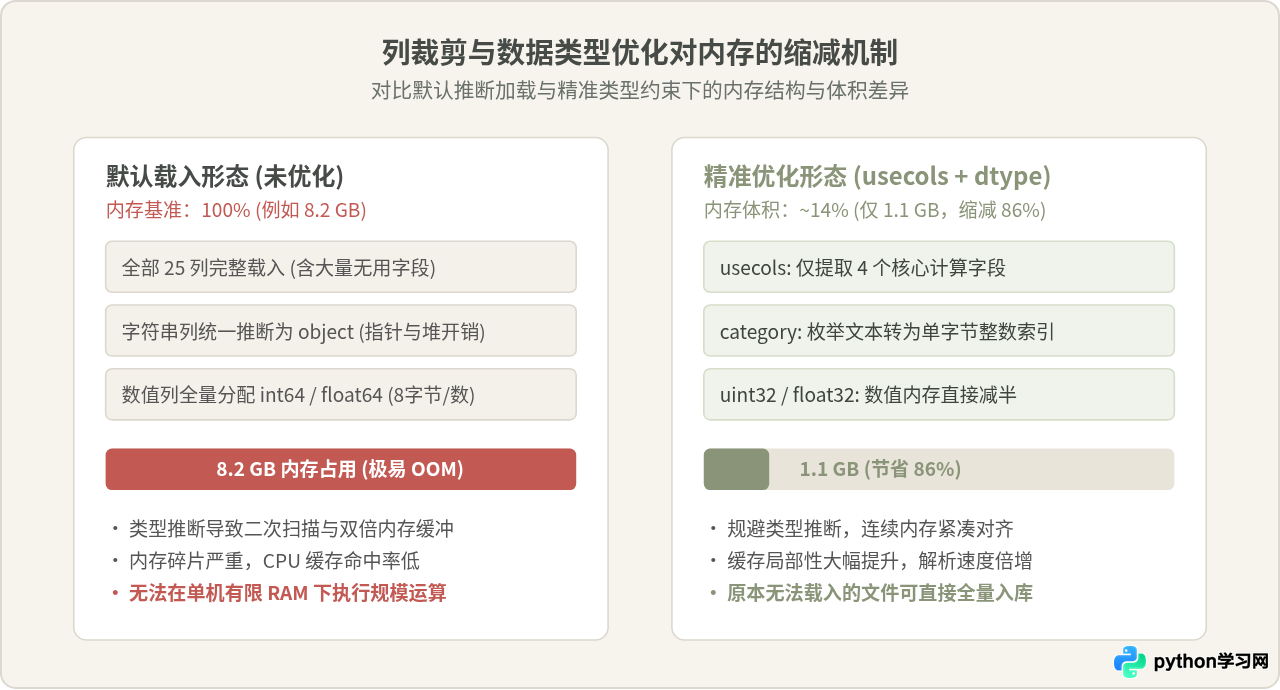
除了分块之外,在很多场景下,仅通过合理设置 usecols 和 dtype,就能让原本 OOM 的大文件直接缩减 70%~85% 的内存占用,甚至能够直接全量安全载入。
1. 使用 usecols 丢弃无用字段
宽表通常包含几十个字段,但具体业务可能只需要其中的 3 到 5 列。在读取阶段指定 usecols,底层的 C 解析引擎会在扫描阶段跳过未选中的列,既减少了磁盘 I/O 数据流,又彻底阻断了非必要字段进入内存:
# 仅解析分析所需的 3 列,忽略其余无用字段
required_columns = ["order_id", "status", "payment_amount"]
df = pd.read_csv("transactions.csv", usecols=required_columns)
2. 使用 dtype 替换默认类型与 category 压缩
Pandas 默认将整数解析为 int64(8 字节),浮点数解析为 float64(8 字节),文本字符串解析为 object。针对这些字段进行紧凑化重构,具有极高的优化收益:
- 小范围数值:如果 ID 或数值的最大值在合理范围内,可显式指定为
uint32(4 字节)、int16(2 字节)或float32(4 字节)。 - 重复率高的分类文本:例如状态("PAID", "FAILED")、性别、省份、平台名等低基数字符串,转换为
category类型。底层仅保存一张映射表与整数索引,能将字符串内存降低 80% 以上。
| 原始字段形态 | Pandas 默认推断 | 优化后的指定 dtype | 单条记录内存缩减 |
|---|---|---|---|
| 小范围正整数 (如年龄、状态码 0~255) | int64 (8 字节) |
uint8 (1 字节) |
-87.5% |
| 一般业务 ID (如 1 ~ 40 亿之间) | int64 (8 字节) |
uint32 (4 字节) |
-50.0% |
| 通用浮点金额、打分 | float64 (8 字节) |
float32 (4 字节) |
-50.0% |
| 有限状态枚举 ("PENDING", "SUCCESS") | object (通常 > 50 字节) |
category (1~2 字节索引) |
-80% ~ -95% |
四、低层工具与现代引擎升级:超越原生 Pandas
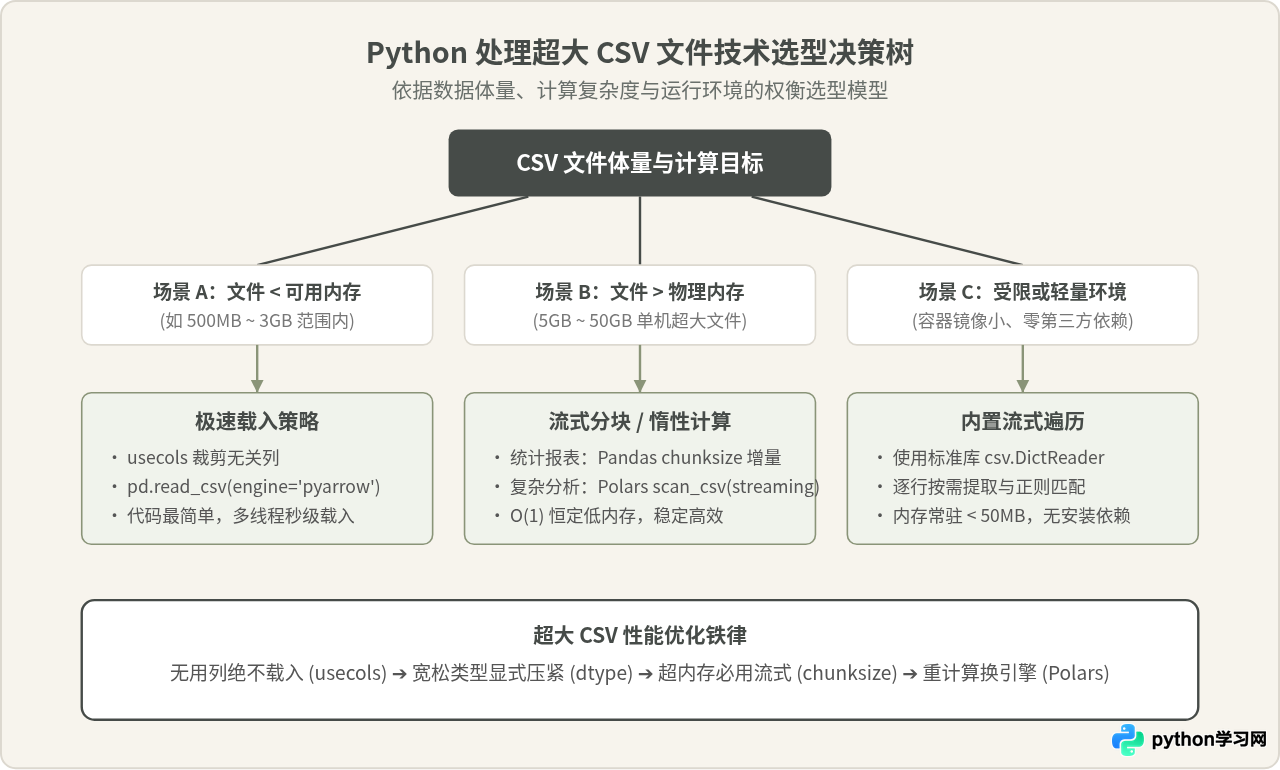
当 CSV 已经达到 10GB 以上,或者对读取耗时有更高要求时,除了 Pandas 自身的分块之外,还可以借助以下更轻量或更高性能的工具:
1. 零依赖轻量方案:Python 内置 csv 模块
对于极为简单的逐行过滤或字段计数任务,完全不需要引入 Pandas 这样庞大的框架。Python 标准库自带的 csv 模块是纯粹的字符流迭代器,内存开销几乎为零:
import csv

match_count = 0
# 内置 csv.reader 按行流式扫描,内存常驻仅几十KB
with open("massive_access.log.csv", mode="r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        if row["status"] == "500" and "api/v1" in row["path"]:
            match_count += 1

print(f"500 异常请求总数: {match_count}")
2. 引擎加速:PyArrow 后端引擎
在较新版本的 Pandas 中,内置了基于 C++ 开发的 pyarrow 解析后端。相比传统 C 解析器,PyArrow 支持多线程并行扫描文件,解析速度大幅提升:
# 启用 pyarrow 引擎与类型后端
df = pd.read_csv(
    "large_dataset.csv",
    engine="pyarrow",
    dtype_backend="pyarrow"
)
3. 新一代流式引擎:Polars 惰性流式计算 (Streaming)
如果需要在超大文件上执行多表关联(Join)、窗口函数或复杂排序,Pandas 的分块手动汇总会非常繁琐。此时,基于 Rust 开发的 Polars 是更理想的现代选择。Polars 支持 惰性查询(LazyFrame) 与 流式计算(Streaming Engine),它能在底层自动将大文件切分成流式数据块并在多核 CPU 上并行计算:
import polars as pl

# scan_csv 仅扫描元数据,构建逻辑执行计划,不立即加载数据
query = (
    pl.scan_csv("massive_orders.csv")
    .select(["user_id", "status", "price"])
    .filter(pl.col("status") == "COMPLETED")
    .group_by("user_id")
    .agg([
        pl.col("price").sum().alias("total_spent"),
        pl.col("price").count().alias("order_count")
    ])
)

# collect(streaming=True) 自动开启流式引擎,在极小内存下完成分布式级别运算
result = query.collect(streaming=True)
print(result.head())很多开发者一旦遇到 20GB 的 CSV,就认为必须搭建 Spark 集群或导入专用数据库。实际上,在单台配备 16GB 内存的现代计算机上,结合 Polars 流式模式 或 Pandas chunksize,完全有能力在几分钟内跑完 50GB 甚至 100GB 的单机数据流水线。过早引入分布式架构不仅带来高昂的维护成本,在网络传输与序列化开销下的处理速度往往还不如单机流式处理。
五、避坑指南与健壮性保障
在实际分块生产环境中,除了内存控制之外,超大文件往往伴随着格式异常与系统中断隐患,需注意以下处理要点:
- 跳过格式异常坏行:在超大文件中个别行常因包含未转义的换行符或多余逗号导致解析崩溃。在
pd.read_csv()中设置on_bad_lines='skip',可以避免数小时的批处理因单条异常数据而全盘报错。 - 编码兼容性:Windows 导出的 CSV 常使用
gbk或带 BOM 的utf-8-sig。遇到乱码报错时,优先显式指定encoding='utf-8-sig'或encoding='gb18030'。 - 安全释放句柄:使用
chunksize处理多文件时,始终采用with pd.read_csv(...) as reader:语法,确保文件读取中断或遇到异常时,底层文件句柄能被操作系统正常回收。 - 分块大小参数的经验区间:一般以
100,000到500,000行作为基准调试起点。既能充分发挥 Pandas C 层向量化解析的速度优势,又可将单块常驻内存控制在 100MB 左右的极度安全区间。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















