


python回调函数怎么定义和使用
详细讲解Python回调函数的定义与使用方法,分析函数作为一等公民的引用传递机制、常见传参技巧、工程级进度监控钩子实践以及高频避坑指南。
一、回调函数的基本定义与调用机制
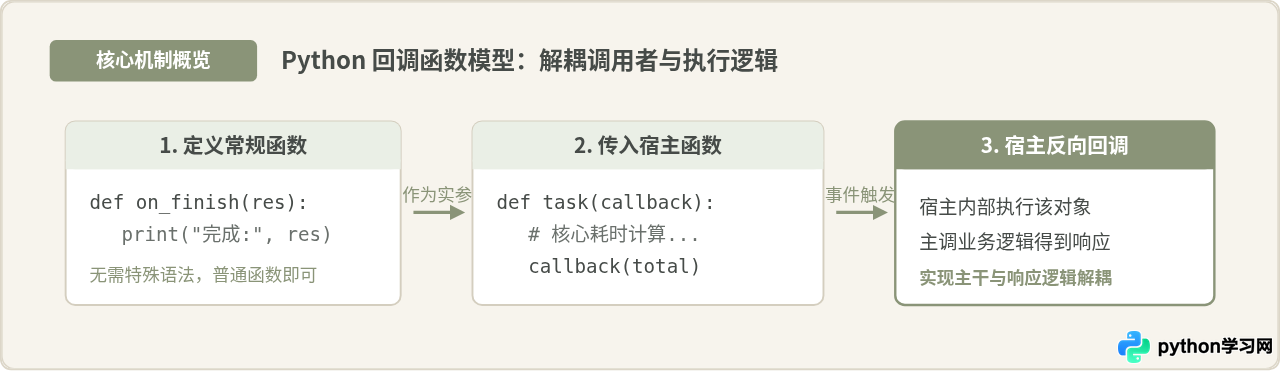
很多读者在初学时常以为回调函数有什么特殊的声明语法。事实上,在 Python 中定义一个回调函数,与定义普通函数没有任何区别。所谓“回调”,描述的是一种软件设计模式和控制权流转方式:A 函数把 B 函数的名字传给 C 函数,C 函数在内部某个时机反过来调用 B 函数。
我们可以通过下面这个最简单的计算场景,直接观察回调函数在 Python 中的定义和调用全过程:
# 步骤 1:定义一个普通函数作为回调函数
def on_calculate_finished(result):
    """这是回调函数,负责接收计算结果并打印格式化通知"""
    print(f"[回调响应] 计算已顺利完成,最终结果是: {result}")

# 步骤 2:定义宿主函数,将 callback 作为一个普通形参
def execute_calculation(num1, num2, callback):
    """这是宿主函数,负责执行核心计算,并在结束时触发回调"""
    print("[主任务] 开始进行耗时相加运算...")
    total = num1 + num2
    print("[主任务] 计算完毕,准备触发回调函数...")

    # 步骤 3:在宿主函数内部调用传入的回调函数
    callback(total)

# 步骤 4:实际调用宿主函数,传入函数名作为实参
execute_calculation(25, 75, on_calculate_finished)
运行上述代码,控制台将输出如下示例结果:
[主任务] 开始进行耗时相加运算...
[主任务] 计算完毕,准备触发回调函数...
[回调响应] 计算已顺利完成,最终结果是: 100
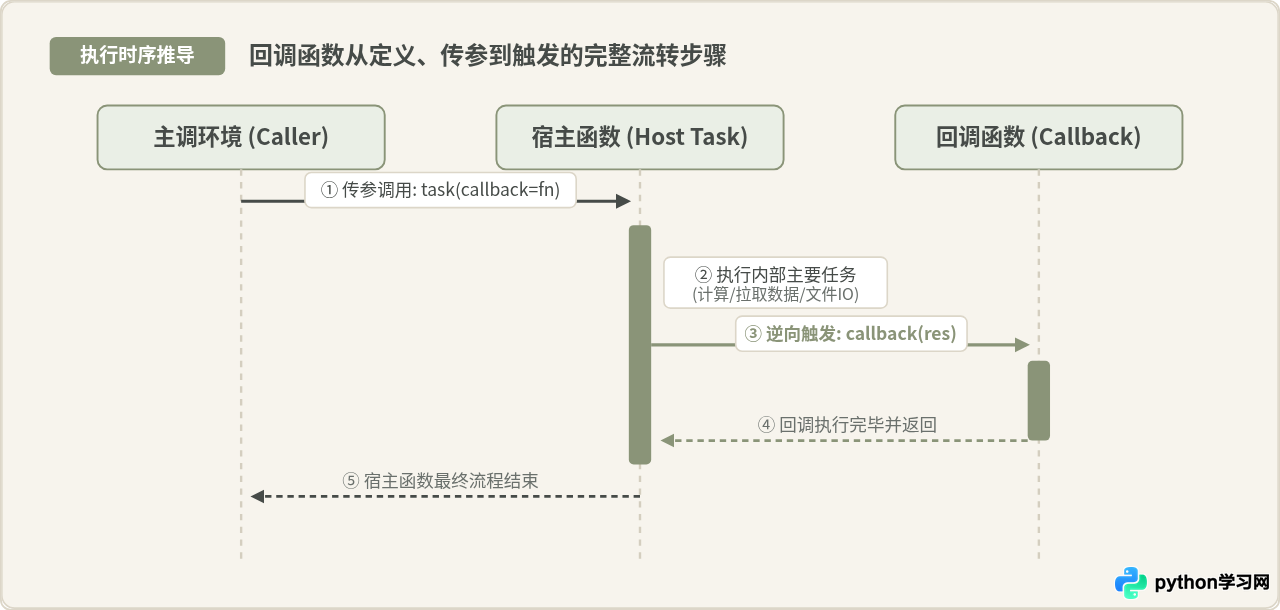
观察上述代码的执行次序:首先,主调代码调用了 execute_calculation,并将函数名 on_calculate_finished(注意末尾没有圆括号)作为参数传入。宿主函数内部完成了两数相加,随后使用 callback(total),把控制权临时交给了我们定义的回调函数,直到回调打印完成后,整个调用链路才结束。
二、传参机制:函数名与函数执行的区别
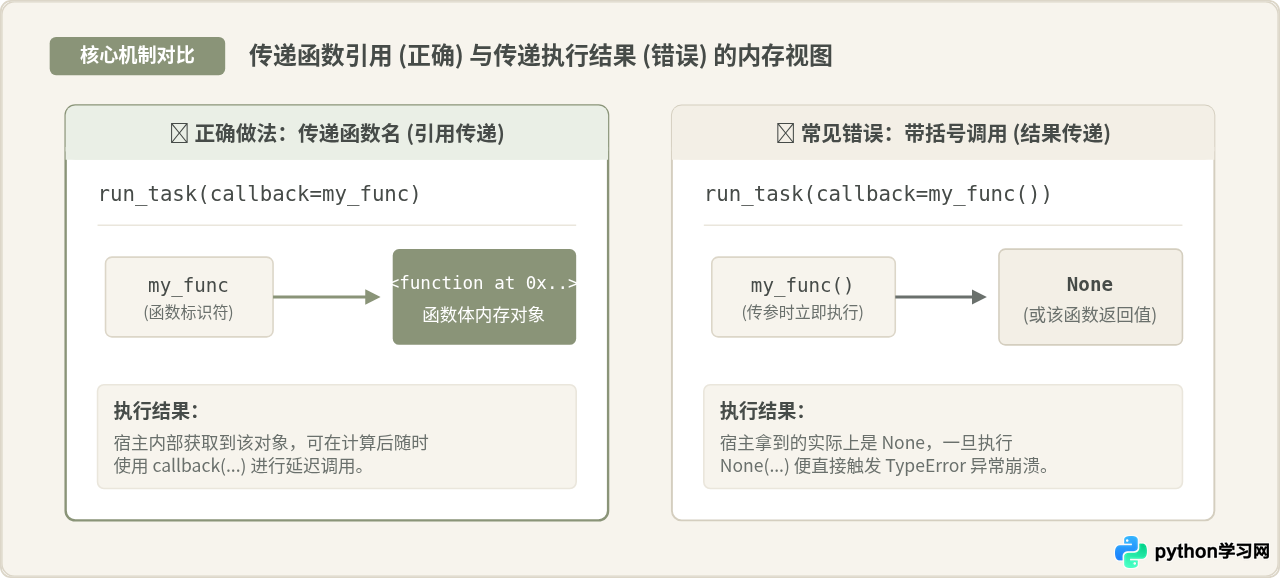
在编写回调函数时,初学者最容易遇到的错误是:在把回调函数传给宿主时,不小心写成了带括号的调用形式。
例如下面的错误写法:
# 错误示例:传参时带上了括号
execute_calculation(25, 75, on_calculate_finished())
执行这段代码会直接抛出报错:
TypeError: on_calculate_finished() missing 1 required positional argument: 'result'
# 或者如果原函数没有参数,则会在宿主执行 callback() 时抛出:
TypeError: 'NoneType' object is not callable
为什么会这样?理解这一点的关键在于 Python 的底层对象引用机制:
- 只写函数名
func:代表获取该函数对象本身的引用(内存地址)。此时函数尚未被执行,宿主函数收到的是一个能够随时被调用的对象。 - 写出函数名加括号
func():代表立即求值。Python 解释器在进入宿主函数之前,会立刻就地运行func(),并将该函数执行完毕后的返回值(若无显式 return 则为None)作为实参传递进去。
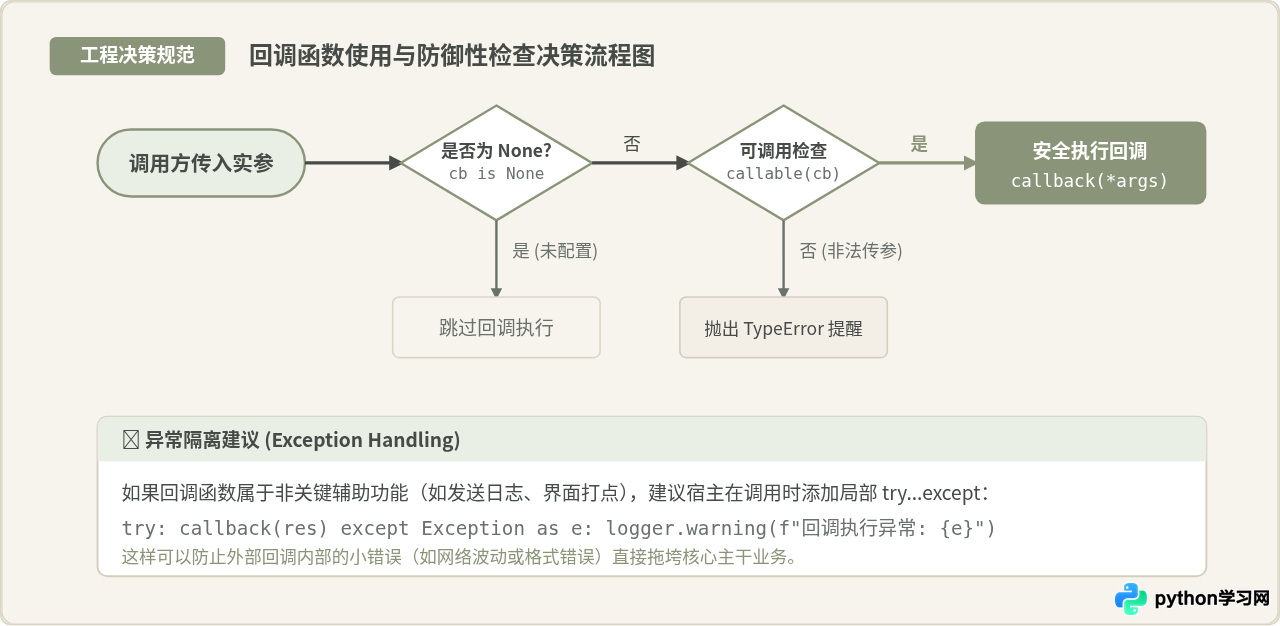
防御性设计:使用 callable() 检查回调有效性
在实际开发中,宿主函数的编写者通常无法预测调用方会传入什么实参。为了避免传入非法参数(如 None、整数或字符串)导致程序崩溃,推荐在调用前使用内置的 callable() 函数进行有效性校验:
def safe_task_runner(data, callback=None):
    """具备防御性检验的安全宿主函数"""
    # 核心数据转换逻辑
    processed_data = [item.strip() for item in data]

    # 检查是否传入了回调,且确认其为可调用对象
    if callback is not None:
        if callable(callback):
            callback(processed_data)
        else:
            raise TypeError(f"参数 callback 必须是可调用对象,当前传入类型为: {type(callback).__name__}")

    return processed_data
三、回调函数的高级传参方式
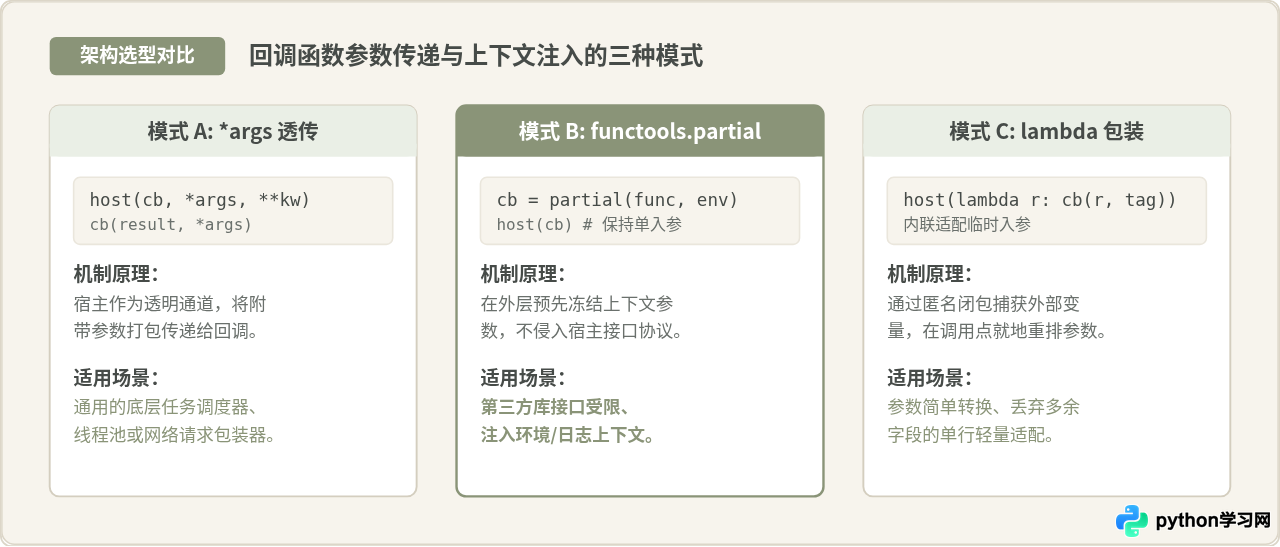
在真实业务中,回调函数的参数往往不仅仅由宿主函数决定。我们常常需要将外部的上下文配置(例如环境名称、日志标签或数据库连接)注入给回调函数。面对参数不匹配或需额外传参的情况,主要有以下三种标准解决方案:
方式一:宿主函数使用 *args 和 **kwargs 进行解耦透传
如果宿主函数是一个通用任务驱动器,可以利用 Python 的可变参数语法,将调用方传入的额外参数原封不动地转发给回调函数:
def fetch_resource(url, on_complete, *args, **kwargs):
    """宿主函数:支持动态透传任意参数给回调"""
    # 模拟请求并获取响应文本
    simulated_response = f"<html>来自 {url} 的数据</html>"

    # 将计算结果与外部透传的参数一并传给回调函数
    on_complete(simulated_response, *args, **kwargs)

def handle_result(content, source_tag, is_debug=False):
    """带有多参数的回调函数"""
    if is_debug:
        print(f"[调试模式] 数据源: {source_tag} | 抓取长度: {len(content)}")
    print(f"[业务处理] 内容截取: {content[:15]}")

# 调用时,宿主函数直接透传 "CDN节点1" 和 is_debug=True
fetch_resource("https://example.com/api", handle_result, "CDN节点1", is_debug=True)
方式二:使用 functools.partial 预置上下文参数(工程推荐)
当宿主函数的接口规范已经固定(例如只接受单参数 callback(result)),而你的回调函数却需要额外参数时,使用 Python 标准库 functools.partial 是最优雅的方案。它可以预先“冻结”部分参数,生成一个新的可调用对象:
from functools import partial

def send_alert(channel, env, alert_msg):
    """通用的报警回调:需要 3 个参数"""
    print(f"[{channel.upper()} - {env}] 报警触发: {alert_msg}")

# 假设宿主监控函数只提供 1 个参数给回调:monitor(callback)
def monitor_system(data, alert_callback):
    if len(data) == 0:
        # 宿主规范:只传递 alert_msg 单个参数
        alert_callback("数据集合为空,服务异常!")

# 使用 partial 预先锁定 channel="dingtalk" 和 env="production"
custom_callback = partial(send_alert, "dingtalk", "production")

# 宿主函数无需做任何改动,无缝衔接
monitor_system([], custom_callback)
方式三:使用 lambda 匿名函数轻量包装
对于逻辑简单、仅用于调整参数顺序或丢弃无用返回值的场景,可以使用 lambda 进行内联包装:
# 宿主期望回调接收 (status, code, data),但业务处理函数只需 data
def on_data_arrived(data):
    print("收到核心数据:", data)

# 利用 lambda 进行适配分发
def run_pipeline(worker_callback):
    worker_callback("SUCCESS", 200, {"id": 1001, "name": "ItemA"})

run_pipeline(lambda status, code, data: on_data_arrived(data))
四、实战演练:大批量数据处理的进度钩子
在实际开发中,最经典的同步回调应用就是长耗时任务的进度监控钩子(Progress Hook)。
假设我们编写了一个处理大批量数据的核心函数 process_batch_records。该函数只应专注于数据清洗与运算,不应该将打印进度、更新 UI 控件或上报监控的逻辑写死在算法内部。通过传入回调函数,我们可以彻底解耦业务逻辑与界面展示:
import time

# 步骤 1:定义满足业务需要的进度回调函数
def console_progress_reporter(current, total, speed):
    """用于控制台输出的回调"""
    percentage = (current / total) * 100
    bar = "=" * int(percentage // 5)
    print(f"
进度: [{bar:<20}] {percentage:5.1f}% | 已处理: {current}/{total} | 速率: {speed:.1f}条/秒", end="", flush=True)

# 步骤 2:编写核心批量处理函数,接收可选回调
def process_batch_records(records, chunk_size=100, on_progress=None):
    """
    数据处理宿主函数
    :param records: 待处理的数据集列表
    :param chunk_size: 每批次处理数量
    :param on_progress: 进度回调函数,签名约定为: (current, total, speed)
    """
    total = len(records)
    processed = 0
    start_time = time.time()

    for i in range(0, total, chunk_size):
        chunk = records[i:i + chunk_size]

        # 模拟批次运算耗时
        time.sleep(0.08)
        processed += len(chunk)

        # 触发进度回调
        if callable(on_progress):
            elapsed = max(time.time() - start_time, 0.001)
            current_speed = processed / elapsed
            on_progress(processed, total, current_speed)

    print() # 换行收尾

# 步骤 3:准备模拟测试数据并执行
mock_data = list(range(500))
print("启动批量数据转换引擎...")
process_batch_records(mock_data, chunk_size=50, on_progress=console_progress_reporter)
process_batch_records 的代码一行都不需要修改。我们只需新建一个 websocket_reporter 回调函数并传入即可。这正是回调模式带来的核心收益:高内聚、低耦合。
五、常见误区与避坑指南
在掌握了回调函数的基本语法后,在实际工程应用中还需要澄清以下三个常见认识误区:
误区一:传了回调函数就等于“异步执行”?
事实与辨析:这是初学者最普遍的误解。在 Python 中,除非你显式使用了多线程(threading / concurrent.futures)或协程(asyncio),否则传入的回调函数默认全部是同步阻塞执行的。
当宿主函数执行到 callback() 时,主线程会立即跳转执行回调函数中的代码,等待回调函数全部执行完毕后,主线程才会继续执行宿主函数随后的语句。如果你的回调函数内部包含耗时的文件下载或网络请求,它将直接阻塞整个主业务流程。
误区二:回调函数是否必须有 return 返回值?
事实与辨析:这完全取决于宿主函数与回调之间约定的“接口契约”:
- 通知型钩子(Notification Hook):如进度汇报、操作日志、完成通知等,回调函数只负责消费数据和执行副作用,通常不需要返回值(返回
None)。 - 转换/过滤型钩子(Transform/Filter Hook):类似于内置函数
sorted(data, key=func)或filter(func, data),宿主需要获取回调的返回值来决定后续逻辑。此时回调函数必须显式 return 处理结果。
六、总结与速查清单
在 Python 中定义和使用回调函数,并不需要依赖任何复杂的黑魔法。理解其本质是利用“函数作为可传递的对象”,并遵循清晰的接口契约。在编写相关代码时,可以参考以下速查表:
| 关键环节 | 正确做法 | 典型错误 / 注意事项 |
|---|---|---|
| 定义回调 | 使用常规 def func(args) 声明,保证形参含义清晰明确。 |
无需特殊装饰器或关键字,与普通函数完全一致。 |
| 传递回调 | 只写函数名:task(callback=my_func)。 |
切忌写成 my_func(),否则传递的是函数执行返回值。 |
| 宿主校验 | 先判断 callback is not None,再用 callable()。 |
避免直接无条件调用,防范调用方误传非法类型。 |
| 上下文注入 | 推荐使用 functools.partial(func, env) 优雅绑定。 |
避免在业务外层使用大量全局变量污染命名空间。 |
| 执行控制 | 默认是同步阻塞执行,辅助性回调建议包裹 try...except。 |
如果回调任务十分耗时,应改用多线程或异步协程调度。 |
只要牢牢掌握“传引用、验可用、巧传参、防异常”这四条基本准则,你就能够在实际项目中写出结构清晰、解耦彻底的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















