


Python完整代码结构解析:从模块导入到主函数入口
深入解析规范的Python代码结构,从文件头声明、模块级Docstring、三段式导入规范,到常量定义、类与函数组织,再到if __name__ == '__main__'主函数入口的完整生命周期与避坑指南。
一、标准 Python 代码的层次解构
很多初学者在编写 Python 代码时习惯“想到哪里写到哪里”,将顶层执行语句与函数定义交叉杂糅。这种写法在简短的单次测试中尚可运行,但随着逻辑扩展,极易引发命名冲突、代码无法被模块化复用以及难以编写自动化测试等问题。
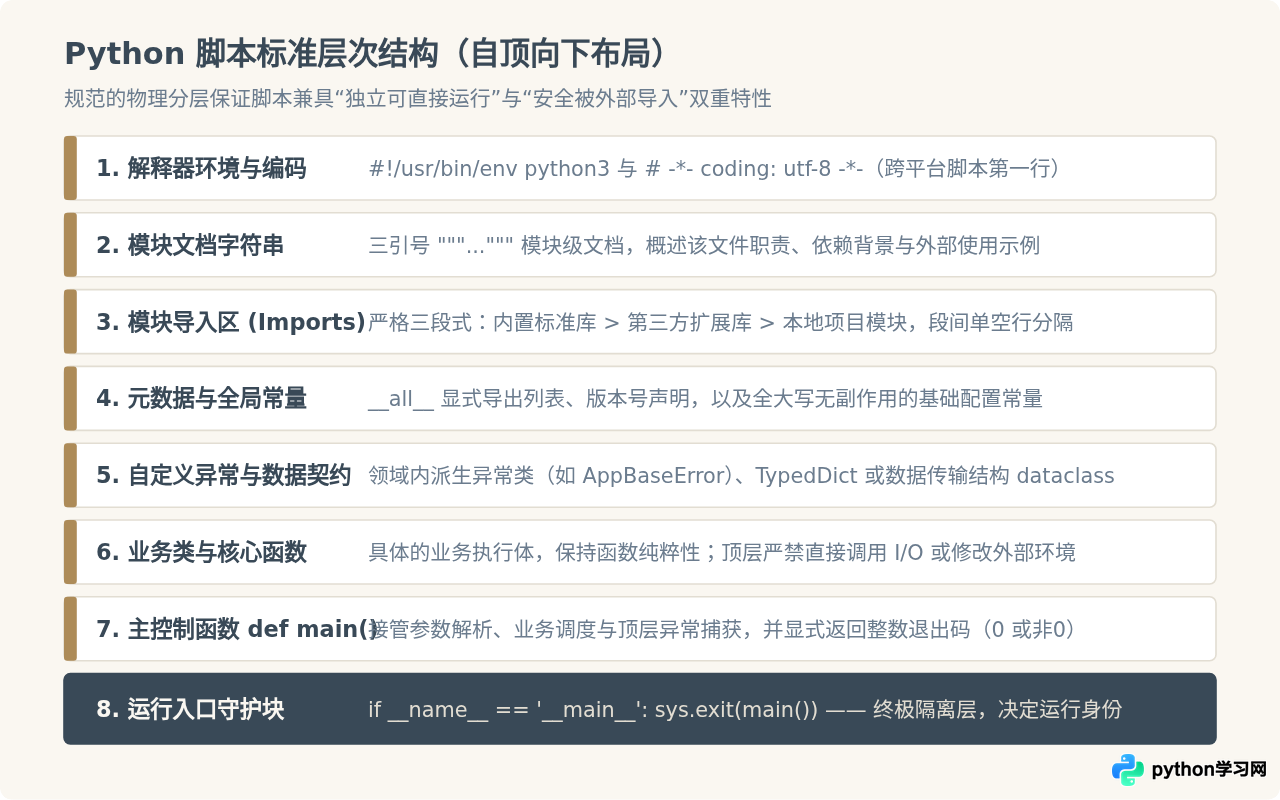
PEP 8 官方编码风格指南明确了标准的自上而下组织顺序。一个健壮的 Python 源码文件应当清晰划分为以下八个逻辑区块:
- Shebang 与文件编码声明:指明执行环境与文件字符集(主要在 Unix 环境或老式跨平台兼容中使用)。
- 模块级文档字符串(Module Docstring):使用三引号详细交代模块的职责、主要接口及使用约束。
- 依赖导入区(Imports):按标准库、第三方库与本地模块严格分层声明。
- 元数据与公开符号:定义
__version__、__author__及__all__导出列表。 - 全局常量与配置:统一采用大写字母命名,避免在后续代码中硬编码魔法值。
- 自定义异常与数据模型:声明业务特定的错误类或基础数据结构(如 Pydantic 模型、dataclass)。
- 业务类与辅助函数:封装实际运算逻辑,各函数保持职责单一与无全局状态副作用。
- 主入口与守卫块:封装
main()逻辑并通过if __name__ == '__main__':接管执行状态。
二、模块导入规范与依赖分组
在 Python 中,所有 import 语句原则上应当且必须集中位于文件顶部的文档字符串之后、任何全局变量或逻辑代码之前。散落在函数内部的局部导入除了为了解决极端循环依赖外,通常会导致依赖关系隐蔽、性能劣化及分析工具失效。
1. PEP 8 推荐的三段式分组原则
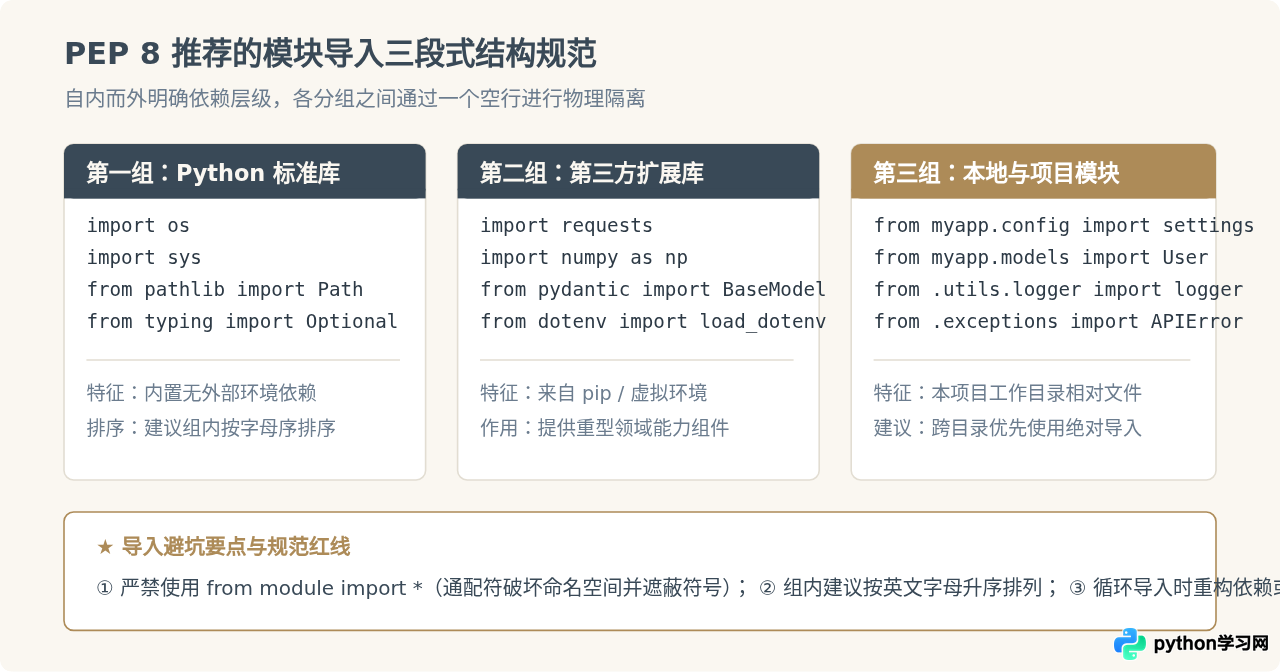
为了让阅读者一目了然地识别代码所依赖的系统级环境与外部包,导入语句应按下列顺序分为三组,各组之间空出一行作为视觉分割:
- 标准库(Standard Library):如
os、sys、pathlib、typing等随 Python 解释器附带的模块。 - 第三方扩展库(Third-party Libraries):通过
pip安装的外部轮子,如requests、pydantic、fastapi、numpy。 - 本地/应用内部模块(Local / Application Imports):本项目同一仓库内的其他业务模块或子包。
2. 为什么严禁使用通配符导入(Wildcard Import)
形如 from math import * 的通配符导入是生产代码中的重大隐患。它将目标模块中的所有公开符号无差别倾倒至当前命名空间,这会带来两个直接恶果:
- 命名空间污染与静默覆盖:如果本地或另一个模块中也定义了同名变量或函数,后导入的内容会悄无声息地覆盖前置定义,造成难以定位的运行时行为异常。
- 静态分析与 IDE 补全失效:静态语法检查器(如 Ruff、Flake8、Mypy)无法追踪变量的真实来源,自动化代码跳转与重构工具也将失去效力。
三、全局常量、类与核心函数的组织边界
导入语句完成后,便进入模块的内容定义区。很多脚本之所以难以维护,是因为全局变量与业务代码边界模糊。在这一部分,务必守住“声明与执行解耦”的底线。
1. 全局常量的声明规则
全局常量应全部采用大写字母与下划线命名(如 DEFAULT_TIMEOUT = 30),并紧跟在导入区之后。注意:尽量只声明不可变数据类型(如字符串、数值、元组)。若必须使用字典或列表,需格外注意防止其他函数在运行时对其产生非预期的就地修改(In-place mutation)。
2. 顶层无副作用原则(No Top-Level Side Effects)
当一个 Python 文件被 import 引入时,Python 解释器会从第一行一直执行到最后一行。如果在顶层(函数之外)书写了直接执行的语句,例如:
# 错误示例:顶层产生严重副作用
print("系统正在启动...")
conn = db.connect("postgres://...") # 导入该文件就会尝试连接网络!
data = fetch_remote_config()        # 发生远程 I/O,极大地拖慢导入速度
任何其他模块只需 import this_module,上述代码就会立即触发数据库连接和网络请求。这会导致单元测试变得异常脆弱,甚至在不需要执行主逻辑的场合产生灾难性后果。规则:模块顶层只允许包含类定义、函数定义、常量定义及类型声明,严禁包含任何会引发网络、文件写或显式打印的执行代码。
四、主函数入口设计:def main() 与 __name__ == '__main__'
一个成熟的 Python 脚本必须具备“既可作为独立命令执行,又可作为工具模块安全导入”的能力。实现这一特性的核心就在于主函数与 if __name__ == '__main__': 守卫块。
1. __name__ 变量的双重身份
__name__ 是 Python 解释器在加载模块时自动注入的内建字符串变量,它的取值完全取决于文件的调用方式:
| 调用方式 | __name__ 的实际取值 | 守卫条件是否满足 | 预期行为 |
|---|---|---|---|
终端命令行直接运行:python app.py |
"__main__" |
是(True) | 作为主程序启动,执行入口块代码 |
被其他模块引入:import app |
"app"(模块实际文件名) |
否(False) | 仅注册类与函数定义,静默跳过执行入口 |
2. 规范编写 main() 函数的三步闭环法
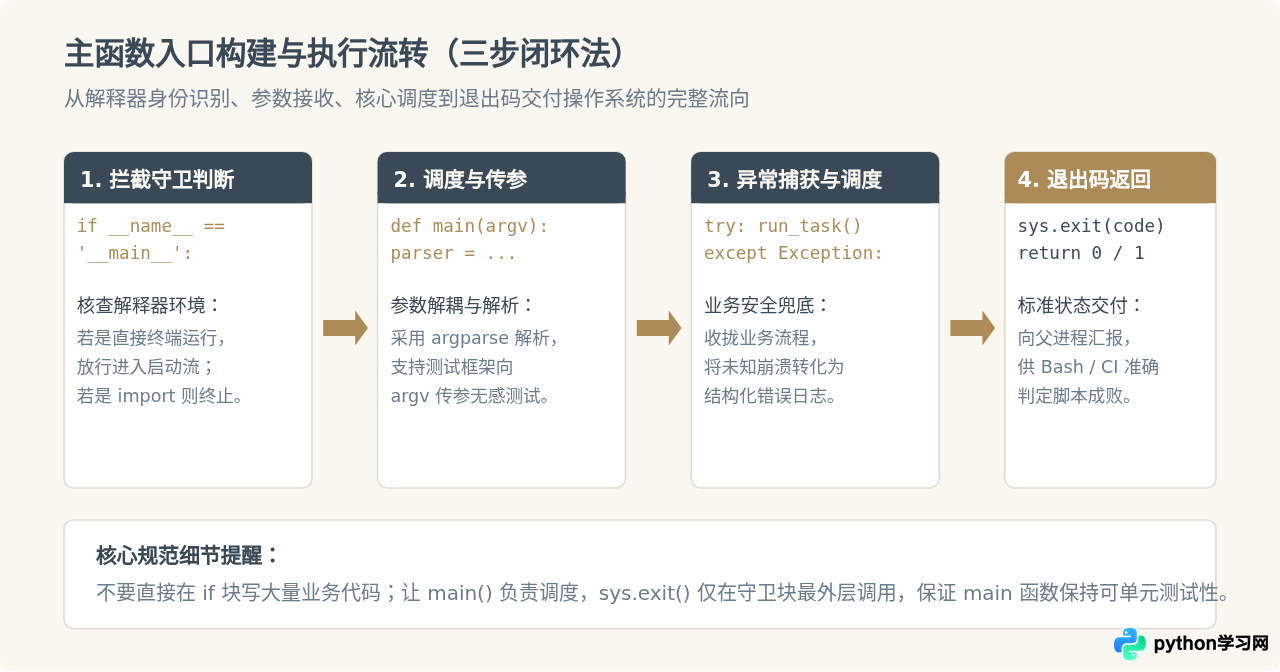
将入口逻辑包裹在独立的 main() 函数中,而非直接堆砌在 if __name__ == '__main__': 条件缩进内,能够显著提升代码的可测试性与工程整洁度:
- 步骤一:支持显式传参(argv)。将
sys.argv[1:]作为可选入参传入def main(argv=None):,这样在编写单元测试(如 pytest)时,无需模拟操作系统底层参数即可轻松调用验证。 - 步骤二:统一的异常拦截与日志收拢。在
main()内部使用try...except捕获顶层未处理异常,避免直接向用户终端打印原始的 Traceback 调用栈,同时保证资源得到妥善释放。 - 步骤三:显式返回标准退出状态码。执行成功返回
0,发生已知错误返回非零整数(如1或特定错误码),并在守卫块中通过sys.exit(main())交还给操作系统或 CI/CD 流水线。
五、规范完整的 Python 代码模版与示例
以下示例展示了一个完整的生产级 Python 脚本模板。该脚本展示了数据统计清洗的功能,完整遵循了从头部声明、三段式导入、常量配置,到业务函数、主函数及守卫入口的全套规范:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""数据处理与质量检查工具脚本。

本模块提供 CSV 文件的读取、字段完整性验证与基础统计计算能力。
既可由命令行直接调用,也可作为库导入使用其 DataProcessor 核心类。
"""

# ==========================================
# 1. 模块导入区 (Imports)
# ==========================================
# 标准库导入
import argparse
import logging
import sys
from pathlib import Path
from typing import Dict, List, Optional, Sequence

# 第三方依赖库导入 (示例)
# import pydantic

# 本地内部模块导入 (示例)
# from .exceptions import DataValidationError


# ==========================================
# 2. 公开接口与全局常量声明
# ==========================================
__all__ = ["DataProcessor", "main"]
__version__ = "1.0.0"

# 全局常量:全大写,无外部依赖与副作用
DEFAULT_LOG_FORMAT = "%(asctime)s - [%(levelname)s] - %(message)s"
MAX_RECORD_LIMIT = 10000


# ==========================================
# 3. 自定义异常与核心业务类
# ==========================================
class DataValidationError(Exception):
    """当数据格式校验失败时触发的自定义异常。"""
    pass


class DataProcessor:
    """负责核心数据清洗与聚合运算的执行器。"""

    def __init__(self, file_path: Path) -> None:
        self.file_path = file_path

    def validate(self) -> bool:
        """检查目标文件是否存在且非空。"""
        if not self.file_path.exists():
            raise FileNotFoundError(f"未找到目标文件: {self.file_path}")
        if self.file_path.stat().st_size == 0:
            raise DataValidationError("目标数据文件内容为空")
        return True

    def process(self) -> Dict[str, int]:
        """执行数据行数统计。"""
        self.validate()
        line_count = 0
        with self.file_path.open("r", encoding="utf-8") as f:
            for line in f:
                if line.strip():
                    line_count += 1
                if line_count > MAX_RECORD_LIMIT:
                    break
        return {"valid_lines": line_count}


# ==========================================
# 4. 辅助函数
# ==========================================
def setup_logging(verbose: bool = False) -> None:
    """根据参数初始化日志配置。"""
    level = logging.DEBUG if verbose else logging.INFO
    logging.basicConfig(level=level, format=DEFAULT_LOG_FORMAT)


# ==========================================
# 5. 主控制函数 def main()
# ==========================================
def main(argv: Optional[Sequence[str]] = None) -> int:
    """主流程执行入口,负责参数解析、依赖组装与异常收拢。

    Args:
        argv: 命令行传入参数,默认 None 则由 argparse 从 sys.argv 读取。

    Returns:
        int: 执行状态码,0 表示正常完成,非 0 表示各类错误。
    """
    parser = argparse.ArgumentParser(description="数据处理与分析工具")
    parser.add_argument("file", type=Path, help="待处理的文本文件路径")
    parser.add_argument("-v", "--verbose", action="store_true", help="启用详细调试日志")

    args = parser.parse_args(argv)
    setup_logging(args.verbose)

    logging.info("开始处理文件: %s", args.file)

    try:
        processor = DataProcessor(args.file)
        result = processor.process()
        logging.info("处理完成,有效记录数: %d", result["valid_lines"])
        return 0
    except FileNotFoundError as err:
        logging.error("文件错误: %s", err)
        return 2
    except DataValidationError as err:
        logging.error("数据校验失败: %s", err)
        return 3
    except Exception as err:
        logging.critical("遇到未捕获的严重错误: %s", err, exc_info=True)
        return 1


# ==========================================
# 6. 入口守卫判断
# ==========================================
if __name__ == "__main__":
    # 显式将 main() 的退出码返回给宿主系统
    sys.exit(main())
六、代码结构自检清单与工程建议
在日常开发与 Code Review 中,可以通过以下四个维度快速检验 Python 文件的代码结构是否规范达标:
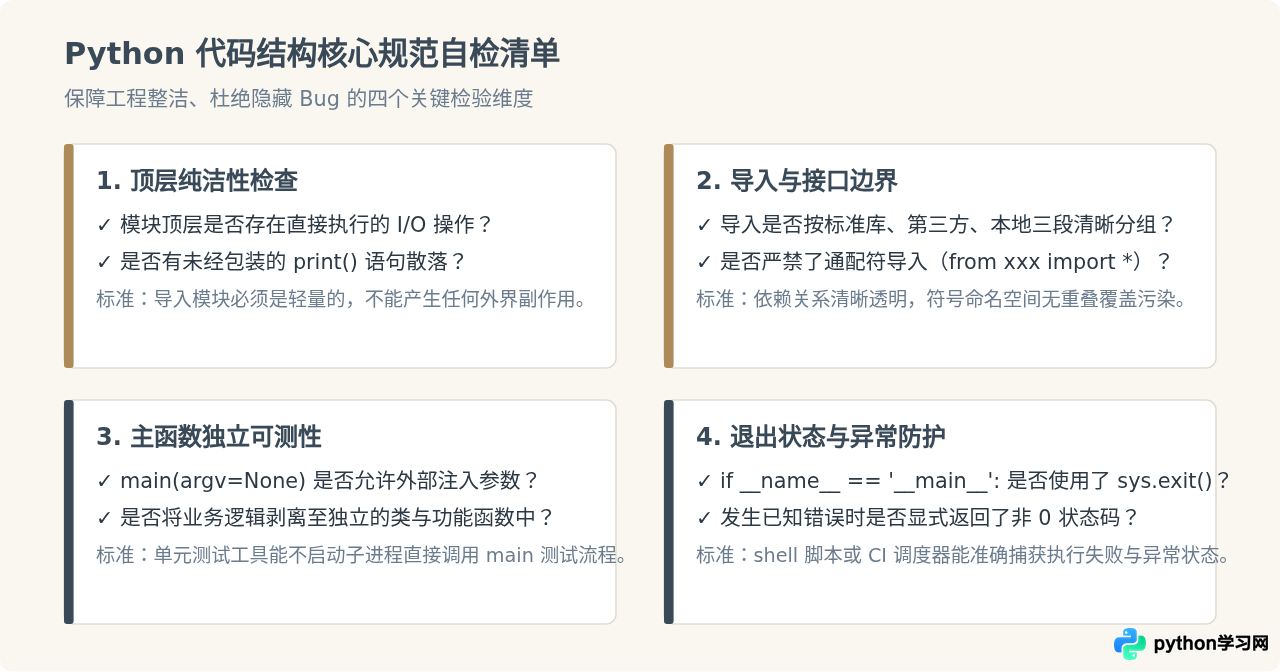
从 Shebang、模块 Docstring、三段式导入、全局常量、业务类与函数,再到 main() 函数与 if __name__ == '__main__': 守卫入口,Python 这套自上而下的经典结构不是繁文缛节,而是 Python 模块机制与动态执行特性的天然要求。养成按这套结构编写代码的习惯,能让每个脚本在保持轻巧简洁的同时,具备工业级代码的健壮性与可扩展性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















