


Python源码运行报编码错误SyntaxError怎么处理
详细解析Python源码运行报编码错误SyntaxError的产生机理、常见触发场景、分步排查修复流程与工程最佳实践。
当执行 Python 脚本时遇到提示 SyntaxError: (unicode error) 'utf-8' codec can't decode byte... 或 SyntaxError: Non-UTF-8 code starting with...,这说明 Python 解释器在编译源代码时遇到了无法按照指定编码解析的二进制字节。这一类错误与程序运行期的文件读写错误(例如 UnicodeDecodeError)不同,它发生在代码执行之前的词法解析阶段。解决的核心方法非常明确:将源码文件统一转换为标准的无 BOM UTF-8 编码,或者在源码文件首行规范声明符合 PEP 263 标准的编码格式。接下来,我们将系统分析该错误的触发机制、排查步骤及长期工程防范方案。
一、为什么编码问题会报 SyntaxError?
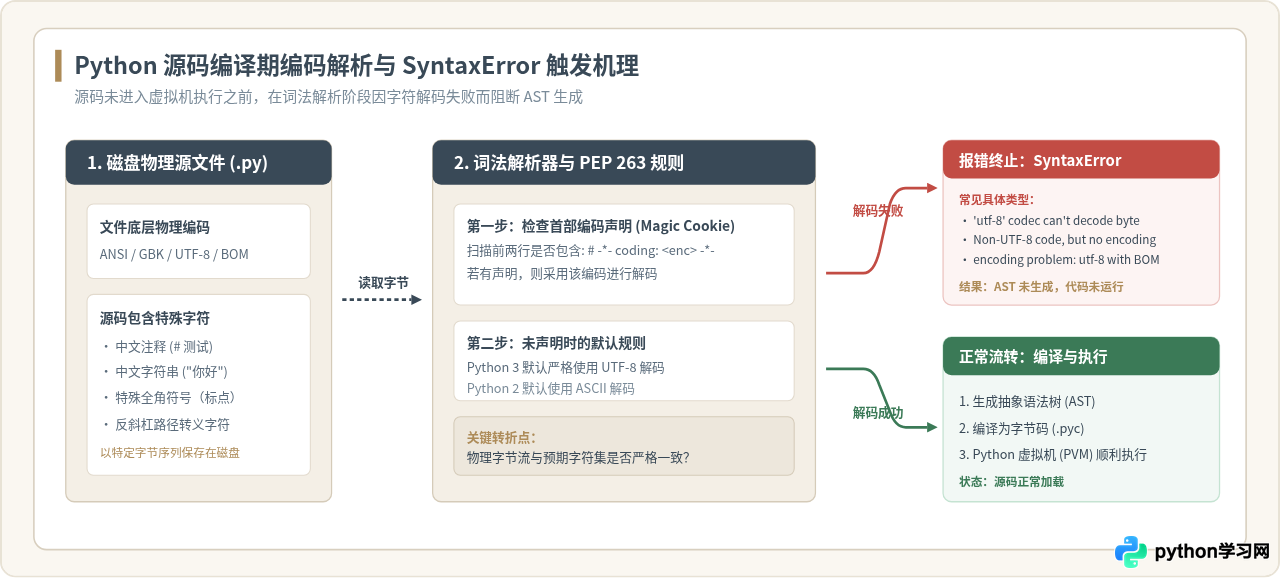
很多开发者容易将“源码编码错误”与“运行时数据编码错误”混为一谈。在 Python 的执行流程中,源码运行主要分为两个阶段:编译阶段(解析源码为字节码)与运行阶段(虚拟机执行字节码)。
当我们在代码中书写了中文注释、中文字符串或者全角符号时,Python 解释器在启动时必须先读取源文件的原始二进制字节流,并将其解码成字符。根据 Python 规范:
- Python 3:默认使用
UTF-8编码来解码源文件。如果文件在磁盘上实际是用 Windows 常见的GBK、CP936或 ANSI 保存的,一旦遇到中文字节,UTF-8 解码器就会因字节序列不合规而立即失败。 - Python 2(历史项目):默认仅使用单字节的
ASCII编码解析源文件。只要源文件中包含任何非 ASCII 字节(即便只是在注释中),若未显式声明编码,就会直接抛出语法错误。
因为字符解码是生成抽象语法树(AST)的前提,一旦解码器罢工,词法分析便无法继续,所以解释器直接将其定性为 SyntaxError 并中断程序。理解这一阶段性特征,是精准解决问题的关键。
二、常见的报错表现与核心诱因分析
排查错误前,先观察控制台打印的完整 traceback。虽然顶层都标记为 SyntaxError,但后面的细分描述往往指明了具体诱因:
1. SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xXX in position Y: invalid start byte
最常见诱因:在 Windows 系统中,默认记事本或其他简易文本编辑器会将文件保存为 ANSI(在简体中文 Windows 下即 GBK/CP936)。当脚本中存在中文汉字时,每个汉字在 GBK 中占用 2 个字节,例如“中”字被存为 0xD6 0xD0。Python 3 默认用 UTF-8 解码,当读到 0xD6 时发现它不符合 UTF-8 多字节序列的前缀规范,便会直接抛出此异常。
2. SyntaxError: Non-UTF-8 code starting with '\xe4' in file test.py on line 1, but no encoding declared
最常见诱因:此错误通常出现在 Python 2 环境,或某些特殊运行容器中。源文件首行未声明编码,但正文已经使用了多字节编码字符(例如 UTF-8 中的汉字“中”字首字节为 \xe4)。解释器要求必须显式遵守 PEP 263 规范声明编码。
3. SyntaxError: encoding problem: utf-8 with BOM
最常见诱因:在早期 Windows 记事本中选择另存为 UTF-8 时,编辑器会在文件最开始插入三个不可见字节 0xEF 0xBB 0xBF(即 Byte Order Mark,BOM)。如果源文件中同时写了 # -*- coding: utf-8 -*-,有些版本的 Python 会检测到 BOM 与头部声明冲突,判定编码语法异常。
4. SyntaxError: (unicode error) 'unicodeescape' codec can't decode bytes in position 2-3: truncated \uXXXX escape
特别提醒(伪编码错误):该报错也带有 (unicode error),但它并非文件本身的存储编码不匹配,而是字符串字面量转义问题。常见于 Windows 路径书写:如 path = "C:\user\test",反斜杠后紧跟 \u 被 Python 误认为是 Unicode 转义序列(如 \u0061),由于后面不足4位十六进制数字而报错。解决办法是在路径前加原始字符串前缀 r"C:\user\test" 或将反斜杠替换为正斜杠 /。
三、分步排查与标准修复流程
遇到编码导致的 SyntaxError 时,切忌盲目胡乱尝试修改文件。按照以下标准四步法,可以一次性彻底根除:
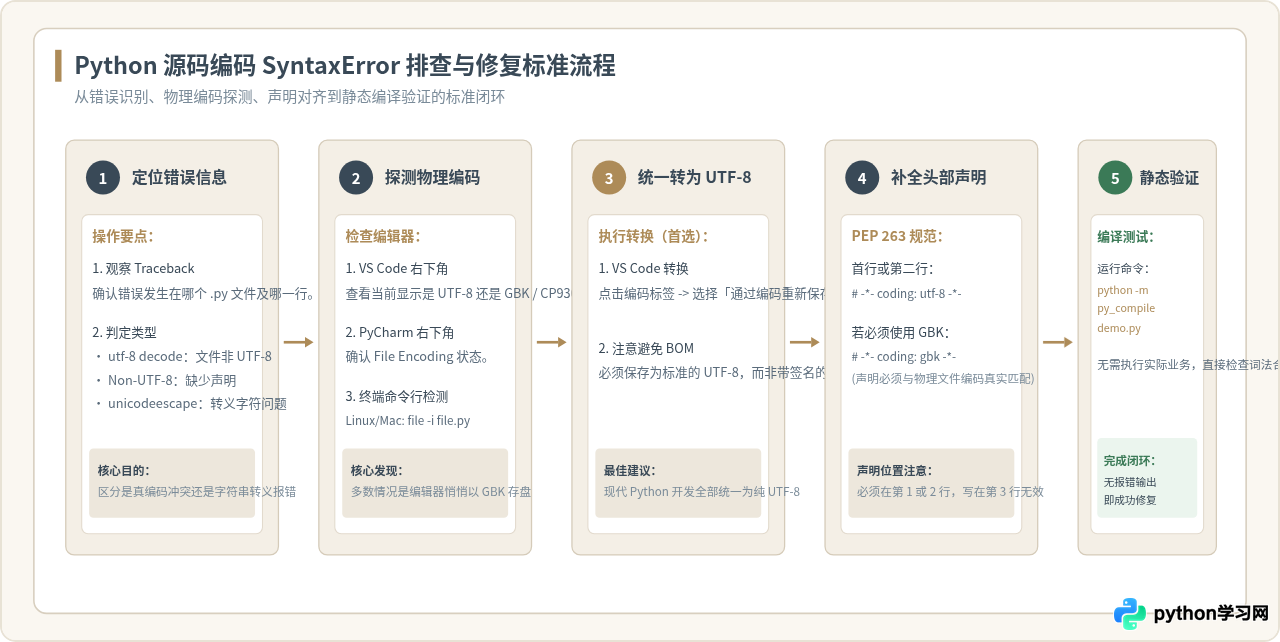
第一步:定位错误源头
仔细查看错误回溯的最末几行。例如:
  File "main.py", line 12
    # 这里是测试配置说明
               ^
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xd5 in position 0: invalid continuation byte
从上述信息中可以提炼出三个关键信息:文件名为 main.py,报错行数为第 12 行,原因是 UTF-8 编码器解析 0xd5 失败。这明确告诉我们:该文件是以非 UTF-8(极大概率为 GBK)编码格式保存的。
第二步:检查并转换编辑器存储编码
绝大多数编码 SyntaxError 的根源在于“编辑器保存的格式与解释器认定的格式不匹配”。针对常用编辑器的操作如下:
- Visual Studio Code:
- 查看窗口右下角状态栏的编码标识(默认通常显示
UTF-8或GBK)。 - 点击该编码标识,在顶部弹出的命令面板中选择 「通过编码重新打开 (Reopen with Encoding)」,选择
GBK或Simplified Chinese (GB2312),确认代码中的中文不再是乱码。 - 再次点击右下角编码标识,选择 「通过编码保存 (Save with Encoding)」,选择
UTF-8。此时编辑器会将磁盘字节统一重写为标准 UTF-8。
- 查看窗口右下角状态栏的编码标识(默认通常显示
- PyCharm:
- 进入
Settings (Preferences)->Editor->File Encodings。 - 将
Global Encoding、Project Encoding以及Default encoding for properties files全部统一设为UTF-8。 - 确保下方
Create UTF-8 files设置为with NO BOM。 - 在打开的冲突文件右下角点击编码切换为 UTF-8 并选择
Convert。
- 进入
- Notepad++:
- 点击顶部菜单栏的
编码 (Encoding)。 - 选择 「转为 UTF-8 编码 (Convert to UTF-8)」(切勿选择「UTF-8-BOM 编码」),然后按
Ctrl + S保存。
- 点击顶部菜单栏的
第三步:规范书写 PEP 263 头部编码声明
根据 Python 官方规范 PEP 263,当源文件包含非 ASCII 字符时,如果需要显式指明编码,必须在文件的第一行或第二行通过特定格式的注释进行声明。
标准且被各大编辑器与解析器广泛识别的写法为:
# -*- coding: utf-8 -*-或者更加简练的形式:
# coding=utf-8避坑提示:
1. 如果脚本首行包含 Linux/Unix 的 Shebang(例如 #!/usr/bin/env python3),那么编码声明必须写在第二行。
2. 编码声明写在第三行或更靠后的位置是完全无效的,解释器不会读取它作为魔术注释。
3. 严禁“声明与实际不符”:如果文件物理上是 GBK 保存的,千万不要在头部写 # -*- coding: utf-8 -*-;同样,如果文件是 UTF-8 保存的,也不要写 # -*- coding: gbk -*-。这种自相矛盾的配置必定引发 SyntaxError。
第四步:使用 py_compile 进行无副作用验证
修复文件编码后,不需要真正调用业务逻辑(例如连接数据库或触发复杂计算)来验证代码是否还会报语法错。可以使用 Python 内置的 py_compile 模块进行静态编译检查:
# 在终端或命令行执行静态编译检测
python -m py_compile main.py
如果命令执行后没有任何错误输出并正常退出,说明解释器已经可以毫无障碍地将源码解码并编译为字节码,编码导致的 SyntaxError 已彻底解决。
四、实际物理编码与 Python 解析行为对应矩阵
为了帮助大家建立系统清晰的对照关系,以下整理了源文件物理存储编码、头部声明与解释器解析行为之间的完整对应矩阵:
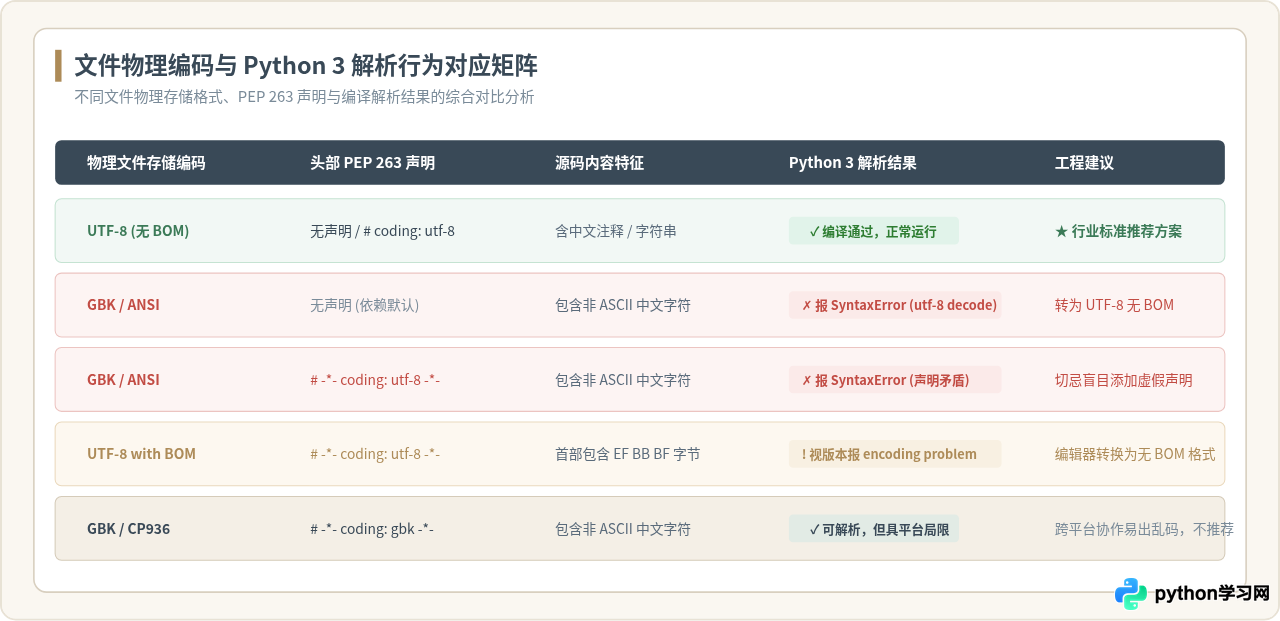
从上表可以直观看出:只要将源码以无 BOM 的 UTF-8 格式存储,无论是 Python 3 默认解析还是配合显式声明,都是最稳健且跨平台兼容性最好的方案。
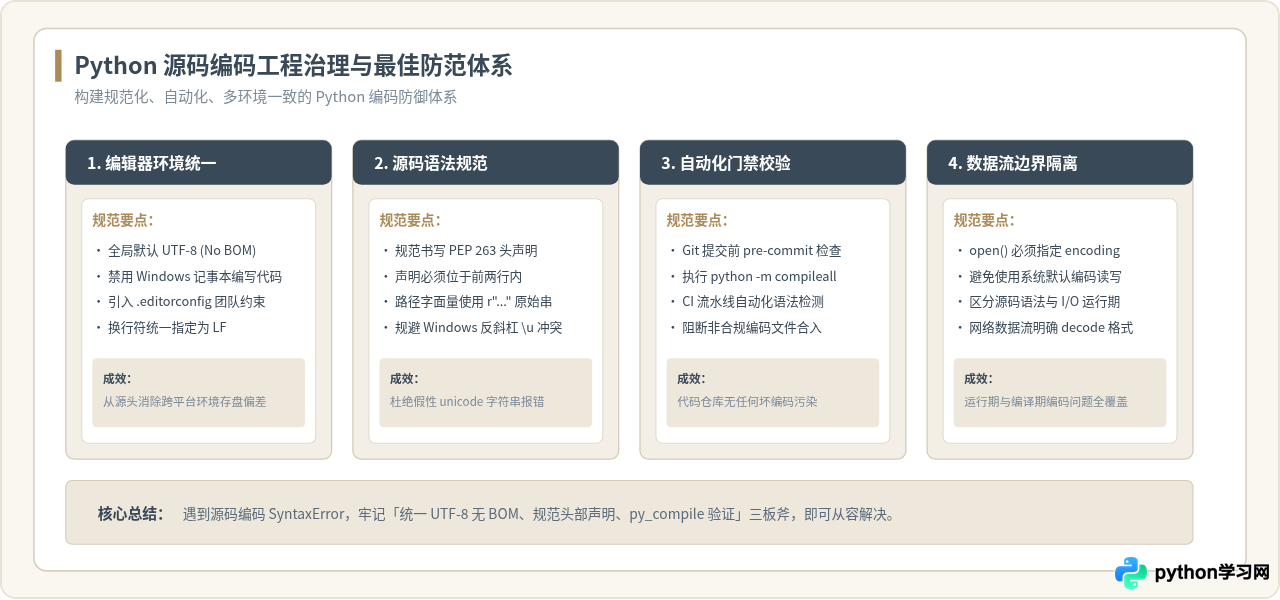
五、工程级最佳实践与长效防范建议
在多人协同或跨操作系统(如 Windows 与 Linux 容器并存)开发时,编码问题如果仅靠单个开发者手动排查,极易重复发生。以下四条工程化实践可以从源头杜绝此类问题:
1. 项目根目录配置 .editorconfig
在代码仓库根目录创建 .editorconfig 文件,强制所有团队成员的 IDE 在新建或保存 Python 文件时自动遵循统一规范:
root = true

[*.py]
charset = utf-8
end_of_line = lf
insert_final_newline = true
trim_trailing_whitespace = true
主流编辑器(VS Code、PyCharm 等)均原生支持或通过插件支持该配置文件,能有效避免 Windows 开发者无意间以 ANSI/GBK 格式提交代码。
2. 明确区分“源码编码”与“I/O 数据编码”
处理好 SyntaxError 仅代表源文件本身可以被 Python 正确编译。如果程序在读取外部 data.txt 或 log.csv 时报错,那是运行期的 UnicodeDecodeError,与源文件头部的 # coding: utf-8 无关。在读写任何外部文件时,务必在 open() 函数中显式声明编码:
# 正确范例:显式传入 encoding 参数,不依赖操作系统默认环境
with open("data.txt", "r", encoding="utf-8") as f:
    content = f.read()
3. 在 CI/CD 流程中加入静态语法校验
在 Git 提交前(pre-commit hook)或流水线构建步骤中,加入对所有 .py 文件的编译校验:
# 校验项目中所有的 Python 文件编译合法性
python -m compileall -q .
任何编码不合规、存在 SyntaxError 的代码会在构建阶段被拦截,杜绝问题代码部署到生产环境。
总结
Python 源码在启动运行阶段报出的 SyntaxError 编码异常,是词法解析器在编译前对源文件字节流进行完整性检验的必然结果。解决该问题的关键是消除实际物理存储与解析规则之间的偏差:通过编辑器将文件另存为无 BOM 的 UTF-8 格式,并在包含非 ASCII 字符的脚本前两行添加标准的 # -*- coding: utf-8 -*- 声明。结合项目级 .editorconfig 统一编辑器保存规范与 CI 语法编译门禁,可以在个人开发与团队协作中彻底杜绝源码编码语法错误的发生。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















