


Python3.14的多个子解释器能并行跑pandas吗?
深入解析 Python 3.14 的子解释器(Subinterpreters / PEP 734)能否并行运行 pandas,剖析 C 扩展隔离机制、安全门禁拦截原理、实测复现过程,并提供切实可行的多核并行替代方案。
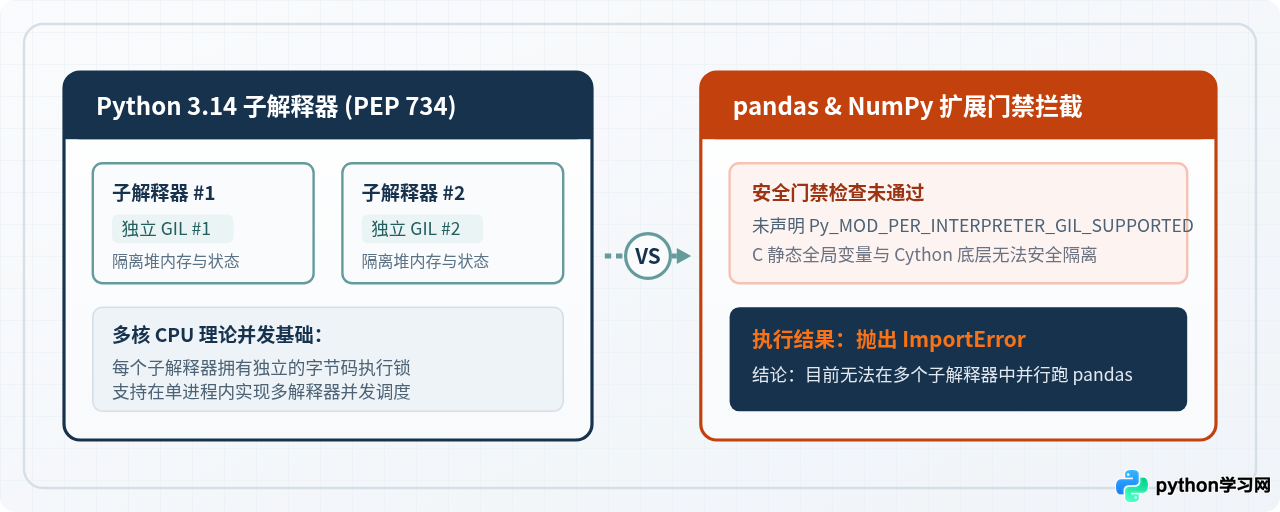
concurrent.futures.InterpreterPoolExecutor 与 interpreters 模块),但在子解释器中尝试导入并运行 pandas 会被解释器主动拦截,直接抛出 ImportError。这是由 Python 对具备独立 GIL 的子解释器所设下的 C 扩展安全门禁决定的,本文将为你详细剖析背后的阻断根源、代码复现过程以及目前切实可行的多核并行方案。
一、核心结论与现实阻断现象
随着 Python 3.14 的演进,许多数据开发者对“每解释器拥有独立 GIL(Per-Interpreter GIL)”这一特性寄予厚望,希望能够在单一操作系统进程内通过多个轻量子解释器实现真正打满 CPU 多核的 pandas 数据并行计算。然而,如果你在 Python 3.14 的子解释器线程中执行 import pandas as pd,程序并不会如期运行,而是会立即中断并输出如下典型报错信息:
# 示例:在 Python 3.14 子解释器中导入 pandas 时的预期报错输出
ImportError: module pandas._libs.interval does not support loading in subinterpreters with their own GIL
这个报错并非偶发的环境缺失或配置错误,而是 Python 运行时专门为多子解释器设计的硬性安全门禁机制。子解释器虽然在 Python 语法层提供了并发能力,但对底层 C/C++ 扩展模块有着极度严苛的内存隔离要求。目前的 pandas 及其基石依赖 NumPy 尚未完成这一深层改造,因此被严格隔离在独立子解释器的门外。
二、架构剖析:Python 3.14 的子解释器与独立 GIL
要透彻理解为何 pandas 会被阻断,首先需要理清 Python 3.14 子解释器的底层运行模型。在 Python 3.12 之前,虽然 C-API 层早已存在“子解释器”概念,但所有子解释器必须共同争夺同一把全局解释器锁(GIL),因而无法实现真正的 CPU 多核并行。
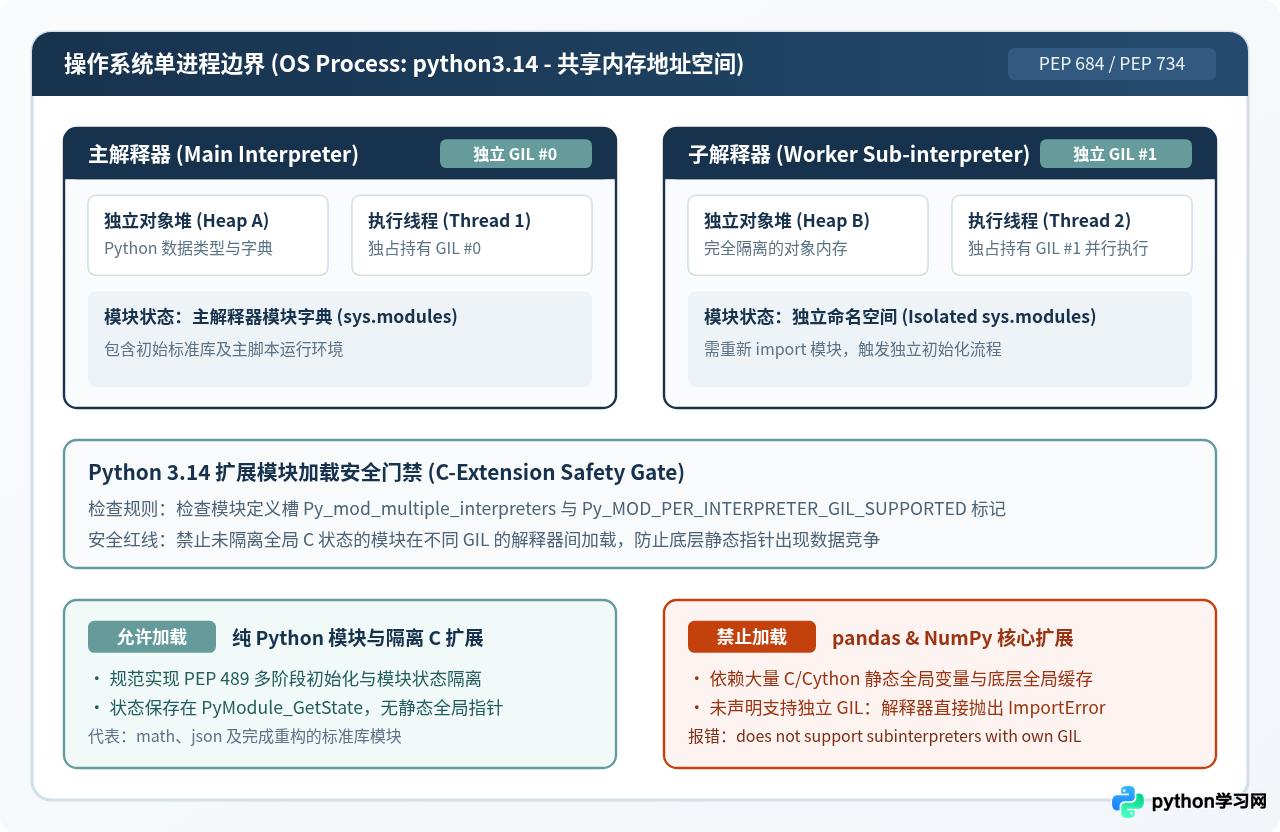
从 PEP 684 引入“Per-Interpreter GIL”开始,到 Python 3.14 通过 PEP 734 提供高阶标准库接口,Python 实现了在单个操作系统进程内运行多个子解释器,且每个子解释器分配一把独立的 GIL。其内存与执行模型呈现以下三个核心特征:
- 独立的 Python 堆内存:每个子解释器拥有属于自己的 Python 对象堆、内置命名空间(
builtins)和模块缓存字典(sys.modules),解释器之间的 Python 原生对象互不干扰。 - 独立的执行线程与锁:子解释器在各自专属的系统线程中执行字节码,互不争抢 GIL,纯 Python 计算可以无阻碍地并行打满多个 CPU 核心。
- 共享的操作系统进程空间与 C 运行时:关键的限制在此产生——虽然 Python 层面的对象堆是隔离的,但它们终究处于同一个 OS 进程内,共享相同的 C 静态全局变量、动态链接库符号和 C 运行时环境。
三、阻断根源:为什么 pandas 无法在独立子解释器中加载?
既然纯 Python 代码可以在多子解释器中并行,为什么偏偏 pandas 无法加载?根本原因在于 pandas 和 NumPy 是深度依赖 C/C++ 与 Cython 编写的高性能科学计算库,其代码中包含了大量无法轻易隔离的底层状态。
1. C 静态全局变量引发的数据竞争隐患
在传统的单个全局 GIL 保护下,即使 C 扩展中定义了静态全局变量(如 static PyObject* cache; 或全局状态标记),也因为任何时刻只有一个线程在执行 Python 相关操作,这些 C 变量在宏观上是线程安全的。然而,当两个子解释器分别持有各自独立的 GIL #0 和 GIL #1 时,它们派生的线程就可能在完全相同的瞬间,向同一个 C 全局内存地址发起写入!这会导致灾难性的内存覆盖、野指针和段错误(Segmentation Fault)。
2. PEP 489 多阶段初始化与模块状态隔离要求
为了从源头杜绝这种内存损坏,Python 官方制定了严格的扩展规范(PEP 489 与 PEP 684):任何允许在独立 GIL 子解释器中加载的 C 扩展,必须满足两个前置条件:
- 实现模块状态动态分配:所有原本存放在 C 全局变量中的状态,必须改造成挂载在模块对象内部(通过
PyModule_GetState获取),确保每个子解释器持有一份专属的模块状态副本。 - 显式声明支持标志:模块定义槽中必须显式声明
Py_mod_multiple_interpreters槽位,并设置为Py_MOD_PER_INTERPRETER_GIL_SUPPORTED。
在 Python 3.14 中,动态加载器(_imp)在载入 C 扩展时会逐一核验该标志。如果某个模块底层依赖了未声明该支持的 C 扩展(例如 pandas._libs 中的 Cython 动态库,或是 NumPy 的底层内核),Python 会立刻主动抛出 ImportError,拒绝完成初始化以确保运行时安全。
四、实测排查:在 Python 3.14 中复现与验证
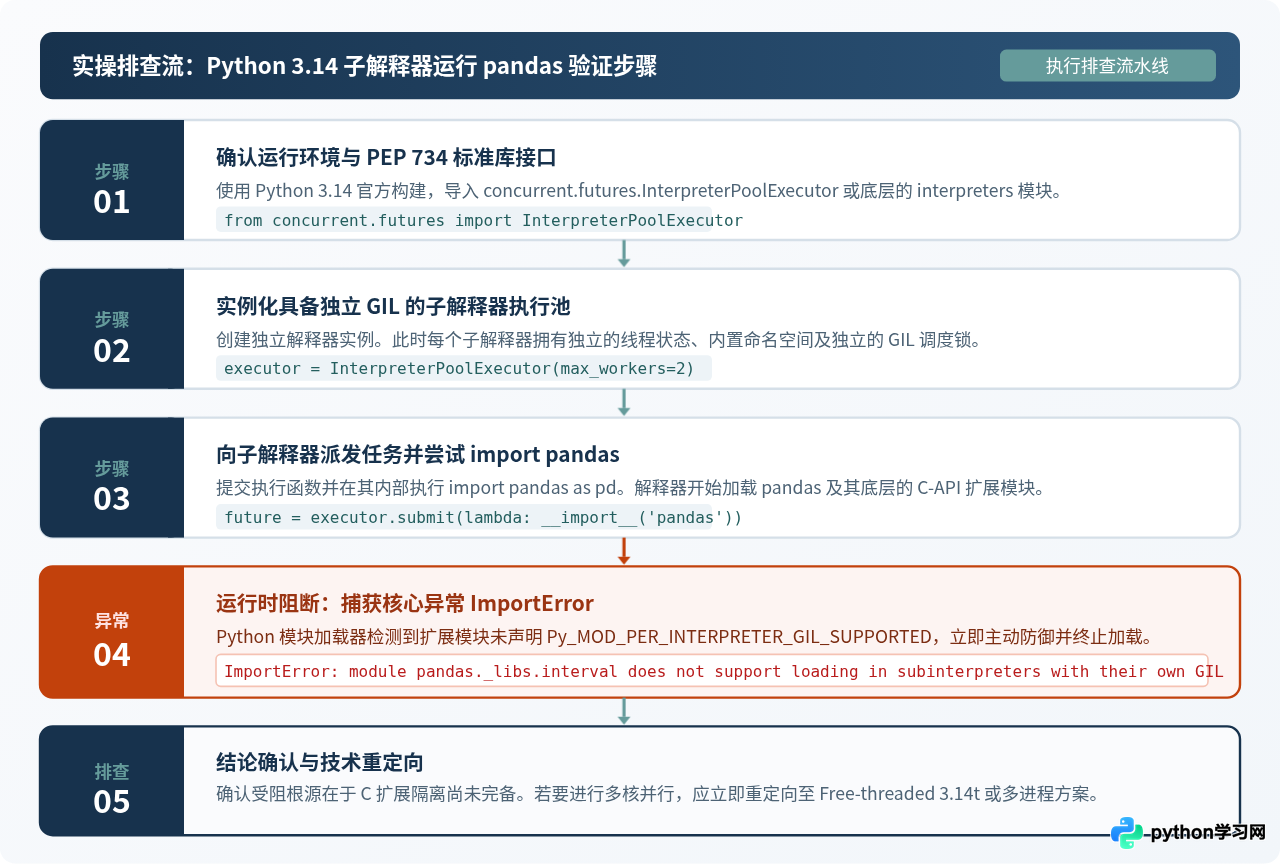
我们可以编写一段简短的标准测试脚本,利用 Python 3.14 提供的 concurrent.futures.InterpreterPoolExecutor 接口,直观验证这一行为:
# 验证脚本:test_subinterpreter_pandas.py
# 运行环境:Python 3.14.0+ (标准构建版本)

from concurrent.futures import InterpreterPoolExecutor

def worker_task():
    try:
        # 在独立的子解释器线程中尝试导入 pandas
        import pandas as pd
        return f"加载成功,pandas 版本: {pd.__version__}"
    except Exception as exc:
        return f"捕获异常 [{type(exc).__name__}]: {exc}"

def main():
    print("正在创建 Python 3.14 独立 GIL 子解释器执行池...")
    # 初始化包含 2 个子解释器的执行池
    with InterpreterPoolExecutor(max_workers=2) as executor:
        future = executor.submit(worker_task)
        result = future.result()
        print("子解释器执行结果:")
        print(result)

if __name__ == "__main__":
    main()
在终端中执行该脚本,你会看到如下示例执行结果:
# 示例控制台输出
正在创建 Python 3.14 独立 GIL 子解释器执行池...
子解释器执行结果:
捕获异常 [ImportError]: module pandas._libs.interval does not support loading in subinterpreters with their own GIL
整个调用链的拦截逻辑清晰可见:子解释器初始化正常完成,但在执行到 import pandas 时,底层加载链触发了 pandas._libs.interval 的初始化,而该动态扩展因未完成 Per-Interpreter 状态重构,触发了加载器的安全断路器。
五、澄清关键混淆:子解释器 vs 自由线程 (nogil)
很多开发者之所以对子解释器能否跑 pandas 产生困惑,主要是将 Python 3.13/3.14 中的两项重大多核技术演进混为一谈了:
- 路线一:子解释器独立 GIL(PEP 684 / PEP 734)
特点是“一个进程内存在多个解释器,各自有各自的 GIL”。它的优势是解释器级别的强隔离,适合用来运行相互独立的租户插件、无状态的轻量 Web 路由、微服务沙箱等纯 Python 逻辑。但正因为隔离边界严格,对底层 C 扩展的改造阻力极大,短期内无法服务于 pandas。 - 路线二:自由线程 Python(Free-threaded Python / PEP 703,即常说的 nogil 构建)
特点是“只有一个主解释器,但彻底移除了全局 GIL”。所有标准线程(threading)共享同一个对象堆,并且直接在硬件层通过原子操作、分布式引用计数与偏向锁保护内存。这才是科学计算和数据工程真正的主战场。
事实上,NumPy、pandas 和 Cython 社区在过去一年中倾注了大量资源适配的正是自由线程构建(python3.14t)。在专门的无 GIL 构建版本中,官方已经提供了对应的预编译二进制包(Wheel),允许开发者在标准线程池中直接并行跑 pandas 代码。
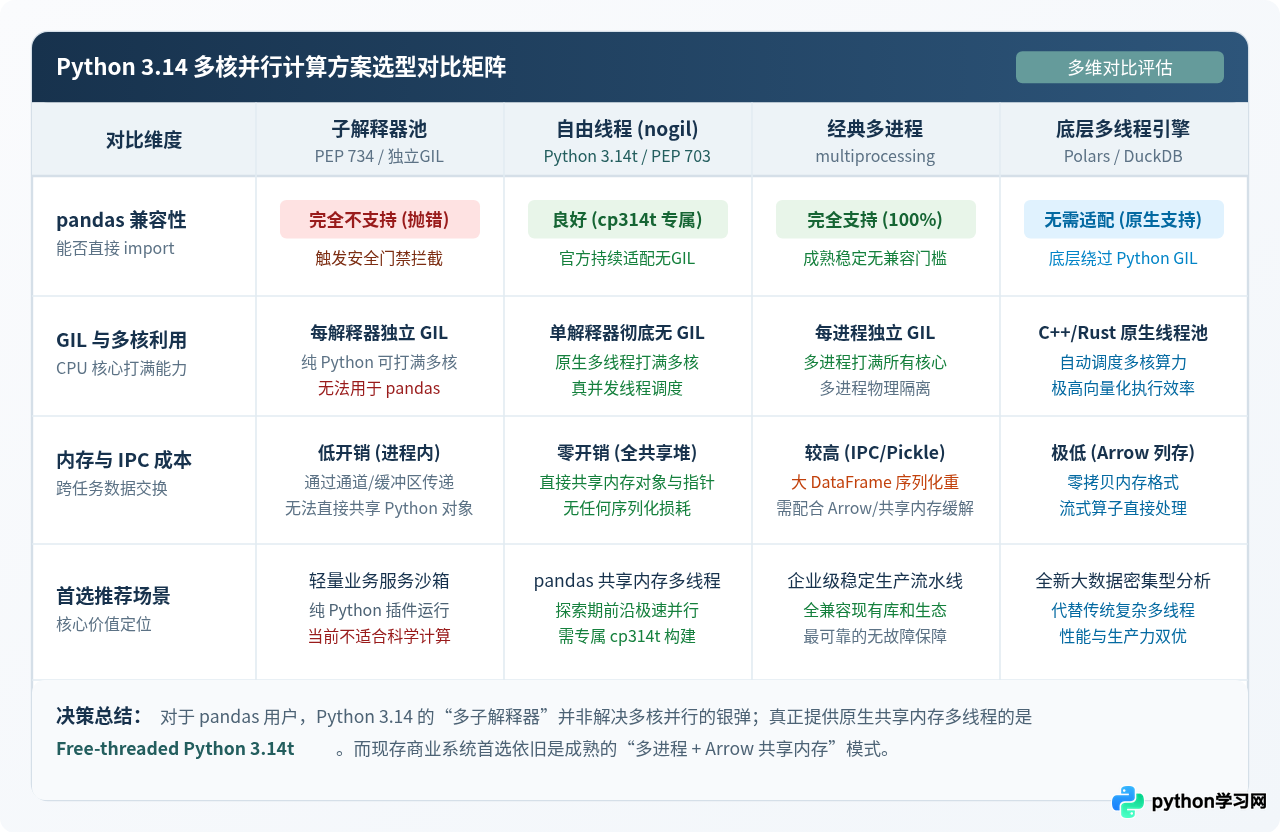
六、现阶段并行跑 pandas 的三种实用方案
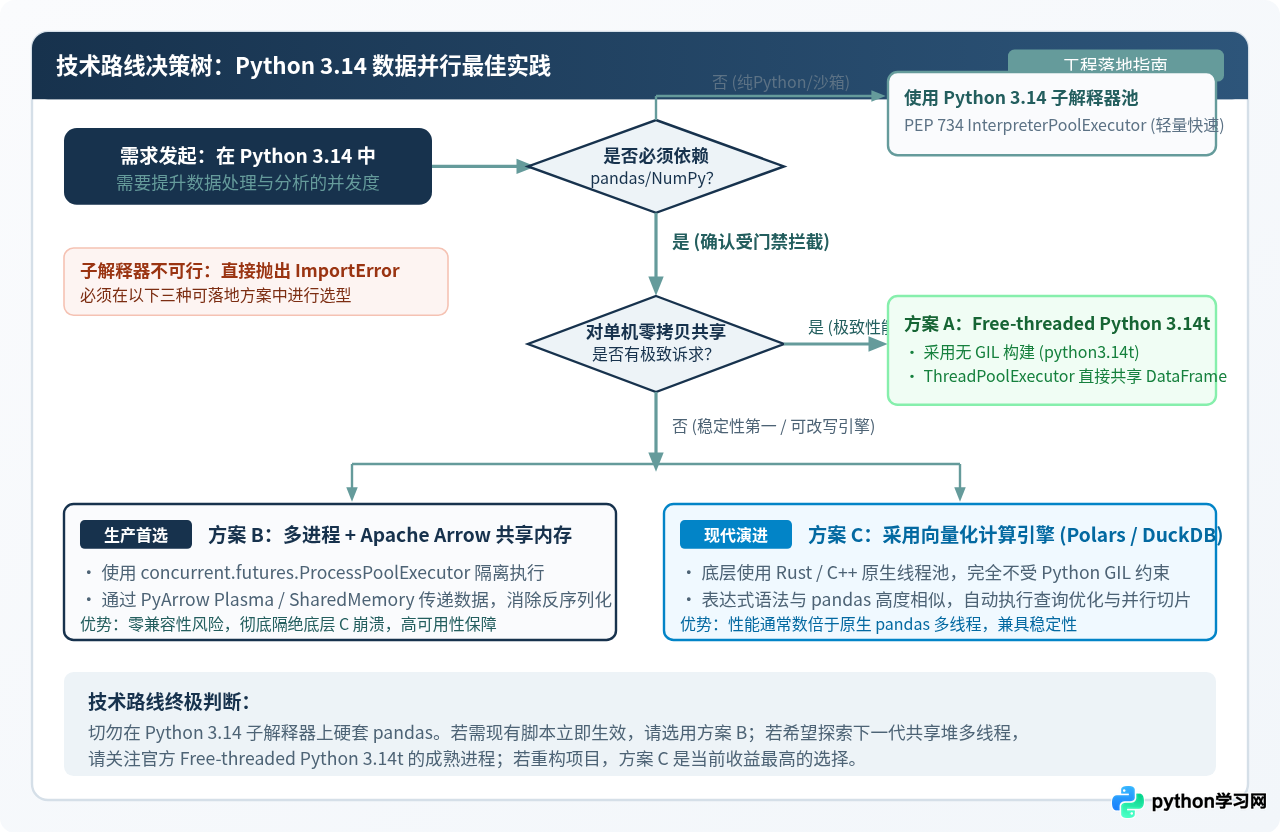
既然子解释器当前无法满足需求,我们在 Python 3.14 环境下进行多核数据处理时,应当采取哪些切实可行的方案?根据工程场景与系统要求,以下三种方式能够直接解决问题:
方案 1:选用 Free-threaded Python 3.14t(无 GIL 构建版本)
如果你希望在单一进程内利用原生多线程处理共享内存中的 pandas DataFrame,且不需要承担进程间通信的序列化开销,直接采用官方无 GIL 构建是官方认可的发展方向:
- 安装无 GIL 的 Python 二进制(在可执行文件名带有
t标记,如python3.14t)。 - 安装针对
cp314t编译的 pandas 和 numpy。 - 直接使用标准库的
concurrent.futures.ThreadPoolExecutor派发数据切片计算任务,多线程将真正同时占用多个物理 CPU 核心。
方案 2:经典而成熟的多进程 + Apache Arrow 共享内存(企业生产首选)
在追求 100% 稳定性和零适配风险的生产环境中,多进程模式(multiprocessing)仍然是当前的黄金标准。为了避免多进程间传统 Pickle 序列化带来的巨大性能消耗,现代工程实践通常采用“Arrow 零拷贝”管道:
# 生产推荐范式:ProcessPoolExecutor + PyArrow / IPC
from concurrent.futures import ProcessPoolExecutor
import multiprocessing as mp

def process_chunk(chunk_id, file_path):
    import pandas as pd
    import pyarrow.parquet as pq
    # 每个子进程独立初始化,享有完整的 C 扩展支持
    table = pq.read_table(file_path)
    df = table.to_pandas()
    # 执行复杂聚合或模型转换
    summary = df.groupby("category")["amount"].sum()
    return chunk_id, summary.to_dict()

if __name__ == "__main__":
    # 设置 forkserver 或 spawn 保证 C 扩展的绝对安全
    mp.set_start_method("spawn", force=True)
    with ProcessPoolExecutor(max_workers=4) as pool:
        # 分布式派发数据块处理
        futures = [pool.submit(process_chunk, i, f"data_part_{i}.parquet") for i in range(4)]
        results = [f.result() for f in futures]
        print(f"成功聚合 {len(results)} 组分块结果")
方案 3:迁移至向量化多线程引擎(Polars / DuckDB)
如果数据计算逻辑容易抽象为表关联、窗口分析或分组聚合,将分析层逐步过渡到 Polars 或 DuckDB 往往能获得更极致的多核性能。这些引擎的底层由 Rust 或 C++ 编写,内部自带高吞吐的原生线程池,完全绕开了 Python 解释器锁,无需用户手动维护复杂的并发调度代码。
七、总结与选型建议
最后,让我们清晰梳理本文的技术结论与实践建议:
- 明确结论:Python 3.14 的多个子解释器目前无法并行运行 pandas。当你尝试在独立 GIL 的子解释器中引入 pandas 时,由于其依赖的底盘 C/Cython 扩展未实现模块状态隔离,Python 安全门禁会主动抛出
ImportError。 - 定位区分:PEP 734 子解释器当前主要定位于纯 Python 业务逻辑与轻量服务的高速隔离运行;如果你追求的是在单个 Python 解释器内打满多核运行科学计算,应当关注并尝试 Free-threaded Python 3.14t(PEP 703)。
- 生产选型:现阶段企业级数据并行处理,最为稳健可靠的做法依然是基于
multiprocessing.ProcessPoolExecutor,并搭配 Apache Arrow 或共享内存来化解数据搬运成本;在新项目架构中,适度引入 Polars 或 DuckDB 同样是提升吞吐的高收益方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















