


Python适合做什么工作?数据分析师与后端工程师的技能匹配指南
深入解析Python在数据分析师与后端工程师两大岗位的核心工作职责、技术栈差异、实战代码与进阶学习路径。通过架构对比图、技术矩阵与决策指南,帮助开发者准确评估技能匹配度与职业方向。
掌握 Python 语法后,许多学习者常常困惑于未来的职业发展切入点。在当前的软件与互联网生态中,Python 最成熟、岗位需求最集中的两大就业方向分别是数据分析师与后端工程师。本文直接对比这两个方向的岗位职责差异、核心技术栈、实际代码形态与技能成长路径,帮助你结合自身的逻辑习惯与专业背景做出精准匹配。
一、岗位定位与核心工作职责拆解
虽然数据分析师与后端工程师都以 Python 为核心开发语言,但两者的业务场景和解决的问题存在本质分野。明确两者的日常职责,是评估自身是否适合的前提。
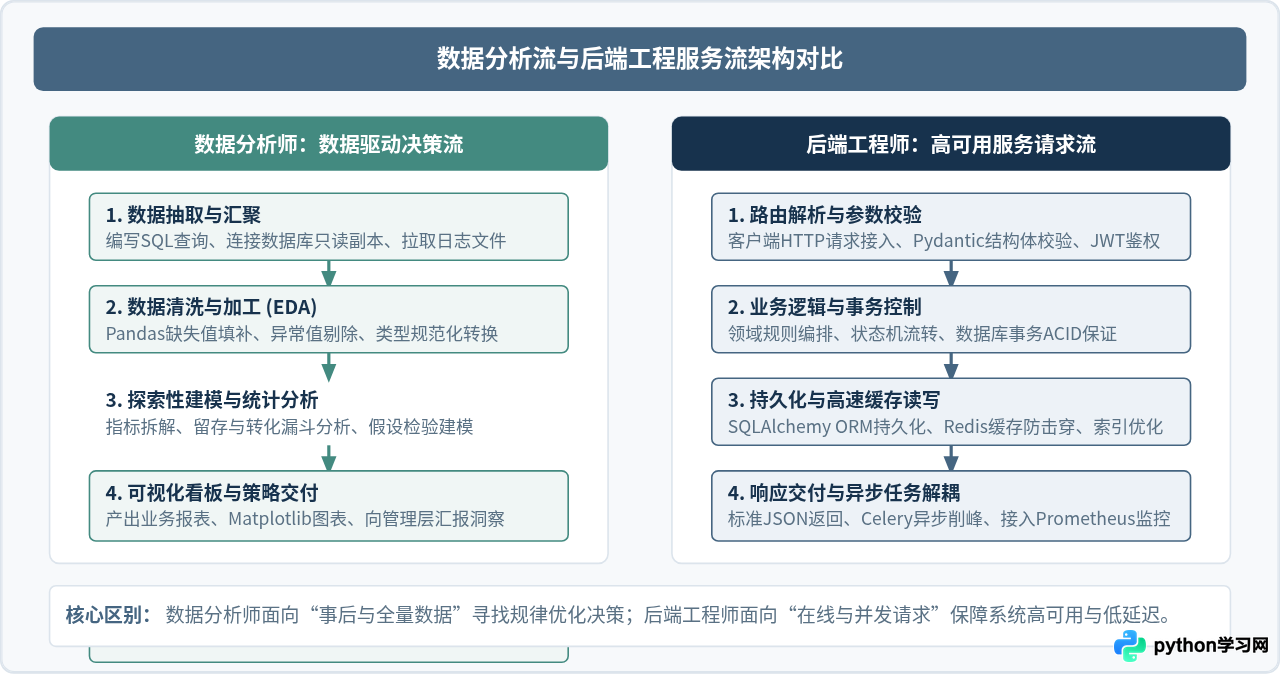
1. 数据分析师:面向业务与决策的数据探索者
数据分析师的主要目标是从已产生的数据中提取价值,通过分析业务指标的变化趋势,解释“发生了什么”以及“为什么会发生”,最终为管理层或业务团队提供可落地的策略建议。其日常工作主要包括:
- 数据提取与汇聚:通过编写 SQL 语句从业务数据库、数据仓库或数据湖中抽取原始订单、用户行为和活动日志。
- 探索性数据分析(EDA):使用 Pandas 处理脏数据、填补缺失值、剔除刷单或测试产生的异常离群点,对数据进行格式标准化。
- 指标建模与归因分析:拆解留存率、转化漏斗、用户生命周期价值(LTV)等关键指标,通过统计对比或回归分析定位业绩波动的原因。
- 可视化报告交付:通过图表或 BI 看板直观展现数据规律,将技术分析结果翻译成业务团队易懂的决策建议。
2. 后端工程师:面向高可用与并发的系统构建者
后端工程师的核心任务是构建稳定、可靠、高效的在线软件系统,负责处理客户端发起的实时请求,保障数据持久化安全与系统高并发吞吐。其日常工作主要包括:
- API 接口设计与开发:基于 FastAPI、Django 或 Flask 编写符合 RESTful 规范的后端接口,制定严密的数据出入参校验规则。
- 业务逻辑与状态机实现:编写满足实际交易、订单状态流转、用户权限鉴权的业务代码,确保在各种并发情况下状态转换严谨准确。
- 数据持久化与数据库设计:设计关系型数据库的表结构、主外键索引,使用 SQLAlchemy 等 ORM 工具操作数据,保证事务的 ACID 特性。
- 性能调优与异步解耦:利用 Redis 缓存高频热点数据,运用 Celery 异步队列解耦邮件发送、耗时文件生成等重型计算任务。
二、核心技术栈与实战代码形态对比
工具链的选择直接反映了岗位日常思维方式的不同。数据分析强调的是对向量化表格数据的快速过滤与统计,而后端工程则强调对象建模、请求拦截与异常防御。
1. 数据分析实战代码示例:订单数据聚合分析
在数据分析场景中,工程师通常在 Jupyter Notebook 或分析脚本中加载数据表,进行链式调用清洗和多维度分组统计。以下示例展示了使用 Pandas 过滤异常订单并按商品品类统计核心指标的典型写法:
import pandas as pd

# 1. 模拟业务交易原始数据记录
data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105", "A106"],
    "category": ["电子", "家居", "电子", "美妆", "家居", "电子"],
    "amount": [1299.0, 89.5, 4599.0, 320.0, -10.0, 899.0],  # 含有测试异常金额
    "order_status": ["completed", "completed", "completed", "pending", "failed", "completed"]
}

df = pd.DataFrame(data)

# 2. 数据清洗:剔除异常金额与未支付完成的订单
valid_mask = (df["amount"] > 0) & (df["order_status"] == "completed")
cleaned_df = df[valid_mask].copy()

# 3. 核心业务指标聚合:统计各品类订单数、总营收与平均客单价
summary = (
    cleaned_df.groupby("category")
    .agg(
        order_count=("order_id", "count"),
        total_revenue=("amount", "sum"),
        avg_order_value=("amount", "mean")
    )
    .reset_index()
)

print(summary)
示例输出:
  category  order_count  total_revenue  avg_order_value
0       家居            1           89.5            89.50
1       电子            3         6797.0          2265.67
2. 后端开发实战代码示例:FastAPI 接口与入参校验
在后端服务场景中,代码必须严谨防御无效请求,执行类型校验,并在发生错误时返回合乎规范的 HTTP 状态码。以下示例展示了使用 FastAPI 和 Pydantic 构建创建订单接口的典型工程实现:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="订单服务示例")

# 1. 定义请求数据契约与校验规则
class OrderCreateRequest(BaseModel):
    user_id: int = Field(gt=0, description="下单用户ID,必须为正整数")
    category: str = Field(min_length=2, max_length=20, description="商品品类")
    amount: float = Field(gt=0, description="订单金额,必须大于0")

# 2. 定义返回响应结构
class OrderResponse(BaseModel):
    order_id: str
    status: str
    amount: float

# 3. 注册订单创建路由
@app.post("/api/v1/orders", response_model=OrderResponse, status_code=status.HTTP_201_CREATED)
async def create_order(payload: OrderCreateRequest):
    # 模拟风控业务规则检查
    if payload.amount > 50000.0:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="单笔订单金额超出风控限额,请使用大额支付通道"
        )

    # 模拟数据库持久化成功后的数据返回
    return {
        "order_id": "ORD-20261010-0982",
        "status": "created",
        "amount": payload.amount
    }
示例交互输出(模拟 HTTP 客户端请求):
POST /api/v1/orders HTTP/1.1
Content-Type: application/json
{"user_id": 108, "category": "电子", "amount": 1299.0}

HTTP/1.1 201 Created
Content-Type: application/json
{"order_id": "ORD-20261010-0982", "status": "created", "amount": 1299.0}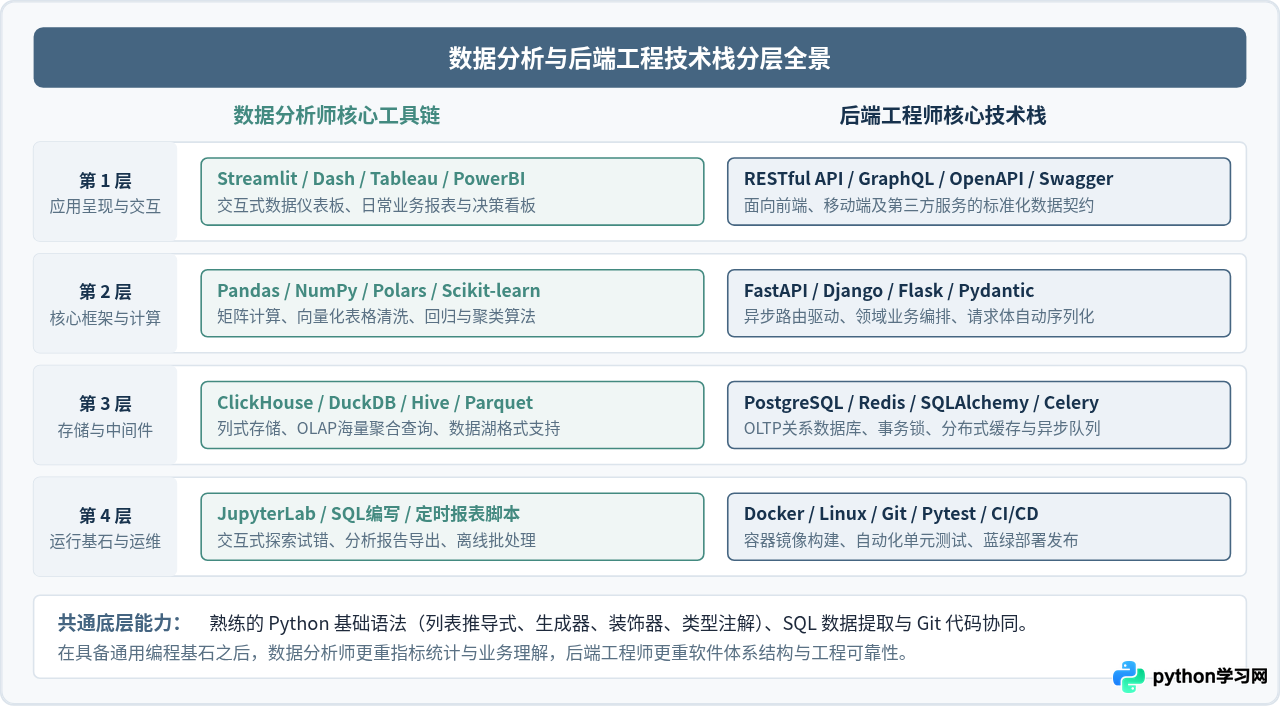
三、从零到就业:技能成长进阶四阶段实施路径
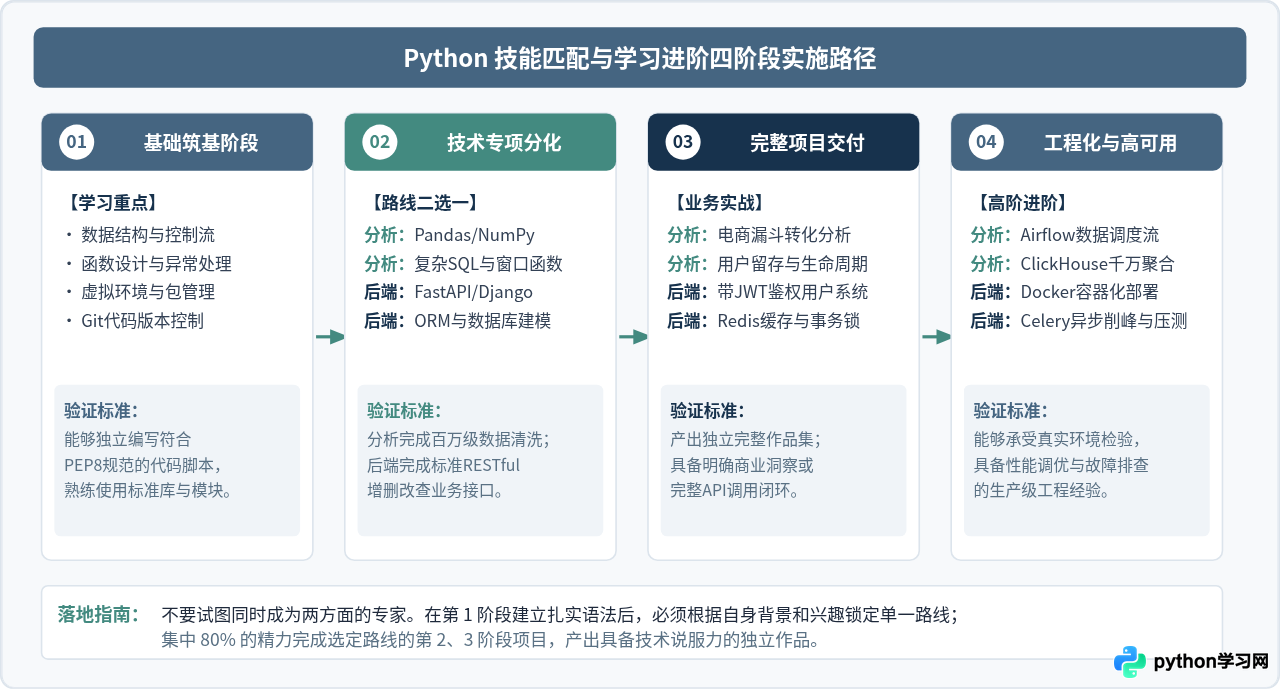
掌握知识需要合理的先后次序。无论你倾向于哪个岗位,都应当经历“通用语言筑基”、“专业技术分化”、“完整项目交付”与“工程化深化”四个阶段。
- 阶段一:语言核心与工程习惯(通用基础):
掌握 Python 基础语法、列表推导式、生成器、面向对象(OOP)、装饰器与异常捕获;熟悉虚拟环境隔离工具(如 venv 或 uv);掌握 Git 分支管理与代码提交规范。此阶段确保编写的代码符合 PEP8 规范且具备良好的可读性。
- 阶段二:专项技术技术栈分化(定向突破):
根据方向二选一:若走数据分析,深入掌握 Pandas 复杂分组变换、NumPy 矩阵运算与 SQL 窗口函数;若走后端开发,深入掌握 FastAPI/Django 框架原理、关系型数据库设计范式与 SQLAlchemy ORM。
- 阶段三:端到端完整项目交付(积累成果):
分析方向应产出独立的数据分析报告或 Streamlit 交互看板(例如基于真实电商脱敏数据的留存率归因分析);后端方向应产出具备 JWT 认证、RBAC 权限控制、Redis 缓存与完整 API 契约的在线系统。
- 阶段四:生产环境与高阶工程化(突破壁垒):
分析方向进一步掌握 Airflow 自动化数据流调度或 ClickHouse 列存加速;后端方向进一步掌握 Docker 容器化打包、Nginx 反向代理、Celery 异步队列解耦与并发性能压测。
四、职业选择与个人技能匹配决策指南
技术最终服务于个人职业规划。面对两个方向,读者应当结合个人的学术背景、思维习惯以及对不同类型工作的兴趣做出决策。
• 倾向于数据分析师的信号:对商业运作规律感兴趣,热衷于发现“为什么上周营业额骤降”,喜欢把技术结论做成图表向非技术同事讲明白,具备统计学或经管背景。
• 倾向于后端工程师的信号:对计算机底层和软件架构充满好奇,热衷于钻研“如何让系统支撑每秒一万次请求”,追求优雅的代码组织、事务一致性与高容错性,具备计算机或工科背景。
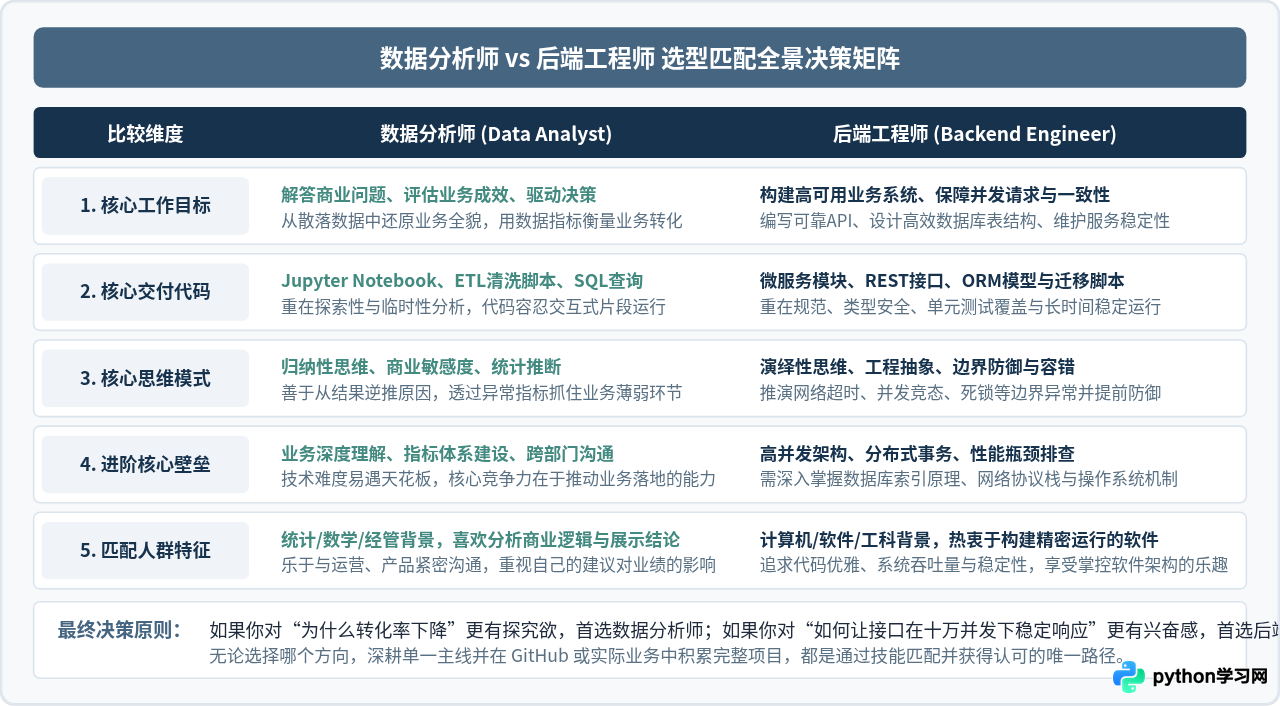
五、综合对比总结表
下表归纳了两个方向在岗位要求、考核重点与发展路径上的核心参数,便于直观核对:
| 评估维度 | 数据分析师 (Data Analyst) | 后端工程师 (Backend Engineer) |
|---|---|---|
| 主要服务对象 | 产品经理、运营团队、企业高管与决策层 | 前端工程师、移动端工程师、下游微服务系统 |
| 核心交付物 | 数据分析报告、Jupyter Notebook、BI仪表盘 | RESTful API、微服务模块、数据库表与迁移脚本 |
| 高频核心库 | Pandas, NumPy, Matplotlib, Seaborn, SQL | FastAPI, Django, SQLAlchemy, Pydantic, Celery |
| 核心考核指标 | 分析洞察深度、数据准确率、业务策略落地效果 | 接口响应延迟(P99)、系统可用性(SLA)、故障率 |
| 进阶技术瓶颈 | 业务全流程理解、大数据数仓架构、因果推断 | 高并发分布式架构、数据库死锁与慢查询优化、微服务治理 |
| 建议起步重点 | 精通 SQL 复杂查询 + Pandas 向量化数据清洗 | 精通 FastAPI 接口编写 + 关系数据库表结构设计 |
明确目标后,避免同时在两个方向上浅尝辄止。选定一条与自身优势高度匹配的主线,在完成语言基础筑基后集中精力完成一个具备工程深度或商业价值的独立实战项目,是进入专业技术领域的最高效路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















