


Python无法识别GPU或CUDA版本不兼容怎么解决
针对Python无法识别GPU及CUDA版本不兼容问题,本文详细梳理硬件驱动、CUDA运行时与深度学习框架的版本依赖关系,提供从环境排查、版本匹配、正确安装到代码验证的完整解决方案。
在Python开发深度学习或GPU加速程序时,调用 torch.cuda.is_available() 返回 False,或者运行代码时抛出 CUDA driver version is insufficient for CUDA runtime version 等报错,是环境搭建中最常见的障碍。这类问题绝大多数并非物理显卡损坏,而是宿主机显卡驱动、系统或运行时依赖的CUDA版本,以及Python框架包(如PyTorch、TensorFlow)所绑定的CUDA版本三者存在脱节,或是在安装时误装了默认的CPU版本。排查并解决这一问题的标准路径包括:首先检查NVIDIA驱动与硬件识别状态,厘清驱动支持上限与框架所需版本的关系,随后在独立的虚拟环境中重新安装与显卡驱动兼容的GPU版框架,并通过交互式张量计算验证硬件调用的完整性。
一、排查起点:使用 nvidia-smi 确认硬件与显卡驱动状态
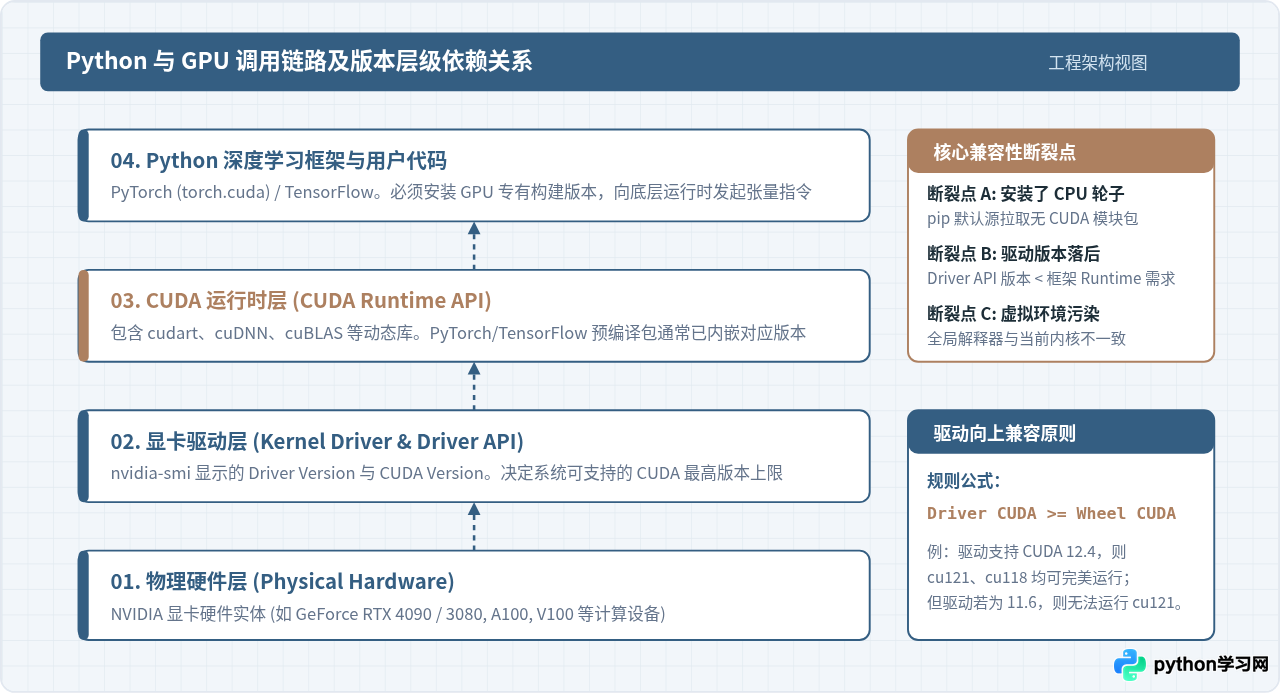
排查的第一步不是重新安装 Python,而是确认操作系统是否已经成功挂载显卡以及安装了可用的显卡驱动。在操作系统终端(Windows 的 PowerShell/CMD 或 Linux 终端)中执行显卡监控指令:
nvidia-smi该命令的输出包含两项最关键的版本指标:Driver Version(显卡驱动版本)与 CUDA Version(该驱动能支持的最高 CUDA 运行库版本)。以下为典型正常输出示例:
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 535.129.03             Driver Version: 535.129.03   CUDA Version: 12.2     |
|-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 4090        Off |   00000000:01:00.0 Off |                  N/A |
| 31%   38C    P8             18W /  450W |       1MiB /  24564MiB |      0%      Default |
+-----------------------------------------+------------------------+----------------------+
根据执行结果,可能出现以下三种情况:
- 提示命令不存在(command not found 或 不是内部或外部命令):说明系统尚未安装 NVIDIA 独立显卡驱动,或者未将 NVIDIA 驱动目录加入系统环境变量。此时需要先前往 NVIDIA 官网下载并安装对应显卡型号的最新驱动。
- 提示 NVIDIA-SMI has failed because it couldn't communicate with the NVIDIA driver:这在 Linux 系统内核更新后非常普遍,原因是旧版内核模块与新内核不匹配,通常需要重启或通过 DKMS 重新编译驱动模块。
- 正常输出表格:记录表格右上角的
CUDA Version数值(如示例中的 12.2)。这代表系统当前驱动所支持的最高 CUDA 运行时上限。在后续选择 PyTorch 或 TensorFlow 安装包时,其所带的 CUDA 版本必须小于或等于该数值。
二、厘清核心概念:Driver API 与 Runtime API 的区别
不少开发者常被 nvidia-smi 与 nvcc -V 显示的两个不同 CUDA 版本所困扰。要准确解决兼容性问题,必须区分两者背后的机制:
- CUDA Driver API(系统驱动层):由显卡驱动文件(如 Windows 的
nvcuda.dll或 Linux 的libcuda.so)提供,版本由安装的显卡驱动决定。nvidia-smi显示的就是该驱动支持的最高 CUDA 版本。 - CUDA Runtime API(运行时库层):由 CUDA Toolkit 提供的
cudart运行库提供,通常是nvcc -V显示的版本。
在现代 Python 深度学习生态中(尤其是官方 PyTorch 轮子包),PyTorch 在安装 wheel 包时已经自带了其所需的完整 CUDA 运行时二进制库。也就是说,普通用户在系统全局不需要单独安装庞大(数个GB)的 NVIDIA CUDA Toolkit,也不需要配置 nvcc。只要宿主机的 nvidia-smi 驱动版本支持的 CUDA 上限大于等于 PyTorch 轮子内嵌的 CUDA 版本,Python 就能直接调用 GPU。
三、排查现有 Python 环境:确认是否误装了 CPU 轮子
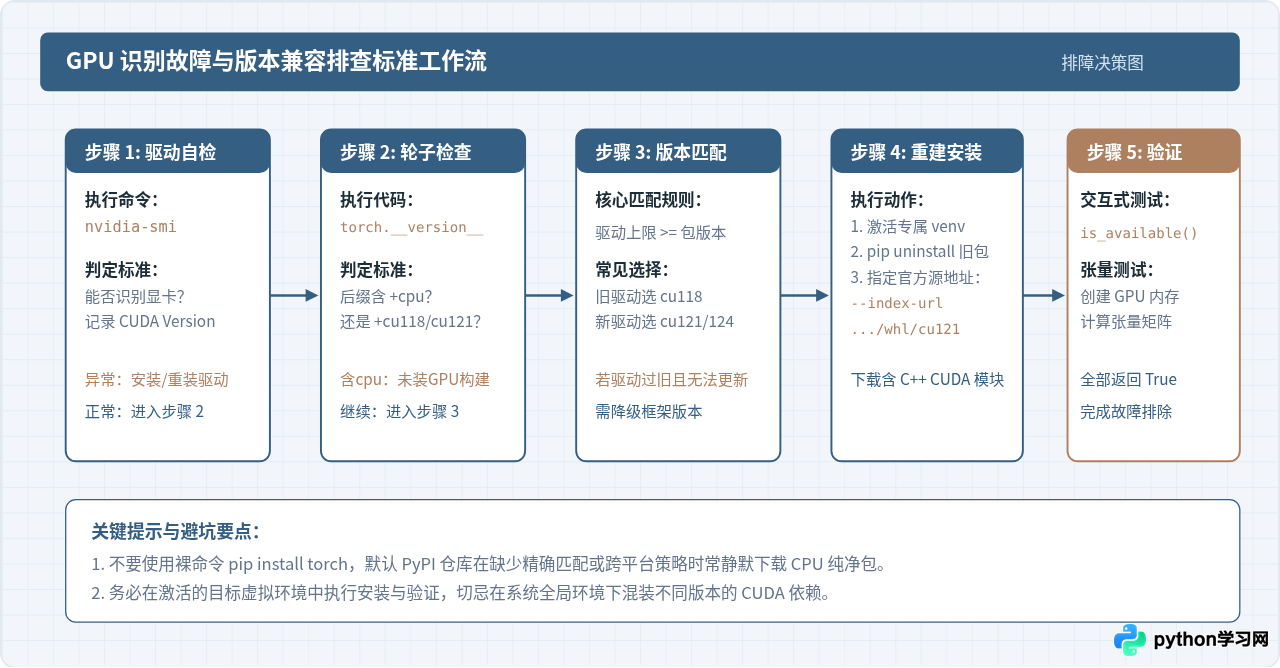
绝大多数直接在命令行运行 pip install torch 的用户,都会遭遇 GPU 无法识别的问题。原因在于 PyPI 官方镜像库为了包体积控制以及兼容没有独立显卡的普通电脑,直接执行 pip install torch 安装的往往是体积仅有 100~200MB 的 CPU 专属编译版本,完全剥离了 CUDA 的底层支持代码(带 CUDA 的 PyTorch 轮子通常在 2GB 以上)。
读者可以在终端中启动 Python 交互环境,打印当前安装的 PyTorch 版本与 CUDA 编译信息:
import torch
print("当前 PyTorch 版本:", torch.__version__)
print("绑定的 CUDA 版本:", torch.version.cuda)
输出结果通常有以下两种典型情况:
- 版本号带有
+cpu(如2.2.0+cpu)或torch.version.cuda返回None:这证明当前安装的是纯 CPU 版本。无论显卡驱动多么先进,该包都不包含 GPU 通信逻辑。 - 版本号带有
+cu121(如2.2.0+cu121)但is_available()仍为False:这说明框架是 GPU 版本,但当前电脑的显卡驱动版本落后于 CUDA 12.1 所需的驱动底线,此时需要升级显卡驱动,或将 PyTorch 更换为 CUDA 11.8 构建版本。
四、版本匹配选择与正确安装方法
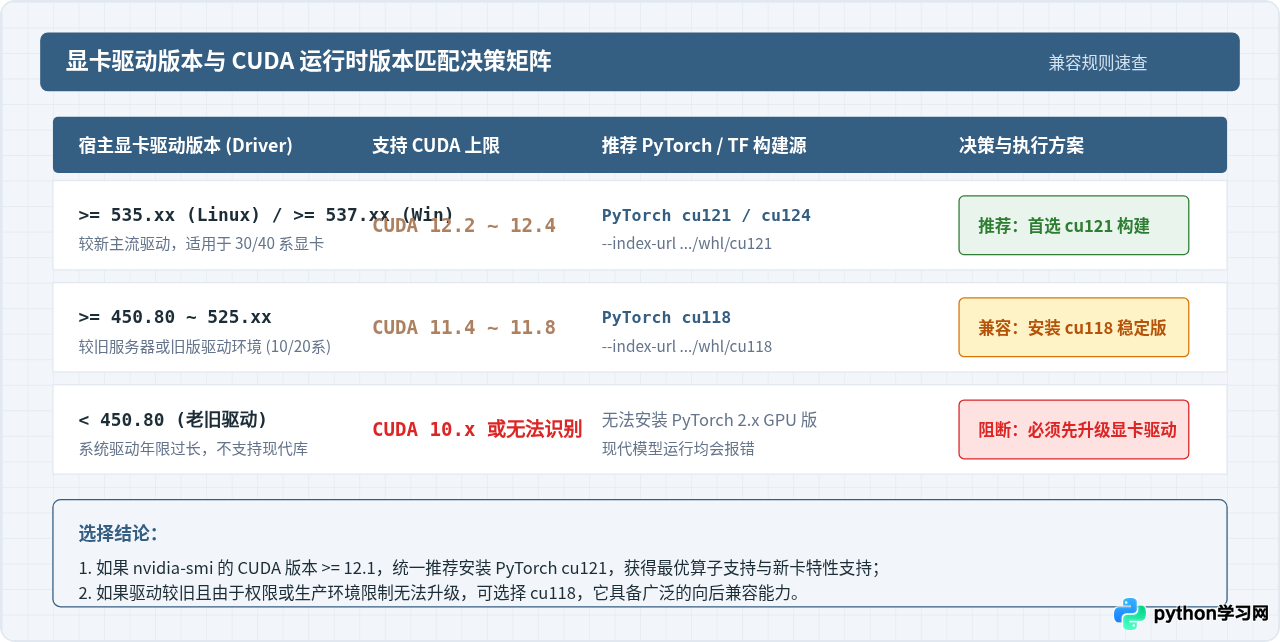
安装前,先依据 nvidia-smi 查看到的驱动支持上限选择合适的安装包。NVIDIA 官方驱动对 CUDA 具有向后兼容特性:高版本驱动可以运行基于低版本 CUDA 编译的程序,但低版本驱动绝对无法运行基于高版本 CUDA 编译的程序。
1. 正确安装 GPU 版 PyTorch
为了防止全局已有环境的库污染,强烈建议先创建并激活一个独立的虚拟环境(例如使用 venv 或 conda),然后卸载旧的 CPU 包并指定官方专用下载源:
# 激活虚拟环境后,彻底卸载现存的 CPU 版本
pip uninstall torch torchvision torchaudio -ypip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118注意:参数 --index-url https://download.pytorch.org/whl/cu121 是关键所在。它强制 pip 从 PyTorch 官方构建的 CUDA 专属仓库中拉取包含底层 C++ CUDA 动态运行库的安装包,下载体积一般在 2.4GB 到 2.8GB 左右。如果下载包仅几十兆或几百兆,说明依然拉取到了错误版本。
2. TensorFlow 2.x 的 GPU 环境说明
对于使用 TensorFlow 的读者,需要注意版本生态的变动:自 TensorFlow 2.11 起,官方停止了在 Windows 原生系统上的 GPU 支持(Windows 下需借助 WSL2 使用 GPU)。在 Linux 环境下,TensorFlow 2.x 会在调用时寻找系统的 libcudart.so 与 libcudnn.so,可以通过 pip 安装对应的 NVIDIA 运行时全家桶:
pip install tensorflow
pip install nvidia-cudnn-cu11 nvidia-cublas-cu11
五、最终验证:使用完整 Python 脚本进行硬件与张量计算核验
安装完成后,不要仅凭命令执行无报错就断定配置成功,必须在 Python 解释器中实际创建一个 GPU 上的张量并执行一次运算,以确认主机内存与显存之间的数据交换畅通无阻。
import sys
import torch

def verify_gpu_setup():
    print(f"Python 解释器路径: {sys.executable}")
    print(f"PyTorch 核心库版本: {torch.__version__}")
    print(f"PyTorch 编译 CUDA 版本: {torch.version.cuda}")

    is_available = torch.cuda.is_available()
    print(f"CUDA 可用性 (is_available): {is_available}")

    if not is_available:
        print("\n[排查提示] CUDA 不可用,请复查:")
        print("1. nvidia-smi 能否正常检测到显卡。")
        print("2. 安装的 PyTorch 版本号中是否含有 +cpu 后缀。")
        print("3. 当前使用的 Python 解释器是否为你安装 GPU 包的虚拟环境。")
        return False

    device_count = torch.cuda.device_count()
    print(f"检测到可用 GPU 数量: {device_count}")

    for i in range(device_count):
        print(f"设备 [{i}]: {torch.cuda.get_device_name(i)}")
        print(f"  显存总量: {torch.cuda.get_device_properties(i).total_memory / (1024**3):.2f} GB")

    print("\n[开始显存张量运算测试...]")
    # 在 GPU 0 上初始化两个 3x3 矩阵并执行矩阵乘法
    device = torch.device("cuda:0")
    a = torch.ones((3, 3), device=device)
    b = torch.ones((3, 3), device=device) * 2
    c = torch.matmul(a, b)

    print("运算结果输出:")
    print(c)
    print("\n[验证成功] 物理 GPU 识别正常,显存数据交换与 CUDA 核函数运行无误!")
    return True

if __name__ == "__main__":
verify_gpu_setup()Python 解释器路径: /home/user/workspace/env/bin/python
PyTorch 核心库版本: 2.2.0+cu121
PyTorch 编译 CUDA 版本: 12.1
CUDA 可用性 (is_available): True
检测到可用 GPU 数量: 1
设备 [0]: NVIDIA GeForce RTX 4090
显存总量: 23.99 GB
[开始显存张量运算测试...]
运算结果输出:
tensor([[6., 6., 6.],
[6., 6., 6.],
[6., 6., 6.]], device='cuda:0')
[验证成功] 物理 GPU 识别正常,显存数据交换与 CUDA 核函数运行无误!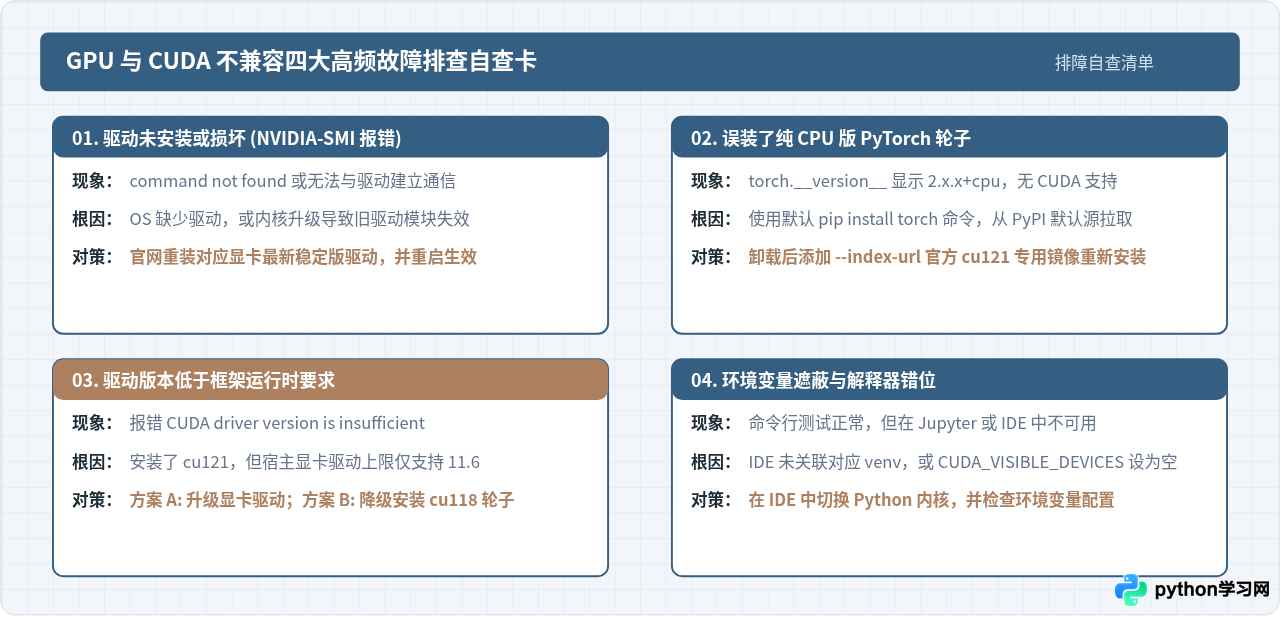
六、常见次生问题与注意事项
如果读者完成了上述匹配安装,但在特定脚本或多卡环境下依然遇到问题,可对照以下两项常见注意事项进行核对:
- 环境变量
CUDA_VISIBLE_DEVICES的设置:如果环境变量被误设为CUDA_VISIBLE_DEVICES=""(空字符串)或-1,PyTorch 会对所有物理 GPU 视而不见并直接退回 CPU 模式。应确保在代码开头或系统环境中未被误屏蔽。若要指定首张卡,应配置为export CUDA_VISIBLE_DEVICES=0。 - IDE(如 VS Code、PyCharm 或 Jupyter)的内核选择:在终端中安装了 GPU 版 PyTorch 后,务必在 IDE 的右下角或设置中将解释器精确指向该虚拟环境目录下的
python可执行文件。如果 IDE 仍然连接在系统的全局默认 Python(仅包含旧的 CPU 库),依然会出现无法识别 GPU 的假象。
总体而言,解决 Python 无法识别 GPU 和 CUDA 不兼容的本质,是建立起“物理显卡正常工作 → 宿主驱动支持上限合格 → 框架下载专属构建轮子 → 虚拟环境准确指向”这一完整链路。理清 nvidia-smi 提供的驱动上限,并通过带有 --index-url 的官方命令安装对应的预编译包,就能在绝大多数场景下直接恢复 GPU 的计算支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















