


Scrapy框架实战:构建Python爬虫项目的标准代码结构
深入讲解Scrapy爬虫框架的标准代码结构与工程化落地实践,涵盖核心分层职责、数据建模、管道清洗、生产级配置与全生命周期规范。
在网络数据抓取任务从简单的单页验证迈向规模化采集时,许多开发者会遭遇代码膨胀、逻辑耦合以及难以维护的困境。构建标准化、高内聚且低耦合的爬虫代码结构,是保障爬虫系统稳定运行、敏捷扩展与团队协作的基石。本文将聚焦于 Python Scrapy 框架,剖析其核心架构与运行机制,并手把手演示如何遵循工程最佳实践,搭建具备高可读性、高扩展性与生产级稳定性的标准项目代码结构。
一、Scrapy 核心架构与数据流协同
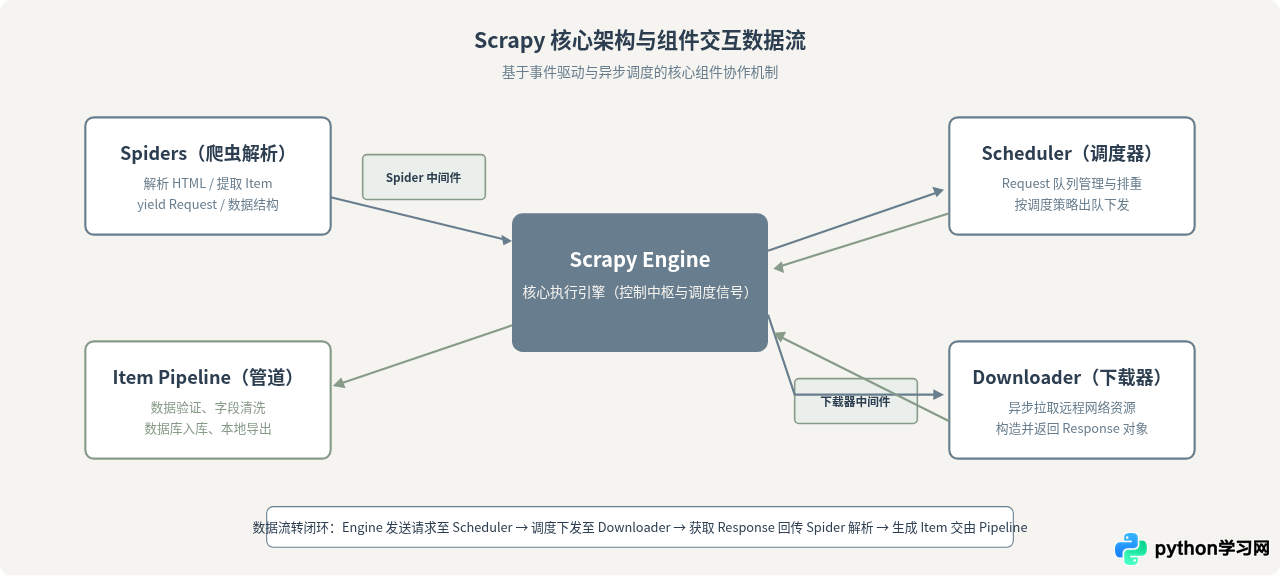
理解 Scrapy 标准代码结构的第一步,是明确其内置的组件拓扑与数据流动机制。与线性执行的脚本不同,Scrapy 采用事件驱动的异步架构(基于 Twisted),各个模块通过引擎(Engine)作为中央枢纽紧密配合,形成清晰的职责闭环。
在该架构中,引擎负责控制所有组件之间的数据信号流;调度器(Scheduler)接收引擎发来的请求并进行队列管理与排重;下载器(Downloader)抓取网页内容并将响应(Response)交还引擎;爬虫解析器(Spider)提取数据产生 Item 或派生新的请求;最后,数据管道(Item Pipeline)负责清洗、校验及持久化存储。中间件(Middlewares)则提供了在请求进入下载器之前、以及响应抵达爬虫之前的灵活拦截钩子。
二、架构选型对比:单文件脚本 vs Scrapy 标准结构
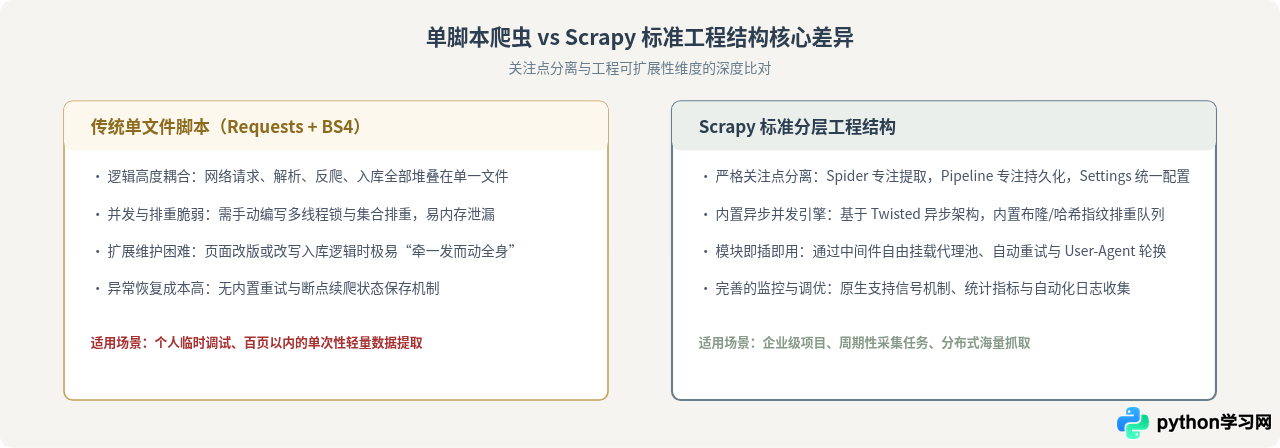
许多初学者习惯于编写一个包含 requests.get()、正则表达式或 BeautifulSoup 解析以及数据库连接的单文件脚本。在简单、一次性的数据抓取中,单脚本确实具备快速见效的优势。然而,一旦面对多页面翻页、反爬应对、增量更新和多目标存储等复杂需求时,两者在维护成本和系统健壮性上展现出显著差异。
标准工程结构之所以关键,在于它实现了“关注点分离”(Separation of Concerns)。当网站的 HTML 结构发生变化时,开发者只需定位并修改对应的 Spider 解析函数;当需要更换入库介质(例如从 JSON 文件迁移至 MySQL 或 MongoDB)时,只需增添独立的 Pipeline 模块,核心抓取逻辑完全不受影响。
三、标准项目的初始化与五步实施流程
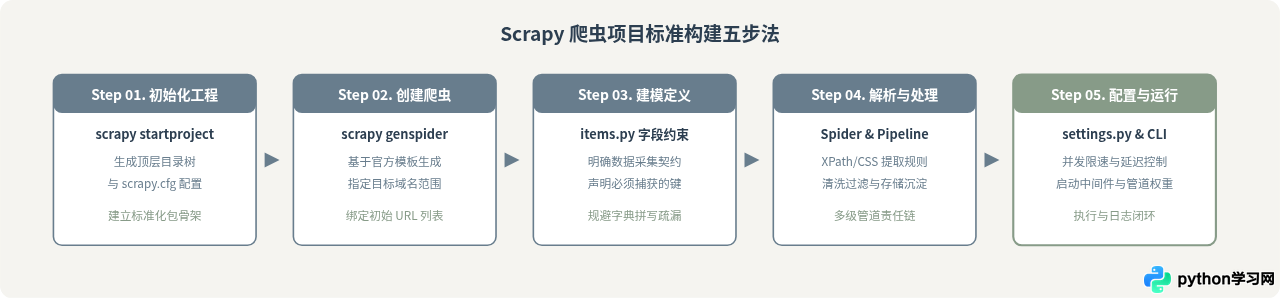
搭建规范的 Scrapy 项目有一套标准的工作流。遵循脚手架指令与规范流程,能够避免手动创建文件引发的导入路径错误和配置脱节问题。
1. 初始化项目骨架
在终端中执行以下命令创建项目。例如我们要创建一个针对图书信息采集的爬虫项目 book_crawler:
# 1. 创建项目
scrapy startproject book_crawler

# 2. 进入项目工作区
cd book_crawler

# 3. 生成爬虫模板(指定爬虫名及合法的域名范围)
scrapy genspider books toscrape.com
执行完成后,Scrapy 会在当前目录下生成标准的工程目录结构:
book_crawler/
│── scrapy.cfg                # 部署配置文件(指向项目的 settings 模块)
└── book_crawler/             # 项目 Python 模块根包
    ├── __init__.py
    ├── items.py              # 数据结构与字段契约定义
    ├── middlewares.py        # 爬虫与下载器中间件(代理、重试、Header)
    ├── pipelines.py          # 数据清洗、验证与持久化存储管道
    ├── settings.py           # 项目全局行为与参数配置
    └── spiders/              # 爬虫代码存放目录
        ├── __init__.py
        └── books.py          # 具体的爬虫解析逻辑
四、核心分层模块的标准代码实现
标准代码结构的核心价值体现在每个模块各司其职。下面通过具体且完整的代码示例,展示各个关键文件的规范写法。
1. 数据建模:items.py
直接在解析逻辑中使用原生字典传递数据容易因键名拼写错误产生难以排查的 Bug。通过继承 scrapy.Item 并使用 scrapy.Field() 声明字段,能够确立严格的数据采集契约:
# book_crawler/items.py
import scrapy

class BookItem(scrapy.Item):
    # 明确定义采集目标需要的字段
    title = scrapy.Field()       # 书籍标题
    price = scrapy.Field()       # 价格文本
    rating = scrapy.Field()      # 评分等级
    stock = scrapy.Field()       # 库存状态
    detail_url = scrapy.Field()  # 详情页 URL
    crawled_at = scrapy.Field()  # 采集时间戳
2. 提取逻辑:spiders/books.py
Spider 负责发送初始请求并解析响应。规范的做法是通过选择器(CSS 或 XPath)抽取数据,实例化前面定义的 Item,并通过 yield 生成器产出 Item 或新的 scrapy.Request。坚决不要在 Spider 内部编写数据库写入逻辑:
# book_crawler/spiders/books.py
import scrapy
from datetime import datetime
from book_crawler.items import BookItem

class BooksSpider(scrapy.Spider):
    name = "books"
    allowed_domains = ["toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/page-1.html"]

    def parse(self, response):
        """解析图书列表页,提取条目并处理翻页"""
        book_nodes = response.css("article.product_pod")

        for node in book_nodes:
            item = BookItem()
            item["title"] = node.css("h3 a::attr(title)").get()
            item["price"] = node.css("p.price_color::text").get()
            item["rating"] = node.css("p.star-rating::attr(class)").re_first(r"star-rating\s+(\w+)")
            item["stock"] = node.css("p.instock.availability::text").re_first(r"\S+")
            relative_url = node.css("h3 a::attr(href)").get()
            item["detail_url"] = response.urljoin(relative_url)
            item["crawled_at"] = datetime.now().strftime("%Y-%m-%d %H:%M:%S")

            # 将填充好的条目 yield 给引擎,流转至 Pipeline
            yield item

        # 翻页逻辑:提取下一页 URL 并递归构造请求
        next_page = response.css("li.next a::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
3. 数据处理与存储:pipelines.py
Pipeline 形成一条责任链,由引擎顺序调用。常见的标准用法是分离“数据清洗校验”与“持久化入库”,形成两个独立的 Pipeline 类:
# book_crawler/pipelines.py
from itemadapter import ItemAdapter
from scrapy.exceptions import DropItem

class BookCleaningPipeline:
    """第一级管道:清洗价格字符,校验必要字段"""
    def process_item(self, item, spider):
        adapter = ItemAdapter(item)

        # 1. 必填字段校验
        if not adapter.get("title"):
            raise DropItem(f"缺失标题,丢弃数据: {item}")

        # 2. 价格字段标准化:去除货币符号并转换为浮点型
        raw_price = adapter.get("price")
        if raw_price:
            cleaned_price = raw_price.replace("£", "").replace("¥", "").strip()
            try:
                adapter["price"] = float(cleaned_price)
            except ValueError:
                adapter["price"] = 0.0

        return item

class JsonLinesExportPipeline:
    """第二级管道:负责本地持久化沉淀"""
    def open_spider(self, spider):
        self.file = open("books_clean.jsonl", "w", encoding="utf-8")

    def close_spider(self, spider):
        self.file.close()

    def process_item(self, item, spider):
        adapter = ItemAdapter(item)
        line = adapter.asdict()
        import json
        self.file.write(json.dumps(line, ensure_ascii=False) + "\n")
        return item
4. 中间件钩子:middlewares.py
中间件是应对反爬、动态修改请求头的最佳位置。在 DownloaderMiddleware 的 process_request 中集中注入 User-Agent 或代理,使得爬虫逻辑保持纯粹:
# book_crawler/middlewares.py
class CustomHeadersMiddleware:
    """下载器中间件:统一注入生产级请求头"""
    def process_request(self, request, spider):
        request.headers.setdefault("Accept-Language", "zh-CN,zh;q=0.9,en;q=0.8")
        request.headers.setdefault("User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36")
        return None
五、生产级配置管理:settings.py 的实战基线
Scrapy 的 settings.py 是项目的中枢神经系统。生产级爬虫必须兼顾抓取效率与目标站点的访问负载,避免因粗暴的高并发导致 IP 封禁或对目标服务器造成拒绝服务压力。
AUTOTHROTTLE_ENABLED(自动限速扩展)。它能根据目标服务器的延迟动态调整抓取速率,比硬编码死固定延迟更加智能和稳定。
# book_crawler/settings.py 核心推荐配置

BOT_NAME = "book_crawler"
SPIDER_MODULES = ["book_crawler.spiders"]
NEWSPIDER_MODULE = "book_crawler.spiders"

# 1. 遵从爬虫协议与日志级别
ROBOTSTXT_OBEY = False
LOG_LEVEL = "INFO"

# 2. 并发度与限速(防封禁关键)
CONCURRENT_REQUESTS = 16
DOWNLOAD_DELAY = 0.5
CONCURRENT_REQUESTS_PER_DOMAIN = 8

# 3. 自动限速扩展(AutoThrottle)
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 1.0
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0

# 4. 激活管道(数字越小越先执行)
ITEM_PIPELINES = {
    "book_crawler.pipelines.BookCleaningPipeline": 300,
    "book_crawler.pipelines.JsonLinesExportPipeline": 400,
}

# 5. 激活下载器中间件
DOWNLOADER_MIDDLEWARES = {
    "book_crawler.middlewares.CustomHeadersMiddleware": 543,
}

# 6. 超时与重试策略
DOWNLOAD_TIMEOUT = 15
RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [500, 502, 503, 504, 408, 429]
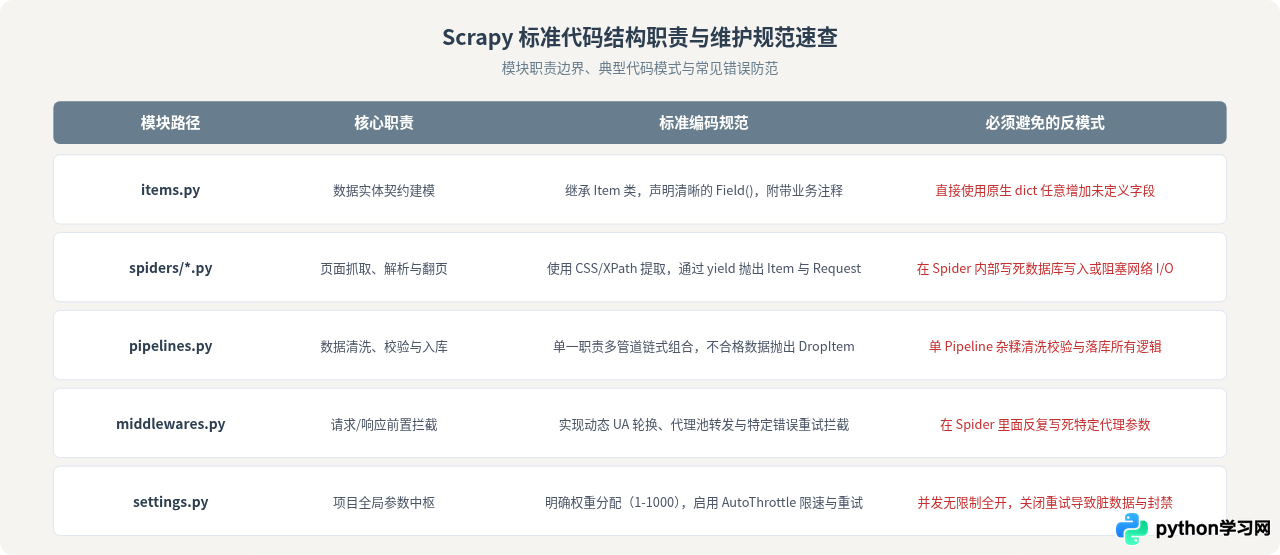
六、工程维护与生命周期速查总结
标准代码结构不仅规范了初次开发的代码书写,更为团队长期维护、排查线上故障以及横向扩展提供了清晰指引。在日常开发与部署维护中,牢记各模块的核心边界与维护原则是写出优雅代码的关键。
总结与最佳实践建议
构建 Scrapy 爬虫项目的标准代码结构,绝非只是为了代码排版的美观,而是软件工程在网络数据采集领域的具体实践。通过将“请求产生”、“网络下载”、“页面解析”、“数据清洗”和“数据持久化”彻底解耦,开发者可以专注于编写业务提取规则,而将并发控制、去重管理与重试容灾放心地交给框架底座。在面对大型项目或团队多人协作时,遵循上述标准化结构将大幅降低沟通与调试成本,使爬虫系统真正具备企业级的可靠性与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















