


Python能从事哪些工作?数据分析、后端开发与AI岗位全景解析
深入解析学习Python能够从事的主流职业方向,涵盖数据分析、Web后端开发、人工智能与大模型应用的核心职责、技术栈、真实工作场景及求职路径。
掌握Python后能够选择的职业方向主要集中在三个核心领域:数据分析与商业智能、Web服务端与后端开发,以及人工智能与算法工程;此外,还衍生出自动化测试开发与DevOps运维开发等技术支撑类岗位。本文直接拆解各岗位的核心职责、日常技术栈、实际业务产出以及进入门槛,帮助处于技术选型或求职准备阶段的开发者建立清晰的职业路线图。
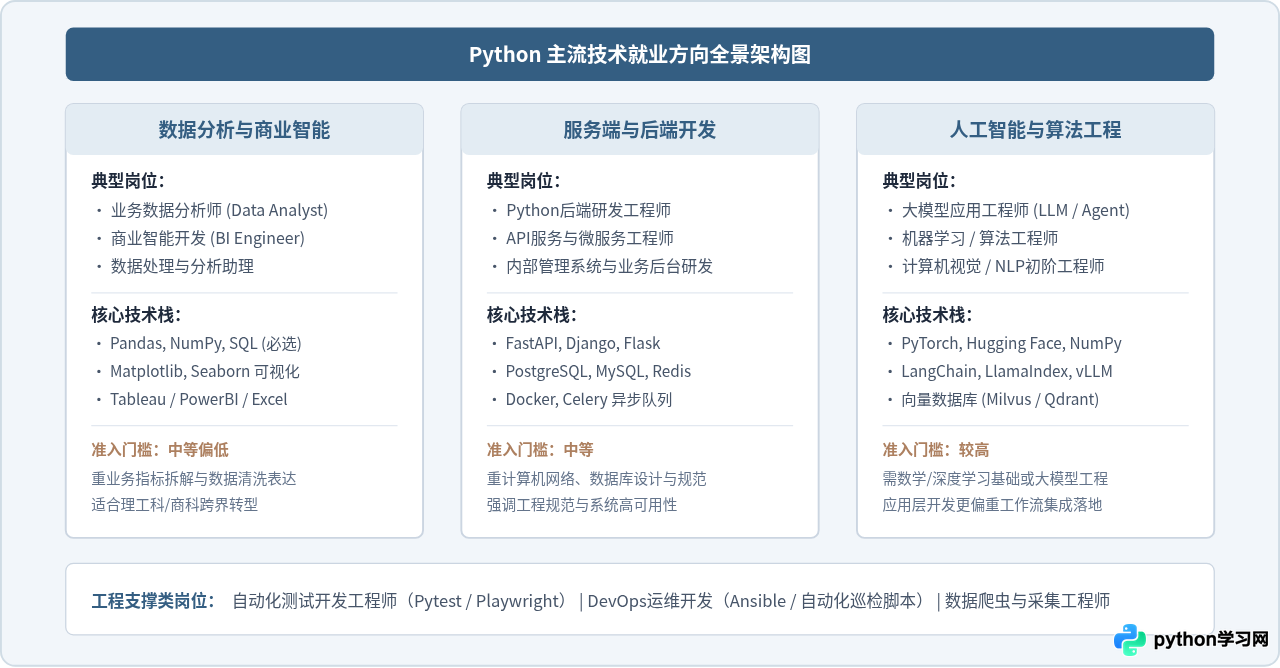
一、数据分析与商业智能(Data Analysis & BI)
数据分析是Python应用最为普遍的领域之一。现代企业拥有大量业务数据(如订单系统、用户行为日志、营销投放转化等),数据分析岗位的目标是通过数据提取、指标建模与规律挖掘,回答“业务发生了什么”、“为什么发生”以及“后续如何优化”。
1. 岗位职责与工作流程
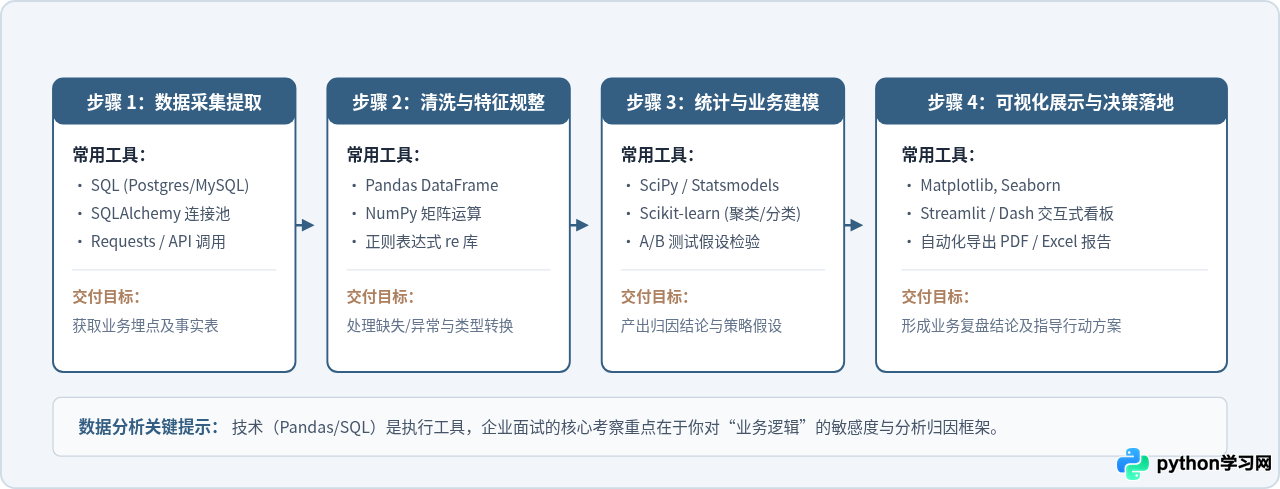
在日常工作中,数据分析师通常不会直接面对格式完备的现成报表,而是要经历从原始数据到决策洞察的完整流水线:
- 指标体系搭建:配合业务部门定义关键核心指标(如留存率、GMV转化漏斗、用户生命周期LTV)。
- 数据提取与ETL清洗:编写SQL从数仓抽取数据,使用Python对缺失值、重复记录、异常极端值进行清洗与类型规整。
- 统计与归因建模:运用描述性统计、假设检验或简单的回归分析排查业务异动原因。
- 报表自动化与呈现:构建交互式看板(Dashboard)或定时自动化生成分析简报,为管理层提供决策支撑。
2. 典型实操代码场景:用户留存与转化聚合
为了让读者直观理解数据分析岗位的代码形态,以下是一段标准的数据清洗与聚合分析脚本。它展示了如何读取交易记录、过滤无效数据并计算各渠道客单价与购买频次:
import pandas as pd

# 示例数据清洗与指标聚合
raw_orders = pd.DataFrame({
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "channel": ["搜索推广", "信息流", "搜索推广", "社交分享", "信息流"],
    "amount": [128.0, None, 256.5, 89.0, -10.0],  # 包含缺失值与脏数据
    "user_id": [1001, 1002, 1001, 1003, 1004]
})

# 1. 过滤脏数据:去除金额为空或小于等于0的异常订单
clean_orders = raw_orders[raw_orders["amount"].notna() & (raw_orders["amount"] > 0)].copy()

# 2. 按渠道聚合客单价、订单量与去重用户数
channel_summary = clean_orders.groupby("channel").agg(
    total_revenue=("amount", "sum"),
    order_count=("order_id", "count"),
    unique_buyers=("user_id", "nunique")
).reset_index()

# 3. 计算客单价(总收入 / 订单量)
channel_summary["avg_order_value"] = (
    channel_summary["total_revenue"] / channel_summary["order_count"]
).round(2)

print(channel_summary)二、服务端与后端开发(Backend Engineering)
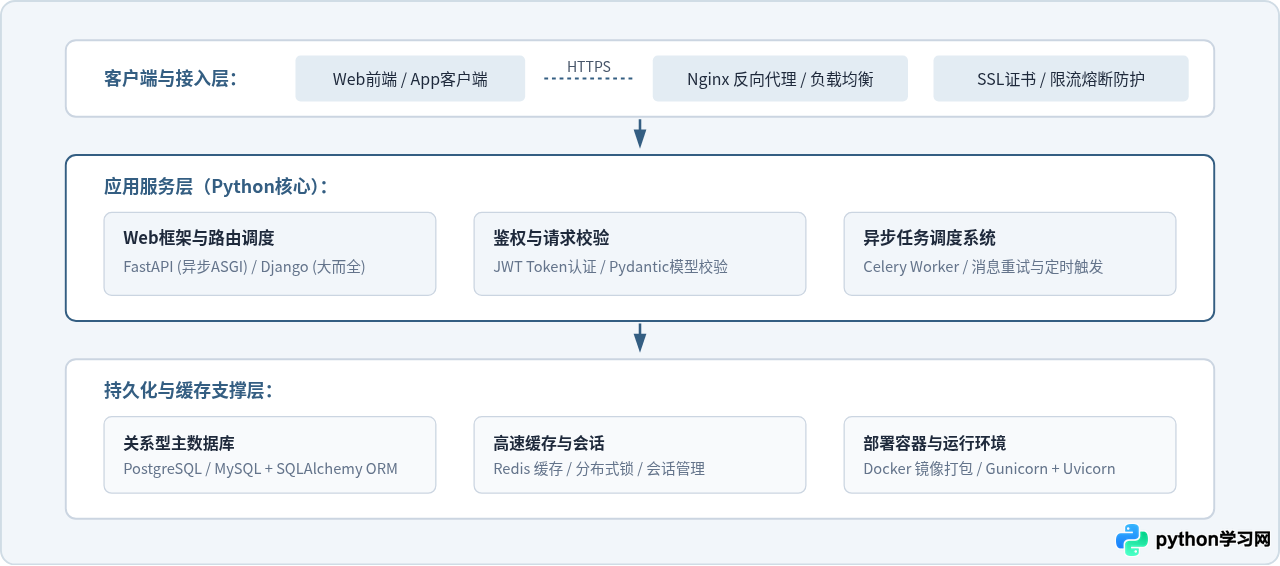
Python在后端开发领域占据着重要地位。由于其拥有成熟的生态体系、快速迭代能力和强大的异步IO支持,许多中大型互联网企业的业务后台、微服务API网关、AI模型推理接口以及中后台管理平台均以Python为主力语言。
1. 岗位职责与技术分工
- API接口设计与研发:基于RESTful或GraphQL协议,提供高性能、标准化的数据交互接口,供前端(Web/移动端)调用。
- 数据库建模与性能优化:设计关系型数据库(PostgreSQL/MySQL)的表结构、索引策略,编写复杂业务查询,并利用Redis实现缓存加速与分布式锁。
- 异步任务与解耦:利用Celery或RQ等任务队列,处理耗时的耗流任务(如邮件发送、PDF生成、音视频转码、跨系统数据同步)。
- 系统稳定性与容器化:配置Docker镜像、编写CI/CD流程,监控接口吞吐量(QPS)、P99延迟与错误率报警。
2. 主流后端框架对比与选型参考
| 框架名称 | 架构特点 | 适用业务场景 | 推荐掌握程度 |
|---|---|---|---|
| FastAPI | 基于ASGI规范,原生支持Python类型注解与异步并发(async/await),自动生成OpenAPI交互文档。 | 现代高并发微服务、前后端分离架构、大模型API封装与推理网关。 | 强烈推荐(当前求职热度最高)。 |
| Django | “开箱即用”全栈框架,自带完善的Admin管理后台、强大的ORM体系与用户认证模块。 | 复杂内容管理系统(CMS)、企业内部敏捷运营平台、中大型一体化业务系统。 | 企业存量项目多,建议深入掌握ORM与中间件机制。 |
| Flask | 微内核设计,极度轻量与灵活,开发者按需自行装配路由、ORM与插件。 | 小型单体工具服务、脚本级接口暴露、概念验证(PoC)项目。 | 适合理解Web底层请求响应机制。 |
三、人工智能与算法工程(AI & Algorithm Engineering)
Python是全球人工智能研发无可争议的第一语言。从底层的张量计算库NumPy,到深度学习框架PyTorch,再到如今大语言模型(LLM)生态的Transformers与LangChain,AI全链路工具均优先提供Python接口。
1. 细分岗位定位与能力区分
随着大语言模型生态的普及,目前AI岗位已出现明显的层级分化:
- 大模型应用工程师(LLM Application Engineer):主要负责结合企业业务场景落地大模型。核心技术包括RAG(检索增强生成)、向量数据库(Vector DB)、Prompt工程、多智能体协作(Agent Workflows)以及利用vLLM/Ollama进行模型量化与部署。此岗位更偏向“工程实现”,对纯数学公式要求相对温和。
- 算法工程师(深度学习/CV/NLP):负责核心模型的设计、训练与调优。需要扎实的线性代数、微积分与概率论功底,熟练掌握PyTorch并能够精读最新Paper,进行模型结构创新或特定垂直领域的LoRA微调。该岗位通常对学历与学术背景有明确要求。
- 推荐与搜索算法工程师:电商、短视频等领域的核心业务算法,基于用户行为数据构建召回、粗排、精排与重排链路。
2. 大模型落地核心技术:RAG(检索增强生成)工作流
目前企业中最急迫招聘的Python AI岗位是能够将通用大模型与企业私有知识库结合的开发者。其核心即RAG架构:
# 概念级代码:基于 LangChain 与 OpenAI/本地大模型的 RAG 检索流程
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate

# 1. 模拟将企业文档切片并向量化存入向量库
embeddings = OpenAIEmbeddings()
texts = [
    "员工年假规则:入职满一年享有5天带薪年假,满三年享有10天。",
    "差旅报销规定:普通出差住宿标准上限为400元/天,实报实销。"
]
vector_store = FAISS.from_texts(texts, embedding=embeddings)

# 2. 构建检索器与提示词模板
retriever = vector_store.as_retriever(search_kwargs={"k": 1})
prompt = ChatPromptTemplate.from_template("""
根据以下已知内容回答问题。如果已知内容无法得出结论,请直接回答不知道。
上下文: {context}
问题: {input}
""")

# 3. 组合并执行 RAG 检索问答链
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0)
document_chain = create_stuff_documents_chain(llm, prompt)
retrieval_chain = create_retrieval_chain(retriever, document_chain)

response = retrieval_chain.invoke({"input": "我入职满一年有几天年假?"})
print("AI 回答:", response["answer"])
四、工程支撑类岗位:自动化测试与DevOps运维开发
除了上述三大业务主航道,还有大量从业者在从事保障研发质量与线上运行稳定的支撑类工作:
1. 自动化测试开发工程师(SDET)
与传统手工点点点测试不同,测试开发工程师使用Python编写测试框架与自动化脚本。主要包括:
- 接口自动化测试:利用
pytest+requests编写用例,实现对微服务接口的参数自动化校验与回归测试。 - UI与全链路测试:使用
Playwright或Selenium模拟用户操作链路,自动截图并核验前端渲染。 - 性能压测:利用
Locust编写分布式高并发压测脚本,测试接口最大吞吐量。
2. 运维开发工程师(DevOps Engineer)
现代运维早已告别纯手工SSH登录服务器执行指令。运维开发工程师通过Python构建自动化运维管理平台:
- 服务器集群自动化配置(结合Ansible与Fabric)。
- 监控告警系统定制开发(与Prometheus、Zabbix对接,实现异常自动拉起与企业微信机器人告警)。
- 多云资产管理系统(CMDB)与自动化发布流程控制。
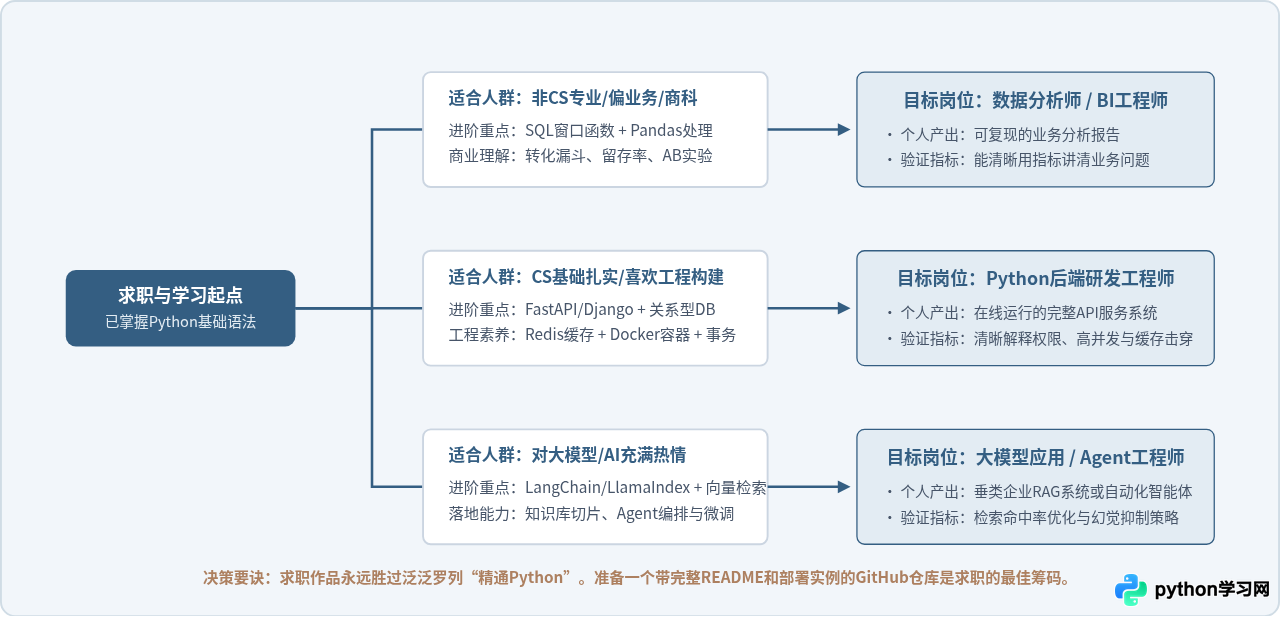
五、岗位选择决策树与学习进阶路径
不同技术背景与职业偏好的学习者,选择切入Python的方向应当有所侧重,切忌在没有明确目标时平均用力。
六、各方向面试与作品准备检查清单
为了在求职过程中脱颖而出,建议求职者根据目标方向准备对应的实体作品集,而不是仅仅在简历中列出掌握的关键字:
- 数据分析方向求职者:
- 准备一份完整的行业数据集分析案例(如天猫双十一消费行为分析、Kaggle公开流失预测数据集)。
- 输出不仅包含Jupyter Notebook清洗代码,还需包含一份面向管理者的PDF分析报告,展示业务结论与策略建议。
- 熟练掌握常见统计学概念(中位数与均值的适用场景、假设检验p值含义、置信区间)。
- 后端开发方向求职者:
- 独立完成一个可真实公网访问的Web API项目(推荐使用FastAPI + PostgreSQL + Redis构建,部署在轻量云服务器或Railway/Render上)。
- 展示严格的代码分层结构(Router路由层、Service业务层、Repository数据访问层)。
- 提供包含Swagger/Redoc的API自动化文档,并在GitHub附带数据库建表DDL语句与Docker Compose一键启动文件。
- AI大模型应用方向求职者:
- 搭建一个完整的垂直领域企业私有知识库RAG检索增强问答应用。
- 能够清楚阐述向量相似度算法(余弦相似度、欧氏距离)、文档切分策略(Chunk Size与Chunk Overlap的影响)以及重排序(Reranking)对召回率的改进效果。
- 了解大模型API限流(Rate Limit)应对机制与异步并发流式输出(Streaming Response)实现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















