


为什么在Python循环中直接修改列表会报错
深入解析在Python循环中直接修改列表引发IndexError、静默漏删和死循环的底层机理,从连续内存模型与迭代器游标机制出发,提供切实可行的4种安全修改方案与工程选型建议。
在Python开发中,直接在循环内部修改正在被遍历的列表,通常会引发两类严重后果:一类是直接抛出 IndexError: list index out of range 等运行时崩溃;另一类则是表面上运行平稳、控制台毫无报错,但实际数据却出现“静默漏删”或产生死循环。这一现象的本质,是Python列表的底层连续存储结构与迭代器基于游标(Cursor)单向递增的机制之间产生了位移脱节。本文将从代码表象、内存运作原理、常见报错类型出发,完整剖析这一问题,并提供生产环境中标准的安全解决路径与技术选型建议。
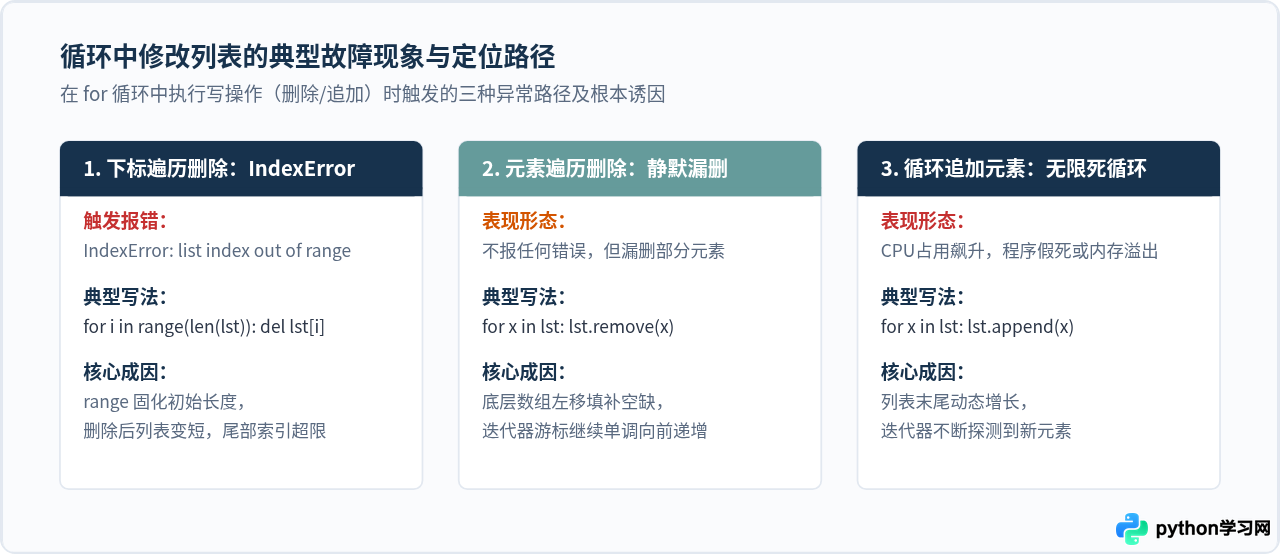
一、常见报错与异常现象:循环修改列表的3种典型后果
很多开发者在初学阶段希望剔除列表中的特定元素,第一反应往往是写一个简单的循环并在其中调用 remove() 或 del。然而代码运行后的行为往往出乎意料,常见的情况可以归纳为以下三种:
1. 静默漏删:元素莫名其妙被“跳过”
观察以下过滤偶数的代码片段。列表中有两个连续的偶数 2 和 4:
numbers = [1, 2, 4, 5, 6]
for num in numbers:
    if num % 2 == 0:
        numbers.remove(num)

# 预期输出: [1, 5]
# 实际输出: [1, 4, 5] (数字4被直接跳过,未被删除!)
在上述执行过程中,程序不仅没有任何报错,甚至执行完毕退出了,但结果中的 4 根本没有被处理。这种在生产环境中极难排查的逻辑Bug,正是因为列表在循环中缩减导致的游标错位。
2. 运行时报错:IndexError 下标越界
部分开发者为了避免直接遍历元素,改用下标遍历 range(len(lst)) 来执行删除操作,结果直接遭遇异常抛出:
data = ["apple", "banana", "cherry", "date"]
for i in range(len(data)):
    if len(data[i]) > 5:
        del data[i]

# 执行结果:抛出 IndexError: list index out of range
为什么明明写了 range(len(data)) 依然会报越界?这是因为 range(len(data)) 在循环开始的一瞬间就已经生成并确定了遍历范围(从 0 到 3)。当第一次满足条件删除了元素后,列表的实际长度变成了 3,但 for 循环后续依然会尝试读取索引 3,此时列表最大合法下标仅为 2,因而立即抛出 IndexError。
3. 逻辑失控:追加操作导致的死循环与内存耗尽
如果在遍历列表的同时向其中 append() 或 insert() 元素,列表末尾将不断向后伸展。迭代器每次自增都会发现末尾还有新增元素,从而永无休止地运行下去,直至触发内存耗尽异常。
二、深层原理解析:迭代器指针与列表内存结构的冲突
要彻底明白为什么会产生上述错误,我们需要深入了解 Python 在执行 for item in my_list: 时底层究竟发生了什么。
1. 列表的物理结构:紧凑连续的动态数组
在 CPython 实现中,列表(list)本质上是一个存放对象指针的连续动态数组(PyListObject)。当执行 remove(x) 或 del list[i] 时,被删除元素之后的所有后续元素都必须在内存中整体向左平移一个位置,以此填补被删除项留下的空缺。
2. 循环迭代器的内部游标(Cursor)
当执行 for item in my_list: 时,Python 解释器会在背后自动创建一个列表迭代器对象(list_iterator)。这个迭代器非常纯粹且“机械”,内部仅持有一个指向当前位置的整数下标游标(cursor):
- 第 1 次迭代:读取
my_list[0],游标递增到1; - 第 2 次迭代:读取
my_list[1],游标递增到2; - 第 n 次迭代:读取
my_list[n],直到游标达到len(my_list)时抛出StopIteration结束循环。
3. 冲突的根源:元素左移与游标递增不同步
关键冲突就在这里产生:迭代器游标完全不知道底层列表发生了删除操作,它只管机械地自增。
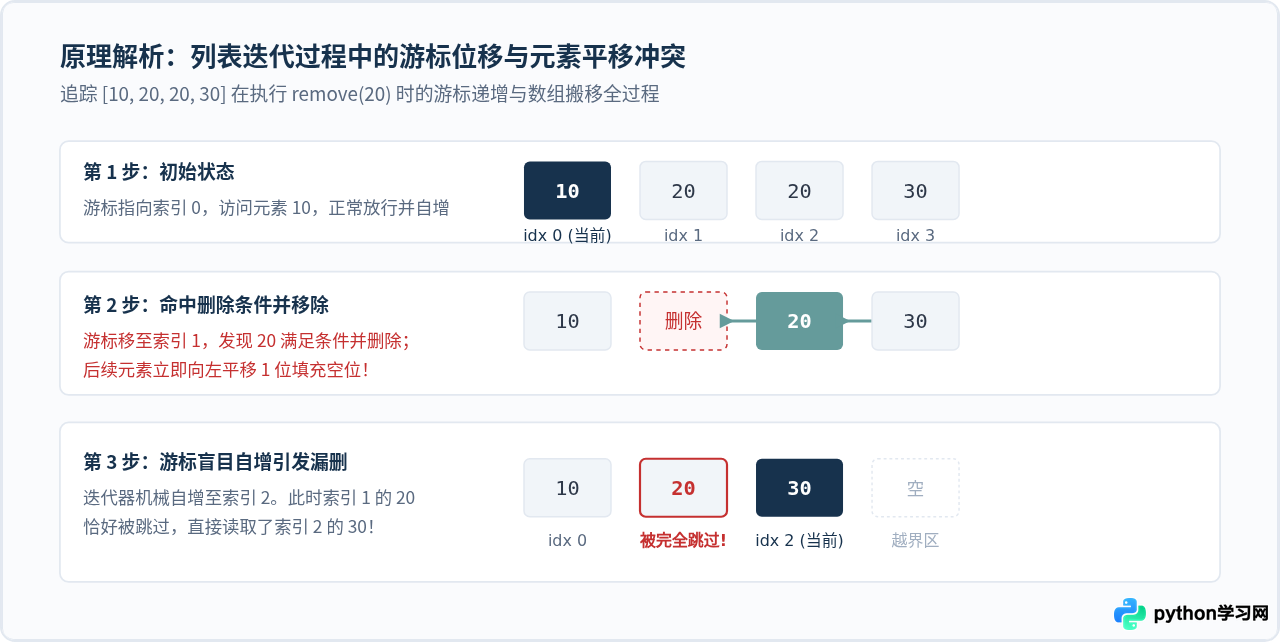
以 [10, 20, 20, 30] 为例:
- 初始游标为
0,读取元素10,不满足删除条件;游标递增为1。 - 游标为
1,读取到第一个20,满足删除条件,执行remove(20)。此时,数组发生左移:原索引2处的第二个20移动到了索引1,原索引3处的30移动到了索引2。 - 下一轮迭代开始,迭代器不管三七二十一,将游标直接递增为
2,并访问my_list[2]。 - 此时
my_list[2]对应的元素已经是30,而刚刚平移到my_list[1]的第二个20就这样被直接跳过了!
细心的读者可能会发现,如果遍历 dict 或 set 时直接增加或删除键,Python 会立即报错:RuntimeError: dictionary changed size during iteration。这是因为字典和集合内部维护了变更计数器(mutation counter),每次迭代都会比对版本号,发现被篡改便主动抛错保护。
但在 list 的 CPython 实现中,为了追求极高的顺序访问性能,官方并没有为列表迭代器增加这一层版本检查。这就导致列表在循环中被修改时不会主动报错阻断,而是任由逻辑继续错位运行,这也是该问题极具隐蔽性的原因。
三、安全修改列表的4种成熟方案
既然直接原位修改存在严重隐患,在实际工程中我们应该采用怎样的规范做法?以下是工业级 Python 开发中推荐的四种安全方案:
方案一:列表推导式(最推荐、最 Pythonic)
在绝大多数场景下,过滤或更新列表元素根本不需要在原列表上反反复复地删除,而是创建一个包含保留元素的新列表。列表推导式由底层 C 代码优化,不仅语义极其清晰,执行速度也远快于在循环中逐个 remove()。
# 过滤掉所有偶数,只保留奇数
numbers = [1, 2, 4, 5, 6]
odd_numbers = [num for num in numbers if num % 2 != 0]
print(odd_numbers)  # 输出: [1, 5]

# 如果需要保持原变量的内存地址(保持对象引用不变),使用切片赋值:
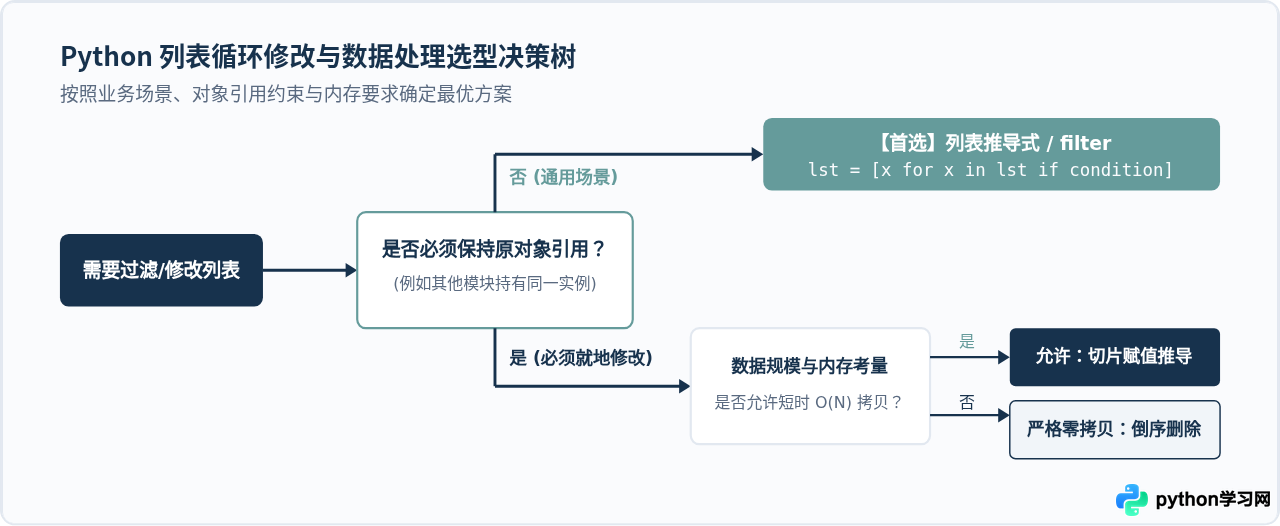
numbers[:] = [num for num in numbers if num % 2 != 0]注意要点:numbers[:] = ... 语法可以将新列表中的内容原位写回原对象的存储空间,如果其它函数引用了同一个列表对象,切片赋值可以确保外部引用能够同步感知到更新。
方案二:遍历副本切片 lst[:] 或 lst.copy()
如果业务逻辑确实需要在循环体内执行原位就地删除(例如删除时还要记录日志、调用析构逻辑等),那么可以通过遍历原列表的切片副本来安全规避游标错位:
numbers = [1, 2, 4, 5, 6]
# 对 numbers[:] 副本进行迭代,修改的是原列表 numbers
for num in numbers[:]:
    if num % 2 == 0:
        numbers.remove(num)

print(numbers) # 输出: [1, 5],正确删除原理说明:numbers[:] 快速在内存中创建了一个原列表的浅拷贝快照。迭代器负责遍历快照,游标在快照上自增;而 numbers.remove(num) 操作的是原列表。二者内存空间互相隔离,原列表无论怎么平移,都不会影响快照上的迭代进度。
方案三:倒序索引遍历(逆向删除)
如果需要在循环中依据索引 del lst[i],最精巧且无额外内存开销的经典技巧是倒序遍历:
data = ["apple", "banana", "cherry", "date"]
# 从最后一个索引向前遍历到 0
for i in range(len(data) - 1, -1, -1):
    if len(data[i]) > 5:
        del data[i]

print(data)  # 输出: ['apple', 'date'],没有越界报错!
为什么倒序是安全的? 当我们删除索引 i 处的元素时,受影响发生左移的只有索引大于 i 的右侧元素。而由于我们是从后向前推进的,右侧元素早已经全部处理完毕,左侧尚未处理的元素索引根本没有受到任何平移干扰!既不会发生 IndexError,也不会漏判。
方案四:while 循环精确控制指针步进
如果业务条件错综复杂,必须通过游标来逐项决策,可以使用 while 循环显式掌控指针。核心规则是:删除了元素时游标不要移动,只有未删除元素时游标才递增。
numbers = [1, 2, 4, 5, 6]
i = 0
while i < len(numbers):
    if numbers[i] % 2 == 0:
        del numbers[i]
        # 删除后后续元素自动补位到 i,故此处不增加 i
    else:
        i += 1

print(numbers)  # 输出: [1, 5]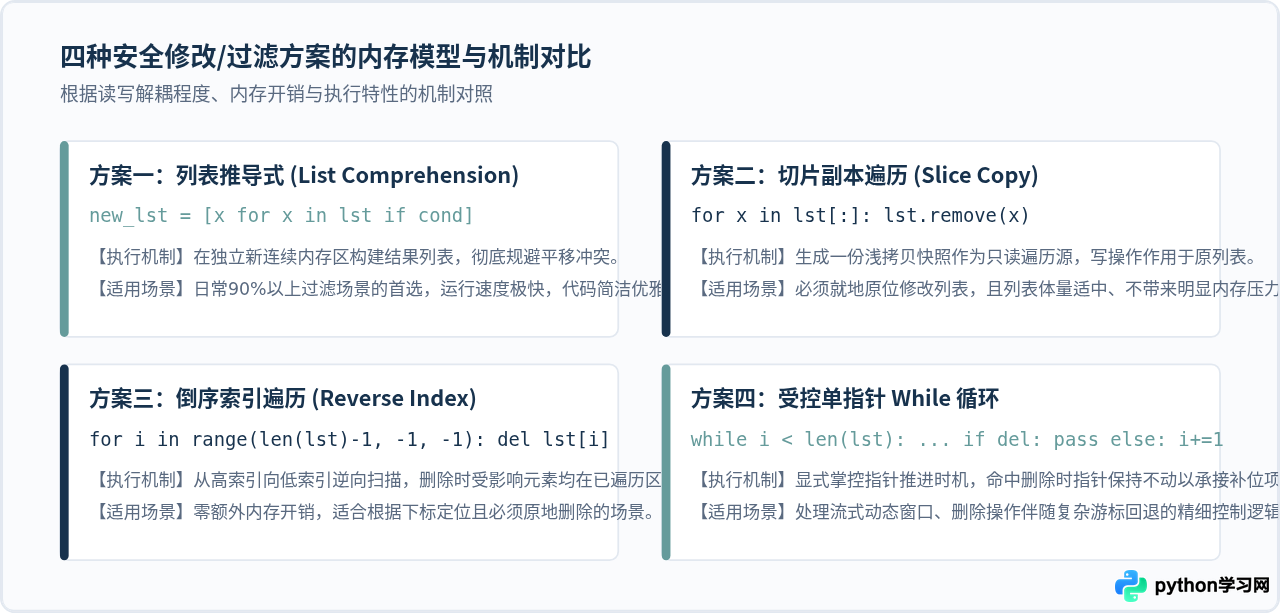
四、工程选型指南与决策路径
面对具体的业务需求,究竟该选择哪一种方案?可以参考以下对照表与决策树:
| 技术方案 | 原位修改 | 额外空间复杂度 | 时间复杂度 | 代码可读性 |
|---|---|---|---|---|
| 列表推导式 | 否 (切片赋值可原地) | O(N) | O(N) (C底层极快) | ★★★★★ (极高) |
| 切片副本遍历 | 是 | O(N) | O(N²) (remove需线性检索) | ★★★★☆ (较好) |
| 倒序索引遍历 | 是 | O(1) (零拷贝) | O(N²) (del需内存平移) | ★★★☆☆ (需仔细核对边界) |
| 受控 while 循环 | 是 | O(1) | O(N²) | ★★☆☆☆ (容易遗漏步进条件) |
五、总结与核心注意事项
归结起来,牢记以下三条原则,就能彻底杜绝循环修改列表引发的报错与逻辑缺陷:
- 牢记“边遍历边原地删”是反模式:除非有倒序遍历或副本快照的机制保障,否则切勿直接对
for x in lst的循环对象调用remove()、pop()或del。 - 能推导就推导:
[x for x in lst if ...]不仅性能更优,而且杜绝了共享状态带来的副作用,是现代 Python 代码的最佳实践。 - 区分列表与字典/集合:列表被修改时不会抛出
RuntimeError,这种“静默容忍”使得逻辑漏洞更加致命,务必在 Code Review 中重点审查此类写法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















