


python函数作为字典值映射怎么写
详细讲解在Python中如何将函数作为字典值进行映射与调用的完整操作指南。涵盖函数对象引用的内存原理、标准四步分派流程、参数不一致适配策略、面向对象类方法映射及常见运行时异常防范。
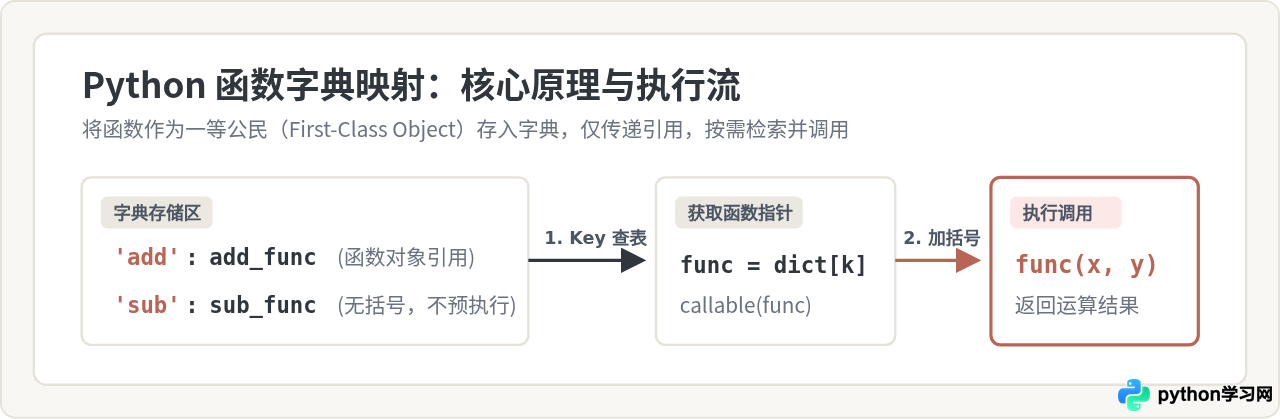
if-elif-else 的分支判断转化为 O(1) 时间复杂度的哈希查表,是构建命令分发器、状态机与解耦业务逻辑的高效方案。
一、基础写法与内存核心机制
许多初学者在编写函数字典映射时,容易混淆“函数引用”与“函数调用”。理解这两者的区别是掌握该模式的前提。
在 Python 中,当定义一个函数 def add(a, b): return a + b 时,解释器会在内存中创建一个代码对象,并将标识符 add 绑定到该对象的内存地址。如果在标识符后面加上圆括号 add(1, 2),就会立即触发执行并返回计算结果;若不带圆括号,add 就是一个普通的变量引用,指向函数对象本身。
因此,最简的函数字典映射代码如下所示:
# 1. 定义基础执行函数
def action_start():
    return "系统已启动"

def action_stop():
    return "系统已停止"

# 2. 构建字典:以字符串为键,以函数引用(无括号)为值
dispatch_table = {
    "start": action_start,
    "stop": action_stop
}

# 3. 查表获取函数对象并调用
cmd = "start"
func = dispatch_table[cmd]   # 取出函数引用 action_start
result = func()              # 追加括号,此时才真正执行函数
print(result)                # 输出示例:系统已启动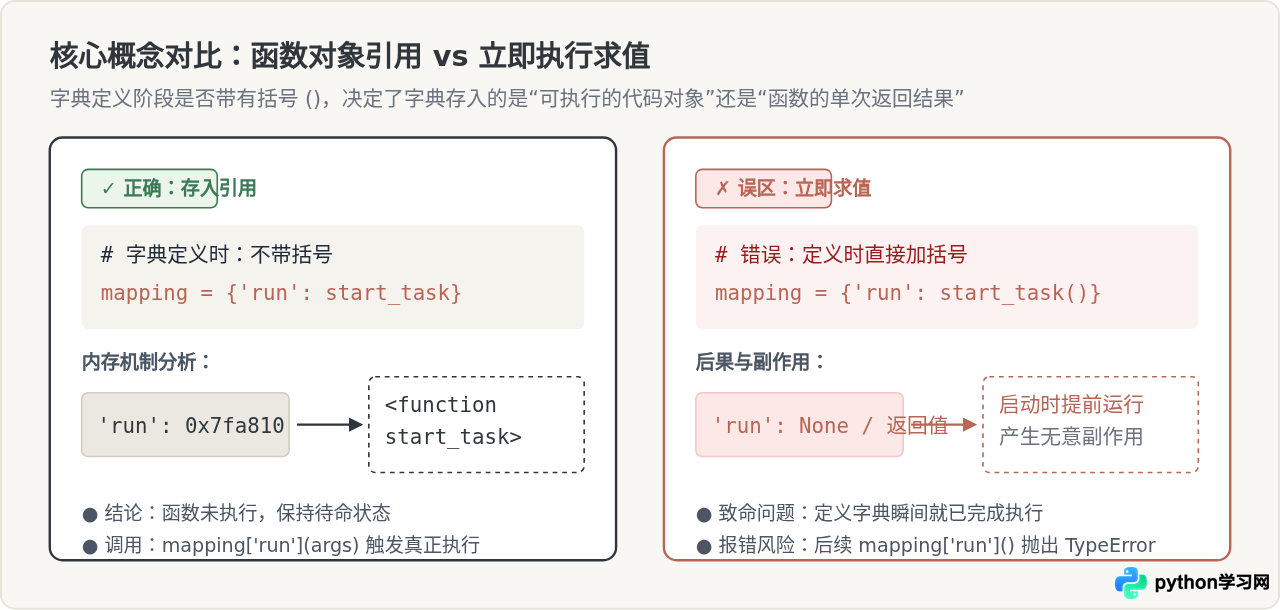
如果写成 {"start": action_start()},Python 在解析该字典语句的瞬间就会立即执行 action_start(),并将函数返回的字符串或 None 作为字典的值存储。后续当你尝试执行 dispatch_table["start"]() 时,程序会抛出 TypeError: 'str' object is not callable 运行时异常。
二、标准调用流程与分步操作指南
在生产环境中,直接使用 dict[key]() 容易遭遇不存在的键从而引发 KeyError。为了构建稳健的调度逻辑,应遵循以下标准四步流程:
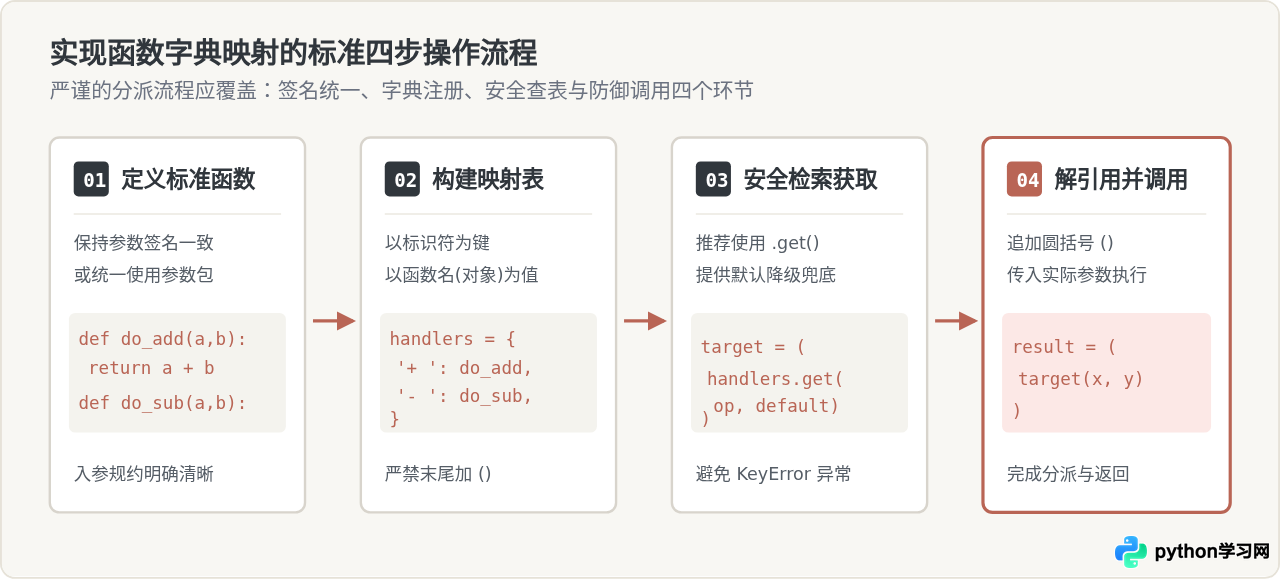
步骤 1:规范定义处理函数
确保参与分发的业务函数在入参规约上保持一致。如果各函数需要接受数据,最理想的情况是设计统一的形参列表(例如都接收两个操作数,或都接收一个上下文对象)。
def calc_add(x, y):
    return x + y

def calc_sub(x, y):
    return x - y

def calc_mul(x, y):
    return x * y

def calc_div(x, y):
    if y == 0:
        return "错误:除数不能为零"
    return x / y
步骤 2:建立分派字典
建立一个哈希映射表。字典的键可以是字符串、枚举类(Enum)或整型代码,值一律赋予对应的函数引用:
operations = {
    "+": calc_add,
    "-": calc_sub,
    "*": calc_mul,
    "/": calc_div,
}
步骤 3:编写降级兜底函数并检索
当调用方传入未定义的运算符时,程序不应直接崩溃。定义一个默认兜底函数,并配合字典的 .get() 方法实现优雅降级:
def calc_unknown(x, y):
    return "错误:不支持的计算操作"

def dispatch_calculator(op, x, y):
    # 安全检索:若 op 存在则返回对应函数,不存在则返回默认函数 calc_unknown
    handler = operations.get(op, calc_unknown)
    # 解引用并传参调用
    return handler(x, y)
步骤 4:验证执行结果
# 测试已注册的操作
print(dispatch_calculator("+", 10, 5))   # 示例输出:15
print(dispatch_calculator("*", 4, 3))    # 示例输出:12

# 测试未注册的异常输入
print(dispatch_calculator("%", 10, 5))   # 示例输出:错误:不支持的计算操作
三、应对参数不一致的高级适配策略
在复杂业务中,被映射的函数往往来自于不同模块,其接收的参数数量和名称可能各不相同。若直接传入固定的实参,会引发 TypeError。针对此类场景,通常有三种解决方案:
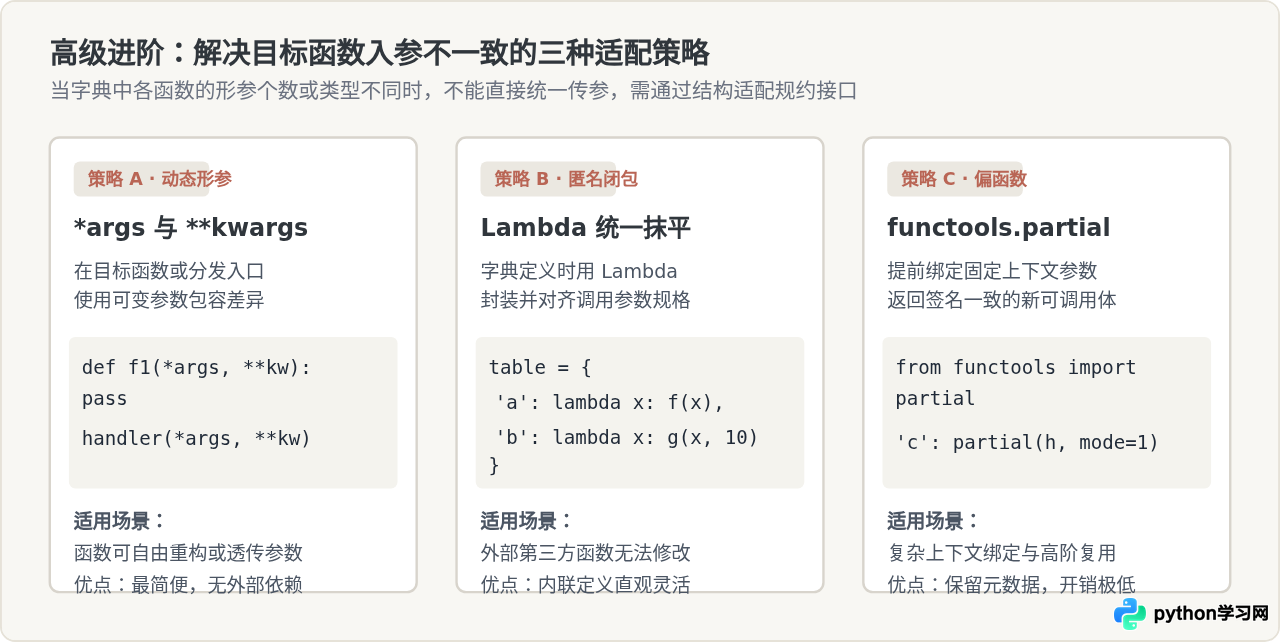
策略 1:使用通用参数包 *args, **kwargs
在设计分发层时,将所有目标函数定义为支持解包传参,或者在分发处使用动态解包:
def log_simple(msg, *args, **kwargs):
    print(f"[INFO] {msg}")

def log_detail(msg, code=0, user="guest", *args, **kwargs):
    print(f"[DETAIL {code}] {user}: {msg}")

logger_map = {
    "basic": log_simple,
    "audit": log_detail
}

# 统一使用通配传参
logger_map["audit"]("用户登录", code=200, user="admin")
策略 2:利用 lambda 表达式抹平调用签名
当目标函数为第三方库不可修改的函数时,使用 lambda 进行轻量级适配是最常见的技巧:
import math

# 某些函数接收1个参数,某些接收2个参数
shape_calc = {
    # 圆面积:只需半径 r
    "circle": lambda r, **kw: math.pi * r ** 2,
    # 矩形面积:需要长 width 和宽 height
    "rect": lambda width, height, **kw: width * height,
    # 正方形面积:只需边长 a
    "square": lambda a, **kw: a * a
}

print(shape_calc["circle"](r=3))                   # 示例输出:28.274333882308138
print(shape_calc["rect"](width=4, height=5))       # 示例输出:20
策略 3:使用 functools.partial 进行预绑定
如果某些函数的部分参数在注册时就已经确定,可以使用偏函数(Partial Function)将其固化,使返回的新可调用对象具备统一的入参格式:
from functools import partial

def send_notification(channel, message, urgent=False):
    return f"[{channel}] [紧急: {urgent}] {message}"

# 预先固化 channel 与 urgent 参数
notify_handlers = {
    "sms_alarm": partial(send_notification, "SMS", urgent=True),
    "email_digest": partial(send_notification, "Email", urgent=False),
}

# 最终调用时,只需提供剩余的 message 参数即可
print(notify_handlers["sms_alarm"](message="服务器 CPU 负载超 90%"))
# 示例输出:[SMS] [紧急: True] 服务器 CPU 负载超 90%
四、面向对象中类实例方法的分发映射
在类定义内部实现命令分派器时,应当将分发字典绑定到实例方法(绑定了 self 的方法对象)。通常推荐在 __init__ 初始化阶段构建映射表:
class OrderProcessor:
    def __init__(self):
        # 在构造函数中将 self 绑定的实例方法存入字典
        self._handlers = {
            "create": self._handle_create,
            "pay": self._handle_pay,
            "cancel": self._handle_cancel,
        }

    def _handle_create(self, order_id, **kwargs):
        return f"订单 {order_id} 创建成功"

    def _handle_pay(self, order_id, amount=0, **kwargs):
        return f"订单 {order_id} 支付成功,金额: ¥{amount}"

    def _handle_cancel(self, order_id, reason="无", **kwargs):
        return f"订单 {order_id} 取消成功,原因: {reason}"

    def execute(self, action: str, order_id: str, **kwargs):
        handler = self._handlers.get(action)
        if not handler:
            raise ValueError(f"未知指令: {action}")
        return handler(order_id, **kwargs)

# 使用示例
processor = OrderProcessor()
print(processor.execute("pay", order_id="ORD-1001", amount=299))
# 示例输出:订单 ORD-1001 支付成功,金额: ¥299__init__ 中构建比在类属性中更好?如果在类顶层定义 _handlers = {"create": _handle_create},此时方法尚未与具体的类实例进行绑定(只是无所属的普通函数,未绑定 self)。调用时必须显式将 instance 作为第一个参数传给它。而在 __init__ 中使用 self._handle_create,Python 会自动将其封装为 Bound Method(已绑定方法),调用时无需手动传递 self,封装度更高。
五、高频踩坑点与防御式编码检查
在将函数映射到字典时,以下四个问题在代码审查和运行时排查中最易出现:
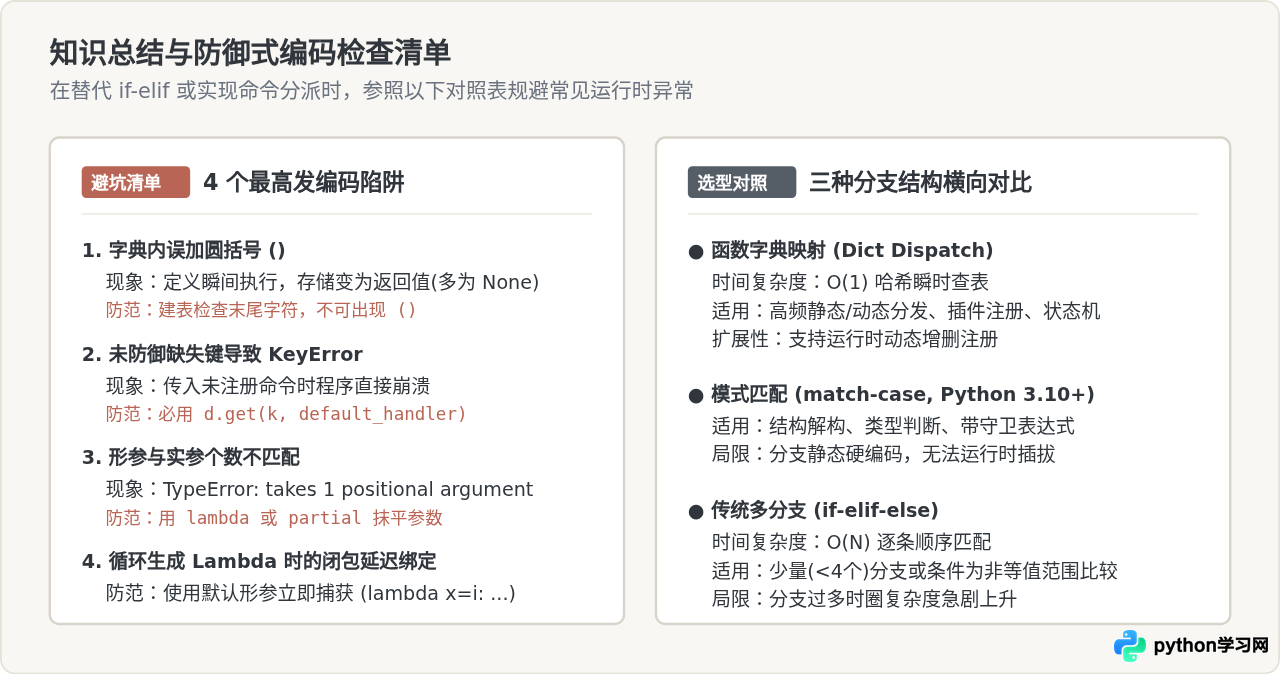
1. 动态生成字典时 Lambda 的延迟绑定问题
如果在一个循环体中批量为字典生成包装函数,直接在 lambda 中引用循环变量会导致闭包延迟绑定,最终所有函数都只能访问到循环结束时的最后一个值:
# 错误写法:所有函数最终打印的都是 2
funcs_bug = {}
for i in range(3):
    funcs_bug[i] = lambda: i

print(funcs_bug[0]())  # 输出 2,而非预期的 0!

# 正确写法:利用默认参数在定义期强制立即捕获当前值
funcs_fixed = {}
for i in range(3):
    funcs_fixed[i] = lambda val=i: val

print(funcs_fixed[0]())  # 预期输出 0
2. 确保取出的对象是真正的可调用实体
在维护大型分派字典时,某些分支可能被赋值为 None 或配置项。在调用前,推荐使用内置函数 callable() 进行防御性判断:
handler = dispatch_map.get(event_type)
if callable(handler):
    handler(payload)
else:
    # 执行降级记录或抛出友好告警
    handle_fallback(event_type, payload)
六、架构选型对比与总结
并非所有条件分支都适合使用函数字典映射。读者可以参考下表进行技术选型:
| 实现方式 | 时间复杂度 | 适用业务场景 | 核心优势与局限 |
|---|---|---|---|
函数字典映射dict.get(key)() |
O(1) 哈希直接寻址 |
命令分发、状态机跳转、插件系统、计算器、协议解析 | 优势:解耦彻底,支持运行时动态注册与热插拔。 局限:只能处理等值匹配,不适合范围判断。 |
模式匹配match-case (3.10+) |
O(1) ~ O(N) 视编译优化 |
复杂数据结构解包、带有 if 守卫的复合条件判断 |
优势:原生解构支持好,类型提示完备。 局限:分支规则在代码中硬编码,无法运行时插拔。 |
条件分支链if-elif-else |
O(N) 顺序逐条匹配 |
分支少于 3 个、区间判断(如 score > 90)、非等值运算 |
优势:逻辑直白无认知负担。 局限:分支超过 5 个时圈复杂度急剧升高,难以维护。 |
总结:编写 Python 函数作为字典值映射,关键在于牢记“存入函数名作为引用,取出后再加括号传参执行”。配合 .get() 默认值兜底、lambda / partial 适配入参以及 callable() 安全校验,即可写出高内聚、低耦合且执行效率极高的分发模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















