


不依赖专用库:用Python struct模块手动解析雷达基数据
本文深入讲解在不依赖Py-ART、cinrad等外部专用气象库的情况下,如何使用Python内置的struct模块,手动按字节协议解析天气雷达二进制基数据,涵盖文件头、径向头、距离库解包与物理量标定完整流程。
在气象数据分析与工程部署中,直接使用 Py-ART 或 cinrad 等大型库虽然便捷,但在轻量化微服务、内网无外网环境或特殊雷达固件适配等场景下,安装庞大的科学计算包往往受到限制。本文将带你直接使用 Python 标准库中的 struct 模块,脱离所有第三方依赖,从最底层的二进制字节流出发,一步步解析天气雷达基数据文件,完成从原始字节到气象物理量(如反射率因子 dBZ)的完整还原。
一、雷达基数据文件的底层组织模型
天气雷达基数据(Base Data)通常由雷达数据采集系统(RDA)直接生成,记录了天线进行立体扫描时接收到的原始信号测量值。为了兼顾传输效率与采样速率,这类文件几乎无一例外采用紧凑的二进制格式存储,由具有明确字节偏移的多个数据结构首尾相接组成。
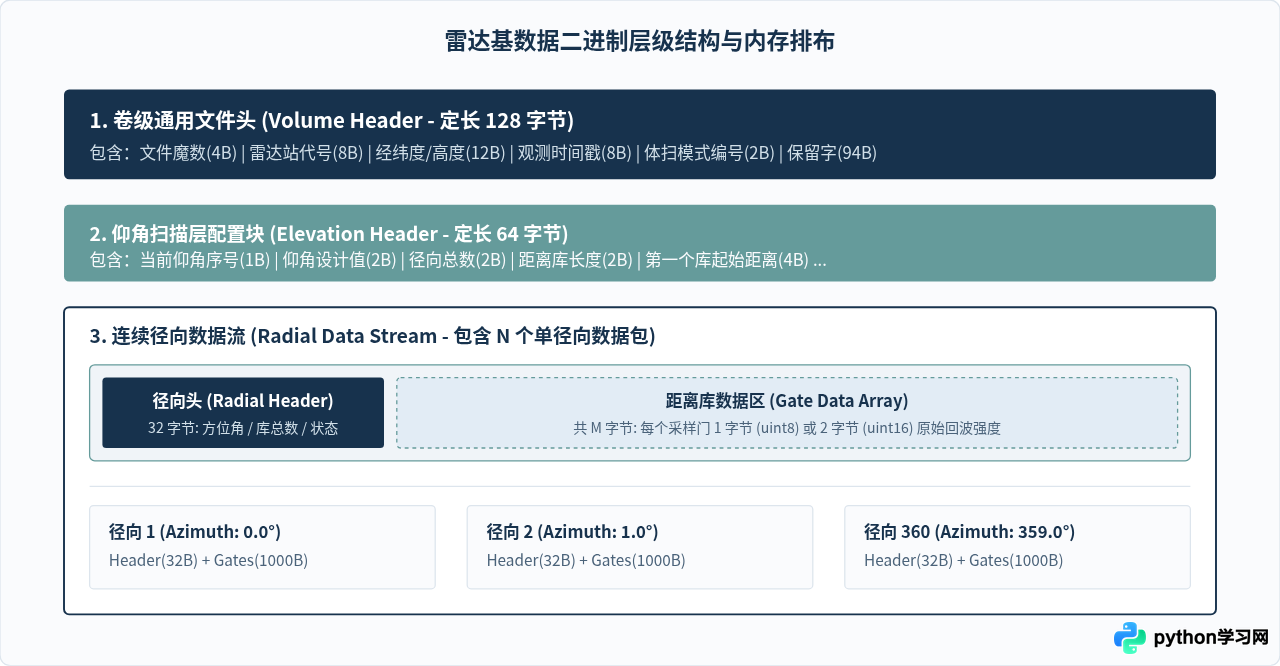
一个标准的雷达单站基数据文件,通常包含三个核心层次:
- 通用文件头/卷头(Volume Header):位于文件最前端,记录雷达站号、经纬度、天线海拔高度、观测开始时间及体扫模式等全局定长参数。
- 仰角/扫描配置块(Elevation/Sweep Header):说明当前扫描圈的仰角角度、脉冲宽度、重复频率(PRF)以及距离库(Gate)的分辨率。
- 径向数据包(Radial Packets):天线旋转过程中,沿每个特定方位角发射并接收回波的数据序列。一个完整的仰角层通常包含 360 个或更多径向。每个径向由“径向头”(记录当前方位角、仰角、门数)与“数据门连续字节区”(记录每个采样库的反射率、速度或谱宽数值)组成。
二、核心工具:Python struct 模块的映射法则
Python 内置的 struct 模块用于在 Python 值与 C 语言结构体(用 Python bytes 对象表示)之间进行转换。手动解析雷达数据的核心,就是根据数据规范编写正确的“格式化字符串”(Format String)。
编写格式化字符串时,首先必须确定字节端序(Endianness)。气象雷达早期标准(如 NEXRAD、部分老款 CINRAD 雷达)多运行于 RISC 架构或网络协议之上,普遍采用大端序(Big-Endian,格式符 >);而现代 x86 工控机采集卡直存的文件则多为小端序(Little-Endian,格式符 <)。如果在解包时不显式指定端序,Python 会默认使用本地平台的对齐规则(带 C 结构体内存填充 padding),导致解析出的偏移量产生不可预测的偏差。
| 格式字符 | C 数据类型 | 标准字节大小 | Python 对应类型 | 雷达基数据常见用途 |
|---|---|---|---|---|
> 或 < |
- | - | - | 字节序标识(大端 / 小端),必须放在格式串首位 |
B |
unsigned char | 1 字节 | int | 8 位反射率原始门计数、状态标记 |
H |
unsigned short | 2 字节 | int | 方位角(需乘换算因子)、距离门数量 |
h |
short | 2 字节 | int | 有符号仰角角度、径向多普勒速度原始值 |
I |
unsigned int | 4 字节 | int | UNIX 时间戳、文件偏移指针 |
f |
float | 4 字节 | float | 单精度浮点经纬度、标定常数 |
4s |
char[4] | 4 字节 | bytes | 雷达站代号、固定格式魔数标识 |
三、原始数据解包与气象物理量标定
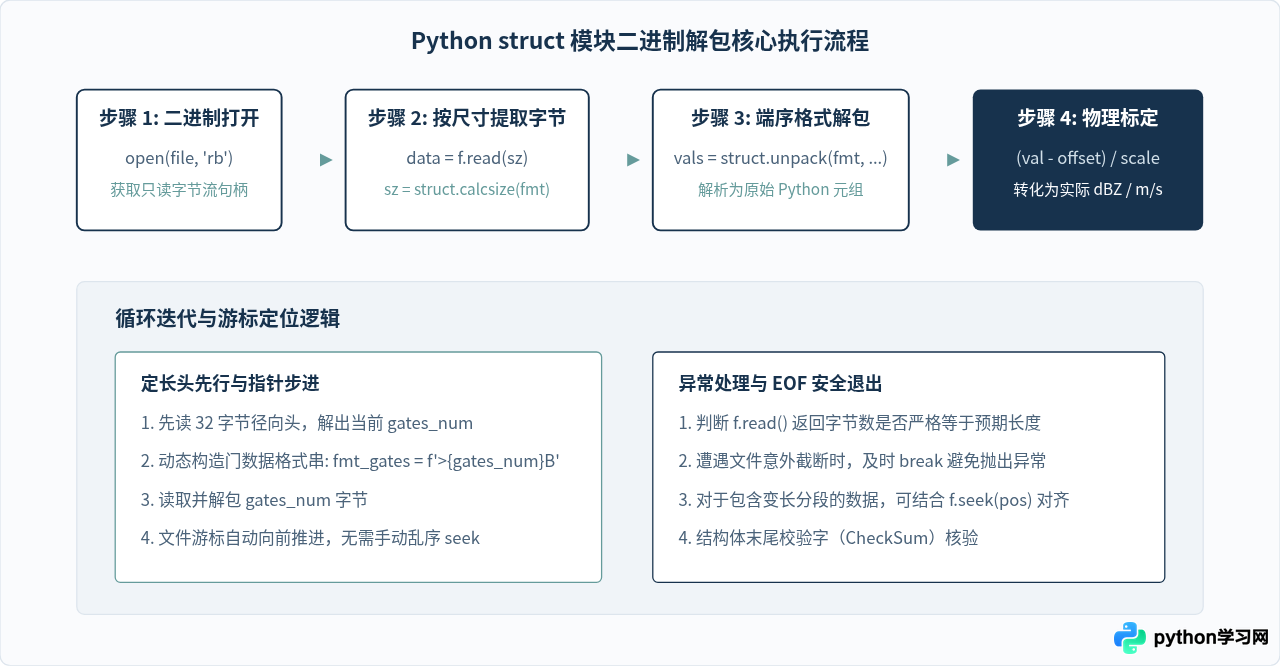
雷达硬件为了降低信道带宽占用,在测量回波功率后,会通过线性量化将其压缩为一个字节(0~255 的无符号整数 uint8)或两个字节。解包出的整数并非最终的物理量,必须通过协议约定的标定公式还原。
在气象行业中,最基础的标定公式通常为线性变换:
物理量实际值 = (原始整数值 - 偏置 Offset) / 缩放因子 Scale以经典的单字节反射率因子(dBZ)编码为例:
- 原始值
0:通常表示天线静区、未被扫描或信噪比极低区域; - 原始值
1:保留给地杂波过滤、噪声或无效采样; - 原始值
2 ~ 255:实际测量值。假设设定Offset = 64,Scale = 2.0,则当读取到原始值134时,其实际物理量为:(134 - 64) / 2.0 = 35.0 dBZ(对应中等强度的降水回波)。
四、纯原生 Python 完整实现方案
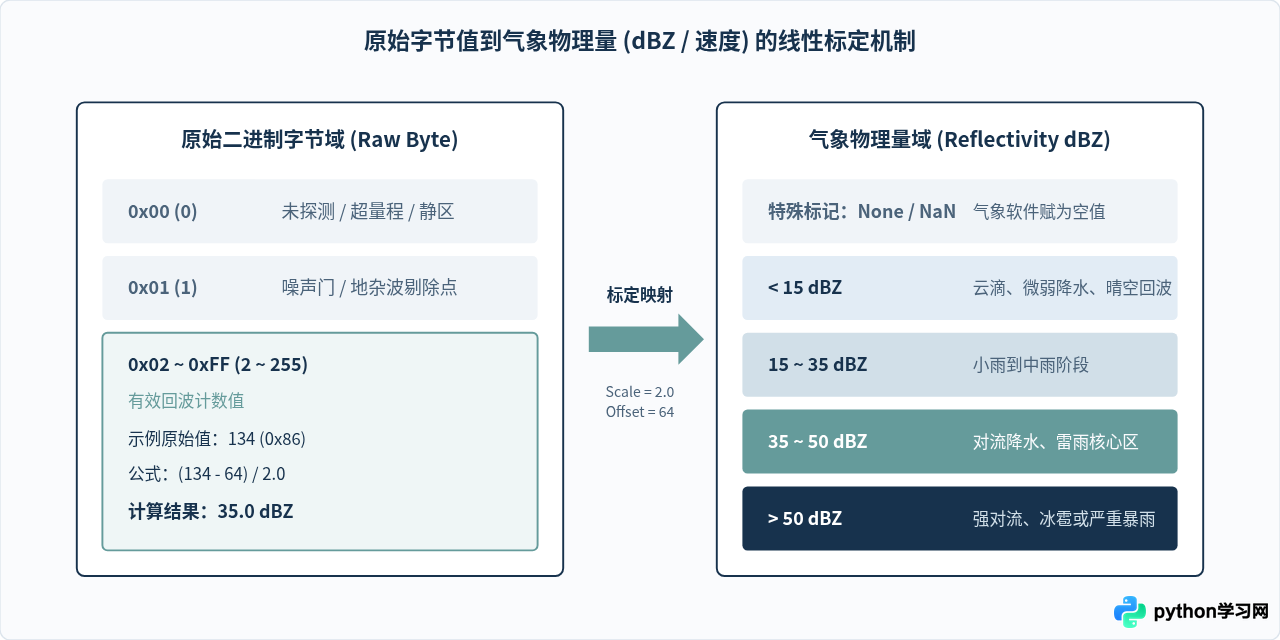
下面是一个完全自包含的 Python 解析脚本。代码仅导入 struct、math 与 os 三个标准库模块。为了方便读者在本地直接运行并验证效果,示例中同时附带了一个简易的模拟基数据二进制生成器,随后调用核心解析器进行逐级解包并打印解析结果。
import struct
import os

# ==========================================
# 1. 结构体格式定义(采用大端序 >)
# ==========================================
# 卷头:文件魔术字(4s), 站点代号(4s), 纬度(f), 经度(f), 海拔(H), 体扫模式(H)
FMT_VOL_HEADER = ">4s4sffHH"
SIZE_VOL_HEADER = struct.calcsize(FMT_VOL_HEADER)

# 径向头:径向序号(H), 方位角*100(H), 仰角*100(h), 距离门数(H), 门长单位米(H)
FMT_RADIAL_HEADER = ">HHhHH"
SIZE_RADIAL_HEADER = struct.calcsize(FMT_RADIAL_HEADER)

# ==========================================
# 2. 模拟基数据生成器(供本地无文件时自测使用)
# ==========================================
def create_mock_radar_file(filepath):
    """生成一个包含 3 个仰角层、每层 4 个径向样例的合规二进制文件"""
    with open(filepath, "wb") as f:
        # 写入 16 字节卷头
        vol_head = struct.pack(
            FMT_VOL_HEADER,
            b"RADR",        # 魔数
            b"Z999",        # 站号
            31.2304,        # 纬度
            121.4737,       # 经度
            45,             # 海拔高度 (米)
            21              # 体扫模式 VCP-21
        )
        f.write(vol_head)

        # 写入模拟径向数据
        gate_count = 500  # 每个径向 500 个门
        for sweep_idx in range(2):
            elevation = int((0.5 + sweep_idx * 0.9) * 100) # 0.5度, 1.4度
            for rad_idx in range(4):
                azimuth = int((rad_idx * 90.0) * 100)     # 0°, 90°, 180°, 270°
                # 打包径向头
                rad_head = struct.pack(
                    FMT_RADIAL_HEADER,
                    rad_idx + 1,
                    azimuth,
                    elevation,
                    gate_count,
                    250 # 库长 250 米
                )
                f.write(rad_head)

                # 生成模拟门数据(含未探测点与对流回波)
                raw_gates = bytearray([0] * gate_count)
                # 假设在第 100~150 库处出现雷雨云团
                for g in range(100, 150):
                    raw_gates[g] = 134  # 标定后约为 35.0 dBZ
                f.write(raw_gates)

# ==========================================
# 3. 纯原生基数据解析核心函数
# ==========================================
def parse_radar_raw_data(filepath):
    """不使用任何第三方库,手动逐字节解包雷达基数据"""
    if not os.path.exists(filepath):
        raise FileNotFoundError(f"未找到目标文件: {filepath}")

    with open(filepath, "rb") as f:
        # 1. 解析卷头
        header_bytes = f.read(SIZE_VOL_HEADER)
        if len(header_bytes) < SIZE_VOL_HEADER:
            print("错误:文件尺寸过小,无法读取卷头")
            return

        magic, station, lat, lon, height, vcp = struct.unpack(FMT_VOL_HEADER, header_bytes)

        # 校验魔数
        if magic != b"RADR":
            print(f"警告:未识别的文件头魔数: {magic}")
            return

        print("=" * 60)
        print(f"雷达站点代号: {station.decode('ascii', errors='ignore')}")
        print(f"经纬度坐标  : 纬度 {lat:.4f}°, 经度 {lon:.4f}°")
        print(f"天线海拔高度: {height} 米")
        print(f"体扫模式编号: VCP-{vcp}")
        print("=" * 60)

        # 2. 循环遍历后续连续的径向数据
        radial_count = 0
        while True:
            rad_head_bytes = f.read(SIZE_RADIAL_HEADER)
            # 若已读取至文件尾,正常退出
            if len(rad_head_bytes) == 0:
                break
            if len(rad_head_bytes) < SIZE_RADIAL_HEADER:
                print("提示:文件尾部数据截断,退出解析")
                break

            r_idx, r_az, r_el, gates_num, gate_size = struct.unpack(FMT_RADIAL_HEADER, rad_head_bytes)
            azimuth_deg = r_az / 100.0
            elevation_deg = r_el / 100.0

            # 读取该径向对应的距离库原始字节
            gates_bytes = f.read(gates_num)
            if len(gates_bytes) < gates_num:
                print("提示:距离库数据不完整")
                break

            # 3. 门数据解包与气象物理量还原
            # 使用 '>{}B'.format(gates_num) 一次性解包为整数元组
            raw_values = struct.unpack(f">{gates_num}B", gates_bytes)

            # 过滤并标定物理量 (0 表示静区,1 表示噪声)
            dbz_list = []
            valid_count = 0
            for val in raw_values:
                if val <= 1:
                    dbz_list.append(None)
                else:
                    # 线性标定公式:(Raw - 64) / 2.0
                    physical_dbz = (val - 64) / 2.0
                    dbz_list.append(physical_dbz)
                    valid_count += 1

            radial_count += 1
            print(f"径向 #{r_idx:03d} | 方位角: {azimuth_deg:5.1f}° | 仰角: {elevation_deg:4.1f}° | "
                  f"总门数: {gates_num} | 有效应答门数: {valid_count}")

            # 打印前 3 个有效库的探测位置与强度
            echo_samples = [(idx, val) for idx, val in enumerate(dbz_list) if val is not None][:3]
            if echo_samples:
                details = [f"库{idx}(距离{idx * gate_size / 1000.0:.1f}km): {val:.1f}dBZ" for idx, val in echo_samples]
                print("   └─ 样例回波: " + ", ".join(details))

        print("=" * 60)
        print(f"解析完成,累计解包径向数目: {radial_count}")

if __name__ == "__main__":
    test_path = "mock_radar_data.bin"
    create_mock_radar_file(test_path)
    parse_radar_raw_data(test_path)
    if os.path.exists(test_path):
        os.remove(test_path)
五、解析性能优化与关键避坑指南
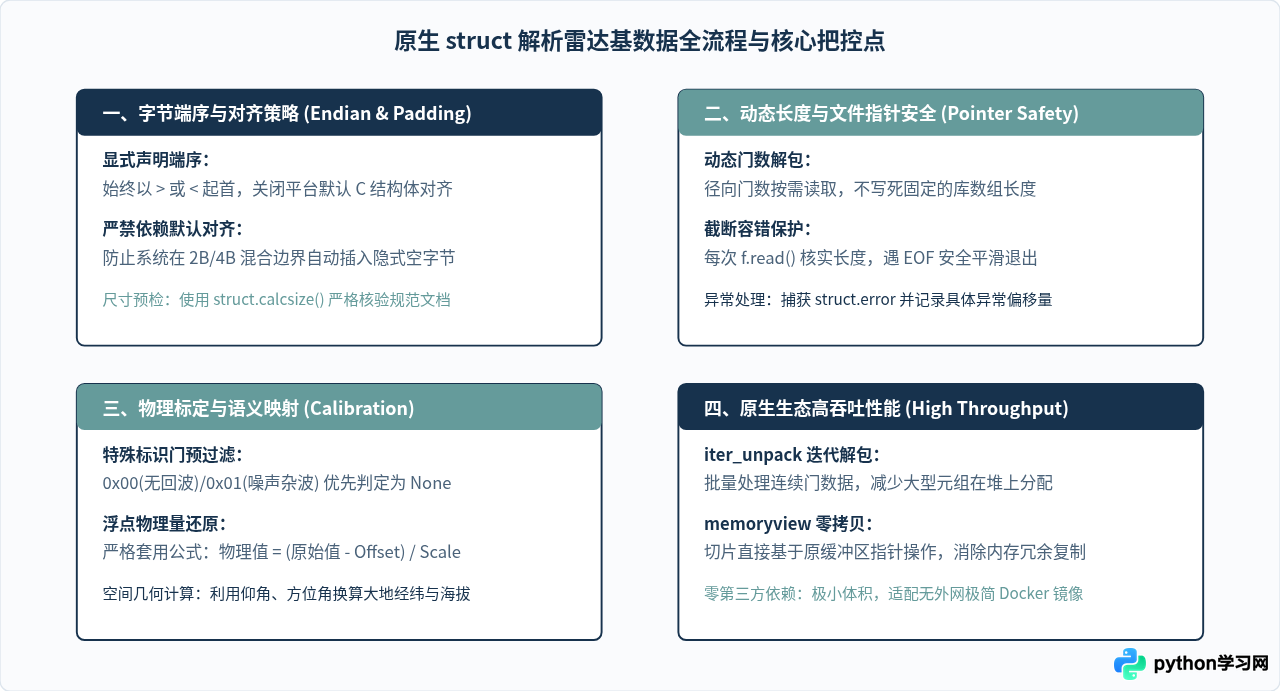
在实际生产部署中,一部多普勒天气雷达一次完整体扫会产生几百个径向、数百万个距离门数据。如果完全使用 Python 的单层 for 循环逐门解包,可能面临一定的执行耗时。通过深入理解 Python 底层机制,可以兼顾纯标准库与高吞吐性能:
- 使用
struct.iter_unpack代替批量字符串构造:在需要对流式二进制进行固定长度重复解析时,struct.iter_unpack(fmt, buffer)可以返回迭代器,避免一次性在内存中创建容纳数十万元素的庞大中间元组。 - 零拷贝内存视图(
memoryview):如果雷达文件已经全部读入内存,对bytes对象做大切片(Slice)会发生内存拷贝。使用memoryview(buffer)[offset:offset+size]可以实现指针级别的无拷贝引用,极大减轻垃圾回收(GC)开销。 - 严格控制结构体对齐标志:若省略
>或<前缀,Python 默认采用@(本机对齐)。在 64 位操作系统中,结构体中short(2 字节)紧跟int(4 字节)时会被编译器插入 2 字节的空白填充(Padding),导致解包指针偏移完全错位。务必在每个格式串最前加入端序符号。 - 防御性处理非标准径向:雷达在天线机械换向、受强风阻挡或硬件重置瞬间,可能产生门数异常的残缺径向。代码中严禁假定每个径向的
gates_num恒定不变,必须实时从每个径向头中动态读取并与剩余文件长度比对。
总结
通过直接使用 Python 的 struct 模块手动解析雷达基数据,我们摆脱了对外部厚重科学计算库的硬性依赖。掌握这种方式不仅能够让你自由运行于无网络环境、边缘网关与极简容器中,更重要的是建立起了对气象雷达底层数据组织、字节序列与物理量标定过程的清晰认知。在面对私有雷达协议或破损数据修复时,这种从二进制直接切入的能力将成为极为稳固的技术基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















