


Python词法分析器实战:解析自定义数学表达式DSL
本文深入讲解如何使用Python构建高效、鲁棒的自定义数学表达式DSL词法分析器,涵盖Token规格设计、命名正则捕获、行列精确定位以及异常处理机制。
eval() 执行用户输入的数学公式存在严重的代码执行安全漏洞,且无法精确捕获语法错误。本文通过 Python 原生模块实战构建一个工业级数学表达式领域特定语言(DSL)词法分析器(Lexer),完成从非结构化字符流到强类型 Token 序列的高效转换,并内置完整的行列坐标定位与非法字符拦截机制。
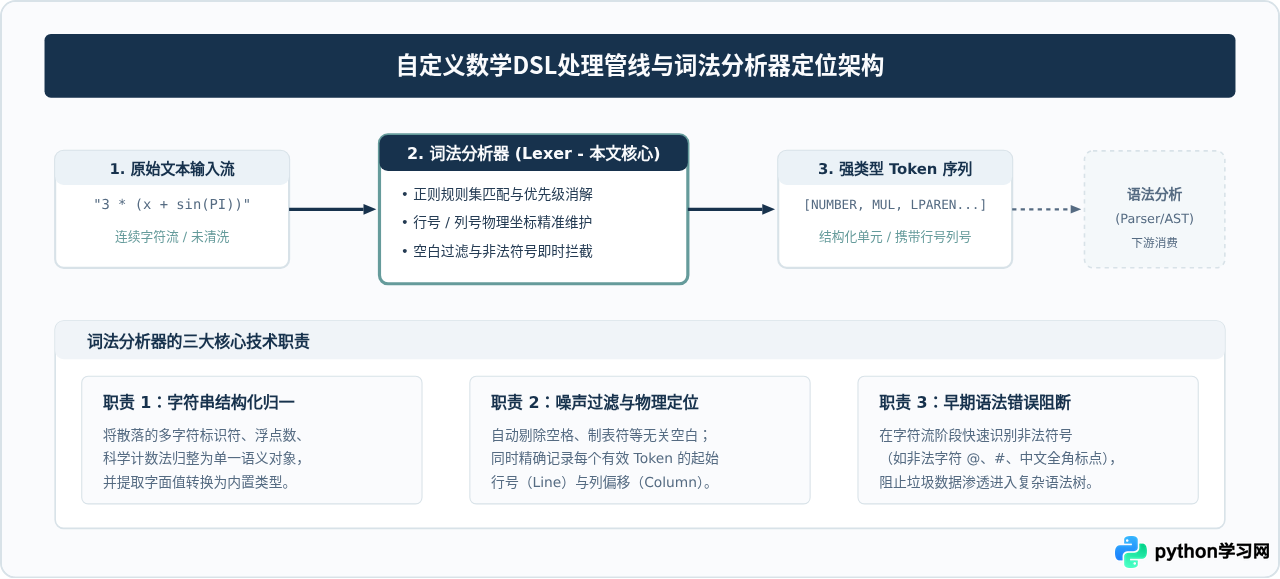
一、自定义数学DSL与词法分析器的核心定位
领域特定语言(Domain-Specific Language, DSL)是针对特定问题域设计的计算机语言。在报表自定义统计、游戏属性公式计算或自动化监控告警中,系统常常允许业务人员输入诸如 total_cost = base_price * (1 + tax_rate) ^ 2 - discount 这类自定义数学表达式。
计算机无法直接“理解”整串文本字符。要对该公式进行求值或类型检查,编译流程通常分为两阶段:第一阶段由词法分析器(Lexer / Tokenizer)将连续的字符流打碎为不可分割的有意义单元(Token);第二阶段由语法分析器(Parser)根据文法规则将其组织为抽象语法树(AST)。词法分析器正是编译器流水线的第一道关卡。
二、设计数学表达式 DSL 的词法规范(Token Specification)
编写词法分析器前,必须清晰界定该数学表达式 DSL 允许哪些语法成分。一个满足通用科学计算与业务公式的 DSL 至少包含以下五大类词法单元:
- 数值常量(NUMBER):支持整数(如
42)、浮点数(如3.1415)以及科学计数法形式(如1.5e-3、2E+5)。 - 标识符与函数名(IDENTIFIER):由英文字母、数字和下划线组成,但不能以数字开头(如变量
tax_rate、内置数学函数sin、sqrt、常量PI)。 - 算术运算符(OPERATORS):加减乘除
+、-、*、/,幂运算符^(或**),以及取模%。需要特别注意多字符操作符优先级匹配。 - 标点符号与分隔符(PUNCTUATION):左右圆括号
(、)控制运算结合顺序,逗号,用于多参数函数调用(如max(a, b)),等号=用于公式赋值。 - 空白符(SKIP):空格与制表符仅起分隔作用,无需作为 Token 输出给下游解析器,但扫描时需准确推移字符指针。
| Token 名称 | 正则表达式模式 | 示例输入 | 说明 |
|---|---|---|---|
NUMBER |
\d+(?:\.\d+)?(?:[eE][+-]?\d+)? |
100, 3.14, 2.5e-4 |
包含整数、小数及科学计数法 |
IDENTIFIER |
[a-zA-Z_]\w* |
x, base_price, sin |
变量名、常数符号及函数名 |
POWER |
\*\*|\^ |
^, ** |
幂运算,长字符 ** 须优于 * 匹配 |
OP_MUL / OP_DIV |
\*, \/ |
*, / |
高优先级乘除双目运算 |
OP_ADD / OP_SUB |
\+, - |
+, - |
低优先级加减双目运算 |
DELIMITERS |
[\(\),=] |
(, ), ,, = |
括号界定、参数分隔与赋值声明 |
SKIP |
[ \t]+ |
, \t |
无语义空白,仅推进列游标 |
MISMATCH |
. |
@, #, ¥ |
兜底捕获未定义字符,立即触发异常 |
三、正则扫描引擎与坐标游标更新机制
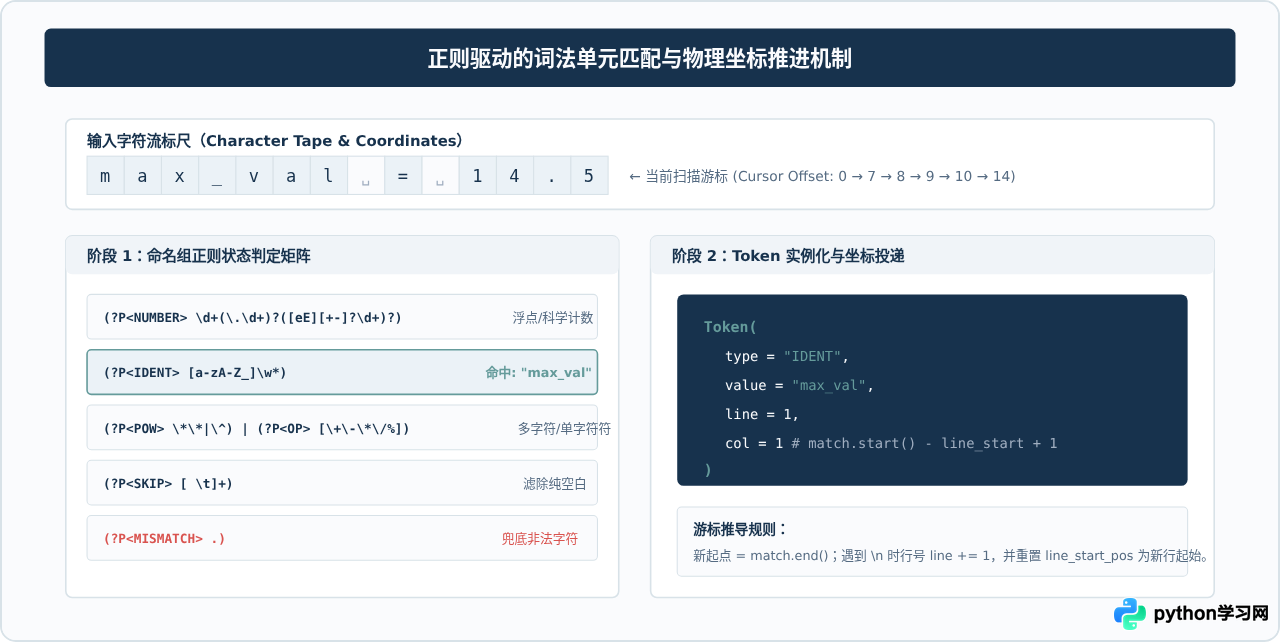
在 Python 中构建词法分析器,最优雅且性能卓越的方法是利用 re 模块的命名捕获组(Named Capture Groups)与 re.finditer 机制。
我们将所有 Token 类型的正则通过命名组语法 (?P<NAME>pattern) 用竖线 | 拼接成一个复合正则表达式。re.compile 会将该庞大的模式编译为底层确定性有限状态自动机(DFA/NFA)。扫描时,每次匹配到的命名组名称即为当前 Token 的类别,匹配字符串即为字面值。
四、Python 词法分析器完整代码实战
以下是针对该自定义数学 DSL 编写的完整词法分析器实现代码。代码使用 Python 3.7+ 的 dataclasses 定义 Token 结构体,封装了自定义异常 LexerError,并通过生成器模式提供流式解析接口。
import re
from dataclasses import dataclass
from typing import Generator, List, Optional, Any

class LexerError(Exception):
    """词法分析异常,携带精确的行列坐标与上下文定位信息"""
    def __init__(self, message: str, line: int, column: int, char: str):
        super().__init__(f"LexerError at Line {line}, Column {column}: {message} (Got: {char!r})")
        self.line = line
        self.column = column
        self.char = char

@dataclass(frozen=True)
class Token:
    type: str
    value: Any
    line: int
    column: int

    def __repr__(self) -> str:
        return f"Token({self.type}, {self.value!r}, line={self.line}, col={self.column})"

class MathDSLLexer:
    """生产级数学表达式 DSL 词法分析器"""

    # 定义词法规则元组:(Token名称, 正则模式)
    # 注意:更长或更具体的模式必须排在前面,以防被短规则前缀截断
    TOKEN_SPECIFICATION = [
        # 1. 数值常量:包括浮点数与科学计数法(如 1.25e-3, 42, 3.14)
        ('NUMBER',     r'\d+(?:\.\d+)?(?:[eE][+-]?\d+)?'),

        # 2. 标识符:变量名与函数名(如 sin, cos, max_val, pi)
        ('IDENTIFIER', r'[a-zA-Z_]\w*'),

        # 3. 幂运算符:** 或 ^
        ('POWER',      r'\*\*|\^'),

        # 4. 双字符/单字符运算符
        ('OP_ASSIGN',  r'='),
        ('OP_ADD',     r'\+'),
        ('OP_SUB',     r'-'),
        ('OP_MUL',     r'\*'),
        ('OP_DIV',     r'/'),
        ('OP_MOD',     r'%'),

        # 5. 界定符与标点
        ('LPAREN',     r'\('),
        ('RPAREN',     r'\)'),
        ('COMMA',      r','),

        # 6. 换行与空白
        ('NEWLINE',    r'\n'),
        ('SKIP',       r'[ \t\r]+'),

        # 7. 兜底匹配任意未知字符
        ('MISMATCH',   r'.'),
    ]

    def __init__(self):
        # 组装复合命名正则表达式:(?P...)|(?P...)...
        parts = [f"(?P<{name}>{pattern})" for name, pattern in self.TOKEN_SPECIFICATION]
        self.master_pattern = re.compile('|'.join(parts))

    def tokenize(self, code: str) -> Generator[Token, None, None]:
        """
        流式生成 Token 序列。
        对于空白直接跳过,遇到换行自增行号,遇到未知字符立即抛出精准异常。
        """
        line_num = 1
        line_start = 0

        for match in self.master_pattern.finditer(code):
            token_type = match.lastgroup
            token_val = match.group()
            match_start = match.start()
            column = match_start - line_start + 1

            if token_type == 'NUMBER':
                # 转换为 Python 数值类型(int 或 float)
                val = float(token_val) if ('.' in token_val or 'e' in token_val or 'E' in token_val) else int(token_val)
                yield Token(token_type, val, line_num, column)

            elif token_type == 'IDENTIFIER':
                yield Token(token_type, token_val, line_num, column)

            elif token_type in ('POWER', 'OP_ASSIGN', 'OP_ADD', 'OP_SUB', 'OP_MUL', 'OP_DIV', 'OP_MOD', 'LPAREN', 'RPAREN', 'COMMA'):
                yield Token(token_type, token_val, line_num, column)

            elif token_type == 'NEWLINE':
                line_num += 1
                line_start = match.end()

            elif token_type == 'SKIP':
                continue

            elif token_type == 'MISMATCH':
                raise LexerError(
                    message=f"遇到未定义的非法字符",
                    line=line_num,
                    column=column,
                    char=token_val
                )
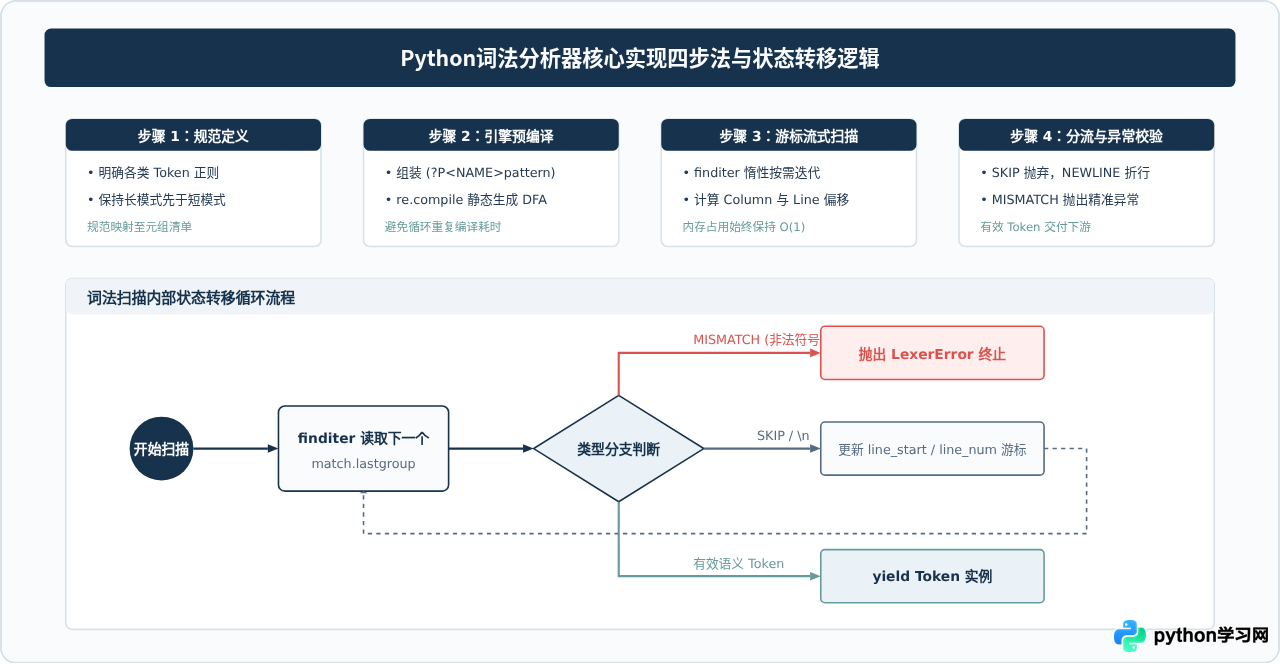
五、词法分析器构建步骤与状态转移控制
实现一个健壮的词法分析器,关键在于状态处理的顺序与边界守护。下图展示了从代码初始化到最终产生 Token 流的四步生命周期:
六、关键技术难点与避坑指南
1. 正则规则的长短词竞争与顺序敏感性
正则表达式引擎的 | 具备从左到右的短路贪婪特性。如果在规则列表中先定义 *(单字符乘号),再定义 **(幂运算符),那么当输入 2 ** 8 时,词法分析器会将 ** 错误拆解为两个连续的乘号 OP_MUL,破坏原语言的语法结构。
\*\*|\^ 必须位于 \* 之前;浮点数模式必须位于纯整数模式之前。
2. 词法阶段与语法阶段的职责边界(负号 vs 减号)
初学者最容易在词法阶段试图区分“一元负号”(如 -5)和“二元减号”(如 a - b)。
事实上,在词法分析阶段无法确定 - 的真实含义,因为其含义完全取决于前驱上下文:如果 - 前面是操作数或右括号,它是二元减法;如果前面是左括号、逗号或位于表达式开头,它是一元取负。词法分析器应当保持纯粹,统一将其标记为 OP_SUB,具体的正负极性判定应由下游语法分析器(Parser)在构建 AST 时根据上下文确定。
3. 精准的行号与列偏移计算
在多行复杂 DSL 脚本中,报错信息如果只显示 SyntaxError: Invalid syntax,排查极为痛苦。我们通过维护 line_start(当前行在整个文本中的起始索引位置),利用公式 column = match.start() - line_start + 1 可以无损推导出 1-indexed 的列号,为后续提供媲美编译器的错误诊断视图:
Line 3, Column 14: 遇到未定义的非法字符 (Got: '¥')
  total = cost * 1.15 ¥ rebate
                       ^
七、运行验证与测试用例
接下来我们使用实际的数学表达式来运行验证上述词法分析器。
用例一:标准科学计算公式
输入复杂数学公式,包含变量、函数、圆括号、多字符乘方与科学计数法:
dsl_code = "result = 2.5e-3 * (x + sin(pi / 4)) ^ 2"
lexer = MathDSLLexer()

for token in lexer.tokenize(dsl_code):
    print(token)
输出结果(完全符合预期,类型明确且行列准确):
Token(IDENTIFIER, 'result', line=1, col=1)
Token(OP_ASSIGN, '=', line=1, col=8)
Token(NUMBER, 0.0025, line=1, col=10)
Token(OP_MUL, '*', line=1, col=17)
Token(LPAREN, '(', line=1, col=19)
Token(IDENTIFIER, 'x', line=1, col=20)
Token(OP_ADD, '+', line=1, col=22)
Token(IDENTIFIER, 'sin', line=1, col=24)
Token(LPAREN, '(', line=1, col=27)
Token(IDENTIFIER, 'pi', line=1, col=28)
Token(OP_DIV, '/', line=1, col=31)
Token(NUMBER, 4, line=1, col=33)
Token(RPAREN, ')', line=1, col=34)
Token(RPAREN, ')', line=1, col=35)
Token(POWER, '^', line=1, col=37)
Token(NUMBER, 2, line=1, col=39)
用例二:非法字符拦截验证
输入包含未经定义的中文标点符号 ¥:
try:
    bad_code = "area = 3.14 * r ¥ 2"
    list(lexer.tokenize(bad_code))
except LexerError as err:
    print(err)
捕获到的异常输出:
LexerError at Line 1, Column 17: 遇到未定义的非法字符 (Got: '¥')八、词法规则与数据模型全景总结
词法分析器是编译器前端基础,也是保证领域特定语言健壮性与安全性的第一块基石。下表全景梳理了本项目核心规则、Token 属性与生产级交付标准:
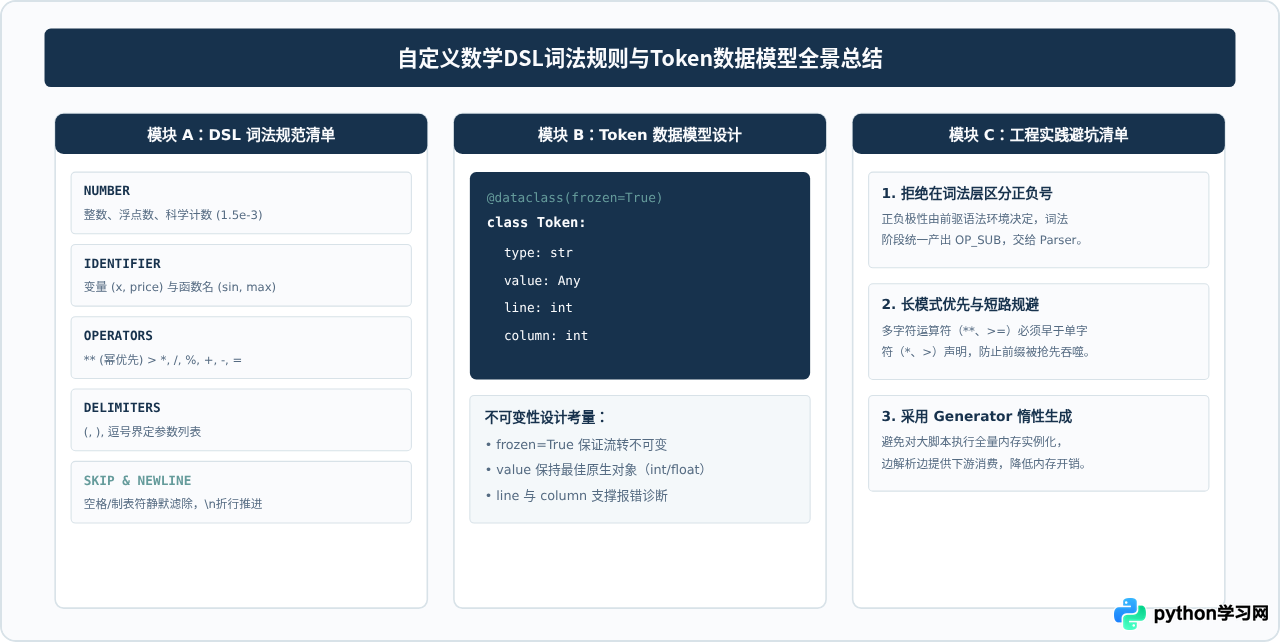
通过本文实现的高性能 MathDSLLexer,我们成功将一段非结构化的自定义数学表达式转换为了标准、干净的 Token 序列。下游的递归下降分析器(Recursive Descent Parser)或 Pratt 语法分析器可以直接消费此 Token 流,进一步构建抽象语法树,实现安全、隔离、可控的公式求值与业务逻辑计算。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















