


pythonlru_cache缓存函数结果怎么用
系统介绍Python标准库functools.lru_cache的使用方法与底层机制,包括函数装饰器挂载、核心参数maxsize与typed的配置、cache_info监控与cache_clear清理,以及参数可哈希性与类方法内存泄漏等高频避坑实践。
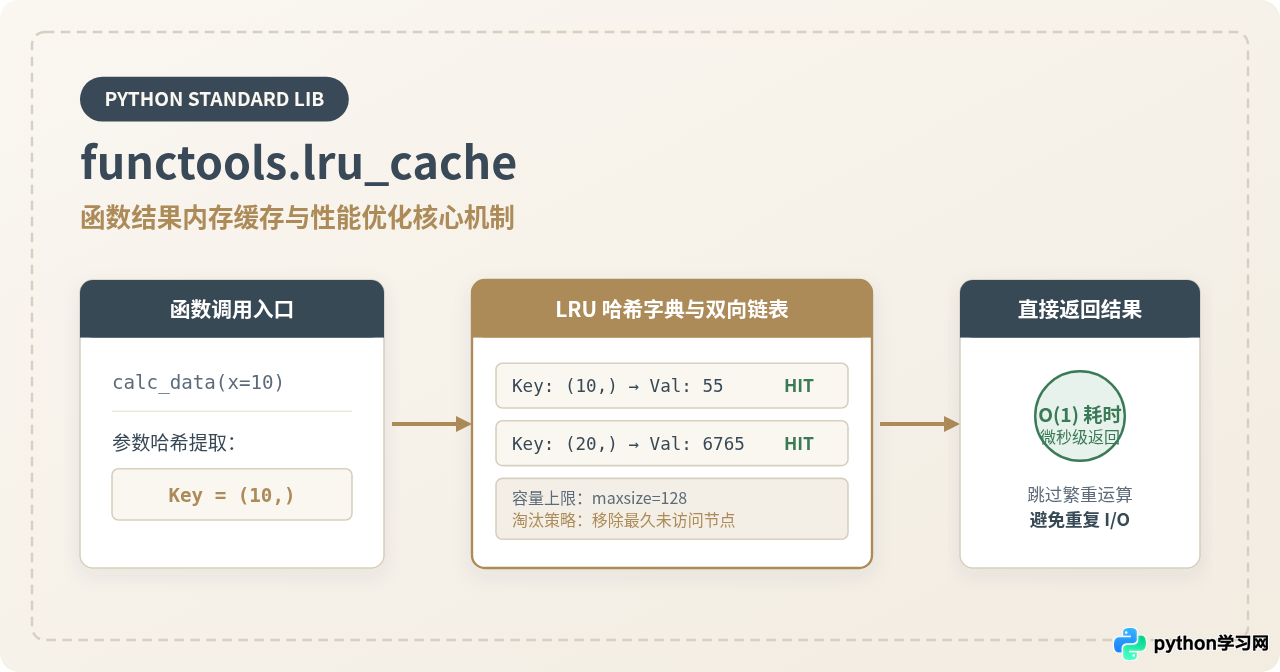
在 Python 开发中,如果一个函数的计算逻辑耗时较长、包含高频的外部查询,或者存在大量的重复入参递归调用,使用内置模块 functools.lru_cache 是成本最低且性能提升最显著的优化手段。它作为装饰器直接作用于函数表面,通过在内存中维护哈希映射与双向链表,记录不同参数组合与对应返回值的映射关系;当相同参数再次传入时,直接在 \(O(1)\) 时间复杂度内返回缓存结果,跳过函数体执行。当缓存容量到达上限时,它会自动剔除最久未被访问的条目(Least Recently Used)。本文将完整拆解其工作机制、核心参数配置、状态监控手段与生产级避坑指南。
一、什么是 lru_cache 及其底层工作机制
lru_cache 是 Python 标准库 functools 中提供的高阶装饰器。LRU 是 Least Recently Used(最近最少使用) 的缩写,这是一种经典的内存淘汰置换算法。其核心思路是:如果某项数据近期刚刚被访问过,那么在不久的将来它再次被访问的概率极高;反之,长期未被使用的数据在内存紧张时应最先被丢弃。
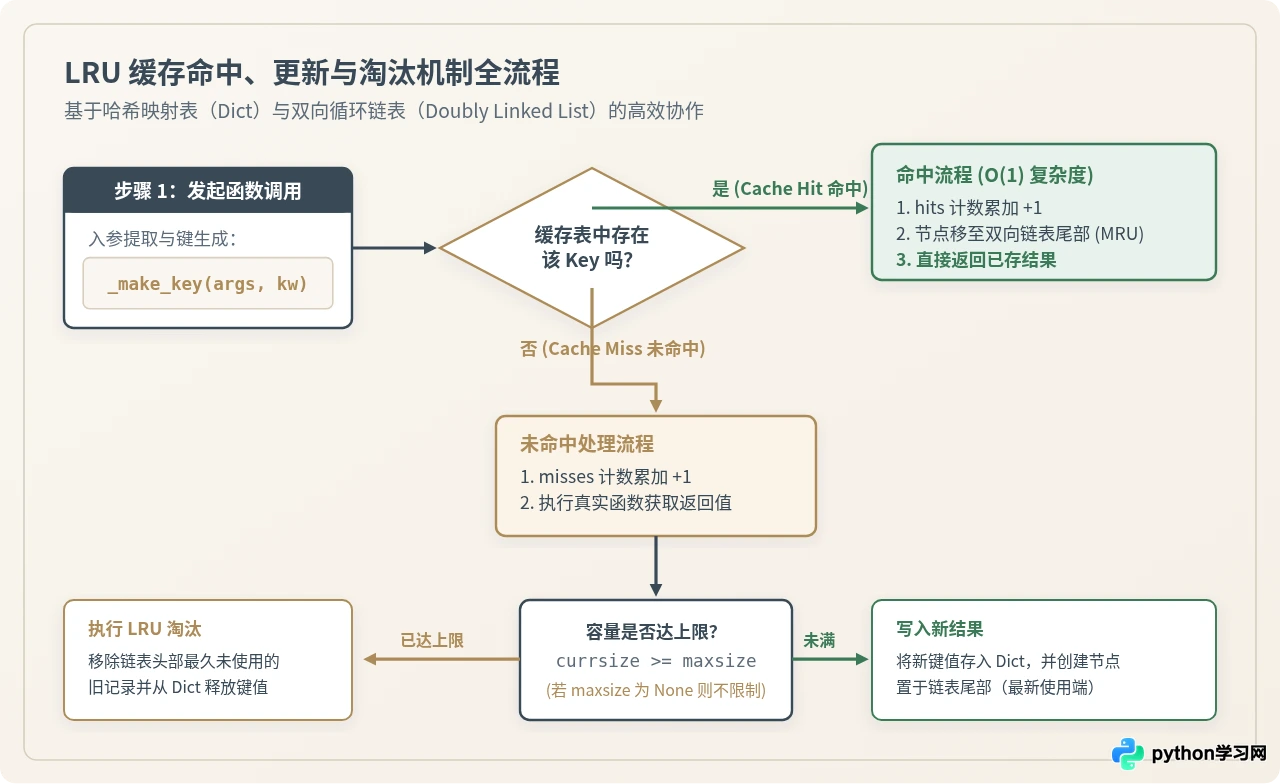
在 Python 内部实现中,lru_cache 结合了哈希字典(Dict)与双向循环链表:
- 哈希字典:以函数的调用实参(位置参数与关键字参数打包成的复合键)作为 Key,函数返回值作为 Value,实现常数级时间复杂度的快速寻址。
- 双向链表:用于维护数据的访问时间顺序。每次命中缓存时,对应节点会被移至链表尾部(表示最新访问);当新增数据且容量已满(达到
maxsize)时,链表头部的旧节点将被安全移出并释放。
二、三步快速上手:基础用法与运行效果
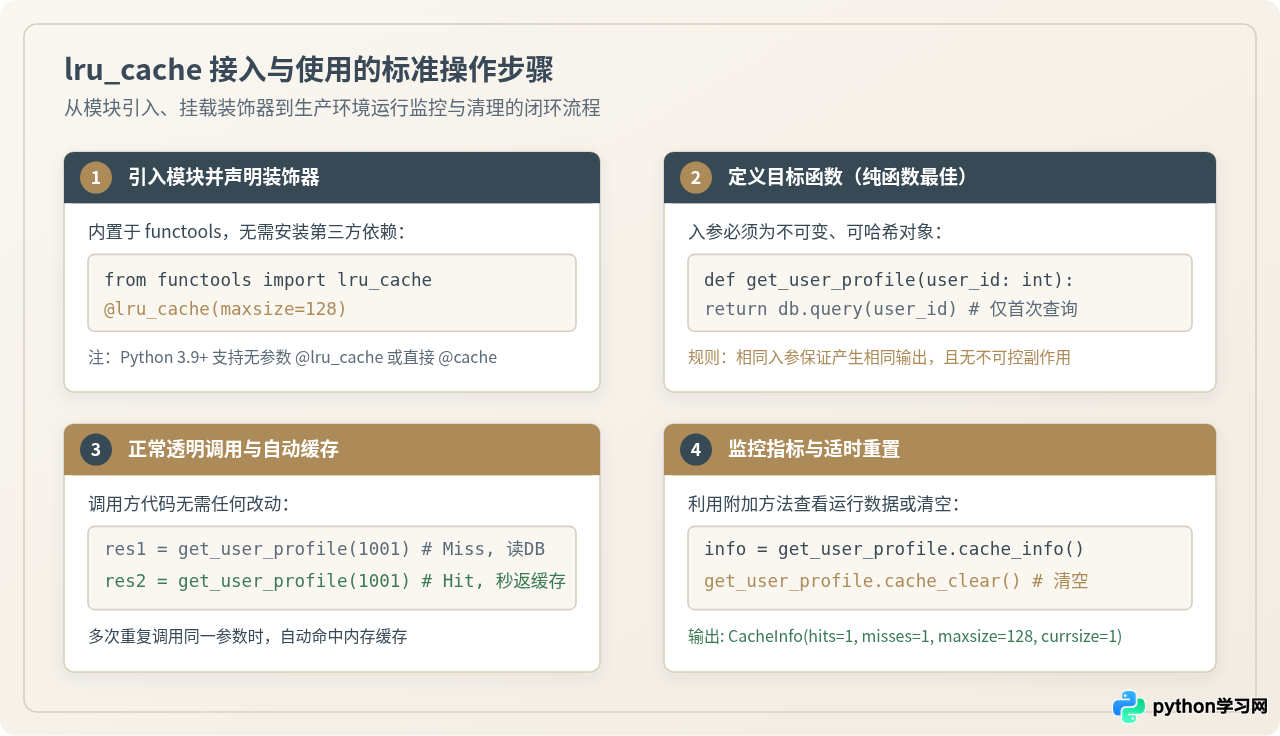
使用 lru_cache 只需三个基本步骤:从 functools 导入、使用装饰器修饰目标函数、按常规方式调用函数。我们以计算密集型的斐波那契数列(Fibonacci)为例,观察其带来的数量级性能提升。
1. 基础代码示例:无缓存 vs 有缓存
常规递归计算斐波那契数列的时间复杂度为 \(O(2^n)\),存在海量的重叠子问题计算:
import time
from functools import lru_cache

# 未使用缓存的原始版本
def fib_raw(n: int) -> int:
    if n < 2:
        return n
    return fib_raw(n - 1) + fib_raw(n - 2)

# 使用 lru_cache 优化的版本
@lru_cache(maxsize=128)
def fib_cached(n: int) -> int:
    if n < 2:
        return n
    return fib_cached(n - 1) + fib_cached(n - 2)

# 性能测试对比
t0 = time.perf_counter()
res_raw = fib_raw(35)
t1 = time.perf_counter()
print(f"fib_raw(35) 计算耗时: {t1 - t0:.6f} 秒")

t2 = time.perf_counter()
res_cached = fib_cached(35)
t3 = time.perf_counter()
print(f"fib_cached(35) 计算耗时: {t3 - t2:.6f} 秒")
运行上述示例输出(示例输出):
fib_raw(35) 计算耗时: 1.845210 秒
fib_cached(35) 计算耗时: 0.000028 秒
原本需要近 2 秒甚至更久的多项式展开计算,在 lru_cache 介入后转变为严格的 \(O(n)\) 线性复杂度,第二次直接调用 fib_cached(35) 时更是直接微秒级返回。
三、核心参数详解:maxsize 与 typed 的科学配置
@lru_cache 接受两个可选关键字参数:maxsize 和 typed。正确理解这两个参数对于控制内存开销与业务准确性至关重要。
| 参数名称 | 类型与默认值 | 取值说明与使用场景 |
|---|---|---|
maxsize |
int 或 None,默认 128 |
缓存能够存储的最大条目数量。通常建议设为 2 的幂次方(如 64、128、512、1024)。 若设为 None,则关闭 LRU 淘汰功能,缓存大小无上限,条目只增不减。
|
typed |
bool,默认 False |
若为 False,不同类型但值相等的参数共享同一份缓存(例如 func(3) 与 func(3.0) 命中同个结果)。若为 True,参数类型也将纳入缓存键比对(func(3) 与 func(3.0) 分别独立计算并存储)。
|
1. maxsize 的选择策略
在默认情况下,maxsize=128 足以应对大部分中小型业务函数。如果已知可能传入的参数组合空间较小(如状态码解析、固定维度的配置转换),可以合理设定为对应规模。若设为 maxsize=None,内存将随调用量的增加而持续增长,必须确保参数组合有限,否则可能引发内存耗尽(OOM)。
Python 3.9+ 语法糖补充:
从 Python 3.9 开始,若不需要传递参数,可省略圆括号直接使用 @lru_cache;同时官方在 functools 中直接提供了 @cache 装饰器,等价于 @lru_cache(maxsize=None),适用于纯粹的无界缓存场景。
2. typed 参数实测对比
当函数的业务逻辑对数值类型敏感时,务必注意 typed 的默认行为:
from functools import lru_cache

@lru_cache(maxsize=32, typed=False)
def square_untyped(x):
    print(f"执行计算: {x} (类型: {type(x).__name__})")
    return x * x

square_untyped(5)    # 首次计算: 5 (int)
square_untyped(5.0)  # 命中缓存!直接返回 25,不触发打印

@lru_cache(maxsize=32, typed=True)
def square_typed(x):
    print(f"执行计算: {x} (类型: {type(x).__name__})")
    return x * x

square_typed(5)    # 执行计算: 5 (int)
square_typed(5.0)  # 重新执行计算: 5.0 (float),独立存储!
四、运行状态查看与缓存清理
被 lru_cache 装饰后的函数,会额外挂载几个非常有用的运行时管理方法:cache_info()、cache_clear() 和 __wrapped__。
1. cache_info():评估命中效率
调用 func.cache_info() 会返回一个命名元组(NamedTuple),包含 4 个核心字段:
hits:缓存命中总次数。数值越高,说明缓存收益越显著。misses:未命中导致实际运行函数的次数。maxsize:配置的最大缓存容量限制。currsize:当前内存中已实际占用的缓存槽位数量。
from functools import lru_cache

@lru_cache(maxsize=100)
def query_config(key: str) -> str:
    return f"val_for_{key}"

query_config("timeout")  # miss +1
query_config("timeout")  # hit +1
query_config("retry")    # miss +1

print(query_config.cache_info())
# 输出示例: CacheInfo(hits=1, misses=2, maxsize=100, currsize=2)
2. cache_clear():显式重置缓存
当底层数据源发生更新,或者单元测试需要在每个用例执行前清空污染时,应主动调用 func.cache_clear(),它将立刻清空内部所有缓存键值并重置计数器。
3. __wrapped__:访问未被缓存包装的原函数
lru_cache 遵循标准装饰器规范,通过 func.__wrapped__ 可以直接获取底层被修饰的原始函数。在需要绕过缓存强制单次执行原生计算或进行精细单元测试时,该属性非常方便。
五、高频踩坑场景与规避方案
尽管 lru_cache 使用极其简便,但在实际工程落地中,有几个极易出现隐蔽 BUG 的关键边界需要引起重视。
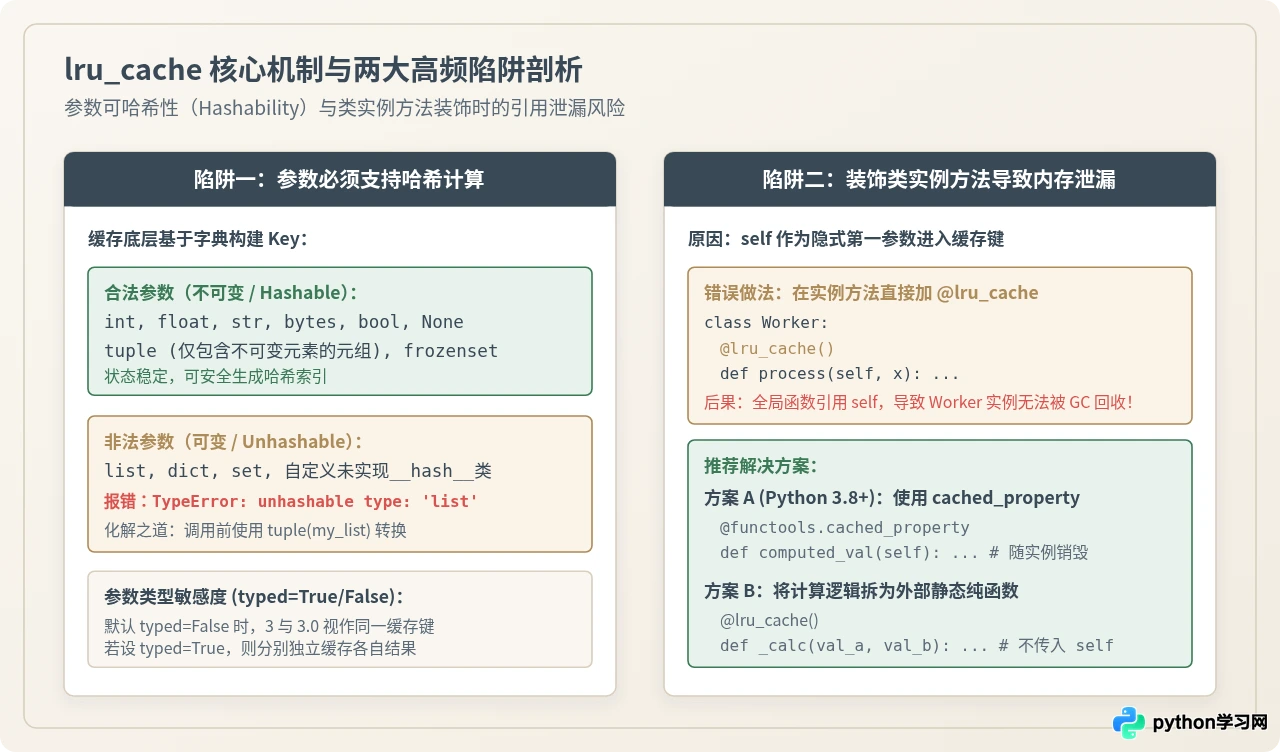
1. 陷阱一:参数必须是可哈希对象(Hashable)
因为 lru_cache 在底层依赖字典键匹配,函数的入参会被打包并计算哈希值。如果传入了 list、dict、set 等可变容器,Python 会在运行时直接抛出 TypeError: unhashable type: 'list'。
解决方案:在调用前或定义函数时,将可变结构转换为不可变的对等结构。例如将 list 转换为 tuple,将 set 转换为 frozenset,将嵌套字典转换为键值排序后的元组序列。
from functools import lru_cache

@lru_cache(maxsize=128)
def process_items(items: tuple):  # 明确声明接收 tuple 而非 list
    return sum(items)

# 错误调用方式:
# process_items([1, 2, 3])  -> 抛出 TypeError: unhashable type: 'list'

# 正确调用方式:
process_items(tuple([1, 2, 3]))  # 正常命中与返回
2. 陷阱二:装饰类实例方法引发内存泄漏
当 @lru_cache 直接装饰类的实例方法时,self 会作为首个位置参数参与哈希计算。由于被装饰的方法对象本身生命周期往往较长,或者内部全局闭包持有了 self,会导致该实例对象的引用计数始终大于零,垃圾回收器(GC)无法及时回收该实例及其占用的附属资源,从而引发渐进式内存泄漏。
规避方案:
- 无参数计算属性:优先使用 Python 3.8+ 提供的
@functools.cached_property,其缓存直接存储在实例的__dict__中,生命周期与实例完全绑定,实例销毁时缓存自动回收。 - 有参数方法:将纯粹的计算逻辑剥离为外部独立函数或静态方法
@staticmethod,仅传入不可变的必要数据参数,切断对self的直接强引用。
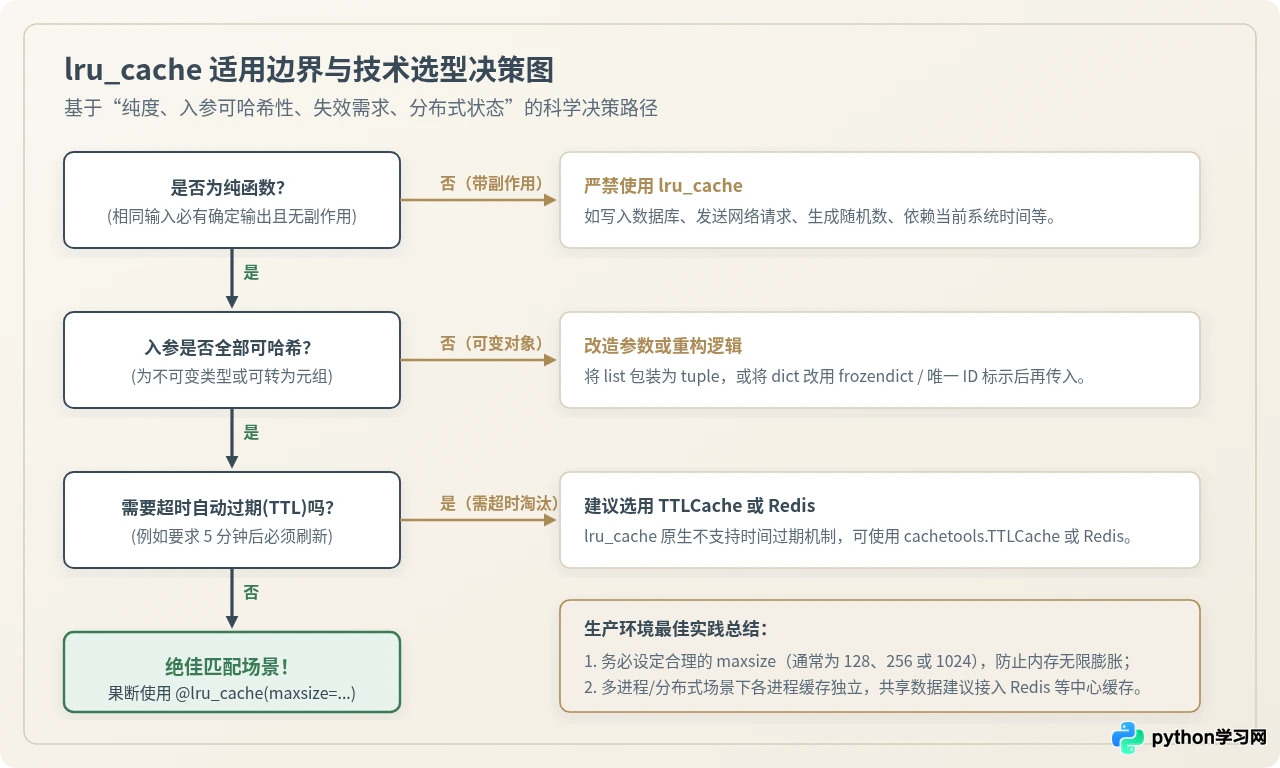
3. 陷阱三:切勿修饰带副作用或依赖外部状态的函数
lru_cache 的成立前提是纯函数(Pure Function)特性。以下函数绝不可挂载 lru_cache:
- 生成随机数或依赖系统时钟的函数(如包含
random.random()、time.time()、datetime.now()); - 涉及数据库写操作、消息队列发送、向外部硬件发送指令的函数;
- 依赖可能被并发修改的全局变量的函数。
六、适用场景与技术选型决策
为了帮助读者在面临性能瓶颈时做出正确的架构与工具选择,下表及决策图梳理了常见缓存策略的技术边界:
| 选型方案 | 存储介质 | 过期机制 | 分布式共享 | 适用典型场景 |
|---|---|---|---|---|
| functools.lru_cache | 当前进程内存 | 仅容量满时淘汰 (LRU) | 否(进程独立) | 静态配置解析、纯数学/几何计算、重叠递归算法、模板编译 |
| cachetools.TTLCache | 当前进程内存 | 基于存活时长 (TTL) | 否(进程独立) | 第三方 API 响应临时缓存(如天气、汇率)、读多写少的轻量字典 |
| Redis / Memcached | 独立分布式缓存服务 | TTL + 多种淘汰策略 | 是(跨进程、跨节点) | 高并发用户 Session、分布式锁、跨微服务共享热点数据 |
总结
functools.lru_cache 是 Python 提供的一把“小巧而锋利”的性能优化手术刀。在日常开发中,只要满足“计算昂贵或重复率高”、“入参不可变且可哈希”、“函数无副作用”三大核心前提,只需一行装饰器即可获得成倍的响应性能提升。在生产实践中,应始终养成显式配置 maxsize 的习惯,并善用 cache_info() 监测命中率,确保系统在内存开销与执行速度之间取得最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















