


Python ImportError常见原因及排查方法
深入解析Python中ImportError与ModuleNotFoundError的常见诱因,涵盖环境隔离、sys.path搜索路径、同名文件遮蔽、相对导入规范及循环导入解耦方案,提供系统化的定位排查步骤与修复指南。
ImportError 是 Python 运行时在解析模块、包或导入特定对象失败时抛出的基础异常。定位该异常的关键在于建立清晰的分步判定路径:首先依据异常提示明确是“找不到模块文件”还是“加载模块后找不到内部对象”,随后沿着 Python 解释器的模块搜索路径(sys.path)和模块初始化生命周期,逐项核验解释器环境、命名冲突、相对导入层级以及循环依赖关系。
一、区分 ImportError 与 ModuleNotFoundError 的报错形态
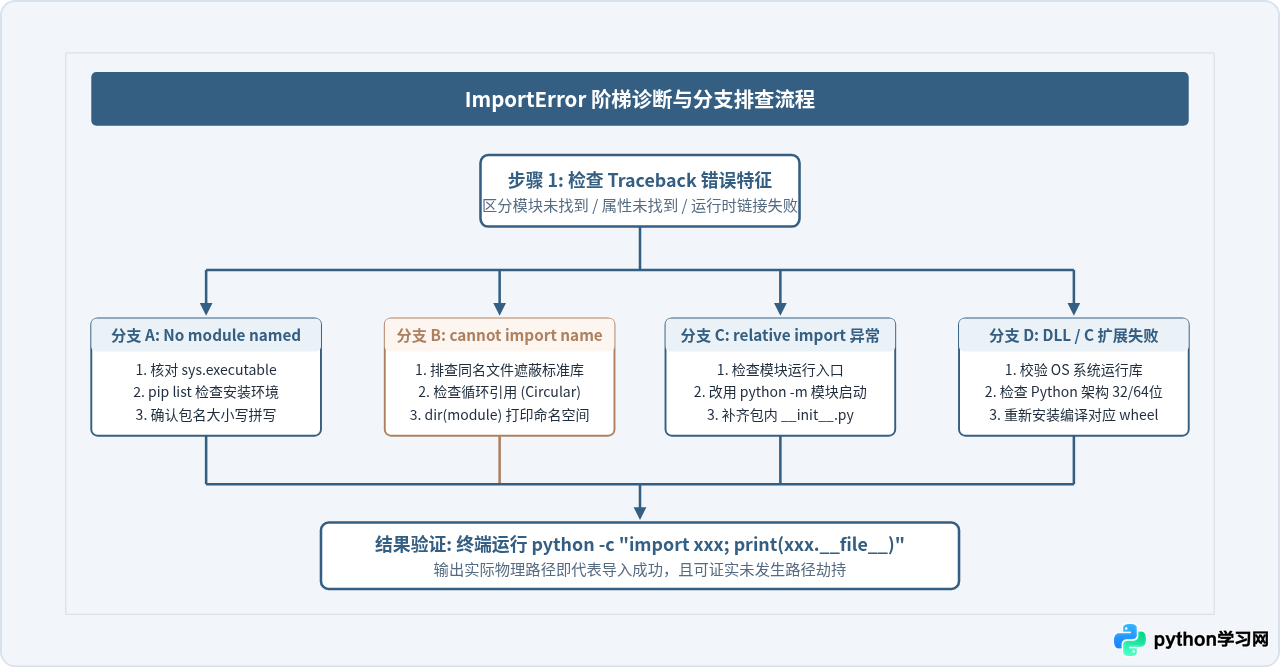
在排查问题前,首先需要仔细阅读终端给出的完整回溯信息(Traceback)。Python 在 3.6 版本后对导入异常进行了细分,不同的报错提示直接对应了完全不同的底层故障节点。
-
形态一:
ModuleNotFoundError: No module named 'xxx'
这是ImportError的直接子类。它意味着 Python 在当前的搜索路径列表中,没有找到名为xxx.py的文件、内置 C 模块或包含__init__.py的包目录。 -
形态二:
ImportError: cannot import name 'yyy' from 'xxx'
该提示表明模块xxx已经被成功定位并加载,但在xxx的全局命名空间中未找到标识符yyy。这通常由于模块内拼写错误、本地同名文件意外遮蔽了第三方库,或者两个模块之间发生了循环导入。 -
形态三:
ImportError: attempted relative import with no known parent package
这发生在使用了点号相对导入语法(如from .utils import helper)时,当前执行的模块未被识别为包的一部分。 -
形态四:
ImportError: DLL load failed / undefined symbol
Python 已经找到对应的 C 扩展模块(如.pyd或.so文件),但操作系统在动态加载链接库时缺少底层依赖项或 CPU 架构不匹配。
二、原因一:解释器错位与第三方包未安装
当出现 ModuleNotFoundError 时,最常见的原因并非没有安装依赖,而是终端执行安装的 Python 环境与代码运行所在的 Python 解释器不一致。这种现象在使用了系统自带 Python、Conda 以及多个虚拟环境(venv)的开发机上极为普遍。
1. 查看当前运行代码的准确解释器
在待测试脚本的最开头加入以下代码,打印出当前运行环境的物理路径与第三方模块安装目录:
import sys

print("当前解释器路径:", sys.executable)
print("模块搜索目录列表:")
for p in sys.path:
    print("  -", p)
2. 使用与解释器绑定的 pip 重新安装依赖
如果在系统终端直接敲 pip install requests,该命令可能将包安装到了全局解释器,而你的 IDE(如 VS Code 或 PyCharm)使用的是虚拟环境解释器。解决该问题的标准操作是永远通过具体的 Python 解释器去调用 pip 模块:
# 确保将包安装到当前明确指定的 python 解释器所在环境中
/path/to/your/venv/bin/python -m pip install <package_name>

# 验证安装是否生效及所在位置
/path/to/your/venv/bin/python -c "import <package_name>; print(<package_name>.__file__)"
三、原因二:本地文件名与标准库冲突(命名遮蔽)
如果在执行 import math、import json 或 import requests 时,报错为:
ImportError: cannot import name 'pi' from 'math'
# 或者
AttributeError: partially initialized module 'json' has no attribute 'loads'
这通常是因为当前脚本所在目录下存在一个与标准库同名的文件(如 math.py、test.py 或 json.py)。
Python 启动时,会自动将启动脚本所在的当前目录注入到 sys.path 的第一个位置(索引为 0)。当代码执行 import math 时,解释器优先在当前目录找到了你的 math.py 并将其载入,而没有去加载 Python 标准库中的真正的 math 模块。如果你的 math.py 中没有定义 pi 变量,就会抛出 cannot import name。
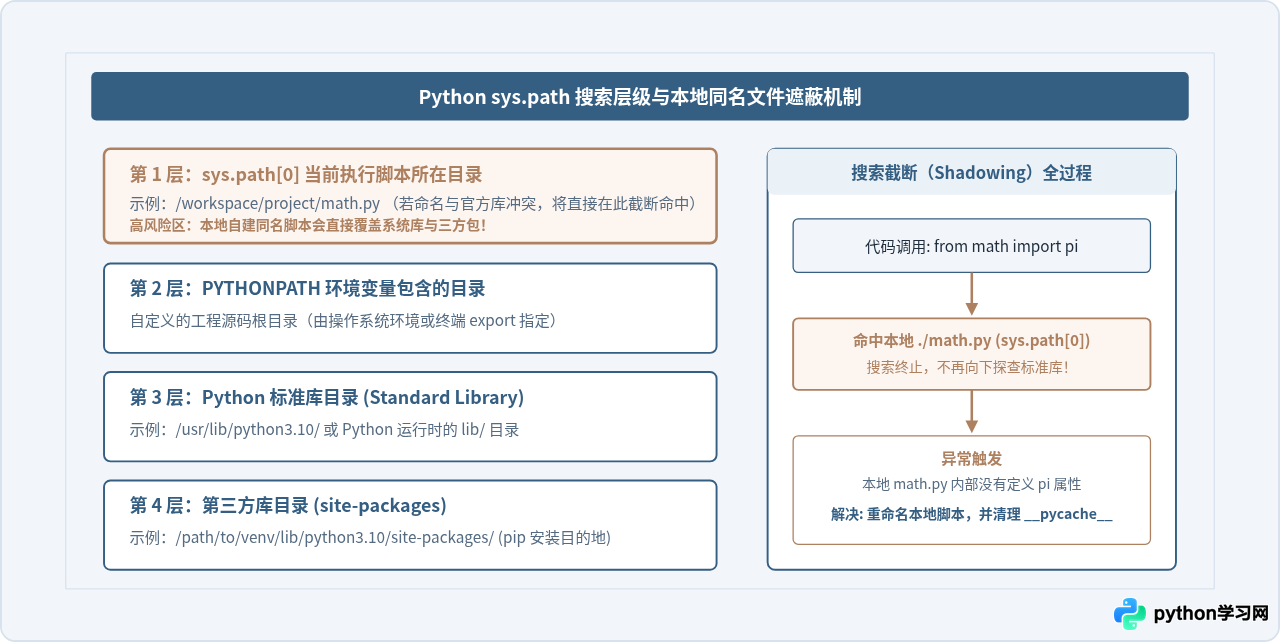
__file__ 属性:
python -c "import math; print(math.__file__)"
如果输出的是你当前工作目录下的文件而不是标准库路径,请立即将本地文件重命名,并删除同级目录下的
__pycache__ 缓存文件夹。
四、原因三:项目多目录结构与相对导入问题
在较大型的多层级工程中,常常遇到在子目录脚本中导入平级模块或父级模块抛错。常见报错形态包括:
ImportError: attempted relative import with no known parent packageModuleNotFoundError: No module named 'utils'(在跨子文件夹调用时)
1. 相对导入的工作机制
Python 中的相对导入(以 . 或 .. 开头)依赖于模块的 __name__ 属性。当直接使用 python path/to/script.py 运行某个脚本时,该脚本的 __name__ 会被强制赋值为 "__main__",此时解释器不知道它所属的父包层级,因而所有点号相对导入都会立即失效。
2. 规范解决步骤
-
在项目根目录使用
-m参数执行:
不要直接cd进入子目录去运行子模块。保持在项目根目录下,使用模块名运行:# 错误执行方式: cd myproject/core && python worker.py # 正确执行方式: 位于 myproject 根目录 python -m core.worker -
确认包标识文件
__init__.py:
虽然 Python 3.3+ 引入了隐式命名空间包,但在多层级工程中,显式在各子文件夹中放置一个空的__init__.py文件,能够确保各种静态代码检查器与打包工具稳定识别包边界。 -
通过
PYTHONPATH指定工程根路径:
如果需要在自动化测试或脚本中自由跨目录导入,可在运行前临时或永久指定根路径:export PYTHONPATH="${PYTHONPATH}:/path/to/myproject"
五、原因四:循环导入(Circular Import)
循环导入是中大型 Python 项目中最隐蔽的 ImportError 诱因。其典型报错通常表现为:
ImportError: cannot import name 'User' from partially initialized module 'models.user' (most likely due to a circular import)1. 为什么会发生循环导入?
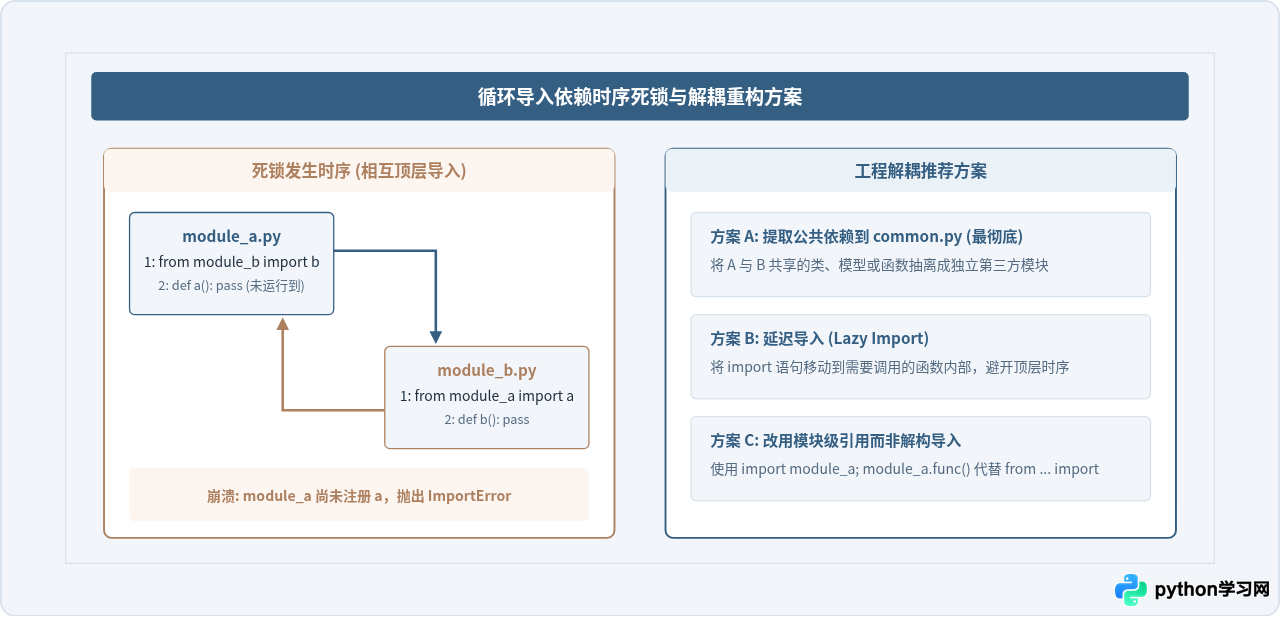
Python 执行 import 时,首先在 sys.modules 注册一个未初始化的空模块对象,随后自顶向下逐行执行该模块内的代码。如果模块 A 在尚未执行完毕时,通过 from b import FuncB 导入了模块 B,而模块 B 的顶部又写着 from a import FuncA,此时模块 B 会反向请求模块 A 的 FuncA。但模块 A 尚处于执行中期,还没有运行到定义 FuncA 的代码行,于是 Python 判定其为未完全初始化模块,抛出 ImportError。
2. 解除循环导入的三种实用方法
-
方法一(最佳实践):重构分层,提取基础模块
循环导入往往是架构设计中模块权责不清的信号。将双方依赖的数据结构、常量或基类抽离到单独的models.py、constants.py或types.py中,使单向依赖成立。 -
方法二:延迟导入(Lazy Import)
如果只是在某个方法中偶发调用,可将导入动作移入函数作用域内,确保模块在顶层已被完整加载完毕:# module_b.py def process_data(): # 局部导入:此时 module_a 的所有顶层代码均已执行完毕 from module_a import get_config config = get_config() ... -
方法三:仅导入模块对象本身
写import module_a而不是from module_a import a_func。在 Python 中,只要模块在sys.modules中占位,import module_a便不会报错;而在稍后真正调用module_a.a_func()时,该函数早已完成绑定。
六、原因五:动态链接库(DLL/SO)缺失与架构冲突
当安装带有 C/C++ 扩展的第三方库(例如 numpy、cv2、torch 等)时,可能出现:
ImportError: DLL load failed while importing _sqlite3: 找不到指定的模块。
# 或者
ImportError: dlopen(...): mach-o file, but is an incompatible architecture (have 'arm64', need 'x86_64')
这类报错不是因为缺少 Python 源码,而是操作系统层面的动态链接阶段受阻:
- Windows 平台缺失运行库: 常见于缺乏 Microsoft Visual C++ Redistributable(VC++ 运行库)。前往微软官网下载并安装 VC++ 2015-2022 运行库安装包后即可修复。
-
macOS 架构冲突: 常见于在 Apple Silicon(M系列芯片)电脑上,通过 Rosetta 模拟的 x86_64 终端安装了 x86 版本的 Python,但误加载了 arm64 的本地编译库。排查命令:
若输出包含file $(which python)x86_64与arm64不一致,建议全部统一为 arm64 原生环境。 -
Linux 动态库缺失: 缺少系统级依赖库(如
libGL.so、libgthread-2.0.so.0),需要使用系统的包管理工具安装系统包,例如在 Debian/Ubuntu 上执行apt-get install -y libgl1-mesa-glx。
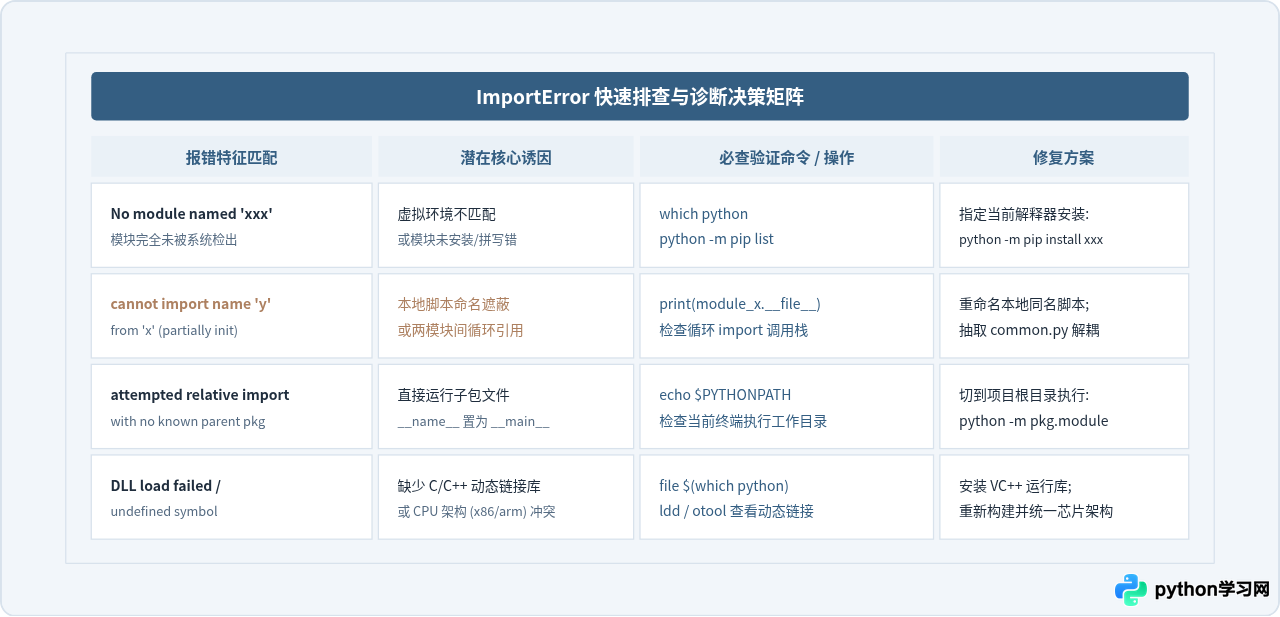
七、排查方法与诊断决策矩阵
在实际维护或部署 Python 服务时,可根据下方的速查矩阵,结合对应的确认命令迅速收敛故障原因并进行修复:
八、总结
排查 ImportError 并不是无序的尝试,而是对 Python 执行上下文的一次精准核验:
- 看全报错信息:确认是模块文件未找到(
ModuleNotFoundError),还是找到了文件但未解析出目标变量(cannot import name)。 - 核对执行解释器:永远用
sys.executable查清正在跑的是哪一个 Python,并用python -m pip install安装目标包。 - 警惕同名文件遮蔽:通过
print(module.__file__)确认导入的文件位于标准库或site-packages,而非当前工程目录下的自建同名脚本。 - 规范多包启动姿势:在工程根目录下使用
python -m模式启动脚本,保持包名解析空间完整。 - 破除循环导入时序:理清模块权责,通过提取公共依赖模块(
common.py)或函数内延迟导入的方式解除双向紧耦合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















