


Python怎么保留Excel原始格式进行读写?推荐支持样式的库
详解Python如何在读写Excel时完整保留原有单元格样式、公式、边框和合并单元格。分析常规库丢失格式的原因,对比推荐openpyxl与xlwings,并提供具体可运行的代码示例与避坑指南。
read_excel读取再用to_excel保存,原工作表中的背景填充、字体字号、边框线、合并单元格乃至公式都会被直接丢弃。要实现“保留原始格式进行读写”,核心逻辑在于不重建整个工作簿,而是加载已有文档的对象模型(DOM),仅针对目标单元格的值进行原地修改并保存。最推荐的库是纯Python且跨平台的openpyxl;若涉及企业级复杂动态图表、重度透视表或VBA宏,则推荐通过xlwings调用本地Excel应用进程。
一、为什么常规读写方式会丢弃原有格式?
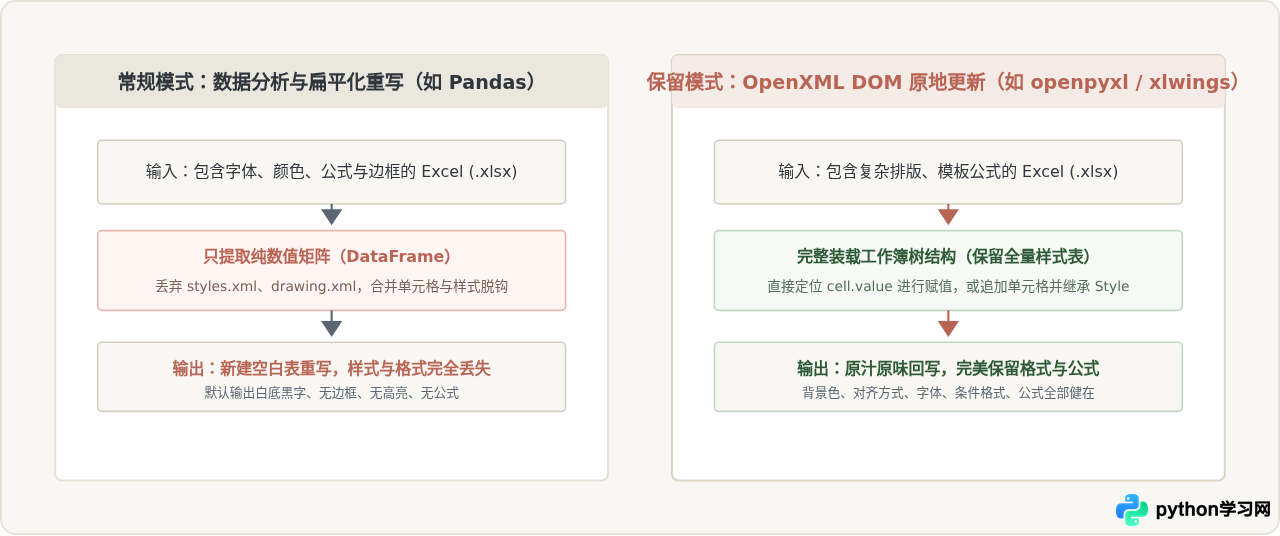
很多初学者接触Python处理表格,最先使用的工具往往是Pandas。Pandas的定位是“数据清洗与矩阵分析”。当执行pd.read_excel('report.xlsx')时,底层解析器只会提取每个单元格的纯计算值(Values),其余的版式、对齐方式、字体颜色等元数据在内存解析阶段就已经被过滤掉。随后的df.to_excel()实际上是创建了一个全新的空白文件,再把纯数据填入,自然不可能保留任何原表格式。
现代Excel文件(.xlsx)的本质是一个基于OpenXML标准的ZIP压缩包。解压后可以看到,数据存储在sheet1.xml等文件中,而样式信息独立存储在styles.xml,图表和图形信息在drawing.xml。如果读取库不能同时解析并维护这套XML关联树,任何写入操作都会导致版面格式的损坏。理解这一底层机制后,我们就能清晰区分两类不同的处理流程:
二、支持样式的常用库及选型推荐
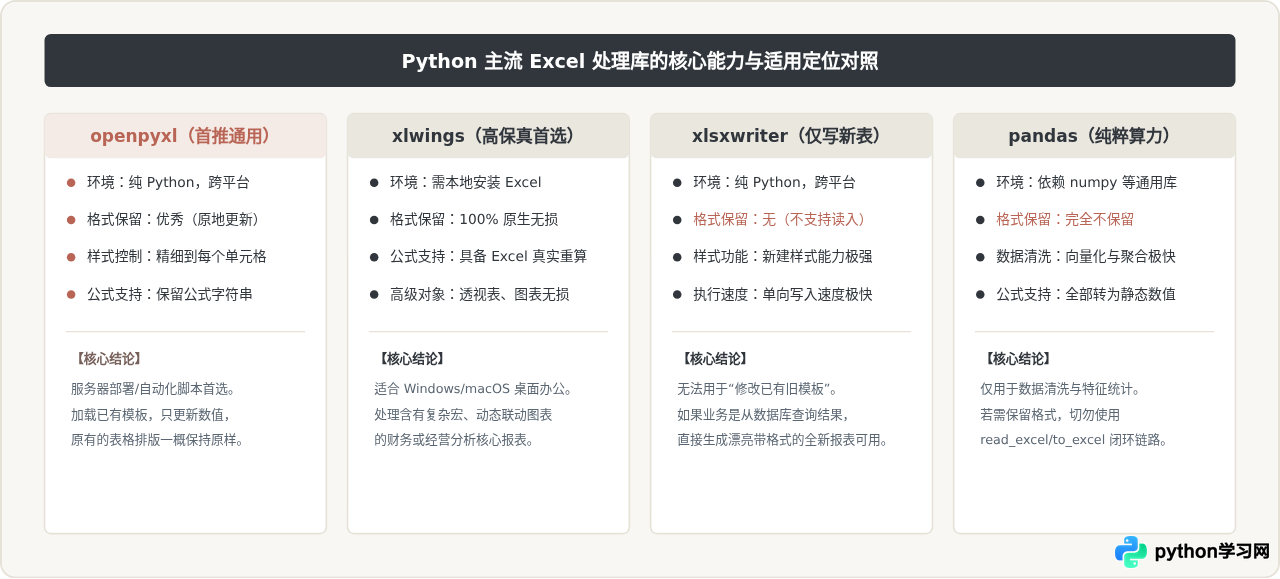
在Python生态中,有多个第三方库具备处理Excel的能力,但它们的设计初衷和能力侧重点截然不同。为了让读者在实际项目中做出正确选择,下面对四种主流工具进行横向对照:
| 库名称 | 运行环境依赖 | 原有格式保留能力 | 对公式/图表/宏的支持 | 适用核心场景 |
|---|---|---|---|---|
| openpyxl | 纯Python,无额外软件依赖 | 极佳(单元格样式、边框、合并单元格完美保留) | 保留公式文本,图表一般不被破坏;但不支持VBA宏执行与计算缓存刷新 | 跨平台Linux/macOS/Windows服务器部署,按模板读写数据 |
| xlwings | 需要安装Microsoft Excel / WPS | 100%完全无损(直接驱动本地Excel底层) | 完全支持公式重算、动态图表刷新、VBA宏调用与透视表联动 | 本地桌面端办公自动化,高保真金融报表与复杂仪表盘生成 |
| xlsxwriter | 纯Python,无额外依赖 | 不支持读已有文件(仅支持从零生成) | 从零绘制图表、条件格式、富文本性能优异 | 报表系统从零导出高质量排版格式的新文件 |
| pandas | 纯Python + 依赖底层解析器 | 完全丢失(仅提取纯数据) | 不支持保留公式,仅保留静态计算结果 | 海量数据聚合、统计、过滤,不关心输出文件排版 |
三、实战方案一:使用 openpyxl 完整保留格式读写
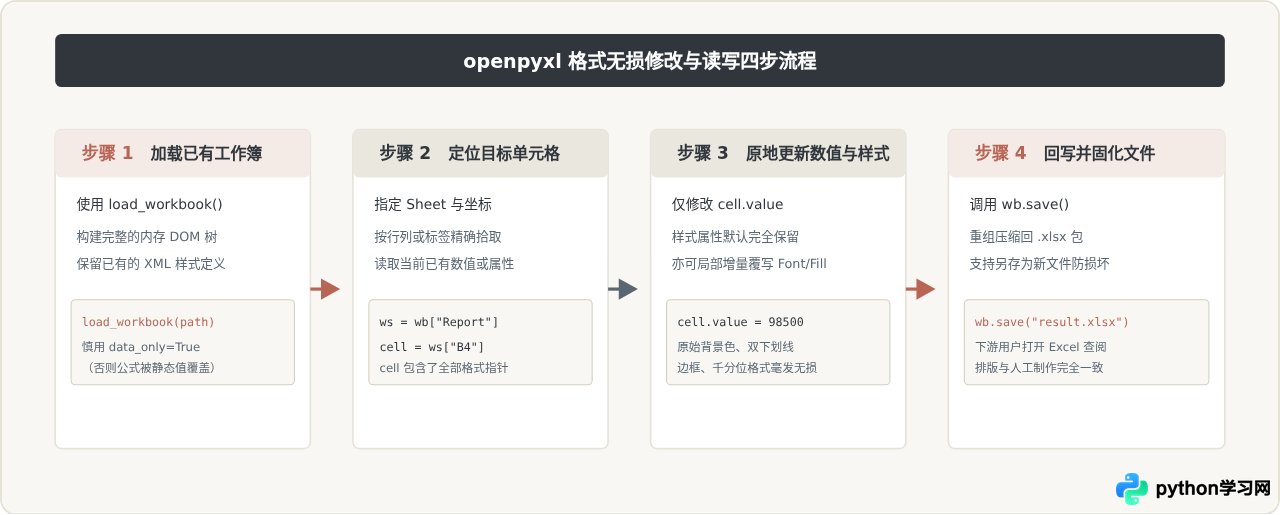
对于大多数无桌面环境的 Linux 服务器或常规自动化需求,openpyxl 是最实用的解决方案。通过 load_workbook() 将已有工作簿加载至内存后,已有的单元格样式会被自动挂载到每个 Cell 对象上。只要不重建工作表,直接给 cell.value 重新赋值,原有的单元格背景、字体、对齐和边框就会得到 100% 继承。
1. 完整代码示例:原地修改单元格并保留原格式
假设我们有一份预先设计好样式的销售模板 sales_template.xlsx,第一行带有深色背景和粗体表头,B4单元格有货币格式和自定义边框。我们希望读取原数据并更新B4单元格的内容,同时不破坏任何已有视觉元素:
from openpyxl import load_workbook
from openpyxl.styles import Font, PatternFill

# 第一步:加载现有工作簿。
# 注意:不要传递 data_only=True,否则模板里的 SUM 等计算公式在保存时会被抹除
wb = load_workbook("sales_template.xlsx")

# 第二步:选择工作表
ws = wb["2024Q3"]

# 第三步:读取单元格原值,并在保留样式的前提下更新值
current_val = ws["B4"].value
print(f"原单元格数值: {current_val}")

# 原地更新值:B4已有的背景色、对齐方式、边框不受任何影响
ws["B4"].value = 189200.50

# 如果有特殊需求,需要对某个被修改的单元格附加警示高亮,可以增量设置样式
# 未显式更改的属性(如对齐方式、外边框)仍会保留
ws["B4"].font = Font(name="Microsoft YaHei", size=11, bold=True, color="B96555")
ws["B4"].fill = PatternFill(start_color="FFF0ED", end_color="FFF0ED", fill_type="solid")

# 第四步:保存为新文档(建议避免直接覆盖模板)
wb.save("sales_report_final.xlsx")
print("更新完成,原有格式与公式均已保留。")
2. 怎么追加新行并继承上一行的格式?
如果业务需要往已有模板的表格底部追加多条新数据,直接使用 ws.append() 会以纯文本形式写入,新行将没有任何边框和字体样式。要保持视觉一致,标准做法是遍历上一行的单元格,将 cell.font、cell.border、cell.fill 和 cell.number_format 拷贝给新单元格:
from copy import copy
from openpyxl import load_workbook

wb = load_workbook("report.xlsx")
ws = wb.active

# 假设上一行是有完整格式的数据行(第10行)
template_row_idx = 10
new_row_idx = 11

new_data = ["北京分公司", 89400, "已归档"]

for col_idx, value in enumerate(new_data, start=1):
    new_cell = ws.cell(row=new_row_idx, column=col_idx, value=value)
    source_cell = ws.cell(row=template_row_idx, column=col_idx)

    # 深度继承源单元格的全部样式对象
    if source_cell.has_style:
        new_cell.font = copy(source_cell.font)
        new_cell.border = copy(source_cell.border)
        new_cell.fill = copy(source_cell.fill)
        new_cell.number_format = copy(source_cell.number_format)
        new_cell.alignment = copy(source_cell.alignment)

wb.save("report_appended.xlsx")
四、实战方案二:面对复杂图表与VBA时使用 xlwings
openpyxl虽然能在绝大部分场景下保护样式,但遇到极度复杂的Excel特性时存在局限:例如文档中内嵌了动态透视表、包含复杂的联动图表,或者带有VBA宏代码。openpyxl保存时可能会由于无法解析某些专有XML扩展节点,导致下一次在Excel中打开时弹出“发现不可读取的内容,是否尝试恢复?”的警告。
此时的最佳选择是 xlwings。xlwings在底层直接通过操作系统COM接口(Windows)或AppleScript(macOS)启动真正的本地Excel进程。所有读写和计算完全由Excel原生核心执行,因此具备绝对的100%格式保真度。
import xlwings as xw

# 启动后台 Excel 进程(不显示图形界面以提高效率)
app = xw.App(visible=False, add_book=False)
app.display_alerts = False
app.screen_updating = False

try:
    # 打开包含复杂图表和透视表的报表模板
    wb = app.books.open("complex_dashboard.xlsx")
    sheet = wb.sheets["KPI_Overview"]

    # 读取旧数值
    old_target = sheet.range("D5").value
    print(f"原销售目标: {old_target}")

    # 修改数值:完全原生态,所有绑定此单元格的动态图表、切片器均会自动联动刷新
    sheet.range("D5").value = 350000

    # 另存为新文件
    wb.save("complex_dashboard_output.xlsx")
    wb.close()
    print("通过 Excel 原生引擎写入完毕,透视表与图表完全保真。")
finally:
    # 必须确保在 finally 块中退出进程,避免后台残留失控的 EXCEL.EXE 进程
    app.quit()
五、全景决策指南与常见避坑要点
在落地生产环境时,根据运行宿主机条件、报表复杂度以及格式保留要求,推荐按下图所示的决策链路进行选型:
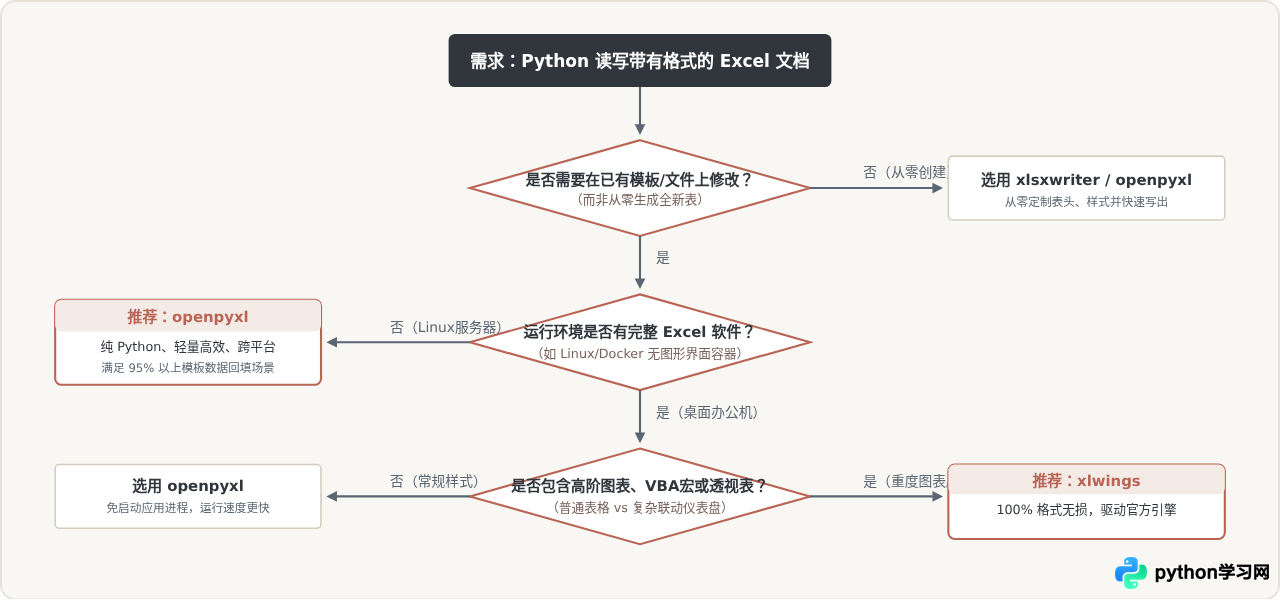
关键避坑要点:
在 openpyxl 中,如果指定 load_workbook(filename, data_only=True),它会读取 Excel 上次由计算引擎缓存的计算结果(而非公式字符串)。但极其危险的是:当你在此模式下调用 wb.save(),原单元格中的公式(如 =SUM(A1:A10))会被彻底替换为静态数字,导致后续表格失去公式自动计算能力。因此,凡是需要“修改后再保存”的场景,绝不要开启 data_only。
如果工作表中存在合并区域(例如 A1:C1 已经合并),在 openpyxl 中必须只能向 ws['A1'].value 进行赋值。如果试图对 ws['B1'] 或 ws['C1'] 赋值,不仅新数据无法在合并视图中正常展示,甚至可能造成合并区域边界属性解析异常。
不要在脚本中直接覆盖源模板文件。若程序因网络波动、断电或代码异常中断在 save() 阶段,原文件可能损毁并不可恢复。正确的生产实践是保留一份只读模板文件,每次读取模板后修改,另存为新的目标文件。
总结
要在 Python 中完整保留 Excel 原有格式,核心在于改变“扁平读取重新生成”的思维模式,转为使用“基于 DOM 树的原地更新”策略。跨平台首选 openpyxl,它无需外部办公软件,开箱即用,通过 load_workbook 配合单元格更新,即可做到数据更新与样式保真两不误;而对于含有复杂动态图表、切片器联动或 VBA 宏的企业级高难度报表,则借助 xlwings 调用原生 Excel 进程,达到 100% 的绝对保真。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















